두뇌 없는 세 부분
체스 프로그램은 무엇으로 이루어지는지, 그리고 손으로 쓴 프로그램이 학습을 시작하기 전에 lichess의 컴퓨터 상대를 상대로 어디까지 통하는지에 관한 글입니다.
| 읽는 시간 | 12 분 |
|---|---|
| 게시일 | |
| 시리즈 | Learning To Play |
| 주제 | 게임 AI, 트리 탐색, 게임, Rust, 지표, 확률, 체스, 쇼기, 바둑 |
요약
학습을 시작하기 전에, 저는 레비가 설명한 세 부분으로 Kishi의 체스 엔진을 만들었습니다. 숫자로 바꾼 판, 누가 더 나은지 말하는 평가 함수, 그리고 앞을 내다보는 탐색입니다. 비트보드 표현은 변경할 때마다 perft로 검사하고, 손으로 쓴 PeSTO 평가 함수에는 체스가 거의 담겨 있지 않습니다. 강함은 탐색과, 그 안에 쌓인 조정된 통계적 내기들에 있습니다. 강함을 정직하게 측정하는 일이 가장 어렵습니다. 매치에는 짝지은 오프닝, 같은 탐색 예산, 명시한 오차 범위가 필요하며, 증명되지 않은 작은 플러스 결과는 유지하되 내세우지 않는다는 뜻입니다. 다시 만든 lichess 컴퓨터를 상대로, 손으로 쓴 평가 함수와 코어 하나를 쓴 Kishi는 레벨 6과 레벨 7 사이에 있으며, 넓은 오차 범위는 빼지 않고 함께 보고합니다. 같은 구성은 쇼기에서 괜찮은 클럽 상대가 되지만 바둑에는 대신 무작위 플레이아웃이 필요하며, 이 기준선은 프로젝트에서 학습시킬 모든 신경망이 이겨야 할 상대입니다.
lichess의 체스 컴퓨터에는 레벨이 여덟 개 있습니다. 저는 기차에서 휴대폰으로 이 컴퓨터와 두는데, 이 컴퓨터와 두어 본 모든 사람이 그렇듯 저에게도 이길 수 있는 레벨과 저를 이기는 레벨이 있습니다. 지난달 제 엔진을 만들었을 때, 그것을 보여 준 사람마다 처음 던진 질문은 제가 스스로에게 묻고 있던 질문과 같았습니다. 몇 레벨이냐는 것입니다. 세상에서 가장 답하기 쉬운 질문처럼 들립니다. 알고 보니 그것은 프로젝트 전체에서 가장 어려운 부분이었고, 프로그램이 아예 두게 만드는 일보다도 어려웠으며, 그 답이 이 글의 요점입니다.
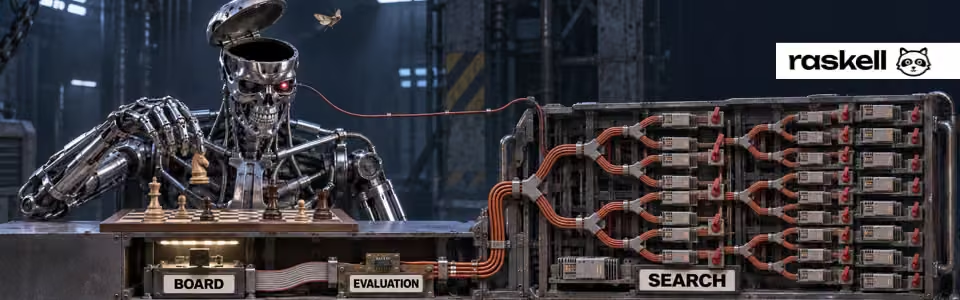
첫 번째 글에서 저는 열두 살의 Demis Hassabis(데미스 허사비스)가 David Levy(데이비드 레비)의 체스 컴퓨터 핸드북을 읽고 체스 프로그램이 세 부분으로 이루어진다는 것을 배운 이야기를 했습니다. 숫자로 바꾼 판, 누가 더 나은지 말하는 함수, 그리고 앞을 내다보는 탐색입니다. 저는 그 세 부분을 Rust로 만들었고, 직접 만들어 보면 각 부분이 실제로 무엇인지 보여 드리고 싶습니다. 놀라운 점은 그중 어느 것이 체스를 담고 있느냐이기 때문입니다. 그다음에는 결과에 숫자를 붙이고, 그 숫자에 왜 오차 범위가 따라오는지 보여 드리고 싶습니다. 대부분의 사람이 슬그머니 빼 버리는 그 오차 범위 말입니다.
이 글에서는 아무것도 학습하지 않습니다. 의도한 것입니다. 체스 국면을 평가하는 법을 배우는 신경망에게는 학습 재료가 될 대국을 둘 상대가 필요하고, 나중에 이겨야 할 상대도 필요합니다. 그렇지 않으면 그것이 무엇이라도 배웠는지 알 길이 없습니다. 이 글이 다루는 것이 바로 그 상대입니다.
숫자로 바꾼 판
레비의 첫 번째 부분은 사소하게 들리지만 그렇지 않습니다. 체스판에는 64칸이 있고 현대의 프로세서는 64비트 숫자를 다루므로, 자연스러운 표현은 기물 종류마다 숫자 하나를 두고, 그 종류의 기물이 서 있는 칸마다 비트 하나를 켜는 것입니다. 백과 흑의 여섯 가지 기물 종류마다 하나씩, 숫자 열두 개면 국면이 됩니다. 수 하나는 16비트입니다. 어디에서, 어디로, 그리고 어떤 종류의 수인지를 나타내는 비트 몇 개입니다. 대국의 전체 상태가 이 문단보다 적은 메모리에 들어갑니다.
이것이 중요한 이유는 속도입니다. “이 나이트는 어디로 갈 수 있는가”라는 질문은 표 하나를 찾아보는 일이 되고, “킹이 공격받고 있는가”라는 질문은 그 숫자들에 대한 AND와 OR 몇 번이 됩니다. 엔진은 이런 질문을 초당 수천만 번 던지고, 그 하나하나가 정확히 맞아야 합니다. 체스 규칙에는 까다로운 예외가 있기 때문입니다. 공격받는 칸을 지나가는 캐슬링이 그렇습니다. 앙파상으로 잡는 폰이, 그렇게 잡으면서 같은 가로줄을 따라 자기 킹에 대한 체크를 열어 버리는 경우도 그렇습니다. 수 생성에 드문 버그 하나가 있는 프로그램은 천 판을 아무 일 없이 두다가 불법 수를 두어 한 판을 지고, 그것이 어떤 규칙이었는지 아무도 알아채지 못합니다.
이것을 위한 시험에는 perft라는 이름이 있고, 모든 엔진 작성자가 가장 먼저 돌리는 것입니다. 알려진 국면에서 정해진 깊이까지 합법적인 수순을 빠짐없이 세고, 수십 년 동안 합의되어 온 공개된 숫자와 비교합니다.
| 내다보는 수 | 시작 국면에서 도달할 수 있는 국면 |
|---|---|
| 1 | 20 |
| 2 | 400 |
| 3 | 8,902 |
| 4 | 197,281 |
| 5 | 4,865,609 |
깊이 5에서 프로그램이 4,865,609라고 말한다면, 적어도 시작 국면에 대해서는 규칙이 맞는 것입니다. 모두가 쓰는 두 번째 국면도 있는데, Kiwipete라는 별명이 붙어 있고 캐슬링 권리와 앙파상과 프로모션이 한꺼번에 살아 있습니다. 그리고 더 고약한 종반 국면 몇 개가 있습니다. Kishi는 변경할 때마다 이 전체 묶음을 돌립니다. 또 프로젝트의 모든 매치 도구는 상대의 수를 Kishi 자신의 생성기와 대조하므로, 두 프로그램이 규칙에 대해 의견이 갈리면 그 대국은 조용히 점수가 매겨지는 대신 요란하게 실패합니다.
결정 하나가 그 뒤로 엔진을 어디서나 따라다닙니다. Kishi에서 국면은 수정되지 않고 복사되는 작은 값입니다. 수를 두면 새 국면이 돌아오고 옛 국면은 그대로 남으므로, “되돌리기(unmake)”가 없고 둘이 서로 어긋날 길도 없습니다. 수마다 이삼백 바이트를 복사하는 비용이 들고, 그 대가로 자기 자신과 어긋날 수 없는 코드를 얻습니다. 나중에 WebAssembly로 컴파일되어 여러 스레드에서 동시에 돌아갈 프로그램에게는 맞는 거래였고, 다시 하더라도 저는 같은 선택을 하겠습니다.
평가 함수
레비의 두 번째 부분은 체스를 담고 있으리라 예상했던 부분인데, 거의 아무것도 담고 있지 않습니다. 평가 함수는 앞을 내다보지 않고 국면 하나만 보고 숫자를 돌려줍니다. 누가 얼마나 더 나은지를 폰의 100분의 1 단위로 말합니다. +100은 둘 차례인 쪽이 폰 하나를 앞서 있거나, 위치상 그에 맞먹는 이점이 있다는 뜻입니다. 허사비스가 읽은 그 책에서 레비가 든 예는 기물 대 기동성이었습니다. 남은 기물이 그 기물들이 닿을 수 있는 칸보다 두 배 중요하다면, 기동성 점수를 더하기 전에 기물 점수를 두 배로 하라는 것입니다. 아이디어는 지금도 정확히 그것, 셀 수 있는 것들에 매긴 가중치입니다.
Kishi의 손으로 쓴 평가 함수는 PeSTO라는 잘 알려진 표 묶음입니다. 열두 가지 기물마다 칸 하나에 숫자 하나씩, 64개의 숫자로 된 표가 있습니다. 중앙의 나이트는 가장자리의 나이트보다 가치가 높고, 킹은 중반에는 구석에, 종반에는 중앙에 있어야 하며, 판 위로 멀리 나아간 폰은 제자리에 있는 폰보다 가치가 높습니다. 기물마다 표가 두 개, 중반용과 종반용이 있고, 평가 함수는 남은 기물의 양에 따라 둘을 섞습니다. 판 위에 있는 기물들의 항목을 더하면, 그것이 그 숫자입니다.
그 밖에는 아무것도 모릅니다. 각 폰이 어디 서 있는지 외에는 폰 구조에 대해, 킹이 어디 서 있는지 외에는 킹의 안전에 대해 아무것도 모르고, 룩이 오픈 파일에 있는지, 두 기물이 서로 어떤 관계인지도 모릅니다. 768개의 숫자 두 벌과 보간 하나가 전부인데, 체스를 두는 대부분의 사람을 이길 만큼 체스를 잘 둡니다. 이것은 이런 프로그램의 강함이 어디에 있는지에 대해 무언가를 말해 줍니다. 지식 속에는 없습니다.
768이라는 숫자는 다음 글에서 다시 다루겠습니다. 이 표를 대체하기로 되어 있는 신경망의 입력이 정확히 768개이고, 그것은 우연이 아니기 때문입니다.
엔진 안에는 이미 작은 학습이 하나 있는데, 이 프로젝트 전체가 다루는 아이디어의 가장 작은 예로서 한 문장을 할애할 만합니다. 탐색은 자기가 본 폰 구조마다 평가 함수가 최근에 얼마나 틀렸는지를 표에 기록하고, 평가 함수를 쓰기 전에 그 이동 평균으로 보정합니다. 이 보정은 대국 중에 탐색 자신의 더 깊은 결과로부터 학습되고, 대국이 끝나면 버려집니다.
탐색
레비의 세 번째 부분에 엔지니어링이 있고, 강함도 여기서 나옵니다. 탐색은 모든 수와 모든 응수와 그 응수에 대한 모든 응수를 시도해 도달할 수 있는 국면들의 트리를 만들고, 끝에 있는 국면들에 대해 평가 함수에 묻습니다. 교과서적인 형태는 미니맥스입니다. 상대는 언제나 나에게 가장 나쁜 응수를 고른다고 가정하고, 최악의 경우가 가장 나은 수를 고릅니다. 알파베타는 트리의 대부분이 중요하지 않다는 증명을 곁들인 미니맥스입니다. 응수 하나가 어떤 수가 충분히 나쁘다는 것을 보여 주고 나면, 그 수의 나머지 진행은 더 읽지 않습니다. 계약서에서 거래를 깨뜨리는 문장을 찾으면 그 조항의 나머지를 더 읽지 않는 것과 같습니다. 매 단계에서 가장 좋은 수를 먼저 살펴본다면, 알파베타는 미니맥스만큼 멀리 보면서 방문하는 국면은 대략 미니맥스의 제곱근 정도에 그칩니다.
현대의 엔진이 그 위에 더하는 모든 것은 체스에 대한 내기이고, 모든 내기는 가끔 틀립니다. 엔진은 내기들이 사 주는 추가 깊이가 그것들이 치르게 하는 실수보다 값어치가 있도록 조정됩니다.
| 기법 | 내기 | Kishi에서 |
|---|---|---|
| 트랜스포지션 테이블 | 같은 국면에 서로 다른 수순으로 도달하므로, 찾아낸 것을 기억합니다 | 모든 스레드가 잠금 없이 공유하는 테이블의 16바이트 항목 |
| 수 정렬 | 가장 좋을 법한 수를 먼저 보아 컷오프가 일찍 일어나게 합니다 | 테이블이 기억하는 수, 그다음 가치 순으로 정렬한 잡는 수, 그다음 최근에 컷오프를 일으킨 수 |
| 널 무브 프루닝 | 아무것도 하지 않아도 이미 충분히 좋다면 수를 두어도 좋으니, 나머지는 건너뜁니다 | 패스한 뒤의 더 얕은 탐색, 앞서 있을수록 더 얕게 |
| 리버스 퓨틸리티 프루닝 | 얕은 깊이에서 목표보다 한참 위에 있으면 그만 봅니다 | 마진은 깊이 한 수당 폰의 100분의 75, 최대 여덟 수까지 |
| 레이트 무브 리덕션 | 정렬에서 뒤로 밀린 수는 최선인 경우가 드무니 더 얕게 탐색합니다 | 깊이와 수 순번의 로그로 된 공식 |
| 싱귤러 익스텐션 | 다른 모든 대안보다 훨씬 나은 수 하나는 더 깊이 볼 가치가 있습니다 | 깊이 여덟 수부터 |
| 정지 탐색 | 교환 도중에는 절대 평가하지 않습니다 | 국면이 잠잠해질 때까지 계속 잡고, 그다음에 묻습니다 |
이 가운데 제가 만든 것은 하나도 없습니다. 이것들은 오픈 소스 엔진들이 함께 물려받은 유산으로, 30년에 걸쳐 하나하나를 수만 판의 대국으로 시험한 사람들이 다듬어 낸 것이며, Kishi의 탐색이 연구 프로젝트가 아니라 수천 줄로 끝나는 이유이기도 합니다. 이 표에서 가져가셨으면 하는 것은 그 모양입니다. 체스 탐색은 통계적인 내기의 더미이고, 각 내기에는 폰의 100분의 1 단위로 적힌 마진이 있으며, 각각은 함께 돌아가는 특정한 평가 함수에 맞추어 조정되어 있습니다. 내기들은 평가 함수가 무엇인지 모릅니다. 다음 글에서 평가 함수가 바뀌고, 그 문장은 값비싼 문장이 됩니다.
이 모든 것을 갖추면, 노트북의 코어 하나에서 엔진은 초당 약 300만 개의 국면을 살펴보고, 판을 한 번 톡 치는 데 걸리는 시간인 0.5초 동안 열일곱에서 스무 반수 앞을 내다봅니다. 1997년의 Deep Blue는 오직 그 일만을 위해 만든 하드웨어 위에서 초당 2억 개의 국면을 살펴보며 열둘에서 열여섯 반수 앞을 내다보았습니다. 60배 적은 국면으로 조금 더 멀리 봅니다. 그 차이가 바로 내기들입니다.
무엇을 어떻게 아는가
이제 어려운 부분입니다. 두 체스 프로그램은 서로 둘 수 있고, 한쪽이 더 자주 이기며, 우리는 그것을 숫자로 바꾸고 싶습니다. 체스에는 1960년대부터 그런 숫자가 있었습니다. Elo 레이팅입니다. 모든 클럽 선수가 아는 숫자이고, 제가 십대 때 지역 대회에서 처음 만난 숫자이기도 해서, 그 산수가 저에게는 한 번도 추상적으로 느껴진 적이 없습니다. 400점 차이는 10대 1의 승산을 뜻합니다. 100점 차이는 강한 쪽이 약 64퍼센트의 점수를 얻는다는 뜻입니다. 두 프로그램 사이의 레이팅 차이는 둘 사이 매치의 점수로 계산되는데, 문제는 짧은 매치의 점수가 대부분 잡음이라는 것입니다.
체스 엔진 개발자들에게는 이를 위한 정직한 도구가 하나 있고, 그 정직함이 설계에 깃들어 있으므로 설명할 가치가 있습니다. 두 프로그램은 같은 무작위 오프닝에서 수백 판을 두는데, 각 오프닝은 색을 바꾸어 두 번씩 두어 운 좋은 오프닝이 한쪽에 유리하게 작용하지 못하게 합니다. 양쪽 모두 한 수에 탐색할 수 있는 국면 수를 똑같이 받으므로, 더 빠른 프로그램이 더 강한 프로그램으로 행세할 수 없습니다. 그리고 결과에는 95퍼센트 신뢰 수준의 오차 범위가 따라오는데, 그 크기는 둔 대국 수에 달려 있습니다.
| 대국 수 | 오차 범위 |
|---|---|
| 20 | 위아래로 약 200 레이팅 포인트 |
| 400 | 약 32 |
| 600 | 약 23 |
이 도구를 믿기 전에 저는 그것을 자기 자신에게 겨누어 보았습니다. 양쪽에 같은 프로그램, 한 수에 국면 1만 개, 600판입니다.
Kishi vs Kishi, 10,000 nodes a move, 600 games: +211 =181 -208 elo +1.7 ± 23.3오차 23에 +1.7은 도구가 0을 읽은 것이고, 아무것도 바뀌지 않았을 때 읽어야 하는 값이 바로 그것입니다. 그다음이 진짜 시험이었습니다. 앞에서 설명한 폰 구조 보정을 넣은 엔진 대 그것을 뺀 엔진입니다.
Kishi vs Kishi without correction, 600 games: +219 =180 -201 elo +10.4 ± 23.3아마 플러스이겠지만, 증명된 것은 아닙니다. 큰 엔진 프로젝트들은 변경 하나마다 이 시험을 수만 판으로 돌리고, 답이 어느 쪽으로든 분명해지는 순간 매치를 멈추는 통계 규칙을 씁니다. 노트북에서 600판은 하룻저녁 일이고, 오차 23에 +10을 정직하게 읽으면 “유지하되, 내세우지는 말 것”입니다. 저는 이 문장이 체스 밖에서도 꽤 쓸모 있다는 것을 알게 되었습니다.
lichess 사다리
Kishi의 두 버전 사이의 매치는 어느 쪽이 더 나은지 말해 줍니다. 둘 중 어느 쪽이 얼마나 좋은지는 아무것도 말해 주지 않습니다. 그러려면 프로그램은 사람들이 이미 그 강함을 아는 무언가와 두어야 하고, 제가 아는 가장 쓸모 있는 잣대는 여러분 주머니 속에 있는 것, 곧 lichess의 컴퓨터 상대입니다. 누구나 두어 보았고, 누구에게나 자기를 이기는 레벨이 있기 때문입니다.
여덟 레벨은 여덟 개의 서로 다른 프로그램이 아닙니다. 세계에서 가장 강한 오픈 소스 엔진인 Stockfish를 세 가지 방식으로 동시에 일부러 약하게 만든 것입니다. 일부러 더 나쁜 수를 고르게 하는 스킬 설정, 몇 수 앞까지 볼 수 있는지에 대한 상한, 그리고 한 수당 시간 제한입니다. 설정은 lichess가 돌리는 클라이언트에 공개되어 있으므로, 이 상대를 노트북에서 정확히 다시 만들 수 있습니다.
| 레벨 | 스킬 | 깊이 | 한 수당 시간 |
|---|---|---|---|
| 1 | −9 | 5 | 50 ms |
| 2 | −5 | 5 | 100 ms |
| 3 | −1 | 5 | 150 ms |
| 4 | 3 | 5 | 200 ms |
| 5 | 7 | 5 | 300 ms |
| 6 | 11 | 8 | 400 ms |
| 7 | 16 | 13 | 500 ms |
| 8 | 20 | 22 | 1,000 ms |
Stockfish 자체의 스킬 설정은 0에서 멈추므로, 제가 다시 만든 레벨 1부터 3은 실제보다 조금 강합니다. 레벨 4부터 8은 정확합니다. Kishi는 코어 하나에서 Stockfish 19와 레벨마다 20판씩, 자기 앱이 해당 레벨에 주는 시간으로 두었습니다.
| 상대 | Kishi의 한 수당 시간 | 점수 | 레이팅 차이 |
|---|---|---|---|
| lichess 레벨 4 | 200 ms | 20판에서 19점 | +511, 오차 ±646 |
| lichess 레벨 6 | 500 ms | 20판에서 13점 | +108, 오차 ±165 |
| lichess 레벨 7 | 500 ms | 20판에서 ½점 | −636, 오차 ±579 |
레벨당 20판으로는 버스가 지나갈 만큼 넓은 오차 범위가 나오며, 그래서 오차를 빼지 않고 표에 넣었습니다. 그래도 숫자로 말할 수 있는 것은 이것입니다. 손으로 쓴 평가 함수로, 코어 하나에서, 한 수에 0.5초를 쓸 때 Kishi는 lichess의 레벨 6과 레벨 7 사이에 있습니다. 여러분을 이기는 것이 레벨 6이라면, Kishi는 그것을 세 판에 두 판 꼴로 이깁니다. 레벨 7은 강함을 대부분 그대로 지닌 채 열세 수 깊이로 생각하는 Stockfish이고, 20판에 무승부 한 번은 그 거리를 정직하게 묘사한 것입니다. 레벨 8은 깊이 22의 Stockfish, 다시 말해 그냥 Stockfish이고, 노트북에서 손으로 쓴 어떤 평가 함수도 거기에 닿지 못할 것입니다.
앱은 휴대폰에서 코어 네 개로 두고 이 숫자들은 코어 하나에서 나온 것이므로, kishi.raskell.io에서 만나는 상대는 표보다 조금 강합니다. 학습한 신경망들이 나오는 대로 휴대폰의 예산으로 다시 측정하겠습니다. 그것들을 앱에 실을지 결정하는 측정이 바로 그것이기 때문입니다.
같은 세 부분, 두 번 더
쇼기도 같은 방식으로 만들었습니다. 숫자로 바꾼 판에는, 잡은 말이 손에 들어갔다가 다시 판으로 돌아올 수 있다는 까다로운 점이 하나 더 있습니다. 손으로 쓴 평가 함수는 말의 가치를 세되 손에 든 말을 판 위의 말보다 조금 더 높게 치고, 자기 왕 가까이 있는 금장과 은장에 보상을 줍니다. 그리고 같은 내기들을 지닌 같은 탐색입니다. 쇼기를 두는 변형 엔진 Fairy-Stockfish를 상대로 한 수에 0.5초씩 주었을 때, 가장 약한 스킬 설정에는 20판 중 20판을, 중간 설정에는 20판 중 2판을 이깁니다. 괜찮은 클럽 상대이지만 강한 수준과는 거리가 멀고, 손으로 쓴 평가 함수는 이미 설계가 삐걱거리는 지점입니다. 말이 판으로 돌아오니 단순화해 들어갈 종반이 없고, 칸의 표가 말해 주는 것은 점점 줄어듭니다.
바둑은 세 부분을 얻지 못했습니다. 통하지 않기 때문입니다. 바둑 국면에서 누가 이기고 있는지 알려 주는 361개 점의 표는 없고, 19×19 판에서 네 수 앞을 내다보는 탐색은 거의 아무것도 보지 못합니다. Kishi의 바둑 엔진은 2008년의 프로그램들이 두던 방식으로 둡니다. 빠른 무작위 대국 수천 판을 끝까지 두어 보고 세는 것입니다. 그리고 가장 낮은 레벨의 GNU Go를 상대로 열 판 중 세 판을 이깁니다. 그 방법과, 그것이 왜 AlphaGo가 빠져나와야 했던 막다른 길이었는지는 따로 한 편의 글감입니다.
치른 비용
| 엔진 | Rust로 며칠, 코딩 에이전트와 함께 작성, 방향은 제가 잡음 |
| 규칙 시험 | 변경할 때마다 몇 초 |
| 코어 하나에서 초당 탐색한 국면 수 | 300만에서 370만 |
| 한 수에 국면 1만 개로 두는 600판 매치 | 코어 열 개로 하룻저녁 |
| lichess 레벨 하나와 두는 20판 | 몇 분 |
기준선은 이 프로젝트 전체에서 가장 중요한 숫자이고, 가장 화려하지 않은 숫자입니다. 그것은 학습한 모든 신경망이 이겨야 할 상대이고, 그것들이 처음 배울 대국을 만들어 낼 선수이며, 나머지 작업이 필요 없게 만들려고 애쓰는 대상입니다. 직접 만든 레비의 세 부분은 손으로 쓴 768개 숫자의 표와 아주 많은 탐색을 담고 있고, 여러분 휴대폰 속 컴퓨터의 레벨 6과 7 사이에 자리합니다. 다음 글에서는 그 표에 은닉층을 하나 더하고, 그 대가가 무엇인지 알아봅니다.
참고 문헌
- Ronald Friederich, PeSTO’s evaluation function, Chess Programming Wiki.
- Perft results, Chess Programming Wiki.
- lichess, fishnet: 컴퓨터 레벨을 두는 클라이언트와 레벨 표.
- Arpad Elo, The Rating of Chessplayers, Past and Present (Arco, 1978).
- Kishi: 탐색과 평가 함수는
engine/, 매치 실행기는tools/, 여기 인용한 모든 매치는docs/study/notebook.md.