# Raskell: 한국어 번역 전문
> raskell.io는 스위스 바젤의 AI 아키텍트 Raffael Schneider의 개인 사이트입니다. 사이트는 주로 영어로 되어 있으며, 아래 글과 페이지는 한국어로 번역되어 있습니다. 그 밖의 글, 노트, 서평, 강연은 영어로만 제공됩니다. 번역된 글마다 Markdown 사본이 있습니다(주소 끝의 슬래시를 .md로 바꾸면 됩니다).
================================================================================
---
title: "컨텍스트가 왕입니다: 모델을 나의 것으로 만드는 레이어"
url: https://raskell.io/ko/articles/context-is-king/
author: Raffael Schneider
date: 2026-12-01
description: "모델은 범용이고, 컨텍스트가 모델을 나의 것으로 만듭니다. 왜 모든 사람이 컨텍스트 레이어를 갖게 될지, 그리고 제 에이전트를 위해 하나를 만들며 배운 것을 씁니다."
tags: [agent-experience, context-engineering, knowledge-management, external-memory, provenance, local-first, agents]
lang: ko
translation_of: https://raskell.io/articles/context-is-king/
---
# 컨텍스트가 왕입니다: 모델을 나의 것으로 만드는 레이어
## 요약
생성형 사전 학습 트랜스포머는 능력을 범용적이고 값싼 것으로 만들었습니다. 그것을 특정한 사람에게 효과적으로 만드는 것은 컨텍스트이고, 효과와 효율에서 다음의 큰 향상은 바로 거기서 나옵니다. 에이전트와 함께 일하는 모든 사람은 개인 컨텍스트 레이어를 갖게 되고, 그들이 대화하는 어시스턴트는 그 레이어만큼만 좋을 것입니다. 모델은 빌려 쓰는 것이므로, 컨텍스트는 그 사람이 열린 형식으로 소유해야 합니다. 제가 제 에이전트를 위해 만든 레이어는 git에 담긴 서로 연결된 Markdown 노트로 이루어진 작은 라우터이고, 모든 세션이 여기서 시작합니다. 분리는 코드로 강제되고, 유일한 인터페이스는 명령 하나입니다. 매일 밤의 꿈(dream)은 사람의 검토 없이 세션 기록과 대조해 이 레이어를 통합합니다. 이것이 정당화되는 이유는 오직 관문이 기계적이고 어느 밤이든 되돌릴 수 있기 때문입니다. Kurumi는 그런 레이어 위에 놓인 어시스턴트이고, IT Intelligence는 조직 전체를 위한 같은 레이어입니다. 패턴은 하나이고, 어떤 규모에서도 같습니다.
지난 몇 년의 대규모 언어 모델은 능력을 범용적인 것으로 만들었습니다. 생성형 사전 학습 트랜스포머는 인류가 써 온 것의 상당 부분을 읽었고, 거의 어떤 분야에서든 초안을 쓰고, 추론하고, 번역하고, 코드를 쓸 수 있습니다. 그것이 혁명이었습니다. 하지만 그것이 하지 못한 일은 모델이 여러분에 대해 무언가를 알게 하는 것입니다. 여러분의 프로젝트, 여러분의 규칙, 이미 내린 결정과 그 이유, 함께 일하는 사람들, 되풀이하고 싶지 않은 실수입니다. 모델은 모든 사람에게 똑같습니다. 그것을 여러분의 것으로 만드는 무언가는 다른 곳에서 와야 합니다.
그 다른 곳이 컨텍스트이고, 저는 이 시스템들이 할 수 있는 일의 다음 큰 걸음이 거기서 나온다고 생각합니다. 같은 모델에, 그 모델이 일해 주는 사람에 관한 알맞은 2킬로바이트를 주는 것입니다. 대부분의 사람은 이 레이어를 과소평가합니다. 저는 에이전트와 함께 일하는 모든 사람이 결국 이런 레이어를 하나씩 갖게 될 것이라고 생각하고, 제 것을 만들면서 어떤 논문보다 더 많은 것을 배웠습니다.
## 범용 모델과 빠진 맥락 {#the-general-model-and-the-missing-context}
범용성은 이 모델들의 선물이면서 동시에 빈틈입니다. 거의 무엇이든 할 수 있는 모델은 그중 무엇이 여러분에게 필요한지, 어떤 스타일로, 어떤 제약 아래에서, 어떤 이력을 가지고 해야 하는지 알지 못합니다. 그 지식이 없는 어시스턴트와의 세션은 매번 낯선 사람과 함께 시작하고, 여러분은 그 비용을 두 번 치릅니다. 효과에서 한 번 치르는데, 낯선 사람은 추측하고 그 추측의 일부는 틀리기 때문입니다. 효율에서 또 한 번 치르는데, 쓸모 있는 일을 하기 전에 여러분의 세계를 다시 알아내느라 토큰과 시간을 쓰기 때문입니다.
컨텍스트는 두 빈틈을 모두 메웁니다. [Context Is the Product](https://raskell.io/articles/context-is-the-product/)에서 저는 모델은 범용품이 되어 가지만 컨텍스트는 그렇지 않다고 주장했습니다. [Agent Experience](https://raskell.io/articles/agent-experience/)에서는 에이전트가 얼마나 추측해야 하는지를 시스템이 에이전트를 얼마나 잘 돕는지의 척도로 설명했습니다. 개인 컨텍스트 레이어는 한 사람을 위한 에이전트 경험입니다. 같은 모델이라도 여러분이 누구인지, 무엇을 만들고 있는지, 어떤 실수를 되풀이하지 말아야 하는지를 적은 짧은 한 페이지를 받으면, 질문을 덜 하고, 덜 추측하고, 방향을 잡는 데 토큰을 덜 쓰고, 여러분이 했을 법한 종류의 변경을 합니다. 다시 학습시키지 않고도 맞춤형이 됩니다.
이 기술에는 이미 이름이 있습니다. Andrej Karpathy는 2025년 6월 [Simon Willison이 인용한 대로](https://simonwillison.net/2025/Jun/27/context-engineering/) 컨텍스트 엔지니어링을 “컨텍스트 창을 딱 알맞은 정보로 채우는 섬세한 기술이자 과학”이라고 불렀습니다. 그 정보의 대부분은 작업에 관한 것입니다. 개인 컨텍스트 레이어는 그중 여러분에 관한 부분이고, 한 작업에서 다음 작업으로 넘어가도 바뀌지 않는 부분입니다.
잘 다듬어진 레이어가 검색만으로는 얻을 수 없는 무언가를 더한다는 측정된 증거가 있습니다. [The components of agent memory](https://www.anthropic.com/research/components-of-agent-memory)에서 Anthropic은 Claude가 검색 도구와 시간이 지나며 스스로 쌓아 온 위키를 함께 가졌을 때, 점수가 “그 위키가 자라면서 54%에서 61%로 올랐고, 검색 도구만 가졌을 때는 53%였다”고 보고합니다. 검색은 무엇이 있는지를 찾아 줍니다. 다듬어진 레이어는 무엇이 중요한지를 말해 줍니다.
## 모든 사람에게 컨텍스트 레이어를 {#every-person-a-context-layer}
저는 에이전트와 함께 일하는 모든 사람이 몇 년 안에 이런 것을 갖게 될 것이고, 사람들이 어시스턴트와 상호작용하는 방식도 그것에 따라 모양이 잡힐 것이라고 생각합니다. 여러분은 모델에 프롬프트를 쓰는 대신, 이미 여러분의 프로젝트와 약속과 일하는 방식을 알고 여러분의 도구들을 가로질러 여러분을 대신해 행동하는 어시스턴트와 글이나 목소리로 대화하게 될 것입니다. 아마 여러 공급자의 여러 어시스턴트가 서로 다른 일을 맡을 것입니다. 그것들을 여러분의 것으로 만들고 서로 일관되게 유지하는 것은 그것들이 모두 기대는 레이어입니다.
중요한 질문은 그 레이어를 누가 소유하느냐입니다. 오늘날 메모리는 대부분 제품 안에 삽니다. 에이전트 도구마다 저마다의 형식으로 저마다의 메모리를 갖고 있고, 하나가 여러분에 대해 알게 된 것은 그 안에 머뭅니다. 편리하지만 함정이기도 합니다. 어시스턴트가 여러분에 대해 많이 알수록 떠나기는 어려워지고, 여러분의 일하는 삶 가운데 더 많은 부분이 여러분이 읽지도, 옮기지도, 고치지도 못하는 저장소에 놓이게 됩니다. 대안은 그 사람에게 속한 컨텍스트 레이어입니다. 자기 기기 위에 열린 형식으로 있고, 코드처럼 버전이 관리되며, 작은 인터페이스를 통해 그 사람이 고른 어떤 어시스턴트에게든 제공되는 레이어입니다. 모델은 빌려 쓰는 것입니다. 컨텍스트는 소유해야 합니다.
적어도 지금은, 소유한다는 것은 직접 만든다는 뜻이기도 합니다. 이어지는 내용은 제가 제 것을 어떻게 만들었는지를 일반적인 용어와 단순화한 이름으로 설명하고, 제가 지킬 결정들을 정리한 것입니다.
## 하나를 만들기 {#building-one}
제가 시작한 코딩 에이전트 세션은 모두 낯선 사람과 함께 시작했습니다. 에이전트가 세션 중에 배운 것은 작업 디렉터리별, 도구별로 저장되었기 때문에, 한 에이전트가 한 리포지토리에서 얻은 교훈은 다음 리포지토리의 다른 에이전트에게 결코 닿지 않았습니다. 한동안 저는 같은 규칙을 서로 다른 두 에이전트 도구의 지시 파일에 손으로 관리하는 사본 두 개로 두었는데, 며칠 만에 서로 어긋났습니다. 그래서 저는 제가 무엇을 하고 있는지, 제 규칙이 무엇인지, 제가 일이 어떻게 되기를 바라는지를 아는 한 곳을 만들었고, 모든 에이전트 세션이 거기서 시작합니다. 저는 그것을 제 뇌(brain)라고 부릅니다. 제 에이전트에게는 그것이 바로 그런 역할이기 때문입니다. 코딩 에이전트와 함께한 긴 세션 하나, 그리고 설계를 두고 에이전트와 꽤 많이 논쟁한 시간이 들었습니다.
처음에 제가 밝힌 요구사항은 이랬습니다.
- git에 담긴 평범한 Markdown이고, 서로 연결되어 있으며, 파싱하고 검색하기 쌀 것;
- 둘 이상의 에이전트 도구가 쓸 수 있고, 나중에는 다른 것들도 쓸 수 있을 것;
- 개인 프로젝트와 고객이나 고용주를 위한 일처럼, 절대 섞여서는 안 되는 컨텍스트들을 분리할 것;
- 사람의 검토 없이 노트를 통합하고, 반박하고, 다듬는 매일 밤의 “꿈”;
- 무엇도 무효로 할 수 없는 몇 가지 절대 규칙을 두고, 그 밖의 모든 것은 수정할 수 있게 열어 둘 것.
무엇이든 만들기 전에 에이전트와 저는 이 요구사항 거의 하나하나를 두고 의견이 갈렸고, 그 불일치가 설계를 만들었습니다.
## 라우터이지 저장소가 아닙니다 {#a-router-not-a-store}
첫 번째 초안은 뇌가 모든 것을 알기를 바랐습니다. 그것은 불러오기 싸야 한다는 요구와 충돌하고, 이미 제자리가 있는 정보를 중복시킵니다. 살아남은 버전은 라우터입니다. 노트에는 정제된 사실과 포인터만 담고, 각 프로젝트의 자체 파일, 즉 README, 결정 기록, 상태 파일이 진실의 원천으로 남습니다. 세션은 작은 진입 페이지를 불러오는데, 실제로는 약 2,600바이트이고, 더 필요할 때 거기서 링크를 따라갑니다.
모든 노트는 한 가지에 관한 Markdown 파일 하나입니다. 프로젝트, 규칙, 교훈, 기계, 열린 질문입니다. 이것은 Andy Matuschak가 [evergreen notes](https://notes.andymatuschak.org/Evergreen_notes)라고 부르는 것에 가깝습니다. 그것은 “프로젝트를 가로질러, 시간이 지나며 진화하고, 기여하고, 쌓이도록 쓰이고 정리된” 노트입니다. 차이는 독자입니다. 이 노트들은 먼저 에이전트를 위해 쓰이고, 사람은 그다음에 읽습니다. 프런트 매터는 그것이 무엇이고 얼마나 믿을 수 있는지를 말합니다.
```markdown
---
id: lesson.verify-before-done
type: lesson
context: core
title: Verify before reporting done
summary: A passing build is not a finished change; look at the result.
status: confirmed
source: person
date: 2026-11-02
---
Screenshots of the page in light, dark and phone width before saying a site
change is done. Applies to every project with a UI; see [[rule.no-unverified-claims]].
```
`status`는 사람이 말했거나 확인한 것과 에이전트가 추론한 것을 구분하고, `source`는 노트가 어디서 왔는지를 말합니다. 사람, 세션, 가져오기, 또는 꿈입니다. 이 구분 하나가 많은 일을 합니다. 에이전트는 확인된 규칙은 묻지 않고 따르고, 확인되지 않은 규칙은 점검해 볼 단서로 다룰 수 있습니다.
노트는 `[[id]]`로 서로 연결됩니다. 작은 컴파일러가 폴더를 두 가지로 바꿉니다. 훑어보고 싶은 에이전트를 위한 노트당 한 줄짜리 인덱스, 그리고 순회하고 싶은 모든 것을 위한 그래프 파일입니다.
```json
{
"nodes": [
{ "id": "lesson.verify-before-done", "type": "lesson", "status": "confirmed" },
{ "id": "rule.no-unverified-claims", "type": "rule", "status": "confirmed" }
],
"edges": [
{ "from": "lesson.verify-before-done", "to": "rule.no-unverified-claims" }
]
}
```
린터는 깨진 링크, 알 수 없는 유형, 너무 커진 진입 페이지, 그리고 다른 컨텍스트를 가리키는 모든 노트를 거부합니다. 이 구조는 Anthropic이 Claude 자신의 메모리에 대해 설명하는 것과 일부러 가깝게 만들었습니다. 진실의 원천으로서의 기록, 각각 한 주제를 다루는 서로 연결된 페이지들의 위키, 그리고 그 위에 주입되는 작은 레이어입니다. “메모리 계층의 맨 위 레이어는 비교적 작게 유지되어야 하기” 때문입니다. Claude Code도 같은 정신으로 그것을 작게 유지합니다. 같은 글에 따르면 Claude Code는 메모리 인덱스 가운데 “처음 200줄 또는 25 KB만” 각 세션에 불러옵니다. 계층 자체는 이 제품들 어느 것보다도 오래되었습니다. 2023년 Charles Packer와 동료들의 [MemGPT](https://arxiv.org/abs/2310.08560)는 운영체제의 “계층적 메모리 시스템에서 영감을 얻은 기법인 가상 컨텍스트 관리”를 제안했습니다. 컨텍스트 창 안의 작고 빠른 레이어, 그리고 에이전트가 필요할 때 불러들이는 크고 느린 레이어입니다.
## 분리된 리포지토리, 그리고 벽 {#separate-repositories-and-a-wall}
한 리포지토리 안에서 폴더로 컨텍스트를 나누는 것은 통하지 않습니다. 리포지토리를 읽을 수 있는 것은 그 전체를 읽을 수 있기 때문입니다. 대신 이 설계에는 일하는 스타일이나 일반 규칙처럼 모든 컨텍스트에서 그 사람에 대해 참인 것을 담는 핵심(core) 리포지토리 하나와, 컨텍스트마다 그 프로젝트와 교훈을 담는 리포지토리 하나씩이 있습니다. 세션은 core와 정확히 하나의 컨텍스트를 불러옵니다. 컨텍스트 안의 노트는 core로 링크할 수 있지만, 다른 컨텍스트로 가는 링크는 아예 표현할 수 없습니다. id는 core와 현재 컨텍스트 안에서만 해석되기 때문입니다.
이것은 읽을 때의 분리입니다. 더 어려운 문제는 쓸 때의 분리, 즉 무언가가 기계를 떠날 때의 분리입니다. 에이전트에게 컨텍스트를 섞지 말라고 말하는 것은 지시이고, 지시는 대부분의 경우에 지켜집니다. 커밋을 거부하는 훅은 벽입니다. 그래서 벽은 코드가 되었습니다. 커밋, 커밋 메시지, 푸시에 거는 훅, 그리고 에이전트가 바깥을 향해 실행하는 셸 명령에 거는 훅입니다. 각 훅은 리포지토리가 어느 컨텍스트에 속하는지 알아내고, 다른 컨텍스트를 식별하는 용어가 담긴 내용, 작성자 신원, 커밋 메시지, 푸시 대상을 막습니다. 실패하면 닫히는(fail closed) 방식이고, 켜기 전에 버릴 리포지토리에서 아홉 가지 경우로 시험했습니다.
세션 전체에서 가장 쓸모 있었던 한 시간은 이미 있던 리포지토리들에 벽의 감사(audit)를 돌린 일에서 나왔습니다. 아무도 찾아보지 않았던 것들이 나왔습니다. 어떤 도구의 로컬 캐시 파일이 실수로 공개 리포지토리에 커밋되어 있었고, 그 안에 내부 계정 이름이 들어 있었습니다. 공개 파일에 홈 디렉터리의 절대 경로가 있어 기계의 사용자 이름이 드러났습니다. 에이전트 지시 파일 하나는 그 내용을 에이전트들이 프로젝트 지시 파일에 복사해 넣고 있었습니다. 어떤 수정은 평범한 커밋이었고, 하나는 이력 재작성이 필요했으며, 한 리포지토리는 비공개가 되었습니다. 재작성에 기대기 전에 알아 둘 만한 한계가 두 가지 있습니다. 호스팅 제공자는 옛 커밋을 해시로 계속 접근할 수 있게 둘 수 있고, 다른 사람이 소유한 포크는 공개된 채로 남습니다. 일반적인 교훈은 **분리는 프롬프트가 아니라 내용이 기계를 떠나는 곳에서 강제되어야 한다**는 것이고, 감사 하나만으로도 그 경비를 만들 가치가 있다는 것입니다.
같은 생각이 규칙 자체에도 적용됩니다. 절대 바뀌어서는 안 되는 작은 공리(axiom)의 집합은 해시를 담은 잠금 파일로 봉인되고, 봉인에는 대화형 터미널이 필요하므로 어떤 에이전트도 그것을 할 수 없습니다. 그 밖의 모든 것은, 제가 직접 밝힌 규칙까지 포함해, 반박에 열려 있습니다. 처음에 저는 제가 쓴 모든 규칙을 꿈으로부터 보호하고 싶었는데, 에이전트가 반대했습니다. 그것은 너무 넓다고 했습니다. 틀린 것으로 드러난 규칙까지 얼려 버리기 때문입니다. 또 너무 약하다고 했습니다. 꿈이 편집할 수 있는 보호는 아무것도 보호하지 않기 때문입니다. 몇 안 되는 공리를 기계적으로 봉인하고 나머지는 열어 두는 것이 더 나은 답이었습니다.
## 명령 하나, 어떤 에이전트든 {#one-command-any-agent}
모든 세션은 같은 방식으로 시작합니다. `ctx context`라는 명령이 진입 페이지, 한 줄씩 적은 공리들, 현재 컨텍스트의 홈 페이지, 그리고 작업 디렉터리가 알려진 프로젝트에 속하면 그 프로젝트의 노트를 출력합니다. 한 에이전트 도구는 세션 시작 훅에서 이것을 실행하고, 다른 하나는 지시 파일에서 이것을 실행하라는 말을 듣습니다. 세 번째 도구도, 아직 존재하지 않는 도구도 같은 명령을 부를 수 있습니다. `ctx find`와 `ctx show`는 무언가를 찾아보고, `ctx capture "..."`는 받은 편지함(inbox)에 덧붙입니다.
이것은 설계에서 가장 덜 흥미로운 부분이고, 제가 가장 먼저 따라 할 부분입니다. 텍스트를 출력하는 명령을 통한 통합은 모든 소비자가 뇌가 어떻게 저장되는지 모르게 해 줍니다. 노트는 옮겨질 수 있고, 형식은 바뀔 수 있고, 그래프 밑에 데이터베이스가 자랄 수도 있지만, 어떤 에이전트 설정도 바뀔 필요가 없습니다. 이것은 [가독성의 사다리](https://raskell.io/articles/agent-experience/#the-legibility-ladder)의 두 번째 단에 놓인 안정적인 계약이고, 뇌가 어느 한 에이전트 공급자에게도 묶이지 않는다는 뜻입니다.
## 꿈꾸기 {#dreaming}
뇌를 자라게 하는 부분은 매일 밤의 통합입니다. Anthropic과 다른 이들이 그렇게 부르기 때문에 저도 이것을 꿈꾸기라고 부릅니다. 제 노트가 꿈꾸게 한다는 생각은 Helvetia의 동료인 [Joachim Prinzbach](https://www.linkedin.com/in/joachimprinzbach/)에게서 왔습니다. 그는 Anthropic이 에이전트 메모리에 관한 글을 내기 전에 저에게 이것을 보여 주었습니다. 그 이야기의 짧은 버전은 [Memory that dreams](https://raskell.io/notes/memory-that-dreams/)에 있습니다. 이 생각은 사람의 기억이 작동한다고 여겨지는 방식에서 왔습니다. 잠과 조용한 휴식 동안 “해마는 우리의 최근 경험을 재생”하고, 그중 일부가 오래가는 지식으로 정제됩니다(Anthropic). 에이전트 버전에는 짧은 역사가 있습니다. 2023년 Joon Sung Park와 동료들의 [Generative Agents](https://arxiv.org/abs/2304.03442)는 시뮬레이션된 각 인물의 경험을 모두 기록해 두고, 그 인물이 “시간이 지나며 그 기억들을 더 높은 수준의 성찰로 종합”하게 했습니다. Letta는 2025년 4월 Kevin Lin, Charlie Snell과 동료들의 논문에서, 에이전트가 “쉬는 시간을 이용해 정보를 재조직”하는 [sleep-time compute](https://www.letta.com/blog/sleep-time-compute)를 제안했습니다. 그리고 Anthropic은 2026년 5월 [dreaming in Claude Managed Agents](https://claude.com/blog/new-in-claude-managed-agents)를 리서치 프리뷰로 내놓았습니다.
매일 밤, 각 컨텍스트마다 따로 이렇게 합니다.
*One night of dreaming, for one context*
```text
step what happens
────────────── ───────────────────────────────────────────────────────────
1 harvest session transcripts (text only, capped), new inbox entries,
the tools' own memory files, notes written by hand in Kurumi
│
▼
2 consolidate a headless model, run in this context's repository:
test the notes against the transcripts; correct, merge
and prune; record what lasts; raise conflicts as open
questions; write a short journal of what changed
│
▼
3 gate touched a protected path? linter fails? hook refuses?
│
yes ─────┴───── no
│ │
▼ ▼
discard the commit and push:
whole run one dream, one commit
```
사람의 검토 없이도 이것을 정당화할 수 있게 하는 것은 관문입니다. 기록이 진실의 원천이고, 결코 편집되지 않습니다. 보호된 경로, 즉 공리, 컨텍스트 레지스트리, 도구 자체, 훅, 그리고 꿈 자신의 프롬프트는 건드릴 수 없습니다. 그중 하나라도 건드린 실행은 통째로 버려집니다. 린터와 커밋 훅은 다른 모든 작성자와 마찬가지로 꿈에도 적용됩니다. 그리고 꿈 하나가 커밋 하나이므로, 어느 밤이든 명령 하나로 되돌릴 수 있습니다. 검토 없는 자동화는 관문이 기계적이고 되돌리기가 쌀 때 합리적이고, 유일한 관문이 모델의 판단일 때 무모합니다.
첫 번째 실제 실행은 약 3분이 걸렸습니다. 세션 세 개와 도구들의 자체 메모리 파일을 읽고 파일 열세 개를 커밋했습니다. 뇌의 씨앗으로 제가 손으로 쓴 노트 속의 낡은 주장 하나를 바로잡았습니다. 한 에이전트 도구가 자기 비공개 메모리에 써 둔 규칙들을 가져와 다른 도구도 볼 수 있는 노트로 바꾸었습니다. 그리고 서로 반대 방향으로 당기는 제 두 입장에 관한 열린 질문을 하나 제기했는데, 그것이야말로 제가 두 번째 뇌에게 바라는 일이고, 제가 스스로는 결코 적어 두지 않았을 일입니다.
Anthropic의 글에는 왜 기록이 진실의 원천으로서 중요한지 보여 주는 좋은 예가 있습니다. 어떤 게임의 긴 실행에서, 한 메모리 노트가 Claude에게 필요한 장소의 위치를 잘못 담고 있었고, 꿈꾸기는 “그 노트를 세션 기록과 대조해 오류를 잡아내고 다시 썼습니다”. 바로잡힌 노트로 Claude는 곧장 나아갔고, 바로잡히지 않은 노트로는 “그 이전 경로로 세 번 되돌아갔습니다”. 실제로 일어난 일과 한 번도 대조되지 않는 메모리는 중립으로 남지 않습니다. 그것은 표류하고, 에이전트는 그것을 따라갑니다.
## Kurumi: 레이어 위의 어시스턴트 {#kurumi-the-assistant-on-top-of-the-layer}
에이전트만 읽을 수 있는 컨텍스트 레이어는 그것이 묘사하는 사람에게서 멀어지므로, 저도 그것을 편하게 읽고 고칠 수 있어야 합니다. 저는 그 일을 제가 만드는 로컬 우선 노트 앱 [Kurumi](https://kurumi.raskell.io)에서 하고, 개인 컨텍스트 레이어 위에 개인 어시스턴트를 두는 생각이 가장 멀리 나아간 곳도 Kurumi입니다.
Kurumi는 데이터를 자체 데이터베이스에 두지만, Markdown 로컬 폴더를 동기화하고 변경 사항을 다시 읽어 들일 수 있습니다. 뇌는 Kurumi가 자기 노트를 직접 가리키게 하지 않습니다. `ctx mirror`라는 명령이 Kurumi 자체 형식으로 된 단방향 사본을 컨텍스트마다 볼트(vault) 하나씩 씁니다. Kurumi는 제목으로 링크를 해석하므로, 링크는 id에서 제목으로 다시 쓰입니다. 꿈의 열린 질문은 Kurumi 자체의 질문 레코드가 되고 프로젝트 노트는 프로젝트 레코드가 되어, 제가 이미 질문과 프로젝트를 관리하는 곳에 나타납니다. 매일 밤의 일지는 노트가 되므로, “지난밤에 무엇이 바뀌었는가”는 제가 커피를 마시며 읽는 것이 됩니다. 뇌를 떠나는 노트는 지워지지 않고 삭제됨으로 표시됩니다. Kurumi는 그냥 사라진 파일을 복원하기 때문입니다. 그리고 제가 Kurumi에 쓰는 것은 무엇이든 다음 꿈이 `source: person`과 함께 제 말로 가져갑니다.
Kurumi는 이미 사람 쪽에서 같은 생각을 다루고 있었습니다. 내장 에이전트는 “Kurumi memory”라는 노트를 두고 모든 대화를 시작할 때 그것을 읽는데, 누구나 이 노트를 열고 편집할 수 있습니다. 이것은 정확히 위에서 말한 의미의 작은 주입 레이어입니다. 어떤 사람이나 프로젝트에 대해 물으면, 에이전트는 링크를 따라 양방향으로 노트를 걸어 거기 달린 할 일, 결정, 열린 질문까지 가고, 자기가 걸어간 경로를 작은 그래프로 보여 줍니다. 그리고 “살아 있는 노트(living note)”는 자기 주제에 관한 노트들로부터 많아야 여섯 시간마다 스스로를 다시 쓰고, 모든 출처로 돌아가는 링크를 답니다. 이것은 한 페이지 규모의 꿈꾸기입니다.
미러는 임시방편입니다. 제대로 된 버전은 제가 시작한 Kurumi 기능입니다. 뇌의 파일을 직접 여는 연결된 폴더 볼트로, 낯선 프런트 매터를 바이트 단위로 그대로 지키고, 설정할 수 있는 키로 링크를 해석하며, 모든 쓰기를 콘텐츠 해시로 지킵니다. 첫 부분, 즉 Kurumi의 저장소 뒤에 있는 읽기 전용 연결 볼트는 브랜치에 있고, 나머지는 진행 중입니다.
## 같은 레이어, 회사 전체를 위해 {#the-same-layer-for-a-whole-company}
[IT Intelligence](https://raskell.io/articles/it-intelligence/)와 그 [참조 구현](https://raskell.io/articles/building-it-intelligence/)에서 저는 조직 전체의 IT 환경을 위한 지식 레이어를 설명했습니다. 개인 컨텍스트 레이어는 한 사람 규모의 같은 패턴입니다.
| | IT Intelligence, 조직을 위해 | 컨텍스트 레이어, 한 사람을 위해 |
|---|---|---|
| 원재료 | 모든 시스템의 내보내기와 API | 세션 기록, 받은 편지함, 손으로 쓴 노트 |
| 보관하는 것 | 근거, 신뢰도, 출처가 달린 엔터티와 엣지 | 상태와 출처가 달린, 엔터티당 노트 하나 |
| 진실의 원천 | 각 기록 시스템 | 각 프로젝트의 자체 파일 |
| 통합 | 일정에 따른 수집, 판정, 구축, 점수 매기기 | 매일 밤의 꿈 |
| 사람이 검토하는 것 | 확인할 불확실한 링크의 대기열 | 꿈이 제기한 열린 질문 |
| 에이전트가 읽는 방법 | 작은 답과 출처를 주는 MCP 서버 | 작은 페이지를 출력하는 명령 하나 |
| 사람이 읽는 방법 | 엔터티 페이지와 그래프가 있는 웹 인터페이스 | Kurumi |
| 절대 일어나서는 안 되는 일 | 추론된 링크가 조용히 사실로 승격되는 것 | 한 컨텍스트의 내용이 다른 컨텍스트의 리포지토리에 들어가는 것 |
두 경우 모두 설계는 같은 몇 가지 결정 위에 서 있습니다. 출처가 말한 것과 결론으로 내린 것을 떼어 두고, 각 사실을 얼마나 믿을 수 있는지 말하고, 통합은 기계에 맡기되 기계의 판단에 기대지 않는 관문 아래에서 하게 하고, 에이전트에게는 작고 안정적인 입구를, 사람에게는 같은 것을 읽을 수 있는 화면을 주는 것입니다. 저는 이 평행을 계획하지 않았습니다. 문제가 같기 때문에 나타났습니다. 특정한 세계에 떨어진 범용 모델에게는 믿을 수 있는 그 세계의 지도가 필요합니다.
## 따라 할 것 {#what-to-copy}
여러분이 자신의 것을 만들고 싶다면, 제가 지킬 결정들은 이렇습니다. 얼마나 중요했는지의 순서입니다.
- **저장소가 아니라 라우터.** 진짜 출처를 가리키는 작은 노트들, 그리고 작은 진입 페이지.
- **엔터티당 노트 하나, 상태와 출처와 함께.** 확인된 것과 추론된 것은 서로 다른 종류의 지식입니다. 표시해 두십시오.
- **id로 된 링크, 인덱스와 그래프로 컴파일.** 훑어보기 싸고, 순회하기 싸고, 린터가 점검합니다.
- **유일한 인터페이스로서의 명령 하나.** 모든 에이전트 도구가 그것을 부르고, 어느 것도 노트가 어떻게 저장되는지 모릅니다.
- **코드로서의 분리.** 섞여서는 안 되는 컨텍스트에는 분리된 리포지토리, 그리고 떠나서는 안 되는 것을 거부하는 훅.
- **손으로 봉인한 몇 안 되는 공리.** 그 밖의 모든 것은 수정에 열려 있습니다.
- **기계적인 관문이 있는 통합.** 진실의 원천으로서의 기록, 보호된 경로, 린터, 실행마다 되돌릴 수 있는 커밋 하나.
- **같은 노트를 사람이 보는 화면.** 자신의 컨텍스트 레이어를 편하게 읽고 고칠 수 없다면, 그것은 여러분에게서 멀어질 것입니다.
## 아직 증명되지 않은 것 {#what-is-not-proven-yet}
이것은 작동하는 시스템이지만 아직 어린 시스템입니다. 첫 번째 꿈은 손으로, 한 컨텍스트에 대해 실행했습니다. 그 뒤로 예약된 작업이 첫 주의 네 밤 동안 새벽 세 시 반에 각 컨텍스트에 대해 스스로 꿈을 꾸었고, 두 에이전트 도구 모두 같은 명령에서 세션을 시작합니다. 한 주는 실적이라고 할 수 없습니다. Kurumi로의 미러는 처음에 Kurumi의 코드, 즉 파서, 링크 해석기, 레코드 리더와 대조해 점검했고, 그 뒤 실행 중인 앱에서도 시험해 보았습니다. 미러를 대체할 연결된 폴더 볼트는 브랜치에 단위 테스트가 있을 뿐 그 이상은 없습니다. 몇 달의 밤을 보낸 뒤 그것이 어떻게 버티는지 쓰겠습니다.
## 모델은 빌려 쓰는 것입니다 {#the-model-is-rented}
모델은 계속 좋아질 것이고, 모든 사람이 같은 모델을 갖게 될 것입니다. 달라지는 것은 각 모델이 자기가 일해 주는 사람이나 회사에 대해 무엇을 아느냐입니다. 그 지식은 모델과 함께 오지 않고, 공급자의 제품 안에 갇혀 있을 필요도 없으며, 시작하기도 어렵지 않습니다. 서로 연결된 노트가 담긴 폴더 하나, 알맞은 페이지를 출력하는 명령 하나, 그리고 믿을 수 있는 관문 몇 개면 됩니다. 컨텍스트는 범용 모델을 여러분의 어시스턴트로 바꾸는 것이고, 여러분이 소유할 수 있는 부분입니다.
## 참고 문헌 {#references}
- Lance Martin, [The components of agent memory](https://www.anthropic.com/research/components-of-agent-memory), Anthropic, 6 November 2026.
- Anthropic, [New in Claude Managed Agents: dreaming, outcomes, and multiagent orchestration](https://claude.com/blog/new-in-claude-managed-agents), 19 May 2026.
- Letta, [Sleep-time Compute](https://www.letta.com/blog/sleep-time-compute), 21 April 2025.
- Kevin Lin, Charlie Snell, Yu Wang, Charles Packer, Sarah Wooders, Ion Stoica, and Joseph E. Gonzalez, *Sleep-time compute: Beyond inference scaling at test-time*, arXiv:2504.13171, 2025, as cited in the Letta post.
- Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G. Patil, Ion Stoica, and Joseph E. Gonzalez, [MemGPT: Towards LLMs as Operating Systems](https://arxiv.org/abs/2310.08560), arXiv:2310.08560, 2023.
- Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein, [Generative Agents: Interactive Simulacra of Human Behavior](https://arxiv.org/abs/2304.03442), arXiv:2304.03442, 2023.
- Simon Willison, [Context engineering](https://simonwillison.net/2025/Jun/27/context-engineering/), simonwillison.net, 27 June 2025, quoting Andrej Karpathy.
- Andy Matuschak, [Evergreen notes](https://notes.andymatuschak.org/Evergreen_notes), Andy's working notes.
- [Kurumi](https://kurumi.raskell.io), a local-first second brain, and its [documentation on AI and the agent](https://github.com/raskell-io/kurumi/blob/main/docs/ai.md).
- Raffael Schneider, [Memory that dreams](https://raskell.io/notes/memory-that-dreams/), [Context Is the Product](https://raskell.io/articles/context-is-the-product/), [Agent Experience](https://raskell.io/articles/agent-experience/), [IT Intelligence](https://raskell.io/articles/it-intelligence/) and [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/).
================================================================================
---
title: "에이전트 경험: 여러분이 만드는 모든 것의 세 번째 독자"
url: https://raskell.io/ko/articles/agent-experience/
author: Raffael Schneider
date: 2026-11-24
description: "UX는 시스템을 쓰는 사람을, DX는 시스템을 만드는 사람을 위한 것입니다. 이제 에이전트가 두 일을 모두 하고, 에이전트가 얼마나 추측해야 하는지가 설계의 문제가 되었습니다."
tags: [agent-experience, agents, ai-engineering, developer-tooling, context-engineering, legibility, interfaces]
lang: ko
translation_of: https://raskell.io/articles/agent-experience/
---
# 에이전트 경험: 여러분이 만드는 모든 것의 세 번째 독자
## 요약
에이전트가 코드를 쓰게 되면 개발자는 문법과 패턴에 쓰는 시간이 줄고 아키텍처, 통합, 요구사항에 쓰는 시간이 늘어납니다. 그리고 에이전트가 다루는 도구는 예전보다 더 중요해집니다. 에이전트 경험(AX)은 Mathias Biilmann이 2025년에 소개한 용어이고, 한 가지로 재는 것이 가장 좋습니다. 에이전트가 여러분의 시스템에서 옳은 일을 하기 위해 얼마나 추측해야 하는가입니다. 인터페이스는 가독성의 사다리 위에 놓입니다. 추측할 것을 남기지 않는 컴파일러와 스키마에서, 모든 것을 추측하게 만드는 HTML과 스크린샷까지입니다. 그리고 오류와 피드백이 모든 인터페이스 가운데 가장 중요합니다. Bun을 Zig에서 Rust로 옮긴 일과 Anthropic이 git을 떠난 일이 보여 주듯, 도구는 다시 쓰기 싼 것이 되었습니다. 그래서 이제 생태계를 고르면, 그 코드보다 그 전제에 더 깊이 묶이게 됩니다. 에이전트의 컨텍스트는 리포지토리, 프로토콜, 그래프, 인덱스로 이루어진 공급망을 거쳐 도착하고, 다른 모든 공급망과 같은 관리를 받아야 합니다. 출처, 신선도, 안정적인 계약, 비용입니다. 표준은 빠르게 등장하고 있지만(AGENTS.md, MCP, Agent Skills, llms.txt), 빈틈이 더 큽니다. 명령줄 도구를 위한 계약, 보장된 효과, 컨텍스트의 출처, 시스템을 측정하는 방법, 그리고 지시와 데이터 사이의 경계입니다.
처음 보는 리포지토리에서 코딩 에이전트가 10분 동안 일하는 모습을 지켜보며 추측을 세어 보십시오. 어떤 명령이 테스트를 실행하는지, 린터의 경고가 치명적인지, 배포 도구가 산문 두 단락과 스택 트레이스로 무엇을 말하려는지, `billing`이라는 이름의 서비스 세 개 가운데 티켓이 말하는 것이 어느 것인지, 그리고 README가 아직도 맞는지입니다. 추측 하나하나가 토큰과 시간을 쓰고, 그중 일부는 틀리며, 틀린 추측은 결국 풀 리퀘스트에 들어갑니다.
그런 추측 가운데 모델에 대해 무언가를 말해 주는 것은 거의 없습니다. 추측은 에이전트가 놓인 시스템에서 나오고, 그 대부분은 설계로 없앨 수 있습니다. 이제 일의 상당 부분을 맡은 에이전트를 시스템이 얼마나 잘 돕는지는 그 자체로 하나의 설계 문제가 되었고, 이 글은 그것을 기술해 보려는 제 시도입니다.
## 개발자는 한 단계 위로 올라갔습니다 {#the-developer-moved-up-a-level}
[Almost Irrelevant](https://raskell.io/articles/almost-irrelevant/)에서 저는 에이전트가 코드 대부분을 쓰게 되면 프로그래밍 언어 선택이 예전보다 훨씬 덜 중요해진다고 주장했습니다. 학습 곡선, 형식적 절차, 보일러플레이트를 에이전트가 떠안기 때문입니다. 같은 변화가 개발자가 하루 종일 생각하는 대상도 바꿉니다. 문법, 디자인 패턴, 루프를 어떻게 표현할지에 쓰는 생각은 줄고, 전체의 형태에 쓰는 생각이 늘어납니다. 어떤 시스템이 어떤 데이터를 소유하는지, 한 변경이 옆에 있는 세 시스템으로 어떻게 번지는지, 요구사항이 무엇인지, 일이 끝났을 때 무엇이 참이어야 하는지입니다.
그대로인 것은 도구입니다. 도구는 예전보다 더 중요해졌고, 그 이유는 Jarred Sumner가 [Bun이 Anthropic에 합류할 때](https://bun.com/blog/bun-joins-anthropic) 잘 표현했습니다. “새 코드 대부분을 AI 에이전트가 쓰고, 테스트하고, 배포하게 된다면, 그 코드를 둘러싼 런타임과 도구는 훨씬 더 중요해집니다.” 그는 사람이 “개별 코드 한 줄 한 줄에서 더 멀어지므로, 코드가 실행되는 환경은 빠르고 예측 가능해야 한다”고 썼습니다. 에이전트는 같은 명령을 하루에 천 번 실행하고 모든 출력을 문자 그대로 받아들입니다. 그래서 개발자가 무시하는 법을 익혔던 기벽들이 이제는 실행할 때마다 비용이 됩니다.
## 세 독자 {#three-readers}
이제 모든 시스템에는 세 종류의 독자가 있습니다.
| | 사용자 경험(UX) | 개발자 경험(DX) | 에이전트 경험(AX) |
|---|---|---|---|
| 누구 | 시스템을 쓰는 사람 | 시스템 위에서나 안에서 무언가를 만드는 사람 | 그 둘 중 하나를 하는 에이전트 |
| 읽는 것 | 화면, 문구, 흐름 | 문서, API, 오류, 도구 | 모든 것을, 문자 그대로, 매번 |
| 기억하는 것 | 몇 년에 걸친 습관 | 팀의 구전 지식 | 적어 두지 않는 한, 세션 사이에 아무것도 |
| 도움을 구하는 곳 | 고객 지원, 동료 | 동료, 포럼 | 아무 데도 없음. 추측함 |
| 혼란의 비용 | 잃어버린 고객 | 날려 버린 오후 | 기계의 속도로 반복되는 잘못된 변경 |
세 번째의 이름은 Netlify의 최고경영자 Mathias Biilmann에게서 왔습니다. 그는 2025년 1월 [Introducing AX: Why Agent Experience Matters](https://biilmann.blog/articles/introducing-ax)에서 이 말을 소개하며 “AI 에이전트가 제품이나 플랫폼의 사용자로서 겪게 될 총체적인 경험”이라고 정의했습니다. 다른 사람들도 금세 이 말을 받아들였습니다. 한 달 뒤 Resend의 Zeno Rocha는 [What is AX](https://resend.com/blog/agent-experience)에서 “에이전트는 밀리초 만에 시작하고 돌아갈 수 있어야 합니다”라고 썼습니다. 이 용어는 개발자에게 파는 제품에 관한 질문으로 태어났습니다. 사람이 양식을 하나하나 클릭해 넘기지 않아도 에이전트가 가입하고, 문서를 읽고, 배포할 수 있는가 하는 질문입니다.
저는 이 말을 더 넓게 씁니다. 에이전트 경험은 모든 코드베이스, 내부 도구, 두 팀 사이의 API, 회사가 간직한 모든 지식의 속성입니다. 이제 에이전트는 제품의 정문에서만이 아니라 그 모든 것 안에서 일하기 때문입니다. 또 저는 더 좁은 정의도 씁니다. 그쪽이 행동으로 옮기기 쉽기 때문입니다. **에이전트 경험이란 에이전트가 여러분의 시스템에서 옳은 일을 하기 위해 얼마나 추측해야 하는가입니다.** 좋은 시스템은 추측할 것을 거의 남기지 않고, 남은 추측은 확인하기 싸게 만듭니다.
## 추측은 어디서 오는가 {#where-the-guesses-come-from}
모델만이 아니라 인터페이스가 에이전트가 할 수 있는 일을 결정한다는 첫 번째 진지한 증거는 2024년의 SWE-agent 논문([Yang et al.](https://arxiv.org/abs/2405.15793))에서 나왔습니다. 이 논문은 에이전트-컴퓨터 인터페이스라는 개념을 도입했고, 시간이 지나도 낡지 않은 주장을 폈습니다. “LM 에이전트는 고유한 필요와 능력을 지닌 새로운 범주의 최종 사용자입니다.” 이 논문의 절제 실험(ablation)은 꼼꼼히 읽어 볼 만합니다. 모든 변경이 인터페이스에 대한 것이었고, 모델에 대한 것은 하나도 없었기 때문입니다.
| 인터페이스 변경(SWE-bench Lite) | 해결 비율 |
|---|---|
| 전체 인터페이스: 깨진 편집을 거부하는 린터가 달린 편집기, 요약된 검색, 100줄짜리 파일 뷰어 | 18.0% |
| 린터라는 안전장치가 없는 같은 편집기 | 15.0% |
| 요약 대신 결과를 한 페이지씩 돌려주는 검색 | 12.0% |
| 한 번에 100줄 대신 파일 전체를 보여 주기 | 12.7% |
| 편집 명령이 아예 없음 | 10.3% |
에이전트에게 파일을 더 많이 보여 주자 결과가 나빠졌고, 검색 결과를 넘겨 보게 하자 검색이 아예 없을 때(15.7%)보다도 나빠졌습니다. 도움이 된 것은 예측 가능한 형태로 주어진 더 적은 정보였습니다. Anthropic도 자사 에이전트에서 같은 교훈을 얻었습니다. [Building effective agents](https://www.anthropic.com/engineering/building-effective-agents)에서 팀은 코딩 에이전트를 만들 때 “전체 프롬프트보다 도구를 최적화하는 데 더 많은 시간을 썼다”고 썼고, “철저한 도구 문서화와 테스트를 통해 에이전트-컴퓨터 인터페이스(ACI)를 신중하게 만들라”고 조언했습니다. 이 조언에는 제조업에서 빌려 온 이름이 있습니다. “도구에 포카요케를 적용하라(Poka-yoke your tools)”, 즉 애초에 실수하기 어렵도록 도구를 바꾸라는 것입니다.
제 일에서 추측은 몇 안 되는 곳에서 나오고, 그 거의 전부는 늘 거기 있었습니다. 사람은 동료에게 물어보는 것으로 그것을 흡수했습니다.
- **모양이 바뀌는 출력.** 색과 진행 표시줄을 곁들여 사람을 위한 표를 출력하면서, 안정적인 기계용 형식은 없는 도구.
- **산문으로 된 오류.** 바쁜 사람을 위해 쓴 메시지. 에이전트는 이것을 해석해야 하고, 문구는 버전마다 바뀝니다.
- **머릿속에 사는 관례.** 팀이 브랜치에 이름을 붙이는 방식, 어떤 테스트가 불안정한지, 어떤 디렉터리가 죽었는지.
- **서로 어긋나는 이름.** 같은 애플리케이션이 리포지토리에서는 이 이름, 클러스터에서는 저 이름, 장애 관리 도구에서는 또 다른 이름으로 불리는 것.
- **어긋나 버린 문서.** 2년 전에는 사실이었지만, 이제 아니라는 것을 알려 주는 표시는 하나도 없는 README.
- **출처 없는 지식.** 어디서 왔는지, 얼마나 오래되었는지 알 길이 없는 답.
## 가독성의 사다리 {#the-legibility-ladder}
모든 인터페이스가 같은 양의 추측을 남기지는 않습니다. 저는 추측할 것을 전혀 남기지 않는 인터페이스부터 거의 모든 것을 남기는 인터페이스까지 순위를 매겨 보는 것이 유용하다고 생각합니다.
| 단 | 인터페이스 | 에이전트가 여전히 추측해야 하는 것 |
|---|---|---|
| 1 | 컴파일러나 타입 검사기 | 거의 없음: 답은 예, 아니면 정확히 어디서 왜 아닌지 |
| 2 | 공개된 스키마가 있는 구조화된 출력(JSON Schema, OpenAPI, RFC 9457 오류) | 무슨 일이 일어났는지가 아니라 다음에 무엇을 할지 |
| 3 | 안정적인 플래그, 종료 코드, `--json` 모드가 있는 CLI | 문서화되지 않은 필드의 의미 |
| 4 | 에이전트가 가져올 수 있는 Markdown 문서(`llms.txt`, `.md` 사본) | 그것이 최신인지, 코드와 어떻게 대응하는지 |
| 5 | HTML 페이지 | 내비게이션과 스크립트 사이에서 내용이 어디 있는지 |
| 6 | 그래픽 인터페이스 | 거의 모든 것 |
에이전트 경험을 개선하는 일은 대부분 무언가를 이 사다리 위로 옮기는 일입니다. Cloudflare의 수치는 한 단 올라가는 것이 얼마나 값진지 보여 줍니다. [Markdown for Agents](https://blog.cloudflare.com/markdown-for-agents/)가 요청하는 클라이언트에게 페이지를 Markdown으로 내주면, 그들의 블로그 글 하나가 16,180토큰에서 3,150토큰으로 줄어듭니다. 그들의 표현으로는 “AI에게 원시 HTML을 먹이는 것은 안에 든 편지가 아니라 포장지를 읽는 데 단어당 돈을 내는 것과 같습니다.” Anthropic의 장기 실행 에이전트는 기능 목록을 Markdown이 아니라 JSON으로 보관합니다. “모델이 JSON 파일을 부적절하게 바꾸거나 덮어쓸 가능성이 더 낮기” 때문입니다([Effective harnesses for long-running agents](https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents)). 어느 단에 있느냐가, 에이전트의 주의력 가운데 얼마가 일 자체로 가고 얼마가 지금 무엇을 보고 있는지 알아내는 데 가는지를 정합니다.
같은 명령이 서로 다른 두 단에 놓일 수 있습니다. 이것은 사람을 위해 쓴 배포 도구입니다.
```text
⠋ Deploying claims-api to prod...
✗ Something went wrong. The rollout could not be completed because one or more
replicas failed their readiness checks. Check the dashboard for details.
```
그리고 이것은 모든 독자를 위해 쓴 같은 실패입니다.
```text
$ deployctl rollout claims-api --env prod --json
{"status":"failed","stage":"readiness","service":"claims-api","env":"prod",
"replicas":{"ready":1,"wanted":3},"probe":"/healthz","last_status":503,
"logs":"deployctl logs claims-api --env prod --since 10m","exit_code":3}
```
첫 번째는 에이전트에게 추측하라고 한 다음, 에이전트가 볼 수 없는 대시보드로 보냅니다. 두 번째는 무엇이 실패했는지, 얼마나 실패했는지, 다음에 어디를 볼지, 어떤 종료 코드로 분기할지를 말해 주며, 사람도 똑같이 잘 읽을 수 있습니다.
## 오류 메시지가 곧 API입니다 {#the-error-message-is-the-api}
에이전트를 위해 시스템에서 가장 신경 써야 할 부분은 피드백입니다. 오류, 경고, 테스트 출력, 리뷰 코멘트입니다. 에이전트는 대부분의 시간을 무언가를 시도하고 돌아온 것을 읽는 루프 안에서 보내므로, 돌아오는 것이 에이전트가 가장 많이 쓰는 인터페이스입니다.
제가 아는 가장 분명한 예는 Bun의 재작성입니다. Bun은 Zig로 쓰였고, 2026년 5월에 Jarred Sumner는 “Claude Code에서 약 50개의 동적 워크플로를 11일 동안 쉬지 않고 실행해” Bun을 [Rust로 다시 썼습니다](https://bun.com/blog/bun-in-rust). 에이전트들은 먼저 모든 파일을 기계적으로 옮겼고, 그다음 한 워크플로가 컴파일러 오류를 작업 대기열 삼아 크레이트 하나씩 처리해 나갔습니다. 처음에는 약 1만 6천 개였습니다. 그것이 왜 통했는지에 대한 그의 요약은 이렇습니다. “컴파일러 오류는 스타일 가이드보다 더 나은 피드백 루프입니다.” 컴파일러 오류는 한 줄을 가리키고, 반박할 수 없으며, 문제가 고쳐지면 사라집니다. 그래서 에이전트는 감독 없이 수천 개의 오류를 처리해 나갈 수 있고, 스타일 가이드에 대해서는 누구도 그렇게 말할 수 없습니다.
Nicholas Carlini는 에이전트 열여섯에게 [C 컴파일러를 만들게 했을 때](https://www.anthropic.com/engineering/building-c-compiler) 반대편에서 같은 곳에 이르렀습니다. “저는 이 테스트 하네스를 저 자신이 아니라 Claude를 위해 쓰고 있다는 것을 계속 스스로 상기해야 했습니다.” 그의 규칙은 구체적입니다. “테스트 하네스는 쓸모없는 바이트를 수천 개씩 출력해서는 안 됩니다.” 몇 줄만 출력하고 나머지는 파일에 기록해야 하며, 오류는 검색으로 쉽게 찾을 수 있어야 합니다. Cloudflare는 이것을 웹 자체에 적용했습니다. “에이전트에게 지시가 아니라 단서를 주는” 오류 페이지 대신 [RFC 9457 문제 상세(problem details)](https://blog.cloudflare.com/rfc-9457-agent-error-pages/)를 에이전트에게 돌려주었고, 그 원칙을 한 줄로 정리했습니다. “핵심 가치는 형식의 선택이 아닙니다. 의미의 안정성입니다.”
의미가 안정적인 오류는 이런 모습이고, 모든 버전에서 같은 것을 뜻합니다.
```json
{
"type": "https://errors.example.com/quota-exceeded",
"title": "Quota exceeded",
"status": 429,
"detail": "Project claims-api has used 1000 of 1000 builds this month.",
"retry_after": "2026-12-01T00:00:00Z",
"fix": "Raise the quota with: deployctl quota set claims-api --builds 2000"
}
```
Anthropic이 도구 작성자에게 주는 조언도 같은 것을 직접 말합니다. “구체적이고 실행 가능한 개선점을 분명히 전달하도록 오류 응답을 프롬프트 엔지니어링하라”([Writing effective tools for agents](https://www.anthropic.com/engineering/writing-tools-for-agents)). 에이전트에게 오류 메시지는 API의 일부이고, API의 나머지가 받는 것을 똑같이 받아야 합니다. 버전, 문서, 테스트입니다.
## 도구가 일회용이 되면 전제가 남습니다 {#when-tooling-is-disposable-premises-remain}
도구는 예전에는 교체하기 비쌌고, 그래서 우리는 수십 년 동안 그 결함을 안고 살았습니다. 에이전트는 교체를 현실적인 선택지로 삼을 수 있을 만큼 싸게 만들었고, 저는 그 결과가 아직 제대로 실감되지 않았다고 생각합니다.
[The Register](https://www.theregister.com/devops/2026/07/14/zig-creator-calls-buns-claude-rust-rewrite-unreviewed-slop/5270743)의 보도에 따르면 Bun의 재작성에는 “API 가격 기준으로 약 165,000달러”가 들었습니다. 처음 쓰는 데 몇 년이 걸린 런타임입니다. 재작성된 Bun은 8월 20일 [Bun 1.4](https://bun.com/blog/bun-v1.4)로 출시되었습니다. 동기는 실용적이었습니다. 팀을 바쁘게 만든 버그는 메모리 버그, 즉 use-after-free와 double-free였고, 다른 언어라면 배제되는 종류의 버그였습니다. 논란도 있었습니다. 같은 기사에서 Zig의 창시자는 이것을 “리뷰되지 않은 쓰레기(unreviewed slop)”라고 불렀고, 11일 동안의 에이전트 작업이 몇 년 동안의 사람 작업만큼 견고한지는 정당한 질문이며 프로덕션에서 보낸 시간만이 답할 수 있습니다. 하지만 재작성은 일어났고, 한 회사가 치르기로 선택할 수 있는 비용으로 일어났습니다. 그것만으로도 계산이 바뀝니다.
Anthropic은 자사 도구에서 한 걸음 더 나아갔습니다. 10월에 Anthropic은 [소스 관리를 다시 설계한 일](https://www.anthropic.com/research/redesigning-source-control)을 소개했습니다. “이제 병목은 사람의 규모에 맞춰 만들어진 모든 개발자 인프라입니다. 소스 관리, 빌드, CI입니다.” 하루에 병합되는 변경은 2026년 5월 약 2,500건에서 9월 30,000건 이상으로 늘었고, 그래서 팀은 자체 버전 관리 시스템인 Scion을 만들어 다섯 달 만에 모노레포를 git에서 옮겼습니다. git은 리포지토리 전체 사본을 가지고 오프라인에서 일하는 클라이언트를 전제합니다. “클라이언트 거의 전부가 에이전트와 작업(job)이므로”, 팀은 Scion을 언제나 온라인인 클라이언트를 위해 설계했습니다. 전제 하나가 바뀌자, 20년 동안 업계를 떠받쳐 온 도구가 더는 맞지 않게 되었습니다.
저는 이것을 재작성 문턱이라고 부릅니다. 도구를 다시 쓰는 비용이 그 도구의 전제를 안고 사는 비용보다 작아지는 지점입니다. 에이전트는 그 문턱을 크게 낮췄고, 여기서 두 가지가 따라 나옵니다.
첫째, 구현은 덜 중요해지고 전제는 더 중요해집니다. 도구의 코드를 몇 주 만에 다시 생성할 수 있다면, 생태계를 고를 때 약속하게 되는 것은 그 생태계의 설계 전제입니다. 메모리 모델, 호환성 약속, 출력이 결정적인지, 모듈에 이름을 어떻게 붙이고 어떻게 찾는지, 오류가 무엇을 보장하는지입니다. 에이전트가 매일 상대하는 것이 그것이고, 재작성에서 살아남는 것도 그것입니다. Bun 재작성의 풀 리퀘스트는 “같은 아키텍처, 같은 데이터 구조”를 약속했습니다([#30412](https://github.com/oven-sh/bun/pull/30412)). 바뀐 것은 누가 메모리를 해제하는가에 대한 전제였습니다.
둘째, 에이전트 경험이 재작성의 이유가 됩니다. 산문으로 된 오류와 불안정한 출력을 가진 도구는 예전에는 성가신 것이었습니다. 이제 그것은 모든 에이전트가 실행할 때마다 내는 세금이고, 어느 시점이 되면 더 나은 도구에 돈을 쓰는 편이 세금을 내는 것보다 쌉니다.
## 컨텍스트 공급망 {#the-context-supply-chain}
에이전트 경험의 나머지 절반은 에이전트가 아는 것을 어디서 얻는가입니다. 에이전트가 기대는 컨텍스트의 종류에 대해서는 [Context Is the Product](https://raskell.io/articles/context-is-the-product/)에서, 검색(retrieval)이 왜 도구에 속하는지에 대해서는 [Retrieval Is a Tool, Not a Layer](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/)에서 썼습니다. 에이전트 쪽에서 보면, 이것은 공급망처럼 동작합니다.
*The context supply chain*
```text
sources channels the agent
───────────────── ─────────────────────── ──────────────
repository ──▶ AGENTS.md, docs/, code ──┐
systems of record ──▶ APIs, MCP servers ──┤
company knowledge ──▶ graphs, ontologies ──┼──▶ context window
documents ──▶ embeddings, search ──┤ (finite, costly)
people ──▶ reviews, approvals ──┘
│
every link carries: provenance · freshness · a stable contract · a cost in tokens
```
그 사슬의 모든 고리는 어떤 공급망이든 지니는 네 가지 속성을 가집니다. **출처:** 에이전트가 사실이 어디서 왔는지 알 수 있고, 나중에 사람이 그것을 확인할 수 있습니까? **신선도:** 사실에 날짜가 붙어 있습니까, 아니면 에이전트가 짐작해야 합니까? **안정적인 계약:** 채널이 버전이 바뀌어도 형태를 유지합니까, 아니면 바뀔 때마다 하류의 에이전트가 깨집니까? **비용:** 그 사실을 컨텍스트 창에 넣는 데 토큰이 얼마나 듭니까? Anthropic의 컨텍스트 엔지니어링 지침은 컨텍스트 창을 바로 그렇게 다룹니다. “따라서 컨텍스트는 한계 수익이 체감하는 유한한 자원으로 다뤄야 합니다”([Effective context engineering](https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents)). 그리고 MCP 서버를 긴 도구 목록이 아니라 에이전트가 호출할 수 있는 코드로 제시하자, 그들의 워크플로 하나가 “150,000토큰에서 2,000토큰으로” 줄었습니다([Code execution with MCP](https://www.anthropic.com/engineering/code-execution-with-mcp)).
채널은 표준화되고 있고, 그 위에서 무언가를 만드는 사람에게는 좋은 소식입니다. 2025년 12월 Linux Foundation은 기여받은 세 프로젝트를 중심으로 [Agentic AI Foundation](https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation)을 결성했습니다. Anthropic의 Model Context Protocol, Block의 goose, OpenAI의 AGENTS.md입니다. 리포지토리를 위한 관례, 시스템을 위한 프로토콜, 그리고 참조 에이전트가 중립적인 거버넌스 아래 모인 것은 이 공급망을 위한 공유 인프라의 시작입니다.
어떤 표준도 공급하지 않는 것은 내용이고, 대부분의 회사가 가장 나쁜 에이전트 경험을 겪는 곳이 바로 거기입니다. 회사 안에서 에이전트가 가장 자주 묻는 질문은 “이것은 누구의 것이고, 무엇이 이것에 의존하며, 아직 쓰이고 있는가?”입니다. 그리고 대부분의 조직에서 그 답은 서로 어긋나는 도구 여섯 개에 흩어져 있습니다. [IT Intelligence](https://raskell.io/articles/it-intelligence/)가 다루는 문제가 그것이고, [참조 구현](https://raskell.io/articles/building-it-intelligence/)이 MCP 서버를 통해, 언제나 출처를 지닌 작고 엔티티 중심적인 답으로 응답하는 이유도 그것입니다. 모든 사실에 출처가 붙어 있고 에이전트가 질의할 수 있는 지식 계층은 조직 자체를 위한 에이전트 경험입니다.
## 지금까지의 표준 {#the-standards-so-far}
2년 전에는 이름조차 없던 분야치고, 에이전트 경험에는 이미 공유된 기반이 꽤 있습니다. 2026년 11월 현재 그 모습은 이렇습니다.
| 관심사 | 존재하는 것 | 시작 | 뒤에 있는 곳 |
|---|---|---|---|
| 리포지토리 안의 에이전트용 지시 | [AGENTS.md](https://agents.md/) | 2025 | OpenAI, 현재는 Agentic AI Foundation |
| 모델에게 설명하는 웹사이트 | [llms.txt](https://llmstxt.org/) | 2024년 9월 | Answer.AI, 제안 단계 |
| 에이전트를 도구와 데이터에 연결하기 | [Model Context Protocol](https://modelcontextprotocol.io/), 현재 개정판 2026-07-28 | 2024년 11월 | Anthropic, 현재는 Agentic AI Foundation |
| 묶어서 전달하는 노하우와 워크플로 | [Agent Skills](https://www.anthropic.com/news/donating-agent-skills-to-the-agentic-ai-foundation) | 2025년 10월 | Anthropic, 2026년 10월 Agentic AI Foundation에 기증 |
| HTTP API의 오류 | [RFC 9457](https://www.rfc-editor.org/rfc/rfc9457) 문제 상세 | 2023 | IETF |
| 분석 도구와 컴파일러의 발견 사항 | [SARIF 2.1.0](https://docs.oasis-open.org/sarif/sarif/v2.1.0/sarif-v2.1.0.html), 그리고 GCC의 SARIF 출력과 [rustc의 JSON](https://doc.rust-lang.org/rustc/json.html) 같은 컴파일러 형식 | 2020 | OASIS |
| 요청하면 Markdown으로 내주는 페이지 | `Accept: text/markdown` | 2026 | Cloudflare, 관행으로 |
| 서비스와 소유자의 카탈로그 | Backstage의 [catalog-info.yaml](https://backstage.io/docs/features/software-catalog/descriptor-format) | 2020 | 사실상의 관례 |
| 사실이 어디서 왔는지 | [PROV-O](https://www.w3.org/TR/prov-o/) | 2013 | W3C |
눈에 띄는 것이 두 가지 있습니다. 가장 새로운 항목들이 에이전트가 매일 쓰는 것들이고, 그것들은 모델 공급사에서 나와 빠르게 중립적인 거버넌스로 옮겨 갔습니다. Anthropic의 집계로는 2025년 12월 표준이 공개된 이후 Agent Skills 하나만 해도 70개가 넘는 에이전트 플랫폼이 통합했습니다. 표준 기구에서 나온 오래된 항목들은 문제의 일부를 잘 풀지만, 다른 독자를 위해 쓰였습니다. SARIF는 코드 스캐너를, PROV-O는 시맨틱 웹을, Backstage는 개발자 포털을 위한 것입니다. 그것들을 에이전트를 위해 하나로 엮은 사람은 아직 없습니다.
## 아직 빠져 있는 것 {#what-is-still-missing}
앞으로 몇 년 동안 일의 대부분, 그리고 흥미로운 아이디어의 대부분은 이 빈틈에서 나오리라고 봅니다. 제가 계속 부딪히는 빈틈들을, 오늘 존재하는 가장 가까운 것과 함께 적으면 이렇습니다.
| 빈틈 | 오늘 가장 가까운 것 | 부족한 것 |
|---|---|---|
| 명령줄 도구를 위한 계약 | HTTP를 위한 RFC 9457, 분석기를 위한 SARIF | 에이전트가 매일 실행하는 수천 개의 CLI에 공통된 것이라면 무엇이든 |
| 믿을 수 있는 효과 | MCP 도구 주석 | 보장: 주석은 힌트일 뿐임 |
| 컨텍스트의 출처와 신선도 | PROV-O, 몇몇 제품의 관례 | 에이전트가 읽는 채널 안의 필드 |
| 에이전트 경험의 척도 | SWE-bench 같은 모델 벤치마크 | 에이전트는 고정하고 시스템을 바꾸는 벤치마크 |
| 조직의 컨텍스트 | Backstage 카탈로그 | 팀이 선언한 것을 넘어, 오늘 참인 것 |
| 에이전트가 읽는 텍스트의 변경 관리 | API 버전 관리 | 도구 설명, 지시, 오류 의미의 버전과 변경 이력 |
| 지시와 데이터 사이의 경계 | 널리 쓰이는 것은 없음 | 컨텍스트 안에서 무엇을 따라도 되는지 표시하는 방법 |
| 사람에게 넘기는 오래가는 인계 | MCP 엘리시테이션(elicitation) | 며칠씩 기다리고, 이름과 기록이 남는 승인 |
**명령줄 도구를 위한 계약.** 에이전트는 삶의 상당 부분을 셸에서 보내는데, 셸에는 공유된 계약이 전혀 없습니다. 도구마다 기계 모드가 있다면 그것을 저마다의 방식으로 만들고, 종료 코드와 오류 문구도 저마다 만듭니다. HTTP에서는 RFC 9457이, 정적 분석에서는 SARIF가 이 문제를 풀었습니다. 명령줄에도 같은 것이 필요합니다. 기계용 출력을 위한 표준 플래그, 모든 오류에 안정적인 타입이 붙은 문제 상세, 필드로 표현된 다음 행동, 의미가 문서화된 종료 코드입니다. 화려하지 않은 일이고, 저는 이것이 다음 모델 출시보다 에이전트의 시간을 더 많이 아껴 주리라고 짐작합니다.
**믿을 수 있는 효과.** 에이전트는 무언가를 실행하기 전에 그 행동이 읽기인지 쓰기인지, 안전하게 반복할 수 있는지, 되돌릴 수 있는지, 시스템 바깥에 닿는지 알아야 합니다. MCP에는 바로 이것을 위한 필드인 `readOnlyHint`, `destructiveHint`, `idempotentHint`, `openWorldHint`가 있고, 명세는 이 필드들에 대해 솔직합니다. “ToolAnnotations의 모든 속성은 힌트입니다. 도구의 동작을 충실하게 기술한다고 보장되지 않습니다”([스키마](https://modelcontextprotocol.io/specification/2026-07-28/schema)). 그리고 클라이언트는 “신뢰할 수 있는 서버에서 온 것이 아니라면 도구 주석을 신뢰할 수 없는 것으로 간주해야 합니다(MUST)”([도구](https://modelcontextprotocol.io/specification/2026-07-28/server/tools)). 올바른 신중함이고, 그래서 빈틈은 열린 채로 남습니다. 빠진 것은 무언가가 검사하는 효과 선언입니다. 읽기 전용을 강제하는 샌드박스, 또는 인프라 도구가 적용하기 전에 계획을 보여 주듯이 무엇이 바뀔지에 대한 계획을 돌려주는 표준 드라이런입니다.
**컨텍스트의 출처와 신선도.** `AGENTS.md`에는 소유자도 날짜도 없습니다. `llms.txt`는 마지막으로 언제 사실이었는지 말하지 않습니다. 도구 결과에는 그 사실들이 어디서 왔는지 담는 공통 필드가 없습니다. 시맨틱 웹은 오래전에 PROV-O로 출처 문제를 풀었지만, 에이전트가 읽는 채널 가운데 그것을 담은 것은 하나도 없습니다. 그렇게 되기 전까지 에이전트는 오늘 아침에 확인한 사실과 조직 개편 세 번 전에 쓰인 사실을 구별할 수 없고, 그 작업을 리뷰하는 사람도 마찬가지입니다. 저는 에이전트가 받는 모든 사실이 세 가지를 지니면 좋겠습니다. 출처, 기준 날짜, 소유자입니다. 제가 [참조 구현](https://raskell.io/articles/building-it-intelligence/)에 넣은 것이 그것이고, 이것을 위해 맞춤형 플랫폼이 필요해서는 안 됩니다.
**에이전트 경험의 척도.** 우리가 가진 모든 벤치마크는 환경을 고정하고 모델을 바꿉니다. 에이전트 경험에는 그 반대가 필요합니다. 에이전트를 고정하고 시스템을 바꾸는 것입니다. 한 리포지토리, API, 내부 플랫폼이 다른 것보다 에이전트에게 더 쉽다는 것을 다른 사람이 받아들일 만한 방식으로 말할 수 있는 사람은 아무도 없습니다. 그래서 개선을 비교할 수도, 개선했다고 주장할 수도 없습니다. 아래의 콜드 스타트 테스트는 제 임시방편입니다. 제대로 된 척도라면, 고정된 에이전트가 한 시스템을 상대로 실행하는 공개 과제 모음이 있고, 추측을 어디서나 같은 방식으로 셀 것입니다.
**조직의 컨텍스트.** Backstage는 서비스를 코드 옆의 파일로 기술하는 것을 평범한 일로 만들었고, 그것은 진짜 진전입니다. 하지만 카탈로그는 팀이 선언한 것을 기록하고, 에이전트에게 필요한 것은 참인 것입니다. 실무에서 누가 그 네임스페이스를 소유하는지, 어떤 애플리케이션이 아직 옛 API를 호출하는지, 어떤 레코드가 낡았는지입니다. 신뢰도와 증거를 담은 소유권과 의존성 그래프를 위한 표준은 없고, 그것을 원하는 회사는 모두 혼자 만듭니다. [IT Intelligence](https://raskell.io/articles/it-intelligence/)가 다루는 빈틈이 그것입니다.
**에이전트가 읽는 텍스트의 변경 관리.** 우리는 API에 버전을 붙입니다. API가 바뀌면 클라이언트가 깨지기 때문입니다. 에이전트도 클라이언트이지만, 에이전트가 의존하는 텍스트는 조용히 바뀝니다. 도구 설명의 문구가 바뀌고, 지시 파일이 재구성되고, 오류 메시지에 문장이 하나 붙습니다. 그 하나하나가 에이전트가 하는 일을 바꾸는데, 실패한 테스트가 없으므로 아무도 그 깨짐을 보지 못합니다. 더 나쁜 것은 도구 설명이 모델에게 주는 지시라는 점입니다. 그래서 도구 설명을 바꾸면, 코드 리뷰어라면 결코 살펴보지 않을 방식으로 동작이 바뀝니다. 에이전트가 읽는 텍스트에는 API 표면이 가진 것이 필요합니다. 버전, 변경 이력, 그리고 누군가 리뷰하는 diff입니다.
**지시와 데이터 사이의 경계.** 에이전트의 컨텍스트 안에서는 모든 것이 비슷해 보입니다. 사용자의 요청, 리포지토리의 관례, 에이전트가 가져온 웹 페이지, 낯선 사람이 쓴 이슈 코멘트가 모두 그렇습니다. 그중 무엇을 따라도 되고 무엇은 읽기만 해야 하는지 표시해 주는 것은 아무것도 없고, 그것이 프롬프트 인젝션의 뿌리입니다. [Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/)에서 썼듯이 더 나은 모델은 위험을 줄이고 샌드박스는 피해를 가둡니다. 하지만 빠진 조각은 권한이 어디서 오는지에 대한 관례, 모든 채널을 관통해 전달되는 관례입니다.
**사람에게 넘기는 오래가는 인계.** MCP의 엘리시테이션은 서버가 세션 도중에 사용자에게 정보를 요청할 수 있게 해 주고, 빠른 질문은 이것으로 해결됩니다. 더 어려운 경우는 기다려야 하는 승인입니다. 두 번째 사람이 필요한 변경이 있는데 그 사람은 목요일까지 휴가 중이고, 나중에는 누가 승인했는지 기록이 남아야 하는 경우입니다. 그런 인계에는 아직 표준이 없습니다. [Aqueduct](https://github.com/raskell-io/aqueduct)처럼 사람을 기다리는 대기 기능을 갖춘 내구성 있는 실행 엔진이 존재하는 이유가 그것이고, 저는 이 인계가 그 자체로 하나의 프로토콜이 되리라고 예상합니다.
이 빈틈 가운데 어느 것도 돌파구를 필요로 하지 않습니다. 몇몇 사람이 지루한 무언가에 합의하기만 하면 되고, 웹이 HTTP 상태 코드를 얻고 명령줄이 `--help`를 얻은 것도 그런 방식이었습니다. 이번에 다른 것은 속도입니다. 관례를 가장 먼저 적어 두고 그것을 받아들이기 쉽게 만드는 사람이 오랫동안 에이전트가 일하는 방식을 정의할 것입니다.
## 측정하기 {#measuring-it}
에이전트 경험은 측정할 수 있고, 측정하는 데 드는 비용도 적습니다. 저는 콜드 스타트 테스트라고 부르는 방법을 씁니다.
1. 시스템에서 실제 과제 하나를 고릅니다. 새 동료가 첫 주에 받을 만한 종류의 과제입니다.
2. 추가 지시도, 기억도, 도움도 없는 새 에이전트에게 그 과제를 줍니다.
3. 일하게 두고, 대화 기록(transcript)을 남깁니다.
4. 기록에서 네 가지를 셉니다.
| 측정 항목 | 알려 주는 것 |
|---|---|
| 추측: 시도한 명령, 연 파일, 밝힌 가정 가운데 틀린 것으로 드러난 것 | 시스템이 추측할 것을 얼마나 남기는지 |
| 첫 번째 성공한 빌드나 통과한 테스트까지의 턴 수 | 피드백 루프가 얼마나 빠른지 |
| 첫 번째 올바른 변경 전까지 쓴 토큰 | 컨텍스트에 닿는 데 얼마나 비싼지 |
| 사람이 개입해야 했던 횟수 | 지식이 아직 머릿속에만 사는 곳이 어디인지 |
도움이 되라고 만든 변경을 할 때마다 다시 실행하십시오. 에이전트가 그렇듯 숫자에는 잡음이 많겠지만, 기록은 그렇지 않습니다. 틀린 추측 하나하나가 구체적인 빈틈을 가리키고, 대부분의 빈틈은 오후 한나절이면 메울 수 있습니다. 열린 채로 남은 빈틈은 제가 에이전트 경험 부채라고 부르는 것이고, 다른 모든 부채처럼 복리로 불어납니다. 모든 에이전트가 실행할 때마다 그것을 다시 치르기 때문입니다.
## 무엇을 할 것인가 {#what-to-do-about-it}
소프트웨어를 만드는 사람과 운영하는 사람에게 할 일의 목록은 짧고, 그중 특이한 것은 하나도 없습니다.
- **관례를 에이전트가 찾을 곳에 적어 두십시오.** 루트에 둔 `AGENTS.md`가 늘 사실로 유지되는 `docs/` 디렉터리를 가리키게 하는 편이, 사람들 머릿속에 든 어떤 지식보다 낫습니다.
- **모든 도구에 기계용 형식을 주십시오.** 안정적인 플래그, 의미 있는 종료 코드, `--json` 모드, 그리고 기본으로는 짧고 자세한 내용은 로그 파일에 남기는 출력입니다.
- **오류를 API로 다루십시오.** 오류에 안정적인 타입을 주고, 다음에 무엇을 할지 말하게 하고, 버전이 바뀌어도 의미를 유지하십시오.
- **리뷰 앞에 검사를 두십시오.** 타입, 스키마, 린터, 테스트는 사람이 들여다보기 전에 추측을 답으로 바꿉니다.
- **지식을 출처가 붙은 데이터로 공개하십시오.** 소유권, 의존성, 상태는 각 사실의 출처가 붙은 채로, 에이전트가 질의할 수 있는 곳에 있어야 합니다.
- **생태계를 전제로 고르십시오.** 호환성 약속, 결정성, 스스로를 설명하는 컴파일러가 이제는 라이브러리 카탈로그의 크기보다 더 가치 있습니다. 카탈로그는 다시 생성할 수 있지만 전제는 그럴 수 없기 때문입니다.
- **콜드 스타트 테스트를 실행하십시오.** 한 번으로 끝내지 말고, 부하 테스트를 하듯이 분기마다 하십시오.
제가 가장 많이 듣는 반론은 이 모든 것이 이름만 바꾼 좋은 개발자 경험이라는 것입니다. 상당 부분은 그렇고, 저는 그것을 고무적으로 받아들입니다. 에이전트 경험이 좋은 시스템은 거의 언제나 사람에게도 더 좋습니다. 차이는 관용에 있습니다. 사람은 문서가 틀리면 동료에게 묻고 팀의 습관을 한 번 익히지만, 에이전트는 추측하고, 습관이 적혀 있지 않으면 세션마다 아무것도 없는 상태에서 시작합니다. 오류를 잘못 읽은 사람은 오후 한나절을 잃습니다. 에이전트는 실행할 때마다, 병렬로, 어떤 리뷰도 따라갈 수 없는 속도로 그것을 잘못 읽습니다.
## 세 번째 독자 {#the-third-reader}
30년 동안 우리는 시스템을 쓰는 사람을 위해 설계했고, 15년 동안은 시스템을 만드는 사람을 위해 설계했습니다. 이제 에이전트가 그 두 일의 큰 몫을 맡고 있고, 에이전트는 우리가 불분명하게 남겨 둔 것을 스스로 피해 가는 능력이 가장 부족한 독자입니다. 그래서 에이전트는 아직 무엇을 고쳐야 하는지 알려 주는, 우리가 가진 가장 정직한 안내자입니다.
## 참고 자료 {#references}
- Mathias Biilmann, [Introducing AX: Why Agent Experience Matters](https://biilmann.blog/articles/introducing-ax), 2025년 1월 28일.
- Zeno Rocha, [What is AX (Agent Experience) and how to improve it](https://resend.com/blog/agent-experience), Resend, 2025년 2월.
- John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, Ofir Press, [SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering](https://arxiv.org/abs/2405.15793), 2024.
- Erik S., Barry Zhang, [Building effective agents](https://www.anthropic.com/engineering/building-effective-agents), Anthropic, 2024년 12월 19일.
- Ken Aizawa, [Writing effective tools for agents, with agents](https://www.anthropic.com/engineering/writing-tools-for-agents), Anthropic, 2025년 9월 11일.
- Anthropic, [Effective context engineering for AI agents](https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents), 2025년 9월 29일.
- Adam Jones, Conor Kelly, [Code execution with MCP: Building more efficient agents](https://www.anthropic.com/engineering/code-execution-with-mcp), Anthropic, 2025년 11월 4일.
- Justin Young, [Effective harnesses for long-running agents](https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents), Anthropic, 2025년 11월 26일.
- Jarred Sumner, [Bun is joining Anthropic](https://bun.com/blog/bun-joins-anthropic), 2025년 12월 2일, 그리고 [Rewriting Bun in Rust](https://bun.com/blog/bun-in-rust), 2026년 7월 8일. 풀 리퀘스트 [Rewrite Bun in Rust](https://github.com/oven-sh/bun/pull/30412), 그리고 [Bun 1.4](https://bun.com/blog/bun-v1.4).
- [Zig creator calls Bun's Claude Rust rewrite "unreviewed slop"](https://www.theregister.com/devops/2026/07/14/zig-creator-calls-buns-claude-rust-rewrite-unreviewed-slop/5270743), The Register, 2026년 7월 14일.
- Linux Foundation, [Linux Foundation Announces the Formation of the Agentic AI Foundation](https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation), 2025년 12월 9일.
- Nicholas Carlini, [Building a C compiler with parallel Claudes](https://www.anthropic.com/engineering/building-c-compiler), Anthropic, 2026년 2월 5일.
- Celso Martinho, Will Allen, [Introducing Markdown for Agents](https://blog.cloudflare.com/markdown-for-agents/), Cloudflare, 2026년 2월 12일.
- Cloudflare, [Slashing agent token costs by 98% with RFC 9457-compliant error responses](https://blog.cloudflare.com/rfc-9457-agent-error-pages/), 2026년 3월 11일.
- Anthropic, [Redesigning source control at Anthropic](https://www.anthropic.com/research/redesigning-source-control), 2026년 10월 13일.
- [RFC 9457: Problem Details for HTTP APIs](https://www.rfc-editor.org/rfc/rfc9457), 2023.
- Jeremy Howard, [/llms.txt: a proposal to provide information to help LLMs use websites](https://www.answer.ai/posts/2024-09-03-llmstxt.html), Answer.AI, 2024년 9월 3일, 그리고 [AGENTS.md](https://agents.md/).
================================================================================
---
title: "제약은 옮겨 갑니다: Agentic Engineering Days Zurich에서 보낸 하루"
url: https://raskell.io/ko/articles/agentic-engineering-days-zurich-2026/
author: Raffael Schneider
date: 2026-11-20
description: "Agentic Engineering Days Zurich 2026의 일곱 개 발표와 그것들을 꿰는 실마리입니다. 에이전트는 제약을 없애지 않고 다른 곳으로 옮깁니다."
tags: [agents, agent-harness, agent-protocols, data-fusion, multiplayer-work, switzerland]
lang: ko
translation_of: https://raskell.io/articles/agentic-engineering-days-zurich-2026/
---
# 제약은 옮겨 갑니다: Agentic Engineering Days Zurich에서 보낸 하루
## 요약
Agentic Engineering Days Zurich 2026은 취리히 중앙역 옆 호텔에서 열린, 매진된 하루짜리 행사였습니다. 344건의 제출 가운데 40개 세션이 선정되었고, 가장 좋았던 것은 사람들이었습니다. Pini Reznik의 발표 소개글이 그날을 보는 렌즈가 되었습니다. AI는 제약을 없애지 않고 옮깁니다. 제가 본 모든 발표는 그 제약이 어디로 가야 하는지에 대한 하나의 답이었습니다. Exasol은 데이터 융합을 데이터베이스 안으로 옮겨서 에이전트가 호출할 때마다 통합의 부담을 지지 않게 하자고 주장했습니다. 후원 발표였고, 제가 가장 먼저 시험해 볼 발표이기도 합니다. 프로토콜 발표는 불확실성을 가장 많이 줄이는 가장 단순한 프로토콜이 이긴다고 말했습니다. NVIDIA의 NOOA는 에이전트를 다시 타입이 있는 소프트웨어로 되돌렸고, 저는 그 타입을 검사할 컴파일러를 원하게 되었습니다. GitHub Next는 제약이 팀의 합의로 옮겨 가는 모습을 보여 주었습니다. 이는 사람과 에이전트가 함께하는 공유된 대화로서의 일, 그리고 그 안에 머무는 결정을 가리킵니다.
금요일에 저는 동료 몇 명과 함께 [Agentic Engineering Days Zurich](https://www.agenticdays.com/)에서 하루를 보냈습니다. 행사는 취리히 중앙역 옆 Marriott에서 하루 동안 열렸고, [letsboot.ch](https://www.letsboot.ch/)가 주최했습니다. 344건의 제출 가운데 40개 세션이 선정되어 다섯 개의 방에서 진행되었고, 표는 매진되었습니다. 내년에는 더 큰 장소에서 이틀 동안 열린다고 하니, 올해가 어땠는지 짐작할 수 있습니다.
Jonas와 Barbara Felix, 그리고 그들의 팀이 이 모든 것을 준비했고, 첫 회치고는 거의 흠잡을 데가 없었습니다. 방도 제시간에, 발표도 제시간에, 음식도 좋았고, 아페로(apéro)는 발표가 시작한 대화를 이어 가기에 충분히 길었습니다. 두 분께 감사드립니다.
개막 30분 전, 취리히 중앙역 Marriott의 로비입니다. 제가 기억하는 대화 대부분은 발표장이 아니라 이곳에서 있었습니다.
발표자 중 일부는 몇 년 전 스위스 클라우드 네이티브 커뮤니티의 사람들이었고, 이제는 다음 일을 하고 있었습니다. 제가 찾아간 세션은 그쪽이 아니었습니다. 저는 나머지 우리가 쓰는 부품을 만드는 사람들을 보러 갔고, 프로그램에는 그런 사람들이 있었습니다. NVIDIA, GitHub, Red Hat과 IBM, Google, 그리고 Exasol의 데이터베이스 창업자입니다. 저는 일곱 개의 발표를 들었고, 예상보다 흥미로운 사람들을 많이 만났으며, 내려놓을 수 없는 문장 하나를 가지고 돌아왔습니다.
## 제약은 옮겨 갑니다 {#the-constraint-moves}
그 문장은 Pini Reznik의 것입니다. 그는 Container Solutions를 공동 창업했고 O'Reilly에서 [Cloud Native Transformation](https://www.oreilly.com/pub/au/7845)을 썼으며, 지금은 re:cinq를 이끌고 있습니다. "From Copilot to the Dark Factory"의 소개글은 회사가 모든 직원에게 코딩 어시스턴트를 사 줄 때 무슨 일이 일어나는지 설명합니다. 개인은 빨라지지만 "PR의 양이 늘고, 리뷰 대기열이 길어지고, 테스트는 약해지며, 컨텍스트와 보안과 플랫폼의 병목이 드러납니다." 그리고 이 문장이 이어집니다. "AI는 제약을 없애지 않습니다. 옮길 뿐입니다."(AI does not remove the constraint; it moves it.)
Goldratt를 읽은 사람이라면 이 모양을 알아볼 것이고, 저도 일주일 전에 [Every layer moves the uncertainty](https://raskell.io/notes/every-layer-moves-the-uncertainty/)에서 비슷한 이야기를 썼습니다. 금요일에 이 문장이 쓸모 있었던 것은, 서로 관계없는 발표들로 이루어진 프로그램을 하나의 질문으로 바꾸어 주었기 때문입니다. 코딩 어시스턴트는 제약을 타이핑에서 리뷰로 옮깁니다. 다섯 개 시스템에 접근하는 에이전트는 제약을 통합 계층에서 에이전트 안으로 옮깁니다. 그래서 저는 발표마다 제약이 어디로 갔는지, 그리고 그곳이 제약이 있기에 좋은 자리인지 물었습니다.
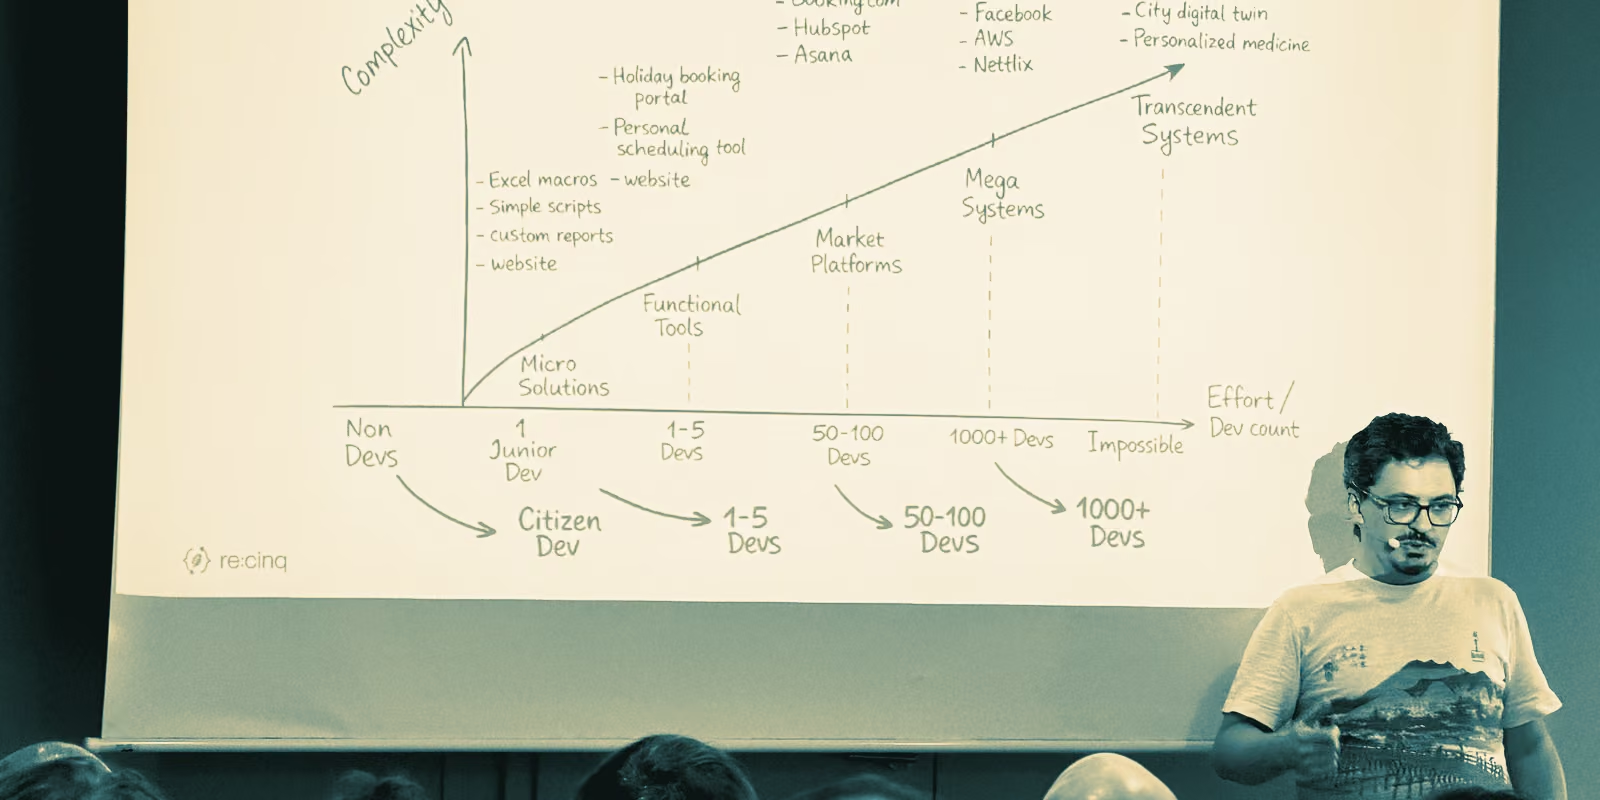
Reznik의 발표는 이 이동을 "Who Builds Software with AI?"라는 차트로 그렸습니다. 한 축은 복잡도, 다른 축은 시스템에 필요한 개발자 수입니다. 원점 가까이에 Excel 매크로와 간단한 스크립트가 있고, 그다음은 개발자 한 명에서 다섯 명이 만드는 기능적 도구, 쉰 명에서 백 명이 필요한 Booking.com과 HubSpot 같은 시장 플랫폼, 천 명이 넘게 필요한 Google Search와 AWS 같은 거대 시스템이 있습니다. 그 너머의 축에는 "Impossible"이라고 쓰여 있고, 기후 시뮬레이터, 도시 디지털 트윈, 개인 맞춤 의료가 예로 나옵니다. 그의 빨간 화살표는 모든 구간을 왼쪽으로 한 칸씩 옮겼습니다. 비개발자는 시민 개발자가 되고, 다섯 명의 팀이 예전에는 백 명이 필요하던 것을 만들며, 축의 끝은 더 이상 불가능이 아닙니다. 이것이 대체로 맞다면, 희소한 것은 더 이상 코드를 쓸 줄 아는 사람이 아닙니다. 한 팀이 혼자서는 할 수 없는, 코드를 둘러싼 모든 것입니다. 그의 마지막 슬라이드는 그에 대해 무엇을 해야 하는지 말했습니다. "제약을 찾으십시오. 역량을 만드십시오. 반복하십시오."(Find the constraint. Build the capability. Repeat.) 긴 버전은 그가 Michael Müller와 함께 쓴 책 [From Cloud Native to AI Native](https://re-cinq.com/whitepapers)이고, re:cinq가 무료로 배포합니다.
re:cinq의 Pini Reznik이 "Who Builds Software with AI?" 차트 앞에 서 있습니다. 복잡도의 모든 구간이 왼쪽으로 한 칸씩 옮겨 가고, "Impossible"은 더 이상 축의 끝이 아닙니다.
| 발표 | 제약이 옮겨 간 곳 |
|---|---|
| Wrike, 운영 중인 SRE 에이전트 | 아무도 테스트하지 않는 컨텍스트 안으로 |
| Exasol, Beyond MCP | 에이전트 밖으로, 데이터베이스 안으로 |
| Red Hat과 IBM, Agents Speak Protocol | 개별 통합 밖으로, 각 경계의 계약 안으로 |
| NVIDIA, NOOA | 프롬프트 밖으로, 다시 평범한 타입 있는 소프트웨어 안으로 |
| GitHub Next, 협업 환경 | 코드를 쓰는 일에서 무엇을 쓸지 합의하는 일로 |
| Typeform, When Software Stops Being Deterministic | 테스트 스위트에서 평가와 트레이스로 |
| re:cinq, From Copilot to the Dark Factory | 코드를 쓰는 사람들에서 명세와 검사를 쓰는 사람들로 |
## 통합 계층으로서의 에이전트 {#the-agent-as-the-integration-layer}
제 아침은 Wrike의 David Pech, 그리고 몇 달째 운영 환경에서 돌아가는 SRE 에이전트로 시작했습니다. 그의 소개글은 이런 에이전트 대부분을 "트렌치코트를 입은, 겨우 주니어 수준의 시스템 관리자"라고 묘사하고, 그가 든 교훈은 모델에 관한 것이 아니었습니다. 프레임워크는 예상보다 덜 중요했고, 오해를 부르는 문서는 에이전트를 오도했으며, 아무도 테스트하지 않는 컨텍스트는 버전이 바뀔 때마다 조용히 나빠졌습니다. 저는 발표 제목이 에이전트 자신의 지침에 있는 한 줄이라고 짐작하며, 이런 에이전트를 만드는 팀이라면 결국 모두 그 줄을 쓰게 된다고 생각합니다.
한 시간 뒤 Alexander Stigsen은 같은 문제를 한 층 아래에서 다루었습니다. Stigsen은 2019년 MongoDB가 인수한 모바일 데이터베이스 [Realm](https://en.wikipedia.org/wiki/Realm_(database))을 창업했고, 지금은 뉘른베르크의 인메모리 분석 데이터베이스 [Exasol](https://www.exasol.com/)의 Chief Product and Technology Officer입니다. 그의 발표 "Beyond MCP"는 후원 세션이자 제품 홍보였습니다. 이 점을 먼저 밝히는 이유는, 그것이 제가 다루는 문제에 대한 가장 명확한 진단이기도 했기 때문입니다.
에이전트에게 시스템마다 MCP 서버 하나씩, 즉 CRM, 청구, 지원 시스템을 주면 에이전트가 여러분의 통합 계층이 됩니다. 에이전트는 모든 도구 스키마와 모든 원시 결과를 컨텍스트에 담는 비용을 치르고, 소스마다 한 번씩 왕복하며, 쿼리 플래너 없이 데이터를 조인하고, 소스 사이에서 아무것도 캐시하지 않으며, 같은 고객의 세 가지 표기를 호출할 때마다 맞춥니다. 그의 슬라이드는 일곱 가지 비용을 나열하고 한 줄로 요약했습니다. "에이전트가 통합의 부담을 집니다."(The agent carries the integration burden.) 소개글은 뻔한 해결책을 배제하는 제약을 덧붙입니다. "규제받는 조직은 그것을 전부 하나의 AI 플랫폼으로 복사할 수 없습니다."
그의 답은 데이터가 있는 곳에서 쿼리하는 연합(federated) 데이터베이스 위에 MCP 인터페이스 하나를 두고, 각 소스의 어휘를 공유된 비즈니스 개념에 대응시키는 시맨틱 계층을 두는 것이었습니다. CRM의 `account_id`와 청구 시스템의 `customer_ref`는 하나의 고객 정체성이 되고, 송장과 환불과 통화는 CHF 기준 순매출이 됩니다. 시맨틱 계층은 하나이고, 모든 에이전트가 그것을 재사용합니다.
저는 데이터 융합을 하나의 개념으로 알고 있었습니다. 제가 생각해 보지 못한 것은 그것을 영속성 계층 안에 두는 것입니다. 그러면 저장소가 무거운 일을 한 번 하고 모든 에이전트가 그 결과를 받습니다. 이는 [Context is cheaper than exploration](https://raskell.io/notes/context-is-cheaper-than-exploration/)의 주장을 한 층 아래로 내린 것이고, [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/)의 패턴과 직접 맞닿아 있습니다. 그 글에서 융합은 파이프라인입니다. 각 소스의 관찰, 워크플로 단계로서의 정체성 해석, PostgreSQL의 엔티티와 엣지, 그리고 근거와 신뢰도를 담은 모든 연결입니다.
반론은 쉽게 나오고, 저도 스스로에게 그 반론을 제기합니다. 쿼리 시점에 융합하는 데이터베이스는 제약을 다시 옮깁니다. 제가 통제하지 못하는 제품 안으로요. 그리고 제가 가장 신경 쓰는 의미, 즉 어떤 소스를 신뢰할지와 일치가 얼마나 확실한지는 바로 파이프라인이 명시적으로 만드는 것입니다. Exasol 자신의 [문서](https://docs.exasol.com/db/latest/ai/ai_build_agents/mcp-server-as-agent-tool.htm)도 MCP 서버만 가진 에이전트가 Exasol의 방언을 무시하는 SQL을 쓸 수 있다고 경고합니다. 그래서 저는 이것을 슬라이드만 보고 결정하지 않겠습니다. 월요일에 참조 구현을 상대로 시험을 시작하며, 그 질문은 [Data fusion belongs in the store](https://raskell.io/notes/data-fusion-belongs-in-the-store/)에 적어 두었습니다.
## 표준을 쓴 사람들 {#the-people-who-wrote-the-standards}
다음 발표는 Stefano Maestri와 Alessio Soldano가 맡았고, 프로토콜 뒤에 있는 사람들을 직접 보는 것은 즐거운 일이었습니다. Maestri는 IBM을 대표해 [A2A Technical Steering Committee](https://github.com/a2aproject/A2A/blob/main/GOVERNANCE.md)에 참여하고 있으며 [A2A Java SDK](https://quarkus.io/blog/a2a-project-launches-java-sdk)의 출시 글을 썼습니다. Soldano는 Red Hat에서 RESTEasy를 이끌었고 Apache CXF의 커미터입니다. 두 사람은 SOAP 대 REST를 안에서 겪었고, 발표는 그 역사 위에 세워져 있었습니다.
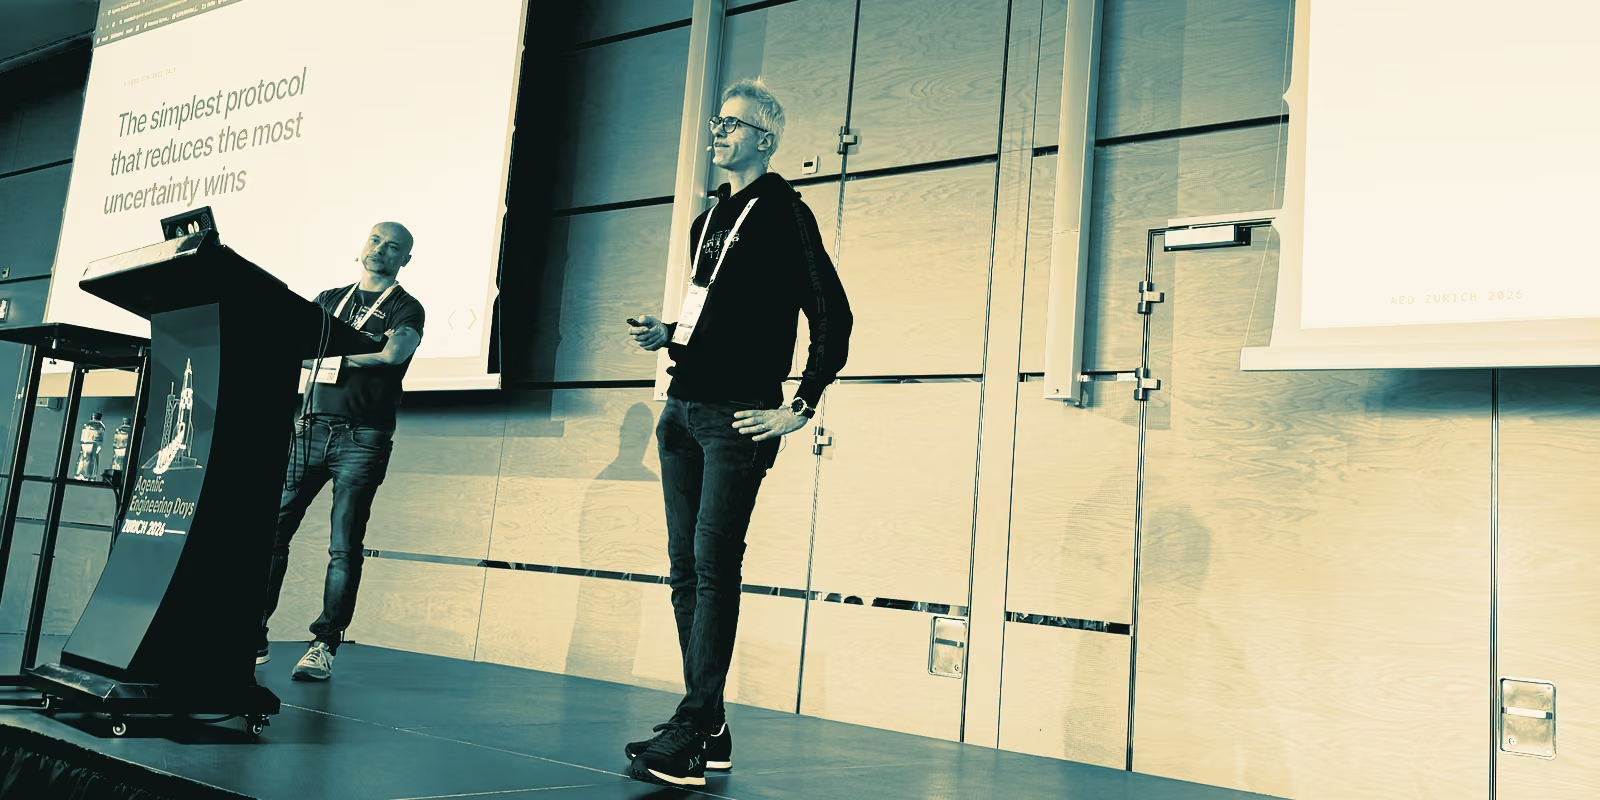
Stefano Maestri(왼쪽, 연단)와 Alessio Soldano가 발표의 렌즈 아래 서 있습니다. "불확실성을 가장 많이 줄이는 가장 단순한 프로토콜이 이깁니다."
그들의 렌즈는 "불확실성을 가장 많이 줄이는 가장 단순한 프로토콜이 이깁니다"(The simplest protocol that reduces the most uncertainty wins)였습니다. 그들의 지도는 가운데에 에이전트를 두고 각 경계에 합의를 두었습니다. 모델 쪽으로는 Open Responses, 도구 쪽으로는 MCP, 다른 에이전트 쪽으로는 A2A, 사용자 쪽으로는 AG-UI와 A2UI, 지식 쪽으로는 AGENTS.md와 Skills, 운영 쪽으로는 OpenTelemetry GenAI, 에디터 쪽으로는 ACP, 결제 쪽으로는 x402입니다. 지도 아래의 질문은 "무엇을 교체 가능하게 만들고 싶습니까?"였습니다.
발표는 추상적이었고, 이야기라기보다 지도였습니다. 하나의 시스템을 처음부터 끝까지 따라가 주었으면 좋았을 것입니다. 하지만 그 지도는 방금 나온 Exasol 발표에 대해 더 나은 질문을 주었습니다. "MCP 인터페이스 하나"는 하나의 경계에 거는 내기입니다. 에이전트는 표준 계약을 유지하고, 그 뒤의 데이터는 교체 가능해집니다. 이것은 시맨틱 계층이 제품이 아니라 계약과 함께 움직일 때만 참이고, 제가 확인하려는 것이 바로 그것입니다. 그들의 덱에서 제가 계속 떠올리는 문장은 "채널을 여는 것은 합의가 아닙니다"(Opening a channel is not the agreement)입니다. MCP 서버는 채널을 엽니다. 고객이 무엇을 뜻하는지가 합의입니다. 자세한 내용은 [The simplest protocol that reduces the most uncertainty wins](https://raskell.io/notes/the-simplest-protocol-wins/)에 있습니다.
## 모든 것이 다시 소프트웨어입니다 {#everything-is-software-again}
저는 NVIDIA가 여름에 [NOOA](https://github.com/NVIDIA-NeMo/labs-OO-Agents)를 공개했을 때 살펴보았지만 시험해 볼 오후를 끝내 찾지 못했습니다. 그래서 Matt Staats가 직접 설명하는 것을 들을 수 있어 반가웠습니다. Staats는 테스트에 관한 박사 논문을 썼고, 테스트 오라클, 즉 프로그램의 출력이 옳은지 어떻게 아는가라는 질문에 관한 [수상 경력의 ICSE 논문](https://bibtex.github.io/ICSE-2011-StaatsWH11a.html)을 썼습니다. 지금 에이전트를 평가하는 일을 하는 사람에게 좋은 배경입니다. 그의 소개글은 "에이전트는 모델을 둘러싼 하네스만큼만 좋습니다"로 시작합니다.
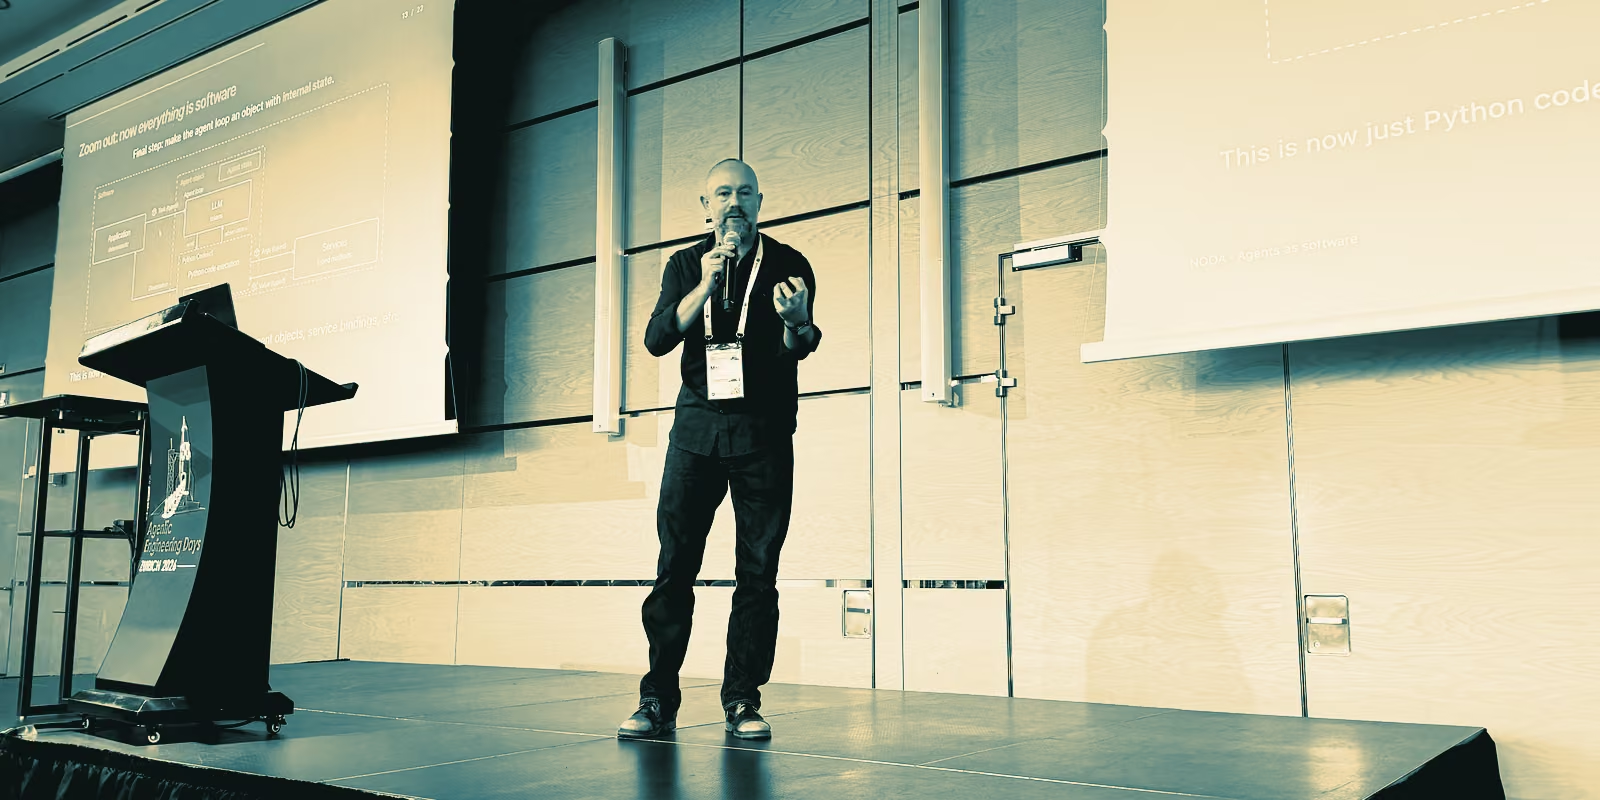
NVIDIA의 Matt Staats가 "Zoom out: now everything is software" 슬라이드 앞에 서 있습니다. 에이전트 루프가 내부 상태를 가진 객체가 되는 슬라이드입니다.
NOOA는 에이전트를 Python 클래스로 다룹니다. 메서드는 능력이고, 필드는 상태이며, docstring은 프롬프트이고, 시그니처는 계약입니다. 본문이 비어 있는 메서드는 런타임에 모델이 완성하며, 모델은 타입이 있는 서비스를 호출하는 Python을 써서 행동합니다. [Wang et al.](https://arxiv.org/abs/2402.01030)의 CodeAct 아이디어입니다. NVIDIA의 [글](https://developer.nvidia.com/blog/six-agent-harness-capabilities-for-higher-model-performance/)은 여섯 가지 능력을 꼽습니다. 타입이 있는 입력과 출력, 참조에 의한 전달, 행동으로서의 코드, 프로그래밍 가능한 루프 엔지니어링, 명시적인 객체 상태, 모델이 호출할 수 있는 하네스 API입니다. 이 글은 GPT-5.5로 SWE-bench Verified에서 82.2%를 보고하는데, 이는 NVIDIA의 숫자이지 제 숫자가 아닙니다. 제게 남은 슬라이드는 "Zoom out: now everything is software"였습니다. 에이전트 루프는 내부 상태를 가진 객체가 되고, 타입이 있는 작업을 받아 타입이 있는 값을 돌려주는 결정론적 애플리케이션이 그것을 호출합니다. 다음 슬라이드의 예제는 여기에 실을 만큼 작았습니다. 슬라이드에 적혀 있듯 NOOA의 프레임워크 소개에서 가져와 고친 것이고, `llm`은 설정된 클라이언트입니다.
```python
from nooa import Agent
ItemPrice = tuple[str, float]
CategoryTotal = tuple[str, float]
class BillingAgent(Agent, llm=llm):
categories: set[str] = {"food", "travel", "other"}
async def categorize(self, prices: list[ItemPrice]) -> list[CategoryTotal]:
"""Group items by self.categories; sum prices for each category."""
...
async def run(self, raw: list[ItemPrice]) -> list[CategoryTotal]:
prices = []
for item, price in raw:
if price >= 0: prices.append((item, price))
return await self.categorize(prices)
```
`run`은 평범한 Python이고, 여느 프로그램처럼 입력을 거릅니다. `categorize`에는 본문이 없습니다. `...`가 그것을 모델에 넘기고, docstring이 프롬프트이며, 시그니처가 무엇이 돌아와야 하는지 말합니다. 판단은 위임되지만 계약은 위임되지 않습니다.
Staats가 보여 준 결과는 메모리에 관한 것이었고, 같은 모델과 같은 스킬로 ARC-AGI-3 게임에서 측정했습니다. 에이전트가 Markdown으로 자기 메모를 남기게 했을 때는 38.4%에 도달했고, NOOA의 메모리 API로는 50.2%에 도달했습니다. 에이전트들은 3,262개의 메모리를 썼지만, 자동 회상은 턴마다 평균 4.1개만 불러왔기 때문에 컨텍스트 창은 작게 유지되었습니다. 그다음 슬라이드의 제목은 "Software is cheaper than thinking", 부제는 "even if software is doing the thinking"이었습니다. Markdown 실행의 점수에 도달하는 데, 월드 모델과 메모리 API를 쓴 버전은 추정 API 비용으로 약 1,040달러가 아니라 약 290달러를 썼습니다. 하네스가 관리하는 구조화된 메모리가 모델이 다시 읽어야 하는 메모를 이깁니다. 그리고 수천 개 중 네 개를 불러오는 회상은 [strategic forgetting](https://raskell.io/notes/strategic-forgetting/)의 한 형태이며, 이번에는 가격표가 붙어 있습니다.
이것은 제가 본 것 중 제약을 가장 설득력 있게 옮긴 사례입니다. 프롬프트와 느슨한 도구 목록은 리뷰하고, 버전을 관리하고, 테스트하기 어렵습니다. 시그니처가 있는 클래스는 그렇지 않습니다. 이는 제가 [Tools: How Agents Actually Do Things](https://raskell.io/articles/tools-how-agents-actually-do-things/)에서 설명한 것과 가깝고, 제가 간 것보다 더 멀리 나아갔습니다.
제가 계속 생각한 것은 타입을 강제하지 않는 언어에서 쓰이는 "타입이 있는"이라는 말이었습니다. Python에서 애플리케이션과 에이전트 사이의 계약은 호출이 일어날 때 검사되고, NOOA는 출력이 맞을 때까지 재시도합니다. 컴파일러가 계약을 강제하는 언어라면, 타입이 맞을 때까지 프로그램이 빌드되지 않을 것입니다. 그래서 저는 [bhc](https://arcanist.sh/bhc/)로 돌아가, 추론과 하네스 바인딩이 그곳에서 네이티브 기본 요소가 될 수 있는지, 에이전트 호출이 다른 효과처럼 타입을 가질 수 있는지 생각하게 되었습니다. 그것이 라이브러리인지, 언어 기능인지, 나쁜 아이디어인지는 아직 모릅니다. 덜 다듬어진 버전은 [Harness types in the compiler](https://raskell.io/notes/harness-types-in-the-compiler/)에 있습니다.
## 제약은 합의에 내려앉습니다 {#the-constraint-lands-on-alignment}
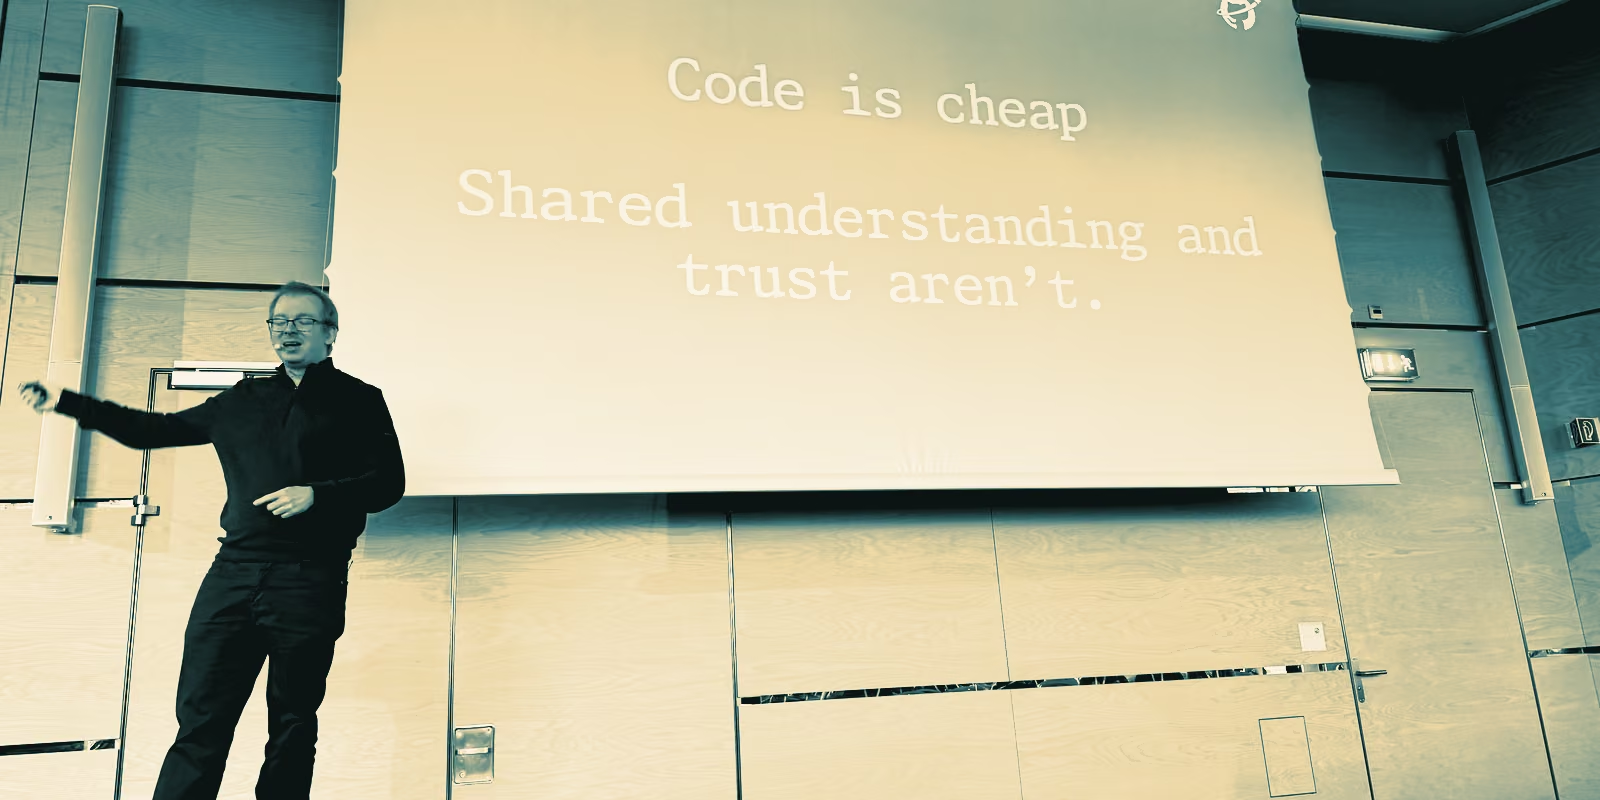
그날 가장 비전 있는 발표는 GitHub Next의 Krzysztof Cieślak이 했습니다. 그는 F# 도구인 Ionide를 만들었고, 스스로를 Copilot의 공동 창작자로 소개합니다. 그의 소개글은 "에이전틱 엔지니어링은 지금까지 혼자만의 이야기였습니다"라고 말하며, 이는 제 경험과 일치합니다. 한 사람, 여러 에이전트, 많은 산출물, 그리고 방에는 아무도 없습니다. 한 슬라이드는 "대부분의 AI 도구는 개발자 한 명의 생산성에 집중합니다"라고 했고, 방의 반응을 얻은 슬라이드는 "코드는 쌉니다. 공유된 이해와 신뢰는 그렇지 않습니다"(Code is cheap. Shared understanding and trust aren't.)라고 했습니다.
GitHub Next의 Krzysztof Cieślak: "코드는 쌉니다. 공유된 이해와 신뢰는 그렇지 않습니다." 방의 반응을 얻은 슬라이드입니다.
그는 두 개의 연구 프로토타입을 보여 주었습니다. Ace는 팀, 그 팀의 채팅, 코딩 에이전트, 그리고 에이전트의 microVM을 하나의 공유 작업 공간에 넣습니다. 그 후속인 [Chopin](https://githubnext.com/projects/chopin/)은 "실시간 멀티플레이어 에이전틱 계획 환경"으로, 동료와 에이전트가 저장소를 중심으로 함께 계획을 쓰고 모두가 볼 수 있는 곳에서 결정을 내립니다. GitHub Next는 Chopin을 "제품도 아니고 완성된 프로토타입도 아니다"라고 조심스럽게 말하며, Ace는 중단된 상태입니다.
그 뒤에 있는 주장은 다시 Reznik의 문장입니다. GitHub Next의 Maggie Appleton은 올해 초 이를 한 줄로 [표현했습니다](https://maggieappleton.com/zero-alignment). "무엇을 만들지 합의하는 것이 새로운 병목입니다." 에이전트가 코드를 싸게 만들면, 제약은 코드가 무엇이어야 하는지에 관한 대화로 옮겨 가고, 풀 리퀘스트와 이슈와 채팅은 그런 속도의 그런 대화를 위해 만들어지지 않았습니다.
저는 일이 이쪽으로 가고 있다고 믿습니다. 여러 사람과 여러 에이전트가 함께하는 공유된 대화이고, 결정과 설계와 코드가 그 대화 안에서 만들어지고 그 대화에 붙어 남습니다. 이것을 보며 [Zed](https://zed.dev/)가 떠올랐습니다. 에이전트가 화제가 되기 훨씬 전부터 그 비전이 좋아서 일찍부터 썼던 에디터입니다. Zed는 Rust로 쓰였고, [그들의 표현](https://zed.dev/blog/videogame)으로는 자체 GPU 프레임워크 위에서 "비디오게임처럼 렌더링"되며, 처음부터 멀티플레이어였습니다. 올해 그들은 "그 사이의 모든 작업을 포착하고 각각에 안정적인 정체성을 부여하는" 버전 관리 [DeltaDB](https://zed.dev/blog/introducing-deltadb)를 발표했고, 그 위에 만든 [Delta](https://zed.dev/blog/introducing-delta)의 발표문은 "이제 소프트웨어가 일어나는 곳은 스레드이며, 인터페이스는 그것을 반영해야 합니다"라고 말합니다. Zed는 시대를 앞서 나왔고 그 과정에서 동력을 조금 잃었습니다. 저는 여전히 그들을 응원합니다. 자세한 내용은 [The conversation is the workspace](https://raskell.io/notes/the-conversation-is-the-workspace/)에 있습니다.
## 결정론, 그리고 다크 팩토리 {#determinism-and-the-dark-factory}
제 오후는 Typeform의 스태프 엔지니어 Susanna Wong의 발표로 마무리되었습니다. 소프트웨어가 결정론적이기를 멈출 때 무슨 일이 일어나는지에 관한 발표였습니다. 우리의 엔지니어링 관행 대부분은 같은 입력이 같은 출력을 준다고 가정합니다. 그녀의 소개글은 이를 분명히 말합니다. "LLM 시스템은 그 가정을 깹니다." 발표는 Typeform이 무엇을 바꿔야 했는지 짚었습니다. 테스트 스위트 대신 지속적인 평가, 로그 대신 트레이스, 엔지니어링 산출물로서 리뷰되는 프롬프트, 그리고 두 번 같은 방식으로 동작하지 않는 구성 요소를 둘러싼 오케스트레이션입니다. 이는 [Evaluation Closes the Loop](https://raskell.io/articles/evaluation-closes-the-loop/)가 다루는 영역이고, 제품에서 그것을 직접 겪어야 했던 사람에게서 듣는 것이 좋았습니다.
그녀의 마지막 슬라이드에는 "The one thing to take home"이라는 제목이 붙어 있었고, "프롬프트는 수율을 삽니다. 시스템은 보장을 삽니다"(Prompts buy yield. Systems buy guarantees.)라고 쓰여 있었습니다. 그 아래에는 "신뢰성은 모델이 아니라 시스템의 속성입니다." 그리고 맨 아래 작은 글씨로, 그날의 문장이 다른 형태로 쓰여 있었습니다. "결정론은 사라지지 않았습니다. 옮겨 갔습니다. 모델 밖으로, 그것을 둘러싼 시스템 안으로." 프롬프트는 좋은 답의 비율을 높일 수 있습니다. 모델을 둘러싼 시스템, 즉 평가, 재시도, 타입이 있는 계약, 승인하는 사람만이 무언가를 약속할 수 있습니다.
그녀의 발표는 Reznik의 다크 팩토리가 이르는 곳이기도 합니다. 이 용어는 무인(lights-out) 제조에서 왔고, Dan Shapiro가 말한 AI 코딩의 [다섯 단계](https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/)는 그것으로 끝납니다. "명세를 소프트웨어로 바꾸는 블랙박스"입니다. Simon Willison의 [요약](https://simonwillison.net/2026/Jan/28/the-five-levels/)은 "로봇은 볼 필요가 없기 때문에 불이 꺼져 있는" 공장을 그립니다. 그곳에 이르기 위한 Reznik의 여섯 시스템은 오케스트레이션, 샌드박스, 컨텍스트, 검증, 거버넌스, 학습 루프이며, 그중 어느 것도 모델이 아닙니다. 불을 끄면 제약은 사람에게 남은 두 가지로 옮겨 갑니다. 명세를 쓰는 일, 그리고 출력이 옳은지 아는 일입니다. 그것이 Wong의 발표이고, Staats의 오래된 분야입니다.
## 제가 가지고 돌아온 것 {#what-i-took-home}
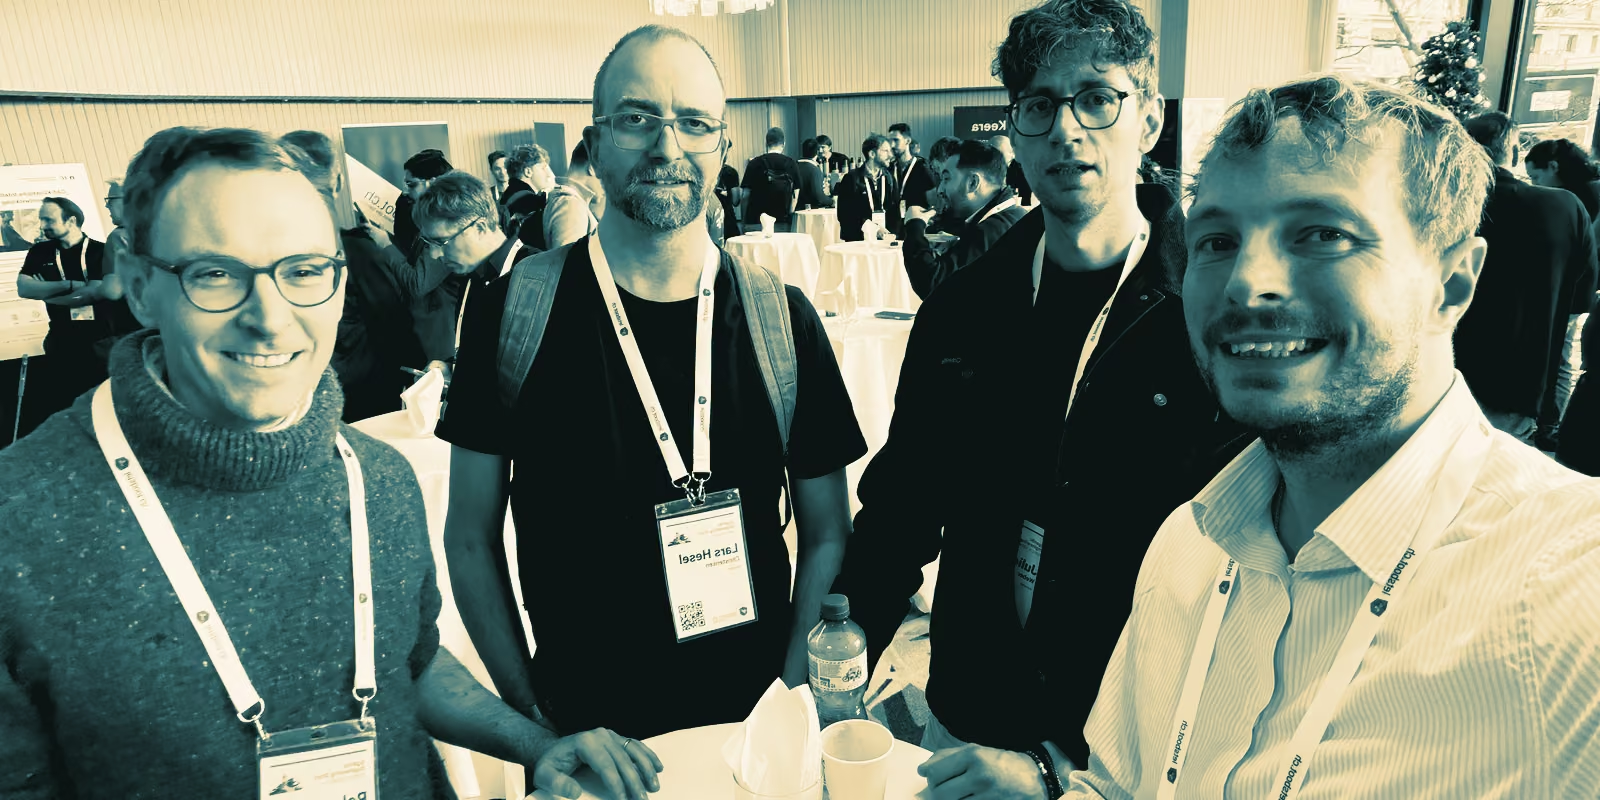
아페로에서 동료들과 함께. 어떤 발표도 대신할 수 없는 컨퍼런스의 한 부분입니다.
발표들은 좋았고, 하루는 그보다 더 좋았습니다. 주로 발표 사이사이, 그리고 아페로에서 동료들과 나눈 대화 덕분이었습니다. 하지만 하나만 남긴다면, Reznik의 문장이 준 습관입니다. 제가 본 모든 발표는 제약을 옮겼습니다. 데이터베이스 안으로, 프로토콜 안으로, 타입 안으로, 공유된 대화 안으로, 평가 안으로. 어느 것도 제약을 사라지게 하지 않았습니다. 새로운 에이전트 도구에 대해 물을 쓸모 있는 질문은 그것이 무엇을 없애는가가 아니라 일을 어디에 두는가, 그리고 그곳이 제가 보고, 테스트하고, 책임질 수 있는 자리인가입니다.
해 질 녘의 취리히 중앙역, Basel로 돌아가는 길입니다.
## 참고 자료 {#references}
- [Agentic Engineering Days Zurich 2026, programme](https://www.agenticdays.com/sessions)
- Pini Reznik, [From Copilot to the Dark Factory](https://www.agenticdays.com/session/1301641-from-copilot-to-the-dark-factory), 세션 소개글
- David Pech, ["YOU MUST NOT ssh!" and Other Stories from Building Our SRE Agent](https://www.agenticdays.com/session/1250380-you-must-not-ssh-and-other-stories-from-building-our-sre), 세션 소개글
- Alexander Stigsen, [Beyond MCP: Supercharging your agents with a single unified data plane](https://www.agenticdays.com/session/1368894-beyond-mcp-supercharging-your-agents-with-a-single-unified), 세션 소개글
- Exasol, [MCP Server as an agent tool](https://docs.exasol.com/db/latest/ai/ai_build_agents/mcp-server-as-agent-tool.htm)
- Stefano Maestri and Alessio Soldano, [Agents Speak Protocol](https://maeste.it/agents-speak-protocol-aed/), 덱과 [sources](https://maeste.it/agents-speak-protocol-aed/sources.html)
- A2A project, [GOVERNANCE.md](https://github.com/a2aproject/A2A/blob/main/GOVERNANCE.md)
- Matt Staats, [NOOA: Inside NVIDIA's Object-Oriented Agent Harness](https://www.agenticdays.com/session/1305345-nooa-inside-nvidia-s-object-oriented-agent-harness), 세션 소개글
- NVIDIA, [NVIDIA-NeMo/labs-OO-Agents](https://github.com/NVIDIA-NeMo/labs-OO-Agents) and [Six Agent Harness Capabilities for Higher Model Performance](https://developer.nvidia.com/blog/six-agent-harness-capabilities-for-higher-model-performance/)
- Xingyao Wang et al., [Executable Code Actions Elicit Better LLM Agents](https://arxiv.org/abs/2402.01030), ICML 2024
- Matt Staats, Michael W. Whalen and Mats P. E. Heimdahl, [Programs, Tests, and Oracles: The Foundations of Testing Revisited](https://bibtex.github.io/ICSE-2011-StaatsWH11a.html), ICSE 2011
- Krzysztof Cieślak, [The next frontier: agentic collaborative environments](https://www.agenticdays.com/session/1283743-the-next-frontier-agentic-collaborative-environments), 세션 소개글; GitHub Next, [Chopin](https://githubnext.com/projects/chopin/)
- Maggie Appleton, [One Developer, Two Dozen Agents, Zero Alignment](https://maggieappleton.com/zero-alignment)
- Zed, [Leveraging Rust and the GPU to render user interfaces at 120 FPS](https://zed.dev/blog/videogame), [Software Is Made Between Commits](https://zed.dev/blog/introducing-deltadb) and [Introducing Delta](https://zed.dev/blog/introducing-delta)
- Susanna Wong, [When Software Stops Being Deterministic](https://www.agenticdays.com/session/1287383-when-software-stops-being-deterministic-rethinking), 세션 소개글
- Pini Reznik and Michael Müller, [From Cloud Native to AI Native](https://re-cinq.com/whitepapers)
- Susanna Wong, closing slide of the talk, photographed in the room
- Dan Shapiro, [The Five Levels: from Spicy Autocomplete to the Dark Factory](https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/)
- Simon Willison, [The five levels](https://simonwillison.net/2026/Jan/28/the-five-levels/)
================================================================================
---
title: "거의 무관해진 선택: 에이전트가 코드를 쓸 때 언어를 고르는 법"
url: https://raskell.io/ko/articles/almost-irrelevant/
author: Raffael Schneider
date: 2026-11-19
description: "에이전트가 코드 대부분을 쓰면 언어는 예전보다 덜 중요해지지만, 아무 의미가 없어지지는 않습니다. Rust, Go, Elixir, Haskell이 여전히 주는 것입니다."
tags: [programming-languages, ai-engineering, rust, golang, elixir, haskell, type-systems]
lang: ko
translation_of: https://raskell.io/articles/almost-irrelevant/
---
# 거의 무관해진 선택: 에이전트가 코드를 쓸 때 언어를 고르는 법
## 요약
코딩 에이전트는 예전에 언어 선택을 좌우하던 비용, 즉 학습 곡선, 보일러플레이트, 채용할 수 있는 인력의 규모를 대신 떠안습니다. 그래서 언어 선택은 예전보다 훨씬 덜 중요해졌습니다. 남는 것은 에이전트가 떠난 뒤에 언어가 약속하는 것입니다. 컴파일러가 무엇을 검사하는지, 장애가 났을 때 런타임이 무엇을 하는지, 리뷰에서 코드가 어떻게 읽히는지, 회사 전체에서 코드가 어떻게 맞물리는지입니다. Rust는 무슨 일이 있어도 작동해야 하는 것들, 예전에 C와 C++가 차지하던 영역, 그리고 메인프레임 위의 COBOL 코어 시스템을 대체하는 일에 씁니다. Go는 회사 전체가 함께 쓰는 평이한 코드, 예전에 Java가 차지하던 영역에 씁니다. Elixir는 본질적으로 분산된 플랫폼과 한 사람이 운영하는 야심 찬 프로젝트에 쓰며, 타입은 아직 도입되는 중입니다. bhc를 통한 Haskell은 소프트웨어를 만드는 다른 방식에 거는 내기이고, 그 방식에서는 검증된 의미가 다시 쓰이는 대신 쌓여 갑니다. Python과 TypeScript는 노트북과 브라우저에서 제자리를 지킵니다. 그리고 사람들이 점점 더 많이 쓰는 것은 요구사항이며, 요구사항은 프로그래밍 언어가 아니라 Markdown과 JSON으로 쓰입니다.
에이전트가 코드 대부분을 쓴다면, 그 코드가 어떤 언어로 쓰이는지가 여전히 중요합니까?
제 경력 대부분 동안 언어 선택은 사람에 관한 선택이었습니다. 누구를 채용할 수 있는지, 생산성을 내기까지 얼마나 걸리는지, 그 사람들이 이미 무엇을 아는지, 그리고 첫 달에 빌림 검사기(borrow checker)를 얼마나 미워하게 될지였습니다. 이런 비용이 어떤 벤치마크보다 더 많은 언어 논쟁을 결정했고, 이제 그 비용은 대부분 무너졌습니다. 에이전트는 Python을 쓰는 것만큼 쉽게 관용적인 Rust를 씁니다. 보일러플레이트를 꺼리지 않고, 라이프타임을 익히는 데 한 달이 필요하지 않으며, 탭에 대한 의견도 없습니다. 팀들이 Rust, Elixir, Haskell을 멀리하게 만들던 학습 곡선은 이제 대체로 에이전트의 문제입니다.
그래서 제 답은 언어가 거의 무관해졌지만 완전히 그렇지는 않다는 것입니다. 언어는 언제나 타이핑하는 방식 이상의 것이었기 때문입니다. 언어는 무엇이 실행 전에 검사될지 정하는 컴파일러이기도 하고, 무언가 실패했을 때 무슨 일이 일어날지 정하는 런타임이기도 하며, 에이전트가 쓴 것을 사람이 얼마나 빨리 리뷰할 수 있는지 정하는 스타일이기도 하고, 코드가 조직이 가진 다른 모든 것과 어떻게 맞물릴지 정하는 모듈 시스템이기도 합니다. 그중 어느 것도 사라지지 않았고, 몇몇은 예전보다 더 중요해졌습니다.
프로그래밍 언어가 장기적으로 어디로 가는지는 [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/)에서 쓴 적이 있습니다. 이 글은 그 글의 실용적인 짝입니다. 제가 오늘 어떤 언어를, 무엇을 위해, 왜 집어 드는지에 관한 글입니다. 주관이 강한 글이고, 네 가지 언어를 다룹니다. 제가 쓰는 언어가 그 넷이기 때문입니다.
## 에이전트가 떠안는 것과 떠안지 않는 것 {#what-the-agent-absorbs-and-what-it-does-not}
arcanist.sh의 글 [The Scorecard Is Right. The Weights Are Wrong.](https://arcanist.sh/blog/the-scorecard-is-right-the-weights-are-wrong/)은 제가 계속 다시 떠올리는 주장 하나를 폈습니다. 흔히 보는 언어 스코어카드는 공정하지만, 그 가중치는 프로그램 전체를 머릿속에 담아야 하는 사람 저자를 전제한다는 것입니다. 저자가 바뀌면 가중치도 바뀝니다. 대략 이렇습니다.
| 언어가 요구하는 비용이나 주는 것 | 사람이 코드를 쓰던 때의 가중치 | 에이전트가 코드를 쓸 때의 가중치 |
|---|---|---|
| 학습 곡선, 형식적 절차, 보일러플레이트 | 높음 | 낮음: 에이전트가 치름 |
| 채용할 수 있는 인력의 규모 | 높음 | 낮아짐: 쓰는 사람은 줄고 리뷰하는 사람은 늘어남 |
| 실행 전에 컴파일러가 검사하는 것 | 중간 | 높음: 생성은 싸고, 검증이 병목임 |
| 리뷰어에게 코드가 어떻게 읽히는지 | 중간 | 높음: 모든 줄에는 여전히 읽는 사람이 필요함 |
| 빌드와 테스트 속도 | 중간 | 높음: 루프가 기계의 속도로 돎 |
| 부하와 장애 상황에서 런타임이 하는 일 | 높음 | 변함없음 |
| 생태계와 라이브러리 | 높음 | 여전히 높음: 에이전트도 라이브러리를 재사용함 |
가중치를 잃은 행은 쓰는 일에 관한 것이고, 가중치를 얻은 행은 쓰인 것을 신뢰하는 일에 관한 것입니다. 이것이 이 글의 나머지를 보는 렌즈입니다. 언어마다, 팀의 누구도 타이핑하지 않은 코드에 대해 그 언어가 무엇을 약속하는지 묻겠습니다.
예시들을 비교할 수 있도록, 아래의 모든 코드 조각은 같은 작은 요구사항의 한 부분을 다룹니다. 은행의 코어 시스템에 가득한 종류의 요구사항입니다. 계좌에 월 이자를 기장하되, 센트 단위에서 0에서 먼 쪽으로 반올림하고(round half away from zero), 해지된 계좌에는 절대 기장하지 않는다는 것입니다. 이 요구사항은 글 끝부분에, 앞으로 요구사항이 취하리라고 제가 생각하는 형태로 전부 적어 두었습니다.
## Rust: 작동해야 하는 것들을 위해 {#rust-for-things-that-have-to-work}
Rust는 예전에 C와 C++가 차지하던 영역을 차지합니다. 프록시, 운영체제, 런타임, 컴파일러, 엔진, 그리고 몇 달씩 실행되거나, 핫 패스에 놓이거나, 해를 끼치려는 사람들의 입력을 처리하는 모든 것입니다. 빌림 검사기는 가비지 컬렉터 없이 컴파일 시점에 메모리 안전성과 데이터 경쟁(data race)이 없음을 보장하고, 타입 시스템은 불변식을 컴파일러가 볼 수 있는 곳에 두는 것을 자연스럽게 만듭니다.
Rust의 유명한 비용은 빌림 검사기와의 싸움이었고, 그 싸움은 에이전트가 떠안는 종류의 비용입니다. Rust는 그것을 오히려 장점으로 바꿉니다. 컴파일러 오류가 정확하고, 국소적이고, 바로 조치할 수 있어서, 루프 안에서 일하는 모델에게 이상에 가까운 피드백이 되기 때문입니다. 에이전트가 제안하고, 컴파일러가 줄 번호와 제안을 붙여 이의를 제기하고, 에이전트가 고칩니다. 사람이 코드를 읽을 때쯤이면 한 부류의 실수 전체가 이미 사라져 있습니다.
두 스레드가 같은 원장에 항목을 덧붙일 때 그 피드백은 이런 모습입니다. 많은 언어에서는 이런 코드가 컴파일되고, 그다음 프로덕션에서 부하가 걸릴 때 가끔씩만 실패합니다.
```rust
let mut ledger = Vec::new();
let a = thread::spawn(move || ledger.push("interest"));
let b = thread::spawn(move || ledger.push("fees"));
```
```text
error[E0382]: use of moved value: `ledger`
--> src/main.rs:6:27
|
5 | let a = thread::spawn(move || ledger.push("interest"));
| ------- ------ variable moved due to use in closure
| |
| value moved into closure here
6 | let b = thread::spawn(move || ledger.push("fees"));
| ^^^^^^^ ------ use occurs due to use in closure
| |
| value used here after move
|
help: consider cloning the value before moving it into the closure
```
프로그램은 한 번도 실행되지 않고, 오류는 정확히 어디서 왜 문제인지 말해 줍니다. 이 예는 컴파일러의 한계, 그리고 사람이나 요구사항이 여전히 중요한 지점도 보여 줍니다. 제안된 수정, 즉 벡터를 복제하는 것은 컴파일되지만, 각 스레드에 저마다의 원장을 줍니다. 은행이 원하는 것은 그것이 아닙니다. 올바른 수정은 락 뒤에 놓인 하나의 공유 원장, `Arc>>`이고, 그것을 고르려면 코드가 무엇을 위한 것인지 알아야 합니다. 컴파일러는 에이전트의 선택지를 안전한 것들로 좁히고, 그중에서 고르는 것은 요구사항입니다.
이것이 대규모로 중요하다는 증거는 제 것이 아닙니다. Google은 2024년에 Android의 메모리 안전성 취약점 비율이 “개발이 메모리 안전 언어로 옮겨 가면서 6년 동안 76%에서 24%로” 떨어졌고, 문제는 “압도적으로 새 코드에 있다”고 보고했습니다([Google Security Blog](https://security.googleblog.com/2024/09/eliminating-memory-safety-vulnerabilities-Android.html)). 1년 뒤 같은 팀은 Rust의 메모리 안전성 취약점 밀도가 Android의 C와 C++보다 “1000배 넘게” 낮고, Rust 변경의 롤백 비율이 약 네 배 낮다고 보고했습니다([Google Security Blog](https://security.googleblog.com/2025/11/rust-in-android-move-fast-fix-things.html)). 에이전트가 곧 많은 새 코드를 쓰게 된다면, 그 새 코드가 자리 잡기에 가장 안전한 곳은 그런 실수가 컴파일되지 않는 언어입니다.
제가 만드는 것 대부분이 그 이유로 Rust로 되어 있습니다. 리버스 프록시인 [Zentinel](https://zentinelproxy.io/)은 다른 사람들의 트래픽 앞에 서 있습니다. 내구성 있는 실행 엔진(durable execution engine)인 Aqueduct는 크래시 후에 실행을 재생해 같은 결과에 이르러야 합니다(이유는 [The River and the Canal](https://raskell.io/articles/the-river-and-the-canal/)에서 설명했습니다). hx와 bhc는 다른 사람들의 빌드가 의존하는 툴체인입니다([Why We Built a Haskell Package Manager in Rust](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/)에 그 이야기가 있습니다). Shiioo는 제 컴퓨터에서 에이전트를 실행하고 그 에이전트들이 한 일을 기록해 둡니다([Shiioo, Re-imagined](https://raskell.io/articles/shiioo-reimagined-and-a-home-ai-lab/)). 이것들은 모두 실패하면 대가가 크고, 모두 정적 바이너리 하나로 배포됩니다.
같은 논리로, 이런 종류의 일 가운데 가장 큰 일에서도 Rust가 제 첫 번째 선택입니다. 은행, 보험사, 공공 행정이 여전히 메인프레임에서 운영하는 코어 시스템, 대부분 수십 년 전에 COBOL로 쓰인 시스템을 대체하는 일입니다. 그 시스템들은 작동합니다. 신뢰할 수 있고, 십진 산술을 정확하게 하며, 대체하려는 모든 시도를 견뎌 냈습니다. 대체로 그 코드 전부가 무엇을 하는지 누구도 자신 있게 말할 수 없기 때문입니다. 에이전트는 그 문제의 절반을 바꿉니다. 에이전트는 COBOL을 참을성 있게 읽고, 프로그램이 무엇을 하는지 설명하고, 지치지 않고 새 버전을 씁니다. 에이전트가 바꾸지 못하는 것은 새 시스템이 적어도 옛 시스템만큼 믿을 만해야 한다는 요구이고, 언어가 중요해지는 곳이 바로 거기입니다. Rust는 메인프레임 없이 메인프레임의 미덕을 줍니다. 정의되지 않은 동작(undefined behaviour)이 없고, 기장 작업 도중에 멈춰 서는 가비지 컬렉터가 없으며(Discord는 2020년에 바로 이 이유로 한 서비스를 Go에서 Rust로 옮겼습니다. 적어도 2분마다 실행되는 Go의 컬렉터가 [주기적인 지연 급증](https://discord.com/blog/why-discord-is-switching-from-go-to-rust)을 일으킨 뒤였습니다), 돈을 위한 [rust_decimal](https://docs.rs/rust_decimal/) 같은 정확한 십진 타입이 있고, 프로그램이 실행되기 전에 여러 부류의 실수를 통째로 거부하는 컴파일러가 있습니다. 이자 자체가 맞는지는 여전히 요구사항과 그 테스트가 말해야 할 몫이며, 앞에서 본 복제된 원장이 그것을 보여 줍니다.
돈에 관한 부분은 짧습니다. COBOL 프로그램은 금액을 고정소수점 십진수로 보관하고, 대체 시스템도 똑같이 해야 합니다. `0.1 + 0.2`가 `0.30000000000000004`가 되는 이진 부동소수점은 절대 써서는 안 됩니다.
```rust
use rust_decimal::{Decimal, RoundingStrategy};
use rust_decimal_macros::dec;
/// Monthly interest, rounded half away from zero to the cent.
fn monthly_interest(balance: Decimal, annual_rate: Decimal) -> Decimal {
(balance * annual_rate / dec!(12))
.round_dp_with_strategy(2, RoundingStrategy::MidpointAwayFromZero)
}
// monthly_interest(dec!(1234.56), dec!(0.015)) == dec!(1.54)
```
반올림 규칙은 이름으로 코드에 적혀 있습니다. 옛 시스템이 어떻게 동작했는지에 대한 누군가의 기억 속에만 사는 반올림 규칙이야말로 마이그레이션이 잘못되는 길이기 때문입니다.
메인프레임이 배치 윈도와 트랜잭션 모니터로 하던 일을 Rust는 비동기 런타임인 [Tokio](https://tokio.rs/)로 합니다. 소수의 스레드 위에서 수천 개의 동시 작업을 타이머, 타임아웃, 취소와 함께 실행합니다. Tokio 자체는 한 프로세스 안에서 실행됩니다. 분산은 작은 바이너리 여러 개를 부하가 요구하는 만큼의 기계에서, 복제되는 데이터베이스 앞에 두고 실행하는 데서 나옵니다. 마이그레이션 자체는 일부러 지루해야 합니다. 옛 시스템과 새 시스템을 같은 입력으로 나란히 실행하고, 모든 출력을 비교하고, 둘이 일치하면 상품 하나 또는 배치 하나씩 전환합니다. Tokio로는 그 비교의 핵심이 몇 줄입니다.
```rust
/// Parallel run: the mainframe stays the system of record, the new core shadows it.
async fn post_interest(
legacy: &Legacy, core: &Core, divergences: &Divergences, balance: Decimal,
) -> Outcome {
let (old, new) = tokio::join!(legacy.post(balance), core.post(balance));
if old != new {
divergences.record(balance, &old, &new).await;
}
old
}
```
두 시스템이 같은 입력을 동시에 받고, 효력을 갖는 것은 옛 시스템의 답이며, 모든 불일치는 누군가가 설명할 수 있도록 기록됩니다. 그 비교가 진짜 일이고, 에이전트가 잘하는 일입니다. 그 뒤에 에이전트가 만들어 낸 것을 안심하고 신뢰할 수 있게 해 주는 것이 언어입니다.
Rust에도 비용이 있고, 에이전트가 그 전부를 없애 주지는 않습니다. 빌드는 Go보다 느립니다. 비동기 Rust는 여전히 마땅한 수준보다 어렵습니다. 그리고 라이프타임을 능숙하게 읽지 못하는 사람에게 Rust는 빨리 리뷰할 수 있는 언어가 아니며, 리뷰어가 다른 팀 사람일 때 이것은 중요합니다. (Google의 Android 엔지니어들은 반대로 Rust 변경이 리뷰에 약 4분의 1 적은 시간을 쓴다고 보고하지만, 그들은 Go가 아니라 C++와 비교하고 있고, 매일 Rust를 리뷰합니다.) 저는 회사의 내부 서비스를 기본으로 Rust로 쓰지는 않겠습니다. 그 서비스들이 실패를 감당할 수 없는 부분에만 쓰겠습니다.
## Go: 회사 전체가 함께 쓰는 코드를 위해 {#go-for-code-a-whole-company-shares}
Go는 예전에 대규모 조직에서 Java가 차지하던 자리에 있습니다. 조직이 수백 개씩 운영하는 평이하고 오래가는 서비스, 많은 팀이 쓰고 더 많은 팀이 읽는 서비스의 언어입니다. 긴 버전은 [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/#why-go)의 “Why Go” 절에 썼으니, 여기서는 짧은 버전을 쓰겠습니다.
Go는 지루할 정도로 관용적이고, 회사에서는 그것이 가장 높은 찬사입니다. 어떤 일을 하는 방법은 대개 하나뿐이고, 레이아웃은 `gofmt`가 정하며, 오류는 발생한 곳에서 처리하는 값이고, 의존성은 프레임워크가 만들어 내는 대신 인자로 전달되며, 이 언어는 엔터프라이즈 Java를 팩토리의 팩토리로 만든 장치를 제공하지 않습니다. import는 모듈 경로이고 대개 Git 리포지토리의 주소이므로, 다른 팀의 코드를 참조하는 일은 파일 한 줄이지 아티팩트 리포지토리 팀에 올리는 티켓이 아닙니다. 한 모듈 안에서는 모든 것이 소스에서 컴파일되므로, 회사 전체를 아우르는 모노레포의 비용이 낮습니다. 게시하고, 버전을 붙이고, 기다려야 할 내부 라이브러리가 없습니다. 몇 초 만에 컴파일되고, 빠르게 실행되며, 바이너리 하나로 배포되고, 도구(테스트, vet, 경쟁 상태 탐지기, 프로파일링, 언어 서버)가 기본으로 들어 있습니다. 그리고 [Go 1 호환성 약속](https://go.dev/doc/go1compat)은 명세에 맞게 쓴 프로그램이 “변경 없이 계속 올바르게 컴파일되고 실행될 것”이라고 말합니다. 기업 소프트웨어가 살아가는 시간 척도가 바로 그것입니다.
에이전트와 함께 달라지는 것은 이 지루함이 두 번 자산이 된다는 점입니다. 스타일이 들어설 여지가 거의 없으므로 에이전트가 쓴 Go는 사람이 쓴 Go처럼 보이고, 그래서 다른 팀의 리뷰어도 산문을 읽는 속도로 읽습니다. 그리고 같은 획일성 덕분에 에이전트는 큰 Go 코드베이스를 쉽게 탐색합니다. 함수는 시그니처가 말하는 대로 하고, 호출 그래프가 바로 눈앞에 있습니다.
Go로 쓴 이자 규칙은 이렇게 읽히고, 어느 팀이나 어느 에이전트가 쓰든 똑같이 읽힐 것입니다.
```go
var ErrClosed = errors.New("account is closed")
// MonthlyInterest returns the interest in cents for one month,
// rounded half away from zero, as the requirement says.
func MonthlyInterest(ctx context.Context, accounts Accounts, iban string, bps int64) (int64, error) {
acct, err := accounts.Get(ctx, iban)
if err != nil {
return 0, fmt.Errorf("monthly interest for %s: %w", iban, err)
}
if acct.Closed {
return 0, fmt.Errorf("monthly interest for %s: %w", iban, ErrClosed)
}
return roundHalfAway(acct.Balance*bps, 10000*12), nil
}
```
의존성은 인자로 전달된 인터페이스이고, 모든 실패는 위로 올라가면서 컨텍스트가 덧붙는 값이며, 호출하는 쪽은 메시지를 파싱하는 대신 `errors.Is(err, ErrClosed)`로 물어볼 수 있습니다. 그리고 이 중 어느 것도 다른 팀 사람에게 설명할 필요가 없습니다.
대가는 Go가 Rust나 Haskell보다 덜 검사한다는 것입니다. 합 타입(sum type)이 없고, `nil`은 여전히 값이며, 정확성의 상당 부분이 타입이 아니라 테스트에 있습니다. 회사에는 대개 이것이 올바른 거래입니다. 정확해야 하는 시스템은 Rust로 만들고, 그 주변의 백 개 서비스는 Go로 만듭니다.
## Elixir: 본질적으로 분산된 플랫폼을 위해 {#elixir-for-platforms-that-are-distributed-by-nature}
Elixir는 Erlang 가상 머신인 BEAM 위에서 실행되고, BEAM은 전화 교환기를 위해 만들어졌습니다. 서로 격리된 작은 프로세스 수백만 개, 크래시한 것을 다시 시작하는 슈퍼바이저, 일급 개념으로서의 노드 간 메시지, 그리고 장애가 일어나지 않는 척하는 대신 장애를 전제로 설계하는 문화가 있습니다. 대부분의 언어는 라이브러리와 인프라로 분산을 덧붙입니다. BEAM에서는 분산이 기본적인 사고방식입니다.
BEAM의 프로세스는 운영체제 스레드가 아닙니다. [Erlang 효율성 가이드](https://www.erlang.org/doc/system/eff_guide_processes.html)에 따르면 새 프로세스 하나는 327워드, 약 2.6 KB의 메모리를 차지하고 자기만의 힙을 가집니다. 그래서 기계 한 대가 수십만 개를 실행하고, 한 프로세스의 가비지 컬렉션이 다른 프로세스를 멈추는 일은 없습니다. (Erlang으로 만든 WhatsApp은 2012년 1월에 서버 한 대에서 [200만 개가 넘는 TCP 연결](https://blog.whatsapp.com/1-million-is-so-2011)을 유지했다고 보고했습니다.) 프로세스는 아무것도 공유하지 않고 메시지로 대화하며, 슈퍼바이저가 그 프로세스들을 지켜봅니다. 애플리케이션은 슈퍼바이저의 트리이고, 클러스터는 서로 메시지를 주고받을 수 있는 기계들 위에 놓인 그런 트리 여러 개입니다. 다음은 broodwar.live의 트리를 줄인 것입니다.
```elixir
children = [
Broodwar.Repo, # the database pool
{DNSCluster, query: dns_cluster_query()}, # find the other nodes
{Phoenix.PubSub, name: Broodwar.PubSub}, # messages across nodes
{Oban, Application.fetch_env!(:broodwar, Oban)}, # durable jobs in PostgreSQL
Broodwar.Ingestion.LiquipediaThrottle, # one process, one rate limit
BroodwarWeb.Endpoint # one process per connection
]
Supervisor.start_link(children, strategy: :one_for_one, name: Broodwar.Supervisor)
```
그리고 두 기계에서 실행되면 이런 모습입니다.
*One application on the BEAM, on two nodes*
```text
node a node b
┌────────────────────────────────────┐ ┌──────────────────────┐
│ Broodwar.Supervisor (one_for_one) │ │ Broodwar.Supervisor │
│ ├─ Repo database pool │ │ ├─ Repo │
│ ├─ PubSub ◀───────────────────────┼──────┼─▶├─ PubSub │
│ ├─ Oban job queues │ │ ├─ Oban │
│ ├─ Throttle crashed, so the │ │ ├─ Throttle │
│ │ supervisor starts │ │ └─ Endpoint │
│ │ a fresh one alone │ │ ○ ○ ○ ○ ... │
│ └─ Endpoint │ └──────────┬───────────┘
│ ○ ○ ○ ○ ○ ○ ○ ○ ... │ │
│ one process per connection │ │
└─────────────────┬──────────────────┘ │
└─────────────────┬──────────────────┘
▼
PostgreSQL: data, and Oban's jobs
```
스로틀 프로세스가 크래시하면 슈퍼바이저가 새 프로세스를 시작하고, 열린 연결, 작업 대기열, 다른 노드는 아무것도 알아차리지 못합니다. 한 노드에서 게시한 메시지는 다른 노드의 구독자에게 도달합니다. 이것이 분산 시스템의 전부이고, 그 어느 부분도 별도의 인프라를 필요로 하지 않았습니다.
그래서 Elixir는 본질적으로 분산된 플랫폼을 만들 때 제 선택입니다. 같은 대화가 웹, 채팅, 이메일, 전화로 들어오는 옴니채널 시스템, 실시간 접속 상태와 많은 열린 연결이 있는 시스템, 재시작을 견뎌야 하는 백그라운드 작업이 많은 시스템이 그렇습니다. 백그라운드 작업에서는 [Oban](https://oban.hexdocs.pm/Oban.html)이 등장합니다. “영속성을 위해 PostgreSQL, MySQL, 또는 SQLite3를 사용하는” 작업 프레임워크입니다. 작업은 이미 가진 데이터베이스 안에 재시도, 고유성, 대기열과 함께 살고, 따로 운영할 브로커가 없습니다. [broodwar.live](https://broodwar.live)에서 Liquipedia의 대회 페이지를 수집하는 작업은 이렇습니다.
```elixir
# api.broodwar.live, lib/broodwar/ingestion/match_sync.ex (trimmed)
use Oban.Worker,
queue: :ingestion,
max_attempts: 3,
unique: [period: 3600, fields: [:args]]
@impl Oban.Worker
def perform(%Oban.Job{args: %{"pages" => pages}}) when is_list(pages) do
case run(pages) do
{:ok, _summaries} -> :ok
{:error, {:rate_limited, _} = reason} -> {:cancel, reason}
{:error, reason} -> {:error, reason}
end
end
```
재시도, 한 시간 안의 중복 제거, 그리고 소스가 우리에게 속도 제한을 걸 때 재시도하지 않고 멈추겠다는 결정까지 여덟 줄이고, 모두 Elixir를 본 적 없는 사람도 읽을 수 있습니다. 사람들의 목소리와 이야기를 모은 아카이브인 [Humankind](https://humankind.plus)는 같은 방식으로 대기열 여덟 개(그중에는 전사, 임베딩, 음성 합성, 이야기 생성이 있습니다)를 Phoenix의 실시간 업데이트와 나란히, 한 런타임 안에서 실행합니다.
Elixir가 한 사람이 운영하는 야심 찬 프로젝트에 제가 가장 좋아하는 언어인 이유도 이것입니다. 회사라면 웹 계층, 대기열, 브로커, 캐시, 클러스터 관리자로 나눌 것을 BEAM은 여전히 머릿속에 담을 수 있는 하나의 시스템으로 줍니다. Go만큼의 채용 인력 규모나 팀 간 관례는 없으므로 대규모 조직의 기본값으로 삼지는 않겠지만, 작은 팀은 이것으로 멀리 갈 수 있습니다.
약점은 타입이었고, 에이전트와 함께라면 그 약점은 더 무거워집니다. 동적 언어는 에이전트가 쓴 것 가운데 실행 전에 검사하는 부분이 더 적기 때문입니다. 그것이 바뀌고 있습니다. 2026년 6월에 출시된 [Elixir 1.20](https://elixir-lang.org/blog/2026/06/03/elixir-v1-20-0-released)은 “타입 주석을 도입하지 않고도 모든 Elixir 프로그램에 대해 타입 추론을 수행하고 점진적으로 타입 검사를” 할 수 있습니다. 타입이 있는 구조체와 타입 시그니처는 정해진 날짜 없이 아직 앞으로 올 일입니다([로드맵](https://elixir-lang.org/blog/2026/01/09/type-inference-of-all-and-next-15/)). 그때까지 저는 패턴 매칭, typespec, 테스트에 기대고, 에이전트가 쓴 Elixir를 에이전트가 쓴 Rust보다 더 꼼꼼하게 리뷰합니다.
지금 정적 타입이 있는 BEAM을 원한다면 [Gleam](https://gleam.run/)이 있습니다. “확장되는 타입 안전 시스템을 만들기 위한 친근한 언어”입니다. 같은 가상 머신으로 컴파일되므로 프로세스, 슈퍼바이저, 분산을 그대로 얻고, Erlang과 Elixir로 쓴 패키지를 쓸 수 있으며, [2024년 3월의 1.0 버전](https://gleam.run/news/gleam-version-1/) 이후로 안정적입니다. 모든 것에 타입이 있고 컴파일러가 검사합니다. 에이전트가 코드를 쓸 때 가중치가 올라가는 바로 그 속성입니다. 생태계는 Elixir보다 젊고, Gleam으로 쓴 Phoenix나 Oban은 없지만, Elixir 라이브러리는 외부 함수 인터페이스(FFI)를 통해 타입을 손으로 적어 호출할 수 있습니다. 프레임워크보다 정확성이 중요한 BEAM 위의 새 서비스라면, 제가 가장 먼저 살펴볼 선택지입니다.
## Haskell과 bhc: 다른 종류의 내기 {#haskell-and-bhc-a-different-kind-of-bet}
Rust, Go, Elixir는 우리가 이미 가지고 있던 질문에 대한 더 나은 답입니다. 제가 만들고 있는 형태의 Haskell은 에이전트가 코드를 쓰게 된 뒤에야 나타나는 질문에 답합니다. 생성이 싸지면 무슨 일이 일어납니까?
모델은 몇 초 만에 그럴듯한 코드를 만들어 내고, 그럴듯한 코드는 자주 틀립니다. 그래서 희소한 일은 코드를 쓰는 일에서 그 코드가 옳다는 것을 아는 일로 옮겨 갑니다(그리고 [The Behavioural Turn](https://raskell.io/articles/the-behavioural-turn/)에서 주장했듯이, 누구든 그 코드를 얼마나 읽을지 정하는 일로도 옮겨 갑니다). Haskell은 그 가운데 가장 많은 부분을 검사할 수 있게 만드는 프로덕션 언어입니다. 타입이 잘 맞는 함수는 변환이 유효하다는 작은 증명이고, 효과는 시그니처에 드러나며, 잘못된 상태는 표현할 수 없게 만들 수 있습니다. 모델이 옳을 필요는 없습니다. 검사할 수 있으면 되고, 컴파일러가 그 검사기입니다. 검사기는 생성 과정 안에 들어갈 수도 있습니다. ETH Zurich와 UC Berkeley의 한 팀은 타입 검사기가 모델의 출력을 토큰 단위로 제약하게 해서, 생성된 TypeScript의 컴파일 오류를 절반 넘게 줄였습니다([Mündler et al., 2025](https://arxiv.org/abs/2504.09246)).
이자 요구사항은 해지된 계좌에는 이자를 절대 기장하지 않는다고 말합니다. 대부분의 언어에서 그 규칙은 누군가가 기억해야 하는 `if`입니다. Haskell에서는 그 규칙이 데이터의 형태가 될 수 있습니다.
```haskell
newtype Cents = Cents Integer
newtype BasisPoints = BasisPoints Integer
data OpenAccount = OpenAccount { iban :: String, balance :: Cents }
data ClosedAccount = ClosedAccount { closedIban :: String }
data Account = Open OpenAccount | Closed ClosedAccount
-- Interest can only be posted to an open account: the type says so.
postInterest :: BasisPoints -> OpenAccount -> OpenAccount
postInterest (BasisPoints bps) acct = acct { balance = Cents (c + interest) }
where
Cents c = balance acct
interest = roundHalfAway (c * bps) (10000 * 12)
monthEnd :: BasisPoints -> Account -> Account
monthEnd rate (Open a) = Open (postInterest rate a)
monthEnd _ (Closed c) = Closed c
```
해지된 계좌에 이자를 기장하려는 에이전트는 실패하는 테스트나 몇 주 뒤의 버그 보고 대신, 무엇이든 실행되기 전에 `bhc check`로부터 이것을 받습니다.
```text
Type errors:
1: type mismatch: expected `OpenAccount`, found `ClosedAccount`
```
누구도 그 규칙을 기억할 필요가 없습니다. 프로그램이 그 규칙을 어기는 것을 표현할 수 없기 때문입니다. 그것이 [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/)의 내기였고, [arcanist.sh](https://arcanist.sh/manifesto/)가 존재하는 이유입니다.
Basel Haskell Compiler인 [bhc](https://arcanist.sh/bhc/)는 같은 언어를 위해 백지에서 시작한 컴파일러이고, Rust로 쓰였습니다. 그리고 두 가지 생각을 더하는데, 저는 그 두 생각이 이것을 더 나은 Haskell이 아니라 소프트웨어를 만드는 다른 방식으로 만든다고 생각합니다.
첫째, 런타임은 고르는 계약입니다. 같은 소스가 프로파일에 따라 컴파일됩니다. `default`는 평소의 지연 평가, `server`는 기한이 있는 구조적 동시성, `numeric`은 융합된 엄격한 수치 코드와 텐서 커널, `edge`는 최소한의 WebAssembly 런타임입니다. 성능의 범위는 구전되는 지식이기를 멈추고 함수가 무엇인지의 일부가 됩니다. “이것은 옳다”뿐만 아니라 “이것은 이 계약 아래에서 옳다”가 됩니다.
둘째는 [커먼즈](https://arcanist.sh/commons/)입니다. 오늘날 모든 에이전트는 모든 세션에서 같은 날짜 파서를 다시 쓰고 검사한 뒤 그 검증을 버립니다. bhc는 모든 정의를 타입 클래스 인스턴스까지 풀어 쓴 명시적인 의미로 정교화(elaboration)하고, 그 의미는 내용으로 주소를 매길 수 있습니다. 그러면 정의 하나가 정체성, 그것에 대해 무엇이 검사되었고 무엇이 검사되지 않았는지에 대한 정확한 기록, 그리고 그것을 컴파일하거나, 테스트하거나, 리뷰하거나, 보증한 사람들의 서명을 지니게 됩니다. 같은 함수를 다른 스타일로 쓴 두 사람은 같은 함수를 쓴 것이고, 그들의 증거는 하나의 객체에 모입니다. 에이전트의 일은 “이 코드를 써라”에서 “이미 검사된 의미로 이것을 조립하고, 아무것도 없는 곳에서는 쓰고, 증명하고, 다음 에이전트를 위해 남겨 두라”로 바뀝니다. 긴 버전은 [The Proof You Only Have to Write Once](https://raskell.io/articles/the-proof-you-only-have-to-write-once/)에 있습니다.
제가 소프트웨어를 만드는 다른 방식이라고 할 때 뜻하는 것이 이것입니다. 소프트웨어의 단위가 명령어를 담은 파일이기를 멈추고, 명시된 계약 아래에서 검증된 의미의 조각, 그것이 필요한 모든 사람이 공유하는 조각이 됩니다.
이것은 완성에서 가장 먼 부분이기도 합니다. bhc는 0.2 버전입니다. Pandoc의 모듈 221개를 모두 타입 검사하고 컴파일하며, Pandoc의 Markdown 리더와 HTML 라이터가 처음부터 끝까지 실행되지만, 가비지 컬렉터가 아직 컴파일된 코드에 연결되지 않아서 오래 실행되는 서버에는 아직 맞지 않습니다([현황](https://arcanist.sh/bhc/status/)). 커먼즈는 로드맵에 첫걸음이 올라 있는 방향이지, 오늘 쓸 수 있는 서비스가 아닙니다. 그래도 제가 그쪽으로 만들어 가는 것은, 대부분의 코드가 생성되면 검증이 가야 할 곳이 거기라고 생각하고, Haskell이 그곳에 가장 가까이 닿을 수 있는 언어라고 생각하기 때문입니다.
## 당연한 반론 {#the-obvious-objection}
이 모든 것에 대한 가장 강한 반론은, 에이전트가 학습 데이터가 가장 많은 언어에 가장 능숙하니 모든 것을 Python과 TypeScript로 쓰고 걱정을 그만하라는 것입니다.
일리가 있고, 두 언어 모두 자기 자리를 얻을 만했습니다. Python은 데이터 과학, 머신러닝, 노트북을 차지하고 있습니다. 그곳에서 Python의 라이브러리는 견줄 것이 없고, 코드의 상당수는 한 번 실행되고 버려집니다. JavaScript는 브라우저의 언어이고, TypeScript는 후회 없이 JavaScript를 쓰는 방법입니다. 다른 언어로 프런트엔드를 만드는 것은 대개 스스로 낸 상처입니다. 하지만 오래가야 하는 것이라면 저는 둘 중 어느 쪽으로도 거의 돌아가지 않습니다. 예전에 그 언어들을 집어 든 이유는 쓰는 속도와 익숙함이었고, 그것들은 이제 에이전트가 떠안는 비용입니다. 남는 것은 프로덕션에서 타입 오류를 발견하는 런타임입니다.
모델이 어떤 언어를 얼마나 유창하게 쓰는지와 그 결과가 무엇을 보장하는지는 서로 다른 질문입니다. 유창성의 격차는 반론이 가정하는 것보다 작습니다. 표준 코드 생성 벤치마크를 18개 언어로 옮긴 MultiPL-E는 여러 언어에서 모델이 Python 점수와 같거나 더 높은 점수를 낸다는 것을 발견했습니다([Cassano et al., 2022](https://arxiv.org/abs/2208.08227)). 보장의 격차도 측정할 수 있습니다. 연구자들이 테스트와 리뷰를 통과해 살아남은 JavaScript 버그에 타입 주석을 붙였을 때, TypeScript는 그중 15%를 잡아냈습니다([Gao, Bird and Barr, 2017](https://earlbarr.com/publications/typestudy.pdf)). 모델이 Rust를 쓰는 솜씨와 Python을 쓰는 솜씨 사이에 어떤 격차가 남아 있든, 그것은 값싼 부분의 격차입니다. 두 컴파일러가 검사하는 것 사이의 격차는 비싼 부분에 있습니다.
또 하나의 정당한 반론은 한 조직에 언어 넷은 셋이 너무 많다는 것입니다. 대부분의 회사에는 맞는 말이고, 그래서 저는 이 목록을 정책으로 회사에 건네지 않겠습니다. 회사는 아주 적은 수의 언어를 골라 각각에 일을 하나씩 맡겨야 합니다. 제 목록은 이렇습니다.
| 만드는 것이 | 집어 들 언어 | 이유 |
|---|---|---|
| 실패해서는 안 되거나, 핫 패스에 있거나, 적대적인 입력을 처리하거나, 메인프레임 코어 시스템을 대체한다면 | Rust | 컴파일러가 가비지 컬렉터 없이 장애의 부류 전체를 배제함 |
| 많은 팀이 읽고 바꾸는 백 개의 서비스 가운데 하나라면 | Go | 관용적인 방법 하나, 빠른 빌드, 게시할 라이브러리가 없는 모노레포 |
| 본질적으로 분산되어 있거나, 실시간이거나, 옴니채널이거나, 작은 팀의 플랫폼 전부라면 | Elixir | 슈퍼비전, 분산, 내구성 있는 작업이 런타임에 딸려 옴 |
| 정확성을 검사하고, 공유하고, 그 위에 쌓아야 한다면 | bhc를 쓰는 Haskell | 증명으로서의 타입, 런타임 계약, 쌓여 가는 검증 |
| 노트북, 학습 루프, 브라우저 안에 산다면 | Python 또는 TypeScript | 그 언어들의 라이브러리가 거기 있고, 다른 무엇도 따라오지 못함 |
## 사람들이 대신 쓰게 될 것 {#what-people-will-write-instead}
에이전트가 코드를 쓴다면 사람들은 무엇을 씁니까? 점점 더 요구사항을 씁니다. 시스템이 무엇을 해야 하는지, 어떤 경우가 중요한지, 무엇이 절대 일어나서는 안 되는지, 누가 무엇을 승인하는지입니다. 그런 글은 정밀할 때는 선언적이고 그렇지 않을 때는 서술적이며, 어느 경우든 그곳에 이르는 방법이 아니라 무엇이 참이어야 하는지를 말합니다.
이 글의 모든 코드 조각 뒤에 있는 이자 규칙을 제가 요즘 요구사항을 쓰는 방식으로 적으면, 짧은 Markdown 파일 하나입니다.
```markdown
## Monthly interest
- Interest is posted on the last business day of each month.
- Monthly interest is balance × annual rate ÷ 12, in cents,
rounded half away from zero.
- A closed account never receives interest.
- Until the switch-over, the mainframe's result is the one that counts,
and every difference from the new core is recorded.
```
그리고 그 규칙을 확정하는 사례들은 JSON으로 적습니다.
```json
[
{ "case": "ordinary month", "account": { "status": "open", "balance": "1234.56" },
"annual_rate": "0.015", "expect": { "interest": "1.54" } },
{ "case": "closed account", "account": { "status": "closed", "balance": "1200.00" },
"annual_rate": "0.015", "expect": { "interest": "0.00" } }
]
```
위의 네 언어로 쓴 모든 것은 이 두 파일의 하류에 있습니다.
그런 글의 형식은 두 가지입니다. 의도, 결정, 에이전트가 읽는 지시(브리프, 설계 기록, `AGENTS.md`)를 위한 Markdown, 그리고 구조가 있는 모든 것을 위한 JSON이며, YAML과 TOML은 JSON의 더 친근한 친척입니다. 구조가 있는 것이란 스키마, 설정, 두 시스템 사이의 계약, 테스트가 대상으로 삼는 사례들입니다(에이전트를 채점할 때 [Evaluation Closes the Loop](https://raskell.io/articles/evaluation-closes-the-loop/)가 쓰는 것과 같은 알려진 사례들입니다). 둘 다 프로그래밍 언어가 아니며, 제가 요즘 손으로 가장 많이 편집하는 두 형식입니다. 이 사이트가 그 예입니다. 글은 Markdown이고, 데이터는 TOML과 JSON이며, 그것을 페이지로 바꾸는 코드 대부분은 에이전트가 썼습니다.
그마저도 지나가는 단계일 수 있습니다. Markdown과 JSON이 사람에게 중요한 것은 사람이 아직 그것을 읽기 때문이고, 그것이 기술하는 것 가운데 더 많은 부분을 기계가 검사하게 될수록 사람의 몫은 의도를 밝히고 결과를 승인하는 일로 줄어듭니다. 기계가 검사할 수 있을 만큼 정밀한 요구사항은 타입과 그리 멀지 않습니다([Source Code Is the New Assembly](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/)의 주장입니다). 이것이 제가 Haskell에 거는 내기를 코드가 향하는 곳뿐 아니라 요구사항이 향하는 곳에 대한 내기로 보는 또 하나의 이유입니다.
## 선택에서 남는 것 {#what-is-left-of-the-choice}
코드를 쓰는 비용이 0으로 가면, 언어는 쓰기 위한 도구이기를 멈추고 아무도 타이핑하지 않은 코드에 대한 약속의 집합이 됩니다. 에이전트가 방을 떠난 뒤에도 그 언어가 여전히 약속하는 것을 보고 고르십시오.
## 참고 자료 {#references}
- Jeff Vander Stoep, Alex Rebert, [Eliminating Memory Safety Vulnerabilities at the Source](https://security.googleblog.com/2024/09/eliminating-memory-safety-vulnerabilities-Android.html), Google Security Blog, 2024년 9월 25일.
- Jeff Vander Stoep, [Rust in Android: move fast and fix things](https://security.googleblog.com/2025/11/rust-in-android-move-fast-fix-things.html), Google Security Blog, 2025년 11월 13일.
- Jesse Howarth, [Why Discord is switching from Go to Rust](https://discord.com/blog/why-discord-is-switching-from-go-to-rust), 2020년 2월 4일.
- [Go 1 and the Future of Go Programs](https://go.dev/doc/go1compat), Go 1 호환성 약속.
- WhatsApp, [1 million is so 2011](https://blog.whatsapp.com/1-million-is-so-2011), 2012년 1월 6일.
- José Valim, [Elixir v1.20 released: now a gradually typed language](https://elixir-lang.org/blog/2026/06/03/elixir-v1-20-0-released), 2026년 6월 3일, 그리고 [Type inference of all constructs and the next 15 months](https://elixir-lang.org/blog/2026/01/09/type-inference-of-all-and-next-15/), 2026년 1월 9일.
- [Gleam](https://gleam.run/), BEAM을 위한 정적 타입 언어, 그리고 [Gleam version 1](https://gleam.run/news/gleam-version-1/), 2024년 3월 4일.
- [Tokio](https://tokio.rs/), Rust의 비동기 런타임, 그리고 [rust_decimal](https://docs.rs/rust_decimal/), 금융 계산을 위한 십진수.
- [Oban](https://oban.hexdocs.pm/Oban.html), 데이터베이스를 기반으로 하는 Elixir의 백그라운드 작업.
- arcanist.sh, [Manifesto](https://arcanist.sh/manifesto/), [The Commons](https://arcanist.sh/commons/), 그리고 [The Scorecard Is Right. The Weights Are Wrong.](https://arcanist.sh/blog/the-scorecard-is-right-the-weights-are-wrong/)
- [bhc](https://arcanist.sh/bhc/)와 [where bhc stands](https://arcanist.sh/bhc/status/), 2026년 10월 20일 마지막 업데이트.
- Federico Cassano et al., [MultiPL-E: A Scalable and Extensible Approach to Benchmarking Neural Code Generation](https://arxiv.org/abs/2208.08227), 2022.
- Zheng Gao, Christian Bird, Earl T. Barr, [To Type or Not to Type: Quantifying Detectable Bugs in JavaScript](https://earlbarr.com/publications/typestudy.pdf), ICSE 2017.
- Niels Mündler, Jingxuan He, Hao Wang, Koushik Sen, Dawn Song, Martin Vechev, [Type-Constrained Code Generation with Language Models](https://arxiv.org/abs/2504.09246), 2025.
### 더 읽을거리 {#further-reading}
이 사이트에 있는, 이 글의 바탕이 된 더 긴 주장들입니다.
- [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/), 명시적, 선언적, 언어 이후의 미래에 대해, 그리고 제가 Haskell에 거는 이유에 대해.
- [What Comes After the Last Programming Language](https://raskell.io/articles/what-comes-after-the-last-programming-language/), 그 아래의 기계가 무엇이 되는지에 대해.
- [Why We Built a Haskell Package Manager in Rust](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/), 한 프로젝트 안에서 저마다 제 일을 맡은 Rust와 Haskell.
- [The River and the Canal](https://raskell.io/articles/the-river-and-the-canal/), Aqueduct와 내구성 있는 실행의 바탕이 된 에세이.
- [How I Work These Days](https://raskell.io/articles/how-i-work-these-days/), 코딩 에이전트와 일하는 것이 하루하루 어떤 모습인지.
- [The Proof You Only Have to Write Once](https://raskell.io/articles/the-proof-you-only-have-to-write-once/), 검증된 Haskell을 위한 커먼즈의 전체 이야기.
Rust와 메모리 안전성:
- [Fearless Concurrency](https://doc.rust-lang.org/book/ch16-00-concurrency.html), *The Rust Programming Language*에서 동시성 코드에 대해 컴파일러가 무엇을 배제하는지 다루는 장.
- [The Case for Memory Safe Roadmaps](https://www.cisa.gov/resources-tools/resources/case-memory-safe-roadmaps), CISA와 협력 기관, 2023년 12월 6일, 메모리 안전하지 않은 언어에서 벗어나는 계획에 대해.
- [What is memory safety and why does it matter?](https://www.memorysafety.org/docs/memory-safety/), ISRG의 Prossimo, 짧은 입문서.
- [Rust in the Linux kernel](https://docs.kernel.org/rust/index.html), 커널 자체의 문서.
- Martin Fowler, [Strangler Fig Application](https://martinfowler.com/bliki/StranglerFigApplication.html), 레거시 코어 시스템을 계속 실행하면서 조금씩 대체하는 패턴.
Go와 대규모 소프트웨어 엔지니어링:
- Rob Pike, [Go at Google: Language Design in the Service of Software Engineering](https://go.dev/talks/2012/splash.article), 2012, Go가 일부러 평이한 이유. 이 글의 주장을 다룬 글을 하나만 고르라면 이 글입니다.
- [Effective Go](https://go.dev/doc/effective_go)와 [Go Proverbs](https://go-proverbs.github.io/), 관용적이라는 것이 실제로 무엇을 뜻하는지.
- [Go Modules Reference](https://go.dev/ref/mod), import 경로, 버전, 체크섬이 어떻게 작동하는지.
BEAM, Elixir, Gleam:
- Joe Armstrong, [Making reliable distributed systems in the presence of software errors](https://erlang.org/download/armstrong_thesis_2003.pdf), 박사 학위 논문, 2003, 슈퍼바이저와 “let it crash”의 바탕이 된 논리.
- [OTP Design Principles](https://www.erlang.org/doc/system/design_principles.html), Erlang 문서에서 다루는 슈퍼비전 트리와 비헤이비어(behaviour).
- Gary Rennie, [The Road to 2 Million Websocket Connections in Phoenix](https://www.phoenixframework.org/blog/the-road-to-2-million-websocket-connections), 2015년 11월 3일, BEAM 기계 한 대가 열어 둘 수 있는 연결의 규모.
- Giuseppe Castagna, Guillaume Duboc, José Valim, [The Design Principles of the Elixir Type System](https://arxiv.org/abs/2306.06391), 2023, 그리고 Elixir의 [gradual set-theoretic types](https://hexdocs.pm/elixir/gradual-set-theoretic-types.html) 가이드.
- [The Gleam language tour](https://tour.gleam.run/), BEAM 위의 타입 있는 코드가 어떤 모습인지 가장 빨리 보는 방법.
증명으로서의 타입, 그리고 쌓여 가는 검증:
- Philip Wadler, [Propositions as Types](https://homepages.inf.ed.ac.uk/wadler/papers/propositions-as-types/propositions-as-types.pdf), Haskell에 거는 내기가 기대고 있는, 프로그램과 증명 사이의 대응.
- Alexis King, [Parse, don't validate](https://lexi-lambda.github.io/blog/2019/11/05/parse-don-t-validate/), 2019, 일상적인 코드에서 불변식을 타입에 넣는 방법.
- Yaron Minsky, [Effective ML Revisited](https://blog.janestreet.com/effective-ml-revisited/), Jane Street, “잘못된 상태를 표현할 수 없게 만들라”(make illegal states unrepresentable)라는 말의 출처.
- [Unison](https://www.unison-lang.org/), 내용 주소 기반 코드를 처음 도입한 언어, 그리고 arcanist.sh의 [Building the Commons](https://arcanist.sh/blog/building-the-commons/), 그것을 Haskell로 가져오는 엔지니어링.
================================================================================
---
title: "IT Intelligence 만들기: 리포지토리 하나에 담은 참조 구현"
url: https://raskell.io/ko/articles/building-it-intelligence/
author: Raffael Schneider
date: 2026-11-16
description: "오픈 소스 부품으로 Enterprise Context Platform(엔터프라이즈 컨텍스트 플랫폼)을 만드는 방법입니다. 온톨로지, 커넥터, 워크플로, 저장소, API, MCP, UI를 직접 실행할 수 있는 리포지토리 하나에 담았습니다."
tags: [enterprise-architecture, context-engineering, agents, provenance, oss, durable-execution, knowledge-management]
lang: ko
translation_of: https://raskell.io/articles/building-it-intelligence/
---
# IT Intelligence 만들기: 리포지토리 하나에 담은 참조 구현
## 요약
이 글은 지난 글에서 다룬 IT 인텔리전스 플랫폼의 참조 구현입니다. 오픈 소스 리포지토리 하나에 담겨 있고, 그 안에는 일부러 어수선하게 만든 가상의 회사 Kestrel Group이 들어 있습니다. 온톨로지가 가장 먼저 오고, 나머지는 모두 온톨로지에서 생성되거나 온톨로지에 맞춰 검증됩니다. 소스에서 온 관찰은 모델이 그 관찰로부터 결론 내린 엔티티와 분리해 둡니다. 모든 관계는 근거, 신뢰도, 출처를 지닌 하나의 행입니다. 아이덴티티 해석(identity resolution)은 공유 키에서 규칙으로, 다시 모델 추론으로 진행되며, 불확실한 연결은 담당 팀이 확인하도록 대기열에 올라갑니다. API와 분리된 워크플로 오케스트레이터가 재시도와 재개를 갖추고 수집을 실행하며, 소스는 공개적으로 점수가 매겨지고, API는 REST와 MCP 서버를 제공합니다. MCP 서버의 답은 작고 엔티티 중심이며 언제나 출처를 함께 담고 있습니다. 도구보다 계층의 순서가 더 중요합니다. 데이터베이스, 워크플로 엔진, 프런트엔드, 모델 제공자는 나중에 다시 고를 수 있는 선택이며, 테스트 모음이 이 글의 주장을 실행 중인 시스템에 대해 검증합니다.
[IT Intelligence(IT 인텔리전스)](https://raskell.io/articles/it-intelligence/)에서 저는 대기업들이 매출 수치를 위해서는 만들었으면서 정작 자신의 IT를 위해서는 한 번도 만들지 않은 것이 있다고 주장했습니다. 무엇이 존재하는지, 누가 그것을 소유하는지, 그것이 어떻게 연결되는지, 전략과 맞는지를 아는 하나의 모델이고, 그 일에 관여하는 모든 사람과 모든 에이전트가 읽을 수 있는 모델입니다. 그러면 당연히 다음 질문이 나오고, 충분히 물을 만한 질문입니다. 실제로 만들면 어떤 모습입니까?
이 글이 그 답입니다. 누구의 실제 IT 환경도 보여 주지 않으면서 할 수 있는 한 구체적으로 답하겠습니다. 이 글은 오픈 소스 리포지토리 하나, [raskell-io/it-intelligence](https://github.com/raskell-io/it-intelligence)에 담긴 참조 구현을 차례로 살펴봅니다. 그 안에는 가상의 회사가 들어 있습니다. 리포지토리를 클론해 노트북에서 실행하고, 코딩 에이전트를 연결해 보면, 첫 번째 글에서 설명한 모든 계층을 볼 수 있습니다. 커넥터, 워크플로 오케스트레이션, 영속 저장소, 컨텍스트 모델(Context Model) 자체, MCP 서버를 갖춘 API 백엔드, 프런트엔드, 그리고 모델을 산출물로 바꾸는 분석입니다.
이 참조 구현은 제가 회사에서 운영하는 플랫폼보다 작고, 단순하고, 더 지루합니다. 하지만 형태는 같고, 제가 보여 드리고 싶은 것은 바로 그 형태입니다.
## 가상의 회사 {#the-fictional-company}
아래의 모든 예시는 **Kestrel Group**을 사용합니다. 마켓 유닛 세 개, 애플리케이션 약 마흔 개, 팀 열두 개 남짓, 컨테이너 클러스터 두 개, WAF 하나, API 게이트웨이 하나, 그리고 흔히 보는 기록 시스템(system of record) 몇 가지를 갖춘 가상의 금융 그룹입니다. 리포지토리는 Kestrel을 실제 도구에서 내보낸 데이터를 흉내 낸 시드 파일로 제공합니다. EA 리포지토리의 애플리케이션 목록, IT 서비스 관리 도구의 구성 항목과 인시던트, Git 호스트의 리포지토리와 팀, 클러스터의 네임스페이스와 워크로드, WAF의 정책, 게이트웨이의 라우트입니다.
시드 데이터는 일부러 어수선하게 만들었습니다. 시스템마다 이름이 다르고, 두 애플리케이션이 같은 리포지토리를 자기 것이라고 주장하며, 한 네임스페이스에는 소유자 레이블이 없고, 한 마켓 유닛은 그룹 IT의 누구도 모르는 자체 통합 플랫폼을 운영하며, EA 리포지토리에는 1년 전에 운영을 종료한 애플리케이션이 올라 있습니다. 깔끔한 데모는 아무것도 증명하지 못합니다. IT 인텔리전스가 제값을 하는 곳은 소스들이 서로 다르게 말하는 곳이기 때문입니다.
## 시스템의 형태 {#the-shape-of-the-system}
*it-intelligence, the reference implementation*
```text
┌────────────────────────┐
│ seed/ or real sources │
└────────────┬───────────┘
▼
┌────────────────────────┐
│ connectors (Go) │
└────────────┬───────────┘
▼
┌────────────────────────┐ ┌──────────────────────┐
│ workflow orchestrator: │ ──▶ │ PostgreSQL: │
│ extract, judge, │ │ observations, │
│ build, score │ │ entities, edges, │
└────────────┬───────────┘ │ scorecards, │
│ LLM calls │ artifacts │
▼ └──────────┬───────────┘
┌────────────────────────┐ │
│ resolver (pluggable │ │
│ model provider) │ │
└────────────────────────┘ ▼
┌──────────────────┐ ┌──────────────────────────┐
│ web (Next.js) │ ◀──▶ │ API (Go): REST, MCP, │
└──────────────────┘ │ artifacts; starts runs │
└─────┬──────────────┬─────┘
▲ ▲
coding agents (MCP) other systems (REST)
ontology/ (LinkML) ──▶ generated types, store vocabulary, JSON Schema, OWL
```
움직이는 부품 여섯 개와, 그 모두의 위에 놓인 파일 하나입니다. 저는 이것들을 데이터가 흐르는 순서가 아니라 실제로 만들 순서대로 살펴보겠습니다. 온톨로지가 가장 먼저입니다. 나머지는 모두 온톨로지에서 생성되거나 온톨로지에 맞춰 검증되기 때문입니다.
## 리포지토리 {#the-repository}
```text
it-intelligence/
ontology/ context_model.yaml, entities.yaml, relations.yaml: the Context Model in LinkML
generated/ JSON Schema, OWL, SHACL, the store vocabulary (do not edit)
cmd/itx/ the one binary: serve, worker, ingest, verify, runs, snapshot
connectors/ one package per source kind: earepo/ itsm/ githost/ cluster/ waf/ gateway/
mapping/ observations to candidate entities and edges, one mapper per connector
resolver/ identity resolution: keys, rules, inference, pluggable model providers
workflows/ the workflows, and runner/, the minimal orchestrator that runs them
store/ PostgreSQL migrations and the generated vocabulary
api/ REST, MCP and the queries both share
artifacts/ Mermaid diagrams and insights
web/ Next.js frontend
config/ sources, resolver thresholds and rules, people, the verify baseline
seed/ the Kestrel Group as source-shaped exports, plus an answer key
deploy/ docker compose for a laptop, a Helm chart for a cluster
docs/ architecture, decision records, adding a source
.mcp.json lets a coding agent in this repo use the MCP server
Makefile
```
여기서 모노레포가 옳은 선택인 데는 지루한 이유가 있습니다. 온톨로지는 바뀌고, 바뀔 때마다 저장소, 매퍼, API, MCP 도구, 프런트엔드 타입이 모두 함께 바뀌어야 합니다. 리포지토리 하나라면 그것은 풀 리퀘스트 하나, 리뷰 하나, CI 실행 한 번입니다. 리포지토리 다섯 개에 흩어져 있으면 조율의 문제가 되는데, 그것이 바로 이 플랫폼이 없애려는 종류의 문제입니다.
스택은 처음부터 끝까지 오픈 소스이고, 놀랄 일이 없다는 이유로 골랐습니다.
| 관심사 | 참조 구현의 선택 | 이유 | 합리적인 대안 |
|---|---|---|---|
| 온톨로지 | [LinkML](https://linkml.io/) | YAML 스키마 하나에서 여러 산출물이 생성되고, RDF와 OWL로 이어지는 다리가 있음 | OWL과 SHACL 직접 사용, JSON Schema 단독 |
| 영속성 | PostgreSQL | 누구나 운영할 수 있고, 재귀 쿼리로 그래프 요구 대부분을 처리함 | PostgreSQL 위의 Apache AGE, 전용 그래프 데이터베이스 |
| 오케스트레이션 | API와 분리된 독자적인 구성 요소인 내구성 있는 워크플로 오케스트레이터, 참조 구현은 PostgreSQL 위의 최소한의 오케스트레이터를 함께 제공함 | 재시도, 재개, 스케줄, 사람을 오래 기다리는 일은 개별 요청이 아니라 플랫폼이 맡아야 함 | [Temporal](https://temporal.io/), [Restate](https://restate.dev/), [Aqueduct](https://github.com/raskell-io/aqueduct), 또는 비슷한 엔진 |
| 백엔드 | Go | 정적 바이너리 하나 `itx`를 API(`itx serve`)로도, 워크플로 워커(`itx worker`)로도 실행함 | MCP SDK가 있는 어떤 언어든 |
| 에이전트 인터페이스 | [Model Context Protocol](https://modelcontextprotocol.io/) | 코딩 에이전트가 이미 사용하는 프로토콜 | OpenAPI 명세를 갖춘 REST |
| 프런트엔드 | Next.js | 엔티티 페이지, 그래프 뷰, 리뷰 대기열을 빠르게 만들 수 있음 | 어떤 웹 프레임워크든 |
| 다이어그램 | 텍스트로 쓴 [Mermaid](https://mermaid.js.org/) | diff가 가능하고, Git 호스트와 위키와 채팅에서 렌더링됨 | Structurizr DSL, PlantUML |
이 가운데 어느 것이든 설계를 바꾸지 않고 교체할 수 있습니다. 교체할 수 없는 것은 계층의 순서와 각 계층이 따르는 규칙입니다.
### 왜 Go인가 {#why-go}
그중 한 가지 선택은 표의 한 행보다 더 많은 설명을 들일 만합니다. 대기업이 10년 동안 운영해야 하는 플랫폼이라면 거의 어떤 것이든 저는 같은 선택을 다시 할 것이기 때문입니다. 백엔드는 Go로 작성되어 있습니다.
기업의 코드는 쓰이는 것보다 훨씬 자주 읽힙니다. 그것도 그 코드를 쓰지 않은 사람이, 흔히 몇 년 뒤에, 어느 정도 압박을 받으며 읽습니다. Go는 바로 그런 독자를 위해 만들어졌습니다. 어떤 일을 하는 관용적인 방법은 대개 하나뿐이고, 레이아웃은 `gofmt`가 정하므로, 한 팀의 코드와 다른 대륙에 있는 외주 개발자의 코드가 똑같아 보입니다. 모든 것이 명시적이고 타입이 정해져 있습니다. 오류는 발생한 곳에서 처리하는 값이고, 의존성은 프레임워크가 주입하는 대신 인자로 전달되며, 실제로 일을 하는 줄을 찾기 전에 기어올라야 할 상속 계층도 없습니다. 이 언어는 엔터프라이즈 Java를 유명하게 만든 장치 대부분을 아예 제공하지 않으므로, 팩토리의 팩토리는 애초에 쓰이지 않습니다. 새 동료나 코딩 에이전트도 `resolver/`를 열어 안내서 없이 따라갈 수 있습니다.
의존성은 그것이 있는 위치로 이름이 붙습니다. import 경로는 모듈 경로이고, 대부분의 모듈에서 그것은 Git 리포지토리의 주소입니다. 모듈 파일은 버전을 고정하고, 체크섬 파일이 그 버전을 지킵니다.
```go
// go.mod (trimmed)
module github.com/raskell-io/it-intelligence
require (
github.com/jackc/pgx/v5 v5.12.0
github.com/modelcontextprotocol/go-sdk v1.8.0
)
```
모듈 안에서는 패키지들이 경로로 서로를 import하고 소스에서 컴파일됩니다. 모노레포의 비용이 낮은 것은 이 때문입니다. 매퍼, 리졸버, REST API, MCP 서버가 생성된 `vocab` 패키지를 공유하는데, 누군가가 내부 라이브러리를 게시하고, 버전을 붙이고, 그것이 아티팩트 리포지토리에 도달하기를 기다릴 필요가 없습니다. 온톨로지를 바꾸고 다시 생성하면, `go build ./...`가 몇 초 안에 깨진 것을 모두 알려 줍니다.
Go는 두 번 빠릅니다. 의존성까지 포함해 리포지토리 전체를 깨끗한 상태에서 빌드하는 데 제 노트북에서 약 20초가 걸리고, 변경 후 다시 빌드하는 데는 2초가 채 걸리지 않으므로 피드백 루프가 짧게 유지됩니다. 그리고 결과물은 즉시 시작되고 적은 메모리로 요청을 처리하는 정적 바이너리 하나이며, API와 워커 모두에 바라는 것이 바로 이것입니다. 도구도 기본으로 들어 있습니다. `go test`, `go vet`, 경쟁 상태 탐지기(race detector), 프로파일링을 위한 `pprof`, 모든 편집기를 위한 `gopls`가 있고, 고르거나 설정할 것이 없습니다. 그리고 [Go 1 호환성 약속](https://go.dev/doc/go1compat) 덕분에 오늘 쓴 코드는 10년 뒤에도 빌드됩니다. 기업 소프트웨어가 실제로 살아가는 시간 척도가 바로 그 정도입니다.
Go에도 대가가 있습니다. `if err != nil`은 반복적으로 느껴지고, 타입 시스템에 합 타입(sum type)이 없어서 온톨로지의 정밀함 일부는 타입이 아니라 검증 쪽에 남게 되며, 제네릭은 늦게 들어왔고 의도적으로 소박합니다. 프런트엔드에는 생태계가 있는 TypeScript를 씁니다. 하지만 플랫폼 가운데 정확하고, 지루하고, 다음 사람이 읽을 수 있어야 하는 부분에 대해서라면, 저는 이보다 잘 맞는 것을 알지 못합니다.
## 첫 번째 계층: 온톨로지 {#layer-one-the-ontology}
컨텍스트 모델이 곧 온톨로지이고, `ontology/`에 들어 있습니다. `context_model.yaml`과, 이 파일이 import하는 두 파일 `entities.yaml`과 `relations.yaml`입니다. 제가 LinkML을 쓰는 이유는 모델을 읽기 쉬운 YAML로 한 번만 쓰고, 시스템의 각 부분이 필요로 하는 형태로 생성할 수 있기 때문입니다. 검증을 위한 [JSON Schema](https://json-schema.org/), 저장소의 어휘(엔티티 종류와 관계 종류의 테이블, 그리고 도메인과 레인지를 벗어난 엣지를 거부하는 트리거), 시맨틱 웹 도구로 추론하고 싶은 사람을 위한 [OWL](https://www.w3.org/TR/owl2-overview/)과 [SHACL](https://www.w3.org/TR/shacl/), Python과 TypeScript 모델, 그리고 사람이 읽을 수 있는 문서입니다. Go 타입은 JSON Schema에서 생성됩니다.
Kestrel 모델을 줄인 버전입니다.
```yaml
# ontology/entities.yaml (trimmed)
classes:
Entity:
abstract: true
slots: [id, name, standing, last_seen]
Application:
is_a: Entity
description: A thing the business recognises as one system, however many parts it has.
Repository:
is_a: Entity
Workload:
is_a: Entity
Namespace:
is_a: Entity
Team:
is_a: Entity
Capability:
is_a: Entity
description: A business capability from the enterprise architecture capability map.
Endpoint:
is_a: Entity
Decision:
is_a: Entity
description: An architecture decision record, with the entities it constrains.
MarketUnit:
is_a: Entity
enums:
Standing:
permissible_values:
secondary: {description: mirrored from an authoritative system}
primary: {description: the Context Model is authoritative}
```
관계는 슬롯으로 이루어진 닫힌 어휘입니다. LinkML은 슬롯마다 도메인(domain)을 하나만 허용하므로, 관계가 여러 종류의 엔티티에서 시작될 수 있는 경우에는 저장소의 어휘를 쓰는 생성기를 위해 어노테이션이 전체 도메인과 레인지(range)를 담습니다.
```yaml
# ontology/relations.yaml (trimmed)
slots:
deployed_as:
description: The application runs as this workload.
domain: Application
range: Workload
multivalued: true
annotations: {ctx_domain: Application, ctx_range: Workload, ctx_cardinality: many}
runs_in:
description: The workload runs in this namespace.
domain: Workload
range: Namespace
annotations: {ctx_domain: Workload, ctx_range: Namespace, ctx_cardinality: one}
owned_by:
description: The accountable team.
range: Team
annotations: {ctx_domain: "Application Repository Workload Namespace Endpoint", ctx_range: Team, ctx_cardinality: one}
```
이것을 만들면서 모델링 규칙 네 가지가 나왔고, 이 규칙들은 문법보다 중요합니다.
**핵심을 작게 유지합니다.** Kestrel에는 엔티티 종류가 아홉 개, 관계 종류가 정확히 열다섯 개 있습니다. 새 종류는 누군가가 답할 수 있게 되는 질문 하나로 자신의 존재를 정당화해야 합니다. 첫 번째 글에서 썼듯이 실패 양상은 온톨로지의 무분별한 확장이고, 이를 막는 방법은 한 사람이 화이트보드 앞에서 설명할 수 있는 스키마입니다.
**엔티티와 관찰을 분리합니다.** 관찰은 소스가 특정 시점에 말한 것입니다. 내보낸 데이터의 한 행, API에서 온 JSON 객체 하나입니다. 엔티티는 컨텍스트 모델이 모든 관찰을 종합해 내린 결론입니다. 둘을 섞으면 카탈로그는 소스의 사본이 되고, 소스의 모순도 고스란히 물려받습니다.
**관계를 일급 객체로 만듭니다.** 온톨로지에서 관계는 슬롯입니다. 저장소에서는 모든 관계가 근거, 신뢰도, 출처, “last seen”을 지닌 독립된 행이 됩니다. “모델은 왜 이렇게 생각하는가?”라는 질문에 답하는 방법은 이것뿐이고, 누군가가 모델을 신뢰할지는 바로 이 질문이 결정합니다.
**역량 맵은 플랫폼 팀이 아니라 엔터프라이즈 아키텍처에서 가져옵니다.** `Capability`는 그룹 자체의 역량 모델로 채워집니다. 이 결정 하나 덕분에 “모든 마켓 유닛에서 보험금 청구 처리를 지원하는 시스템은 무엇인가” 같은 질문이 쿼리가 되고, 전략은 이렇게 모델 안으로 들어옵니다.
`make ontology`는 `ontology/generated/`의 모든 것을 다시 생성하고, 생성된 파일이 최신이 아니면 CI가 실패합니다. 온톨로지는 코드이고, 코드처럼 리뷰됩니다.
## 두 번째 계층: 저장소 {#layer-two-the-store}
PostgreSQL은 다섯 가지를 담습니다. 관찰, 엔티티, 엣지, 스코어카드, 산출물입니다. 그 주위에 보조 테이블 몇 개가 있습니다. 별칭(각 소스가 엔티티를 부르는 이름), 데이터 세트 레지스트리, 모든 확인과 선언을 담는 추가 전용 로그, 기록해 둔 모델 판단, 스냅숏, 그리고 워크플로 실행의 상태입니다. 핵심은 보여 드릴 수 있을 만큼 짧습니다.
```sql
-- store/schema.sql (trimmed)
create table observation (
id bigserial primary key,
source text not null, -- 'earepo', 'cluster', ...
dataset text not null, -- 'applications', 'workloads', ...
external_id text not null, -- the id inside the source
payload jsonb not null,
observed_at timestamptz not null
);
create table entity (
id text primary key, -- 'ctx:Application/policy-admin'
kind text not null,
name text not null,
standing text not null default 'secondary',
attributes jsonb not null default '{}',
last_seen timestamptz not null
);
create table edge (
id text primary key, -- a stable hash of kind, endpoints and source
kind text not null references relation_kind(kind),
from_id text not null references entity(id),
to_id text not null references entity(id),
basis text not null, -- 'asserted' | 'derived' | 'inferred'
confidence double precision not null,
status text not null, -- 'active' | 'pending' | 'rejected'
source text not null,
evidence jsonb not null default '{}',
confirmed_by text,
confirmed_at timestamptz,
last_seen timestamptz,
unique (kind, from_id, to_id, source)
);
```
관찰은 추가 전용(append-only)입니다. 어떤 것도 덮어쓰지 않으므로 모델은 언제나 소스가 말한 것으로부터 다시 만들어질 수 있고, 모든 엣지는 `evidence`를 통해 자신을 만든 관찰을 가리킬 수 있습니다.
`basis` 열은 첫 번째 글에서 말한 구분을 담습니다. **asserted**(단언된) 엣지는 소스 자체의 키에서 곧바로 나온 것입니다. 클러스터가 이 워크로드는 저 네임스페이스에서 실행된다고 말하는 경우입니다. **derived**(도출된) 엣지는 규칙에 따라 다른 엣지들로부터 따라 나옵니다. 워크로드가 어떤 팀이 소유한 네임스페이스에서 실행되므로, 달리 말하는 것이 없으면 그 팀이 워크로드를 소유한다는 식입니다. **inferred**(추론된) 엣지는 리졸버가 대개 모델의 도움을 받아 제안한 것으로, 신뢰도와 그 근거가 된 추론을 함께 지닙니다. 팀이 추론된 엣지를 확인하면 `confirmed_by`와 `confirmed_at`이 설정되고, 엣지는 사람의 이름이 붙은 단언된 엣지가 됩니다. 테이블의 트리거가 모든 엣지를 온톨로지에서 생성된 어휘에 맞춰 검사하므로, 저장소는 모델이 허용하지 않는 관계를 담을 수 없습니다.
이 모든 것은 출처(provenance) 표준 없이도 동작하지만, 그런 표준 하나와 잘 맞아떨어집니다. W3C의 [PROV-O](https://www.w3.org/TR/prov-o/) 용어로 말하면, 엣지는 `evidence`에 담긴 관찰로부터 도출되었고(derived), `source`에, 또는 확인된 뒤에는 사람에게 귀속되는(attributed) 엔티티입니다. 참조 구현은 PROV를 내보내지 않으며, 어떤 수집 실행이 엣지를 만들었는지, 즉 PROV 용어로 활동(activity)도 아직 기록하지 않습니다. 다른 도구가 그 계보를 필요로 한다면, 시작할 곳은 이 두 군데입니다.
왜 그래프 데이터베이스가 아니라 PostgreSQL입니까? 아키텍트와 에이전트가 묻는 것 대부분은 엔티티에서 한두 홉 떨어진 것이고, 나머지는 재귀 쿼리가 잘 처리하는 범위가 정해진 탐색이기 때문입니다. 고전적인 “이것을 바꾸면 무엇이 깨지는가” 질문은 이렇습니다.
```sql
-- everything that depends on payment-gateway, up to four hops away
with recursive impact(id, depth) as (
select 'ctx:Application/payment-gateway'::text, 0
union
select e.from_id, i.depth + 1
from edge e
join impact i on e.to_id = i.id
where e.kind = 'depends_on' and i.depth < 4
)
select id, min(depth) as distance
from impact
where depth > 0
group by id
order by distance, id;
```
그래프가 이 방식으로 편하게 처리할 수 있는 규모를 넘어서면, [Apache AGE](https://age.apache.org/)가 같은 PostgreSQL 인스턴스에 openCypher 쿼리를 더해 주고, 전용 그래프 데이터베이스는 나중에 따로 내릴 결정입니다. 모든 팀이 이미 운영할 줄 아는 데이터베이스로 시작하는 것이 첫날부터 그래프 쿼리 언어의 우아함을 누리는 것보다 가치 있습니다.
## 세 번째 계층: 커넥터와 매핑 {#layer-three-connectors-and-mapping}
커넥터는 한 가지 일만 합니다. 소스를 읽고 관찰을 내보냅니다. 커넥터는 온톨로지에 대해 아무것도 모릅니다.
```go
// connectors/connector.go
type Observation struct {
Source string
Dataset string
ExternalID string
Payload json.RawMessage
ObservedAt time.Time
}
type Connector interface {
Name() string
Datasets() []string
Extract(ctx context.Context, dataset string, since time.Time) iter.Seq2[Observation, error]
}
```
매핑은 별도의 단계로, 커넥터마다 매퍼가 하나씩 있으며, 관찰을 **단언**(assertion)으로 바꿉니다. 후보 엔티티와 후보 엣지이고, 각각 자신이 나온 관찰이 태그로 붙어 있습니다. 종류와 관계를 나타내는 상수는 온톨로지에서 생성된 `vocab` 패키지에서 오므로, 매퍼가 관계를 지어낼 수는 없습니다.
```go
// mapping/mappers.go, the cluster mapper (trimmed)
func (clusterMapper) Map(ctx Context, o connectors.Observation) (Assertions, error) {
a := start(o)
var k k8sObject
if err := decode(o, &k); err != nil {
return a, err
}
if o.Dataset == "workloads" {
wl := a.Entity(vocab.Workload, k.Metadata.Namespace+"/"+k.Metadata.Name, k.Metadata.Name, nil)
a.Edge(vocab.RunsIn, wl, Key(vocab.Namespace, k.Metadata.Namespace), Asserted)
// The cheapest win in the whole system: a label carrying the EA application id
// turns an inference into an assertion.
if app := k.Metadata.Labels[ctx.Config.ApplicationLabel]; app != "" {
a.Edge(vocab.DeployedAs, Alias(vocab.Application, "earepo:applications", app), wl, Asserted)
}
}
return a, nil
}
```
이렇게 나누면 커넥터를 재사용할 수 있습니다. 같은 Git 호스트 커넥터가 어느 회사에서든 동작하기 때문입니다. 그리고 회사 고유의 지식은 리뷰할 수 있는 매퍼에 남습니다. 또한 소스를 소유한 팀이 커넥터를 직접 쓸 수 있다는 뜻이기도 하며, 기여는 그렇게 시작됩니다. 참조 구현에서 소스를 추가하는 일은 파일 세 개입니다. 커넥터, 매퍼, 그리고 테스트에 쓸 시드 내보내기 파일입니다.
레이블 확인은 이 매퍼 하나를 넘어서 중요합니다. 배포에 EA 애플리케이션 ID를 추가하는 팀이 하나 늘 때마다 모델의 추론 하나가 단언으로 바뀌고, 스코어카드는 다음 날 아침 그 개선을 보여 줍니다.
## 네 번째 계층: 아이덴티티 해석 {#layer-four-identity-resolution}
매핑은 같은 대상에 대해 많은 후보를 만들어 냅니다. EA 리포지토리는 “Policy Administration”이라고 하고, Git 호스트에는 `pol-adm-svc`와 `pol-adm-ui`가 있고, 클러스터는 네임스페이스 `claims-prod`에서 `policy-admin`을 실행하며, IT 서비스 관리 도구에는 “PAS”라는 비즈니스 서비스가 있습니다. 아이덴티티 해석(identity resolution)은 이 가운데 어떤 것들이 하나의 엔티티인지 결정합니다.
해석은 값싸고 확실한 것에서 비싸고 불확실한 것으로, 세 번의 패스로 진행됩니다.
1. **키.** 소스들에 걸쳐 공유되는 식별자, 예를 들어 배포 레이블의 애플리케이션 ID나 리포지토리 메타데이터 파일의 CMDB 참조가 단언된 연결을 만듭니다.
2. **규칙.** 정밀도가 알려진 결정론적 휴리스틱입니다. 정규화한 이름이 같은 경우, 소유 팀이 정확히 하나의 애플리케이션만 소유한 리포지토리, 네임스페이스 명명 규칙 같은 것입니다. 이것들은 도출된 연결을 만듭니다.
3. **추론.** 남은 것은 모델로 갑니다. 각 후보는 애플리케이션 최대 다섯 개로 된 짧은 목록을 받는데, 소유 팀의 애플리케이션이 먼저 오고 그다음에 이름이 가장 비슷한 것들이 옵니다. 모델은 후보의 이름, README 발췌나 설명, 소유자, 네임스페이스를 보고 구조화된 판단을 돌려줍니다.
```json
{
"candidate": "githost:repo/kestrel/pol-adm-ui",
"match": "ctx:Application/policy-admin",
"confidence": 0.82,
"reasons": [
"README describes the policy administration frontend",
"same owning team as pol-adm-svc, already linked by key",
"deploys to claims-prod next to policy-admin"
]
}
```
IT 서비스 관리 도구의 비즈니스 서비스인 “PAS”도 같은 방식으로 해석됩니다. 모델은 이것을 0.93으로 Policy Administration에 연결합니다. PAS는 흔히 쓰는 약어이고, 그 지원 그룹이 애플리케이션을 소유하며, 인시던트 텍스트에 `pol-adm-svc`가 언급되기 때문입니다.
임곗값은 명시적이며 설정 안에 있습니다. 0.9를 넘으면 연결은 추론된 것으로 저장되고 평소처럼 표시됩니다. 0.6과 0.9 사이면 추론된 것으로 저장되고 담당 팀이 확인하도록 대기열에 올라갑니다. 0.6 미만이면 버려지고 로그에 남습니다. 추론된 연결이 조용히 단언된 연결로 승격되는 일은 결코 없습니다. 그러려면 사람이 필요합니다. 모델 제공자는 교체할 수 있습니다. 기본적으로 참조 구현은 기록해 둔 판단을 재생하므로, 오프라인에서 API 키 없이 실행되고 매번 같은 답을 냅니다. `config/resolver.yaml`의 한 줄로 로컬 모델이나 호스팅된 모델로 바꿀 수 있고, 입력이 메타데이터이고 프롬프트가 작기 때문에 그렇게 해도 잘 동작합니다.
이 문제는 오래된 것입니다. 통계학자들은 이것을 레코드 연결(record linkage)이라고 부르며, Ivan Fellegi와 Alan Sunter가 1969년에 이에 대한 형식 이론을 세웠습니다. 두 개의 임곗값이 후보 쌍을 연결, 비연결, 그리고 사람의 검토로 넘어가는 가능한 연결로 나눕니다. 위의 세 구간은 같은 생각이며, 그들의 이론에서 일치 가중치(match weight)가 있는 자리에 모델의 판단이 들어갑니다. 소스에 애플리케이션 수백 개가 아니라 레코드 수백만 건이 있다면, 영국 법무부(UK Ministry of Justice)가 만든 그 확률적 접근의 오픈 소스 구현인 [Splink](https://moj-analytical-services.github.io/splink/)를 살펴보십시오.
## 다섯 번째 계층: 워크플로 {#layer-five-workflows}
수집은 불안정한 소스와 통신하고 시간 초과가 나는 모델을 호출하므로, 단계별 재시도, 충돌 후 재개, 스케줄, 그리고 무슨 일이 있었는지 볼 수 있는 곳이 필요합니다. 게다가 여기서 모든 일이 빨리 끝나지는 않습니다. 연결은 팀이 확인하기를 기다리고, primary 선언은 두 번째 사람이 승인하기를 기다리며, 누군가 휴가 중이고 이메일로 알림이 나가는 동안 둘 다 며칠씩 머물 수 있습니다. 그런 일은 API에 속하지 않습니다. 그래서 워크플로 오케스트레이션은 독자적인 구성 요소입니다. API는 컨트롤 플레인으로서 실행을 시작하고 그 상태를 보고하지만 직접 실행하지는 않으며, 실행은 오케스트레이터가 맡습니다.
운영 환경에서 그 오케스트레이터는 Temporal, Restate 또는 그와 비슷한 내구성 있는 워크플로 엔진입니다. 설계는 그중 무엇인지에 좌우되지 않습니다.
후보 하나는 제가 만든 것입니다. [Aqueduct](https://github.com/raskell-io/aqueduct)는 에이전트가 쓰고 사람이 승인하는 절차를 위해 만든, Rust로 작성한 내구성 있는 실행 엔진입니다. 모든 단계를 완료로 치기 전에 저널에 기록하고, 시간 제한을 두고 사람을 기다리며(시그널이나 누구든 완료할 수 있는 id로 기다리고, 아무도 답하지 않으면 다른 사람에게 넘깁니다), 단계를 gRPC나 HTTP를 통해 어떤 언어로 된 워커에서든 실행하므로 여기의 단계들은 Go로 남을 수 있습니다. 아직 초기 단계이고, 자체 README도 아직 의존하지 말라고 하므로, 저는 이것을 기본값이 아니라 선택지로 언급합니다.
참조 구현은 같은 계약 뒤에서 동작하는 PostgreSQL 기반의 최소한의 오케스트레이터를 별도의 프로세스 `itx worker`로 제공하므로, 다른 것을 설치하지 않고도 노트북에서 실행됩니다. 워크플로는 멱등적인 단계들의 고정된 목록입니다.
```go
// workflows/workflows.go (trimmed)
modelSteps := []runner.Step{
{Name: "Judge", Run: d.judge, Timeout: 30 * time.Minute},
{Name: "Build", Run: d.build, Timeout: 10 * time.Minute},
{Name: "Score", Run: d.score, Timeout: 10 * time.Minute},
}
return []runner.Workflow{
{Name: "IngestSource", Steps: append([]runner.Step{extract}, modelSteps...)},
{Name: "IngestAll", Steps: all},
{Name: "ConfirmLink", Steps: []runner.Step{applyLink, build, score}},
{Name: "DeclarePrimary", Steps: []runner.Step{applyPrimary, build}},
{Name: "BuildArtifacts", Steps: artifactSteps},
}
```
실행과 단계 시도는 테이블 두 개에 저장됩니다. 워커는 `select ... for update skip locked`로 실행을 가져가고 하트비트를 유지하므로, 여러 워커가 나란히 실행될 수 있고, 충돌한 프로세스가 버린 실행은 다른 워커가 이어받습니다. 실행은 성공하지 못한 첫 단계에서 재개되고, 재시도는 지터를 두고 간격을 늘리며, 단계들은 실행 id 외에는 아무것도 주고받지 않습니다. 단계가 만든 것은 무엇이든 PostgreSQL로 갑니다. API와 워커는 별도의 프로세스이므로 따로 확장되고, 느린 수집이 에이전트의 쿼리를 붙잡아 두는 일은 없습니다.
| 워크플로 | 트리거 | 단계 |
|---|---|---|
| `IngestSource` | 소스별 주기, 또는 요청 시 | Extract, Judge, Build, Score |
| `IngestAll` | `make ingest` | 모든 소스에 대해 Extract, 그다음 Judge, Build, Score와 산출물 단계 |
| `ConfirmLink` | 팀이 UI에서 확인하거나 거부함 | Apply, Build, Score |
| `DeclarePrimary` | 데이터 세트 소유자의 요청, 두 번째 사람이 승인 | Apply, Build |
| `BuildArtifacts` | 매일 밤, 그리고 `IngestAll`이 끝날 때 | Snapshot, Diagrams, Insights |
모든 실행은 `/runs`에 단계, 시도, 오류, 소요 시간과 함께 나타나며, 이것은 생각보다 중요합니다. 소스의 스코어카드가 떨어지면 첫 번째 질문은 지난 수집에서 무슨 일이 있었는가이고, 그 답은 클릭 한 번 거리에 있습니다. 최소한의 오케스트레이터가 할 수 없는 일은 워크플로 안에서 사람을 며칠씩 기다리는 것, 알림을 보내는 것, 수천 개의 병렬 작업으로 퍼져 나가는 것입니다. 그래서 참조 구현에서 `ConfirmLink`와 `DeclarePrimary`는 사람이 답한 뒤에야 시작합니다. 내구성 있는 엔진은 그 기다림을 워크플로 자체 안으로 옮기며, 이것이 엔진이 더해 주는 첫 번째 것입니다. 엔진으로 교체하는 일은 기계적입니다. 단계들은 이미 액티비티의 형태를 갖추고 있고, API는 실행을 시작하고 그 상태를 읽는 일만 하기 때문입니다.
## 여섯 번째 계층: 점수 매기기 {#layer-six-scoring}
`Score` 액티비티는 수집할 때마다 소스와 데이터 세트별로 스코어카드를 계산합니다.
| 신호 | 계산 방식 |
|---|---|
| 신선도(freshness) | 소스의 예상 주기 안에 변경되거나 확인된 레코드의 비율 |
| 완전성(completeness) | 매퍼가 필요로 하는 모든 필드를 갖춘 레코드의 비율 |
| 일치도(agreement) | 적어도 하나의 다른 소스가 확인해 주는 사실의 비율, 따라서 한 소스만 가진 사실은 점수를 끌어내림 |
| 해석 가능성(resolvability) | 아이덴티티와 참조가 모두 컨텍스트 모델 엔티티로 해석되는 레코드의 비율 |
전체 점수는 가중 평균이고, 가중치는 설정으로 정하며, 모든 숫자는 그 뒤에 있는 레코드로 연결됩니다. 시드에서 수집을 한 번 마치면, EA 리포지토리의 애플리케이션은 0.58, 역량은 0.45, 클러스터의 네임스페이스는 0.75, IT 서비스 관리 도구의 비즈니스 서비스는 0.99를 받습니다. 점수에서 두 가지가 따라 나옵니다. 단언된 사실은 모두 0.7에 소스의 마지막 전체 점수의 0.3배를 더한 신뢰도로 시작하므로, 잘 관리된 소스에서 온 사실은 방치된 소스에서 온 같은 주장보다 우선하고, 도출된 사실은 자신의 사슬에서 가장 약한 신뢰도를 물려받습니다. 그리고 스코어카드는 모든 팀이 볼 수 있는 페이지에 공개되므로, 데이터 품질은 감사 지적 사항에서 리그 순위표에 가까운 것으로 바뀝니다.
## 일곱 번째 계층: API와 MCP 서버 {#layer-seven-the-api-and-the-mcp-server}
API 프로세스 `itx serve`는 같은 쿼리로 세 가지 표면을 제공합니다. 시스템과 프런트엔드를 위한 REST API, 에이전트를 위한 MCP 서버, 그리고 생성된 산출물을 위한 정적 엔드포인트입니다. 이것들을 한 프로세스에 두는 것은 의도적입니다. 같은 엔티티를 보는 에이전트와 사람은 같은 사실을 봐야 하고, 이를 보장하는 가장 쉬운 방법은 구현을 두 개 두지 않는 것입니다.
설계에 가장 많은 공을 들인 곳은 MCP 서버입니다. 에이전트를 위한 도구는 프로그램을 위한 API와는 규칙이 다른 인터페이스이기 때문입니다. Kestrel 서버는 몇 가지 도구를 노출합니다.
| 도구 | 입력 | 반환 |
|---|---|---|
| `search_entities` | 텍스트, 선택적으로 종류 | id, 종류, 한 줄 요약을 갖춘 일치하는 엔티티 |
| `get_entity` | id | 엔티티, 그 속성, 지위, 직접 연결된 엣지 |
| `find_owner` | id 또는 자유 텍스트 이름 | 소유 팀, 소유 관계가 어떻게 확립되었는지, 그리고 신뢰도 |
| `impact_of_change` | id, 깊이 | 주어진 깊이까지 이것에 의존하는 대상, 거리별로 묶음 |
| `explain_fact` | 엣지 id | 엣지 하나의 근거: 소스, 관찰, basis, 누가 확인했는지 |
| `list_decisions` | id | 엔티티를 제약하는 아키텍처 결정 |
| `render_diagram` | id, 뷰 | 엔티티 주변의 Mermaid 다이어그램 |
세 가지 규칙이 이 도구들을 만들었습니다. **도구는 엔티티 중심입니다.** 에이전트는 범용 쿼리 언어보다 “이것과 그 주변을 달라”에서 더 잘 추론하기 때문입니다. **모든 답에는 출처가 담깁니다.** 그래서 에이전트는 사실이 어디서 왔는지 인용할 수 있고 사람은 그것을 확인할 수 있습니다. **답은 작습니다.** 하위 그래프 전체가 아니라 에이전트가 이어서 따라갈 수 있는 id를 담습니다. 이 플랫폼의 목적은 에이전트의 토큰을 아끼는 것이지 컨텍스트 윈도우를 넘치게 하는 것이 아니기 때문입니다. 경제적인 근거는 [The Economics of Inference](https://raskell.io/articles/the-economics-of-inference/)에서, 도구 설계의 근거는 [Tools: How Agents Actually Do Things](https://raskell.io/articles/tools-how-agents-actually-do-things/)에서 다뤘습니다.
“*claims-prod의 소유자는 누구이고 무엇이 그것에 의존하는가?*”라는 질문을 받으면, 리포지토리 안의 에이전트는 `find_owner`를 호출하고, 첫 번째 수집 후에는 이런 답을 받습니다.
```text
find_owner {"id": "claims-prod"}
owner: ctx:Team/claims-platform, derived, 0.92
path: ctx:Namespace/claims-prod <- runs_in - ctx:Workload/claims-prod/claims-settlement (asserted, cluster)
ctx:Workload/claims-prod/claims-settlement <- deployed_as - ctx:Application/claims-settlement (asserted, cluster)
ctx:Application/claims-settlement - owned_by -> ctx:Team/claims-platform (asserted, itsm)
```
네임스페이스에는 소유자 레이블이 없으므로 소유 관계는 도출된 것이고, 답도 그렇다고 말합니다. `claims-prod`에서는 보험금 청구 애플리케이션 세 개가 실행되고 모두 같은 팀을 가리킵니다. 가장 강한 사슬이 이기고, 에이전트는 그 답이 기대는 모든 사실을 인용할 수 있습니다. 팀이 다음에 할 일은 답에서 분명히 드러납니다. 네임스페이스에 소유자 레이블을 달면 도출이 단언으로 바뀝니다.
코딩 에이전트가 이것을 쓸 수 있도록, 리포지토리에는 프로젝트 범위의 MCP 설정이 들어 있습니다. Claude Code에서는 리포지토리 루트의 `.mcp.json`입니다.
```json
{
"mcpServers": {
"it-intelligence": {
"type": "http",
"url": "http://localhost:8080/mcp"
}
}
}
```
회사에서는 같은 항목이 공유 인스턴스를 가리키고, 모든 새 리포지토리가 출발하는 템플릿에 들어갑니다. 그때부터 모든 노트북의 모든 코딩 에이전트가 서비스를 대상으로 코드를 쓰기 전에 그 서비스의 소유자가 누구인지 물어볼 수 있습니다.
## 여덟 번째 계층: 프런트엔드 {#layer-eight-the-frontend}
Next.js 프런트엔드는 기술적으로는 가장 덜 흥미로운 계층이지만, 사람들이 다시 찾아올지를 결정하는 계층입니다. 뷰는 다섯 개입니다.
- **엔티티 페이지.** 엔티티마다 하나씩 있으며, 속성, 종류별로 묶은 엣지, 마우스를 올리면 보이는 출처, 그리고 사실이 낡으면 호박색으로 바뀌는 “last seen”이 있습니다.
- **그래프 뷰.** 어떤 엔티티든 그 주변을 보여 주며, 관계 종류와 깊이로 거를 수 있습니다.
- **리뷰 대기열.** 팀마다 하나씩 있으며, 확인을 기다리는 추론된 연결과 각각에 대한 모델의 이유가 나란히 있습니다.
- **소스 스코어카드.** 여섯 번째 계층의 리그 순위표입니다.
- **산출물.** `BuildArtifacts`가 만든 모든 것이며, 각각 그것을 만든 스냅숏이 표시되어 있습니다.
TypeScript 타입은 온톨로지에서 오므로, 모델이 바뀌면 프런트엔드는 따라잡을 때까지 컴파일에 실패합니다. 이것은 올바른 종류의 마찰입니다.
## 아홉 번째 계층: 산출물 {#layer-nine-artifacts}
산출물은 컨텍스트 모델이 조회 이상의 몫을 해내기 시작하는 곳입니다. `BuildArtifacts` 워크플로는 모델의 스냅숏을 찍고 그 위에서 생성기를 실행합니다. 각 산출물은 자신이 나온 스냅숏을 기록하므로, 다시 만들어 낼 수 있고 독자는 그것이 얼마나 최신인지 알 수 있습니다.
**텍스트로 된 다이어그램.** 생성기는 엔티티의 주변을 따라가며 Mermaid를 씁니다. Kestrel의 보험 계약 관리 애플리케이션에 대한 출력은 이렇습니다.
```text
flowchart LR
app_policy_admin["Policy Administration owner: claims-platform"]
repo_svc["repo: pol-adm-svc"]
repo_ui["repo: pol-adm-ui"]
wl["workload: policy-admin ns: claims-prod"]
ep["endpoint: api.kestrel.example/policies WAF: enforced"]
cap["capability: Policy Management"]
pay["Payment Gateway"]
app_policy_admin -->|realised_by| repo_svc
app_policy_admin -.->|realised_by, inferred 0.82| repo_ui
app_policy_admin -->|deployed_as| wl
app_policy_admin -->|exposed_via| ep
app_policy_admin -->|supports| cap
app_policy_admin -->|depends_on| pay
```
추론된 엣지는 점선으로 그려지고 신뢰도가 표시되므로, 다이어그램은 자신이 아는 것에 대해 정직합니다. 텍스트이기 때문에 Git 호스트, 위키, 채팅 도구에서 렌더링되고, 스냅숏 사이에 diff를 떠서 한 분기 동안 IT 환경에서 무엇이 바뀌었는지 보여 줄 수 있습니다.
**인사이트.** 각 인사이트는 이름, 설명, 임곗값을 지닌 쿼리이며, 스냅숏마다 실행됩니다. Kestrel에는 어느 실제 회사에서든 무언가를 찾아내곤 하는 인사이트 몇 개가 함께 들어 있습니다.
```sql
-- applications in production with no accountable owner
select a.id, a.name
from entity a
where a.kind = 'Application'
and a.attributes->>'lifecycle' = 'production'
and not exists (
select 1 from edge e
where e.from_id = a.id and e.kind = 'owned_by'
and e.confidence >= 0.8
);
```
다른 인사이트들은 마켓 유닛마다 둘 이상의 플랫폼이 지원하는 역량(통합 후보), WAF 정책 없이 인터넷에 노출된 엔드포인트, EA 생명주기는 “retired”라고 하는데 워크로드는 여전히 실행 중인 애플리케이션, 그리고 커밋 이력으로 계산한 트럭 팩터(truck factor)가 1인 리포지토리를 찾아냅니다. 각 발견은 관련된 엔티티로 연결되므로, 서랍에 들어갈 보고서가 아니라 대화의 출발점이 됩니다.
**초안**은 다음 단계이며 아직 만들어지지 않았습니다. 솔루션 설계의 현황 섹션, 미리 채워진 아키텍처 결정 기록, 짧은 비즈니스 케이스를 위한 생성기이고, 각각 모든 주장에 대해 엔티티나 엣지를 인용해야 합니다. 그 인용 규칙이 첫 번째 글에서 산출물 과신(artifact over-trust)이라고 부른 것에 대한 방어입니다.
## 실행하기 {#running-it}
Docker만 있으면 되고, API 키는 필요 없습니다.
```sh
git clone https://github.com/raskell-io/it-intelligence
cd it-intelligence
make up # PostgreSQL, the API, the workflow worker and the web UI
make seed # register the Kestrel Group sources
make ingest # extract, judge, build, score, and build the artifacts
make verify # check the resolver against the answer key, and this post against the system
open http://localhost:3000
```
첫 번째 수집이 끝나면 볼 만한 곳이 세 군데 있습니다. 스코어카드 페이지에서는 EA 리포지토리 내보내기가 신선도에서 가장 낮은 점수를 받은 것을 볼 수 있습니다. 레코드 대부분이 마지막으로 수정된 지 반년이 넘었고, 1년 전에 운영을 종료한 그 애플리케이션도 그중 하나입니다. claims platform 팀의 리뷰 대기열에는 `pol-adm-ui`에서 Policy Administration으로 가는 추론된 연결이 0.82로, 모델의 세 가지 이유와 함께 들어 있습니다. 그리고 리포지토리 안의 코딩 에이전트에게 “claims-prod의 소유자는 누구이고 무엇이 그것에 의존하는가?”라고 물으면, 그래프를 지나간 경로를 인용하는 답이 도구 호출 스무 번이 아니라 두 번 만에 나옵니다.
제가 가장 자랑스럽게 여기는 부분은 `make verify`입니다. 시드에는 정답지가 함께 들어 있습니다. Kestrel Group이 실제로 어떤 모습인지 손으로 적어 둔 것입니다. verify 단계는 해석된 모델을 정답지와 비교하고, 이 글의 구체적인 주장 하나하나를 실행 중인 시스템에 대해 확인하며, CI는 변경이 있을 때마다 이를 실행합니다. 시드에서 엣지는 정밀도 0.996, 재현율 0.994로 나오고, 아이덴티티는 1.0입니다. 규칙마다 정밀도도 측정하는데, 그중 하나인 `team_owns_single_app`은 사례 1건 가운데 0건을 맞힙니다. 이 규칙은 실험용 리포지토리를 아무 관계도 없는 애플리케이션에 연결합니다. 참조 구현이라면 숨기지 말고 보여 줘야 하는 것이 바로 이런 것입니다.
## 참조 구현이 다루지 않는 것 {#what-the-reference-leaves-out}
참조 구현은 자신의 빈틈에 대해 솔직할 때 신뢰를 얻습니다. 큰 빈틈은 이렇습니다.
- **아이덴티티와 접근 제어.** 참조 구현에는 인증이 없습니다. 확인과 primary 선언에는 이름이 필요하므로, 쓰기에는 “act as” 선택기에서 고른 이름이 `X-Actor` 헤더로 실려 갑니다. 실제 배포에서는 쓰기에 진짜 신원 확인이 필요합니다. 제가 주장했듯이 읽기는 모두에게 열려 있더라도 마찬가지입니다.
- **규모를 갖춘 실제 커넥터.** 커넥터는 시드 파일을 읽습니다. Git 호스트만 GitHub 조직 하나를 위한 작은 라이브 모드를 갖추고 있습니다. 운영 환경의 커넥터는 페이지네이션, 속도 제한, 부분 실패, 자격 증명, 그리고 예고 없이 스키마를 바꾸는 소스를 다뤄야 합니다. 이 일은 화려하지 않고 끝이 없습니다.
- **이력.** 참조 구현은 관찰 이력은 보관하지만 엔티티와 엣지는 제자리에서 다시 만듭니다. 특정 시점에 대한 질문(“마이그레이션 전에 IT 환경은 어떤 모습이었는가?”)에는 유효 기간을 지닌 엣지 이력이 필요합니다. 이는 간단한 확장이지만 저장 공간과 쿼리 복잡도에서 실제 비용이 듭니다. 그때까지는 스냅숏과, 스냅숏 사이의 `itx snapshot diff`가 값싼 대용품입니다.
- **규모.** Kestrel에는 애플리케이션이 마흔 개 있고, 참조 구현은 수집할 때마다 모델 전체를 다시 빌드합니다. 엔티티가 수천 개라면 괜찮지만, 수백만 개라면 그렇지 않습니다. PostgreSQL은 큰 그룹의 IT 환경을 감당하지만, 빌드는 증분 방식이 되어야 하고 재귀 쿼리에는 인덱스와 제한과 약간의 주의가 필요합니다.
- **초안.** 결정 기록과 비즈니스 케이스를 위한 생성기는 그 인용 검사와 함께 아직 만들어지지 않았습니다.
- **온톨로지 자체의 거버넌스.** 누가 엔티티 종류를 추가할 수 있는지, 그 변경을 어떻게 리뷰하는지는 조직의 질문입니다. 리포지토리는 코드 리뷰로 이를 뒷받침할 수는 있어도 답할 수는 없습니다.
이 가운데 어느 것도 형태를 바꾸지 않습니다. 이것들은 오후 한나절에 이해할 수 있는 참조 구현과 그룹 전체를 위해 운영할 수 있는 플랫폼 사이의 차이입니다.
## 여기서 가져갈 것 {#what-to-take-from-it}
이런 것을 만든다면 도구보다 순서가 더 중요합니다. 온톨로지를 먼저 쓰고 모든 것을 그것에서 생성하십시오. 관찰과 엔티티를 분리해 두십시오. 모든 관계를 근거, 신뢰도, 출처를 지닌 행으로 만드십시오. 소스의 점수를 공개적으로 매기십시오. MCP 서버는 API와 같은 프로세스에 두고, 오케스트레이션은 그 바깥에 두십시오. 산출물은 스냅숏에서, 출처와 함께, 텍스트로 생성하십시오. 데이터베이스, 워크플로 엔진, 프런트엔드 프레임워크, 모델 제공자는 나중에 다시 고를 수 있는 선택입니다.
이 리포지토리는 뜯어보라고 있는 것입니다. 여러분의 내보내기 데이터로 실행했는데 모델이 무언가를 잘못 판단한다면, 그것이 일어날 수 있는 가장 유용한 일이고, 저는 그 이야기를 듣고 싶습니다. [CONTRIBUTING.md](https://github.com/raskell-io/it-intelligence/blob/main/CONTRIBUTING.md)에 소스를 추가하는 방법이 설명되어 있고, 이슈는 열려 있습니다.
## 참고 자료 {#references}
- Raffael Schneider, [IT Intelligence: The Missing Data Layer of Enterprise IT](https://raskell.io/articles/it-intelligence/), 이 플랫폼의 필요성을 논한 짝을 이루는 글입니다.
- [raskell-io/it-intelligence](https://github.com/raskell-io/it-intelligence), 참조 구현이며, 결정 기록은 `docs/adr/`에 있습니다.
- [LinkML](https://linkml.io/), Linked Data Modeling Language, 그리고 그 [생성기](https://linkml.io/linkml/generators/).
- [Temporal](https://temporal.io/), [Restate](https://restate.dev/), [Aqueduct](https://github.com/raskell-io/aqueduct), 내구성 있는 실행 엔진이며, 어느 것이든 오케스트레이터의 자리를 대신할 수 있습니다.
- [PostgreSQL documentation on recursive queries](https://www.postgresql.org/docs/current/queries-with.html) (`WITH RECURSIVE`).
- [Apache AGE](https://age.apache.org/), PostgreSQL 위에서 openCypher로 하는 그래프 쿼리.
- [Model Context Protocol](https://modelcontextprotocol.io/), 그리고 [공식 Go SDK](https://github.com/modelcontextprotocol/go-sdk).
- [Mermaid](https://mermaid.js.org/), 텍스트로 쓰는 다이어그램.
- [Backstage software catalog](https://backstage.io/docs/features/software-catalog), 엔티티 모델의 조상 격인 개발자 포털.
- Simon Brown, [The C4 model](https://c4model.com/), 생성기가 목표로 삼을 수 있는 아키텍처 뷰.
- [The Go 1 compatibility promise](https://go.dev/doc/go1compat), 몇 년 전에 쓴 Go 코드가 지금도 빌드되는 이유.
- Ivan P. Fellegi, Alan B. Sunter, “A Theory for Record Linkage”, *Journal of the American Statistical Association* 64, no. 328 (1969): 1183 to 1210, [doi:10.1080/01621459.1969.10501049](https://doi.org/10.1080/01621459.1969.10501049), 임곗값과 사람의 검토(clerical review)를 갖춘 아이덴티티 해석의 토대.
- [Splink](https://moj-analytical-services.github.io/splink/), 영국 법무부(UK Ministry of Justice)가 만든 오픈 소스 확률적 레코드 연결.
- W3C, [PROV-O: The PROV Ontology](https://www.w3.org/TR/prov-o/), 사실이 어디서 왔는지를 나타내는 표준 어휘.
- W3C, [OWL 2 Web Ontology Language](https://www.w3.org/TR/owl2-overview/)와 [SHACL](https://www.w3.org/TR/shacl/), 온톨로지가 생성되는 시맨틱 웹 형식, 그리고 검증에 쓰이는 형식인 [JSON Schema](https://json-schema.org/).
- Michael Nygard, [Documenting Architecture Decisions](https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions).
================================================================================
---
title: "사람으로 이루어진 제국"
url: https://raskell.io/ko/articles/review-empire-of-ai/
author: Raffael Schneider
date: 2026-11-14
description: "Karen Hao의 Empire of AI는 OpenAI의 이야기를 그 안의 사람들을 통해 들려줍니다. 취재로서는 흡인력이 있고, 논증에서는 고르지 않습니다."
tags: [research-labs, technology-races, hubris, training-data, capital-allocation, bureaucracy]
categories: [reviews]
review_of: "Empire of AI"
review_of_author: "Karen Hao"
review_of_kind: book
review_of_year: 2025
rating: 7.5/10
lang: ko
translation_of: https://raskell.io/articles/review-empire-of-ai/
---
# 사람으로 이루어진 제국
## 요약
Karen Hao의 *Empire of AI*는 OpenAI와 Sam Altman, 그리고 그 주변 사람들을 안에서 들여다본 기록으로, 약 300건의 인터뷰를 바탕으로 합니다. 저는 10점 만점에 7.5점을 줍니다. Sebastian Mallaby의 *The Infinity Machine*을 읽은 직후에 읽으면 거의 짝을 이루는 책입니다. 같은 인물들, 같은 시기를 DeepMind가 아니라 OpenAI에서 바라보며, 정치는 더 많고 기술은 더 적습니다. 가장 좋은 부분은 OpenAI의 사명이 한두 해마다 어떻게 다시 정의되었는지를 보여 주는 대목입니다. Hao는 이를 제국의 공식으로 읽고, 저는 그 안의 어느 개인보다도 큰 과정으로 읽습니다. 논증하는 부분에서는 약합니다. 다른 곳에서 치르는 비용을 다룬 몇몇 장은 더 짧을 수 있었고, 칠레에 관한 서술은 이 나라를 하나의 정치적 관점으로만 봅니다. 가장 오래 남는 교훈은 세계적 의미를 지닌 회사도 여전히 당신이나 저 같은 사람들이 이끈다는 것입니다. 조금 더 똑똑하고, 조금 더 영리하고, 조금 더 멀리 볼 뿐입니다.
*Empire of AI*는 2023년 11월 17일 금요일, 태평양 시간으로 정오 무렵에 시작합니다. Sam Altman(샘 올트먼)이 화상 회의에 접속하자 이사회 다섯 명 중 네 명이 그에게 해임을 통보합니다. 프롤로그는 닷새 전부를 따라갑니다. Ilya Sutskever(일리야 수츠케버)가 아무것도 설명하지 못하는 전체 회의, 임원들의 위협, 직원들의 연판장, Microsoft의 제안, 수츠케버의 번복, 올트먼의 복귀까지입니다. 그런 다음 책은 2015년 Rosewood 호텔의 저녁 식사로 돌아가고, 마지막 부에 이르러서야 이사회 논의의 안쪽에서 같은 닷새에 다시 도착합니다.
Karen Hao(캐런 하오)는 2019년부터 OpenAI를 취재해 왔습니다. 그해 그는 사흘 동안 회사 사무실에 머물며 이 회사에 관한 첫 프로필 기사를 썼습니다. 이 책은 약 260명을 대상으로 한 약 300건의 인터뷰를 바탕으로 하며, 그중 90명 이상이 OpenAI의 전현직 직원입니다. 여기에 메모와 이메일, Slack 메시지가 더해집니다. 올트먼과 OpenAI는 협조하지 않기로 했습니다. 이 점은 양쪽으로 드러납니다. 하오는 어느 회의에서 누가 무슨 말을 했는지 알고 있고, 올트먼은 대부분 그와 함께 일한 사람들의 눈을 통해 보입니다.
저는 10점 만점에 7.5점을 줍니다. Sam Altman과 OpenAI, 그리고 둘을 빚어낸 반목을 이해하고 싶다면 읽어야 할 책이며, 제가 짐작만 하던 것을 확신하게 해 주었습니다. 역사상 어느 회사 못지않게 중요할지도 모르는 회사도 여전히 당신이나 저 같은 사람들이 이끈다는 것입니다. 조금 더 똑똑하고, 조금 더 영리하고, 조금 더 멀리 볼 뿐입니다.
## 두 권의 책, 하나의 이야기 {#two-books-one-story}
저는 Sebastian Mallaby(세바스천 맬러비)가 쓴 Demis Hassabis(데미스 허사비스) 전기 [*The Infinity Machine*](https://raskell.io/articles/win-everything-control-no-one/)을 읽은 직후에 이 책을 읽었고, 그 순서가 옳았습니다. 맬러비는 DeepMind의 기원을, 그리고 그 길에서 현대 머신러닝의 기원을 시간 순서대로 들려주며, 그 결과를 우리가 이제 막 겪기 시작한 트랜스포머 기반 언어 모델에까지 이릅니다. 하오는 나머지 절반을 들려줍니다. 같은 시기, 같은 사람들(Musk, Sutskever, Amodei, Hinton, Suleyman)을 런던이 아니라 샌프란시스코에서 바라봅니다. 두 책은 서로의 사각지대를 비추는 거울입니다. 맬러비는 허사비스의 협조를 얻었고 올트먼은 그의 경쟁자들을 통해 그렸습니다. 하오는 올트먼의 협조를 얻지 못했고, 허사비스는 등장하더라도 멀리서 그립니다.
어떤 장면은 두 책 모두에 나오고, 그 덕분에 더 좋아집니다. 맬러비가 런던에서 전하는 Musk의 허사비스에 대한 두려움은 하오의 첫 장에서 OpenAI가 존재하는 이유 자체로 등장합니다. 머스크는 AI의 미래가 Larry Page에게 좌우되기를 원하지 않았고, 올트먼은 Google이 아닌 누군가가 먼저 만드는 편이 좋겠다는 이메일을 그에게 보냈습니다. 한 전직 DeepMind 연구자는 하오에게 OpenAI의 창립이 “꽤 온화한 사람에 대한 반쯤 히스테리적인 반응”이었다고 말합니다. 맬러비가 언어를 지능으로 가는 길로 여기지 않던 DeepMind를 보여 준다면, 하오는 그 생각을 바꾼 메모를 보여 줍니다. 2019년 OpenAI를 떠나 DeepMind로 옮긴 안전 연구자 Geoffrey Irving이 언어 모델을 확장해야 한다는 논거를 가지고 갔습니다(7장). 두 책이 함께 다루는 사람들과 아이디어는 모든 연결에 출처를 달아 [Who contributed to AI](https://raskell.io/notes/who-contributed-to-ai/)에 그려 두었습니다.
강조점의 차이는 큽니다. 맬러비는 기술을 설명하며, 모든 아이디어를 두 번씩 설명하고, 사람들은 이 분야의 역사를 위해 존재합니다. 하오의 관심은 사람과 정치, 그리고 기술이 어떻게 작동하는지보다 누가 그 값을 치르는지에 있습니다. 둘 다 정당한 선택입니다. 하오의 선택은 더 나은 스릴러와 더 약한 사상사를 낳습니다.
## 이야기하는 방식 {#how-it-is-told}
하오는 긴장감을 위해 쓰고, 저는 그 점이 좋았습니다. 이 이야기들은 서로 얽혀 있고 인간적으로도 무척 흥미로워서 드라마로 들려줄 가치가 있습니다. Rosewood 저녁 식사, 2018년 머스크의 최후통첩과 퇴장, GPT-2 시연에 이어 자신의 생물학 시험을 통과한 GPT-4에 마음을 연 Bill Gates, GPT-3 팀의 3분의 1을 데리고 떠나 Anthropic을 세운 Amodei 남매, 그리고 ChatGPT 자체가 그렇습니다. ChatGPT는 Anthropic이 곧 챗봇을 내놓는다는 소문 때문에 2022년 11월에 서둘러 출시되었고, 내부에서는 “조용한 연구 프리뷰”로 규정되었으며, 직원들은 주말 동안 수천 명이 써 볼지 수만 명이 써 볼지를 두고 내기를 했습니다. 닷새 만에 사용자가 백만 명이 되었습니다.
구성은 독자에게 덜 친절합니다. 책은 네 부로 되어 있고 대체로 순서를 따르지만, 몇몇 시기를 두 번 들려줍니다. 2장과 3장은 2015년부터 2019년까지를 한 기관의 이야기로 들려주고, 5장은 다시 돌아가 같은 시기를 연구의 이야기로 들려줍니다. 4장은 OpenAI를 완전히 떠나 조면기에서 다트머스, 딥러닝에 이르는 AI의 역사에 관한 에세이가 됩니다. 9장은 2021년의 케냐, 베네수엘라의 붕괴, 콜롬비아, 2023년의 나이로비 사이를 오갑니다. 13장은 워싱턴 쪽에서 2023년을 다시 다룹니다. 엄격하게 시간 순서를 따른 맬러비의 서술을 읽은 뒤라, 저는 때때로 시간선의 어디에 있는지 놓쳤습니다. 읽기를 멈출 정도는 아니었지만, 책 끝에 연표나 등장인물 목록이 있었다면 도움이 되었을 텐데 이 책에는 둘 다 없습니다.
## 언어에 건 내기 {#the-bet-on-language}
가장 좋은 내용 중 일부는 GPT를 만든 결정들을 다룬 5장에 있습니다. 하오에 따르면 OpenAI 내부에서 일리야 수츠케버가 쓰던 표현은 [“지능은 압축이다”](https://raskell.io/notes/intelligence-is-compression/)였습니다. 설득력 있는 텍스트를 생성하도록 훈련된 모델은 세상에 대해 배운 것을 그 본질로 압축해야 한다는 뜻입니다. 이어서 Dario Amodei(다리오 아모데이)는 연구를 여러 내기의 포트폴리오로 운영하는데, 그가 남겨 둔 내기가 GPT-2였습니다. GPT-2는 이 분야에서 “순수 언어” 가설이라 부르던 것을 대표했습니다. 충분한 텍스트만으로, 다른 것 없이 훈련한 시스템이 범용 지능에 이를 수 있다는 가설이며, 지각과 행동도 필요하다는 “접지” 가설과 맞섭니다. 아모데이는 언어 모델을 확장하는 것이 아마도 가장 빠른 길이지만, 필요한 유일한 것은 아닐 가능성이 크다고 보게 됩니다.
맬러비와 나란히 놓으면 이것이 지난 십 년의 결정적인 갈림길입니다. DeepMind의 2010년 사업 계획서는 언어가 곧 표현된 지능이라는 생각을 물리쳤고, 허사비스는 모델이 세상을 이해하려면 세상 안에서 행동해야 한다고 여러 해 동안 믿었습니다. OpenAI는 반대쪽에 걸었고, 첫 라운드를 이겼습니다. 압축과 순수 언어가 하나의 내기, 곧 텍스트로 충분하다는 내기의 두 절반이라는 것은 하오의 해석이 아니라 제 해석입니다. 하오는 일부 직원이 언어 쪽 내기를 옹호하며 헬렌 켈러와 시각장애인을 빗댄 논거를 “혐오스럽다”고 부르고, 4장에서는 규모 확장이 자연법칙이 아니라 [“자기실현적 예언”](https://raskell.io/notes/a-self-fulfilling-prophecy/)이라고 주장합니다. 그래도 책은 이 갈림길을 분명하게 보여 줍니다.
전반부의 다른 세 대목은 별도의 노트가 되었습니다. 실리콘밸리 밖에서는 아무도 쓸모가 생기기 전에 이것에 돈을 대지 않았을 것이라는 한 중국 연구자의 견해([A billion without a plan](https://raskell.io/notes/a-billion-without-a-plan/)), 올트먼이 사무실 벽에 칠해 둔 Rickover의 말([One person can make a difference](https://raskell.io/notes/one-person-can-make-a-difference/)), 그리고 AGI가 어떤 느낌이어야 하는지에 대한 OpenAI의 그림으로서의 영화 *Her*([The interface that disappears](https://raskell.io/notes/the-interface-that-disappears/))입니다.
## 사명은 어떻게 움직이는가 {#how-a-mission-moves}
제가 가장 오래 기억할 대목은 18장 “A Formula for Empire”에 있습니다. 하오는 OpenAI의 사명이 세 가지 성분으로 이루어진 공식처럼 작동한다고 주장합니다. 원대한 야망으로 인재를 모으고, 대안을 위험해 보이게 만들어 자본을 모으며, 회사에 유리할 때마다 다시 해석할 수 있을 만큼 모호합니다. 세 번째 성분의 증거로, 하오는 사명이 단계마다 무엇을 뜻한다고 이야기되었는지를 매번 회사 자신의 말로 나열합니다.
| 연도 | 사명이 뜻한다고 이야기된 것 | 출처 |
|---|---|---|
| 2015 | “재정적 수익을 내야 할 필요에 얽매이지 않는” 비영리 조직, 연구의 오픈소스 공개 | 출범 발표 |
| 2016 | AI가 만들어지면 모두가 혜택을 누려야 하지만, 과학 자체는 공유하지 않아도 된다 | 수츠케버가 올트먼, Brockman, 머스크에게 보낸 이메일 |
| 2018~2019 | 일에 필요한 자원을 모으기 위한 이익 상한 구조, 그러면서도 안전을 돌볼 시간이 없는 경쟁은 피한다 | 헌장 |
| 2020 | 모델을 API 뒤에 가두는 것, “개방과 혜택 공유를 위한 전략”으로서 | 하오의 첫 회사 프로필에 대한 올트먼의 답변 |
| 2022 | “반복적 배포”, 그리고 ChatGPT 출시를 향한 질주 | 회사의 입장에 대한 하오의 요약 |
| 2024 | 매우 유능한 AI 도구를 무료로, 또는 아주 좋은 가격에 사람들 손에 쥐여 주는 것 | GPT-4o 출시 후 올트먼의 블로그 |
이 장은 올트먼이 나폴레옹 어록집을 칭찬하는 장면으로 시작합니다. 특히 나폴레옹이 혁명의 표어를 다시 해석해 자신의 권력을 공고히 한 방식을 높이 삽니다. 이 비유는 날카롭고, 하오도 그렇게 의도합니다. 저는 이 표를 다르게 읽습니다. 모든 단계에는 당시로서는 말이 되는 이유가 있습니다. 훈련 비용이 커졌으니 비영리 조직에 자본이 필요했고, 자본은 수익을 요구했으니 모델에 사업이 필요했으며, 경쟁자가 나타났으니 사업에 속도가 필요했습니다. 2015년의 이상주의는 하나의 결정으로 버려진 것이 아닙니다. 연산과 돈과 경쟁이라는 현실에 의해, 합리적인 한 걸음씩, 대부분 여전히 그 이상을 섬기고 있다고 믿은 사람들에 의해 닳아 없어졌습니다. 그것은 올트먼을 포함해 그 안의 어느 한 사람보다도 큰 과정이며, 저는 창업자 중 누구였더라도 같은 일이 일어났으리라고 생각합니다.
같은 과정이 11장의 더 작은 이야기에서도 보입니다. 2020년의 한 메모에서 올트먼은 OpenAI가 [“작고, 집중하고, 신뢰가 높고, 헛소리가 적고, 강도 높은”](https://raskell.io/notes/small-focused-high-trust/) 조직으로 남기를 바랐고, 2022년 말에는 신규 채용을 백 명 안팎으로 제한하자고 주장했지만 다른 임원들은 그 다섯 배를 원했습니다. OpenAI는 2022년 10월 외부 워크숍 때 약 300명이었고, 1년 뒤에는 800명 가까이 되었습니다. 큰 집단은 결국 스스로를 유지하는 데 점점 더 많은 일을 쓰게 되며, 이는 정부 부처나 기업이나 마찬가지입니다. 이 관찰에 대한 제 나름의 생각은 [Small, focused, high-trust](https://raskell.io/notes/small-focused-high-trust/)에 적어 두었습니다.
## 제가 갈라서는 지점 {#where-i-part-ways}
하오의 입장은 분명하며, 저자의 말에서 그렇게 밝힙니다. 이 책은 “기업에 관한 책이 아니라” “권력에 관한 성찰”이며, 하오는 AI의 비용을 안고 사는 세계 곳곳의 공동체에 들어가 지냈습니다. 프롤로그에서 하오는 그 은유를 분명히 말합니다. AI 기업들은 식민지적 의미의 제국입니다. 자기 것이 아닌 자원을 차지하고, 다른 이들의 노동을 착취하며, 근대성이라는 관념과 경쟁 제국과의 경주로 이를 정당화합니다. 이는 정직한 취재를 낳지만, 어떤 대목에서는 책이 AI를 만드는 사람들에 대한 기록이라기보다 그들에 대한 고발처럼 읽힙니다. 다른 곳에서 치르는 비용을 다룬 몇몇 장은 말하려는 바보다 길게 느껴졌고, 더 압축할 수 있었습니다.
그중 하나는 저도 덜어 내지 않겠습니다. 7장 “Science in Captivity”는 Timnit Gebru(팀닛 게브루)를 따라갑니다. 에티오피아에서 태어나 십 대에 에리트레아 난민으로 미국에 온 연구자로, Google의 윤리적 AI 팀을 공동으로 이끌었습니다. 그는 Joy Buolamwini와 함께 “Gender Shades”를 써서, 상업용 얼굴 분석이 피부색이 어두운 여성에게서 가장 자주 실패한다는 것을 보여 주었습니다. GPT-3가 등장하자 그는 Reddit과 Common Crawl의 나머지로 훈련한 모델이 그 독성을 흡수할 것이라고 경고했고, Emily M. Bender와 함께 “On the Dangers of Stochastic Parrots”를 썼습니다. Google은 그에게 논문 철회를 지시했습니다. 그는 조건을 내걸고 받아들여지지 않으면 떠나겠다고 했습니다. 2020년 12월 2일, Google은 그의 사직을 즉시 수리한다고 통보했고, 그는 자신이 해고되었다고 발표했습니다. 하오의 더 큰 논점은 과학에 관한 것입니다. 이 일 이후, 그리고 ChatGPT 이후, 업계는 모델을 무엇으로 훈련했는지 공개하지 않게 되었고, 훈련 데이터를 볼 수 없다면 모델을 정직하게 시험할 수 없습니다. 저는 GPT 초기, 모두가 가중치 속 편향을 이야기하던 시절의 논쟁을 기억합니다. 제 작업에서는 그 문제가 그 뒤로 뒤로 물러났습니다. 답하기 전에 도구로 사실을 찾아보는 모델은 가중치만으로 답하는 모델보다 훨씬 자주 사실을 맞힙니다. 그것이 가중치에 편향이 없다는 뜻은 아니지만, 편향이 얼마나 중요한지는 바꾸어 놓았습니다. 어느 쪽이든, 닫힌 훈련 데이터에 관한 하오의 논점은 유효합니다.
칠레에 관한 장인 “Plundered Earth”(12장)는 읽기 힘들었습니다. 하오는 칠레의 이야기를 식민지 과거, 시카고 보이스, 피노체트의 민영화, 불평등, 그리고 Gabriel Boric(가브리엘 보리치)의 당선을 통해 들려주고, 칠레를 제국에 구리와 리튬, 땅, 그리고 산티아고 주변 데이터센터를 위한 물을 대는 글로벌 사우스의 나라들 사이에 놓습니다. 저는 칠레를 좋아하고 그곳에 아는 사람들도 있는데, 그것은 이 나라를 보는 하나의 관점일 뿐 전체가 아닙니다. 칠레는 유엔 인간개발지수에서 라틴아메리카 1위입니다. 칠레 정부는 투자를 원하기 때문에 데이터센터를 유치하며, 하오 자신의 취재도 스스로 결정하는 나라를 보여 줍니다. 세리요스의 주민 투표, 2024년 Google이 산티아고에 수랭식 데이터센터를 지을 수 없다고 판결한 환경 법원, 그리고 이제 활동가들과 함께 데이터센터 전략을 작성하는 정부 부처가 그렇습니다. 세계적 기준으로 칠레는 데이터센터와 광산을 두기에 합리적인 곳이며, 긴 가뭄 속의 물 문제는 정당한 우려입니다. 여기서는 하오의 취재원들이 하오의 틀보다 더 신중합니다. 원주민 활동가 Sonia Ramos는 자기 조상이 광부였으며 문제는 규모라고 말하고, 우루과이 연구자 Daniel Pena도 데이터센터에 대해 같은 말을 합니다.
규모가 바로 제가 갈라서는 지점입니다. 올트먼, 허사비스, 그리고 다른 이들이 거는 내기는, 세계의 자원을 더 많은 지능을 만드는 데 쓰면 그것이 없으면 풀 수 없는 문제들을 풀어 결국 보상받으리라는 것입니다. 에너지가 그중 가장 큰 문제입니다. 하오에 따르면 올트먼은 자신의 가장 큰 데이터센터들의 에너지 문제가 핵융합의 돌파구와 함께 저절로 풀릴 것이라고 즐겨 말했고, 핵융합 기업 Helion은 그의 가장 큰 개인 투자처입니다. 하오는 AGI가 우리의 환경 문제를 해결하리라는 주장은 증명할 수 없다고 말하는 한 연구자의 말을 인용합니다. 맞습니다. 틀렸을 수도 있습니다. 그러나 그것은 일관된 전략이며, 이 책이 주는 것보다 더 많은 공감을 받을 만합니다. 제국이 정의상 순손실인 것은 아닙니다. 소수의 손에 집중된 권력은 해악을 가능하게 하며, 그것은 논의할 가치가 있습니다. 문제는 축적된 권력으로 무엇을 하느냐이지, 축적 그 자체가 아닙니다. 저는 자본에 관해 이 논지의 한 버전을 [A billion without a plan](https://raskell.io/notes/a-billion-without-a-plan/)에서 펼쳤습니다.
## 제국은 어떻게 무너지는가 {#how-the-empire-falls}
에필로그는 하오의 대안을 제시합니다. 뉴질랜드 최북단의 마오리어 라디오 방송국 Te Hiku Media는 공동체가 동의하에 기증한 310시간의 녹음으로 마오리어 최초의 음성 인식 모델을 만들었고, 자체 GPU 두 대로 훈련했습니다. 하오는 이를 웹에서 가져온 68만 시간으로 훈련한 OpenAI의 Whisper와 대비합니다. 이어 스탠퍼드 연구자 Ria Kalluri의 강연에서 빌려 와, 권력의 세 축으로 지식, 자원, 영향력을 꼽습니다. 하오의 설명에 따르면 AI 기업들은 인재를 집중시키고 열린 과학을 잠식하며 모델을 검증에서 차단함으로써 지식을 통제하고, 자금과 데이터, 노동, 연산, 에너지, 토지를 모아 자원을 통제하며, 이데올로기와 세상의 상상력을 사로잡는 시연을 통해 영향력을 통제합니다. 세 번째 축에 대한 하오의 처방은 대중 교육이며, 하오는 ELIZA를 만든 Joseph Weizenbaum의 말로 책을 맺습니다. 프로그램의 내부 작동이 이해할 수 있을 만큼 쉬운 말로 설명되면 [“그 마법은 무너져 내린다.”](https://raskell.io/notes/its-magic-crumbles-away/)
이 세 축은 유용한 렌즈이며, 저도 쓰겠습니다. Te Hiku는 좋은 이야기이고, 사람들이 스스로 내놓기로 한 데이터로 훈련한 작은 모델은 미래의 일부입니다. 제가 가장 중요하다고 보는 세부 사항은 놓치기 쉽습니다. Te Hiku는 자기 GPU를 샀기 때문에 어떤 거대 기술 기업의 클라우드에도 의존하지 않았습니다. 하드웨어의 소유야말로 자원이라는 축에서 보통 사람들이 실제로 바꿀 수 있는 부분입니다.
맞춤형 모델을 훈련하는 것이 그 한 가지 방법입니다. 모델을 실행하는 것이 다른 방법이며, 누군가 모델에게 무언가를 물을 때마다 점점 더 많은 연산이 여기에 쓰입니다. 이것이 제가 [Archipelag.io](https://raskell.io/articles/archipelag-io-distributed-compute-from-mining-rigs-to-open-beta/)로 풀고 있는 문제입니다. 소수의 하이퍼스케일러가 아니라 개인과 공동체가 운영하는 GPU에서 AI 작업이 실행되는 네트워크로, 가까운 호스트를 우선하고 모든 작업이 어디에서 실행되었는지 기록합니다. 지금은 공개 베타이며, 다음 프런티어 모델을 훈련하지는 않을 것입니다. 그러나 사람들이 AI를 실행하는 인프라에 대한 접근을 빌리기만 하는 것이 아니라 그 일부를 소유하게 해 주며, 소유에 따르는 것들을 함께 가져옵니다. 호스트를 맡는 사람들의 수입, 집 가까이에 머무는 데이터, 그리고 조건을 마음대로 바꿀 수 있는 단 한 명의 집주인이 없다는 것입니다. 웹은 출판에 대해 같은 일을 했습니다. 웹 이전에는 독자에게 닿으려면 인쇄기나 방송 면허가 필요했고, 웹 이후에는 컴퓨터만 있으면 누구나 페이지를 올릴 수 있었으며, 웹은 수백만 명이 바로 그 일을 하면서 자라났습니다. [Tim Berners-Lee의 회고록](https://raskell.io/articles/the-web-was-the-training-set/)에 대한 서평에서 쓴 대로입니다. 분산된 시민 컴퓨팅은 추론을 위한 같은 한 수입니다.
저는 그 처방에 전적으로 동의합니다. 이 시스템들이 어떻게 작동하는지 설명하는 것이 누구든 할 수 있는 가장 좋은 일이며, 이 사이트가 하려는 일이기도 합니다. 제가 갈라서는 곳은 그 진단이 집중 그 자체를 문제로 삼는 지점, 그리고 작은 모델을 큰 모델의 보완이 아니라 대체물로 내놓는 지점입니다.
## 누가 읽어야 하는가 {#who-should-read-it}
Sam Altman과 OpenAI, 그리고 이 기술 뒤의 사람들과 반목에 관심 있는 모든 사람에게 권합니다. 가능하다면 하오가 대부분 주어진 것으로 여기는 기술을 설명해 주는 *The Infinity Machine*을 먼저 읽고 나서 읽기를 권합니다. 세부 묘사는 대단하며, 저는 올해 읽은 대부분의 책보다 이 책에서 기억할 만한 일화를 더 많이 얻었습니다. 조금 더 초점이 분명했으면 좋았겠습니다. 올트먼 주변 사람들에게 닿을 수 있었던 하오라면, 사람들에 관해서만 쓴 더 단단한 책은 한층 더 웅장했을 것입니다.
제게 남는 것은 하오가 비판으로 끌어내는 한 가닥의 실입니다. 이 책은 두 개의 제사로 시작합니다. 설명되면 무너지는 마법에 관한 Weizenbaum의 말, 그리고 올트먼의 블로그에서 가져온 한 줄입니다. 10장에서 하오는 둠어(Doomer)와 부머(Boomer)가 같은 성경을 설교한다고 씁니다. 한쪽은 지옥불을, 다른 쪽은 천국을 말합니다. 18장에서 하오는 2013년 올트먼의 그 문장으로 돌아갑니다. 가장 성공한 창업자들은 [“종교에 더 가까운 무언가”](https://raskell.io/notes/something-closer-to-a-religion/)를 만들려 하며, 회사는 결국 그것을 이루는 가장 쉬운 방법이라는 것입니다. 그리고 17장에서 하오는 한 팟캐스트에서 그가 [“지능은 그저 물질의 창발적 속성”](https://raskell.io/notes/an-emergent-property-of-matter/)이라고 한 말을 과장 광고로 인용합니다. 저는 그 확신을 공유하며, 그에 관해 [An emergent property of matter](https://raskell.io/notes/an-emergent-property-of-matter/)에 썼습니다. 하오가 종교를 경고 신호로 본다면, 저는 이 회사들이 무엇이 되어 가고 있는지에 대한 정직한 묘사로 봅니다. 인간 노동의 가치가 떨어지면서, 이 회사들을 묶어 두는 것은 그들이 돈을 주고 사는 일이 아니라 그들이 믿는 것이 될 것입니다. OpenAI는 그 첫 번째 회사 중 하나이며, 그 사명은 계속 움직일 것입니다.
================================================================================
---
title: "두뇌 없는 세 부분"
url: https://raskell.io/ko/articles/three-parts-and-no-brain/
author: Raffael Schneider
date: 2026-11-05
description: "체스 프로그램은 무엇으로 이루어지는지, 그리고 손으로 쓴 프로그램이 학습을 시작하기 전에 lichess의 컴퓨터 상대를 상대로 어디까지 통하는지에 관한 글입니다."
tags: [game-ai, tree-search, games, rust, metrics, probability, chess, shogi, go-game]
series: learning-to-play
lang: ko
translation_of: https://raskell.io/articles/three-parts-and-no-brain/
---
# 두뇌 없는 세 부분
## 요약
학습을 시작하기 전에, 저는 레비가 설명한 세 부분으로 Kishi의 체스 엔진을 만들었습니다. 숫자로 바꾼 판, 누가 더 나은지 말하는 평가 함수, 그리고 앞을 내다보는 탐색입니다. 비트보드 표현은 변경할 때마다 perft로 검사하고, 손으로 쓴 PeSTO 평가 함수에는 체스가 거의 담겨 있지 않습니다. 강함은 탐색과, 그 안에 쌓인 조정된 통계적 내기들에 있습니다. 강함을 정직하게 측정하는 일이 가장 어렵습니다. 매치에는 짝지은 오프닝, 같은 탐색 예산, 명시한 오차 범위가 필요하며, 증명되지 않은 작은 플러스 결과는 유지하되 내세우지 않는다는 뜻입니다. 다시 만든 lichess 컴퓨터를 상대로, 손으로 쓴 평가 함수와 코어 하나를 쓴 Kishi는 레벨 6과 레벨 7 사이에 있으며, 넓은 오차 범위는 빼지 않고 함께 보고합니다. 같은 구성은 쇼기에서 괜찮은 클럽 상대가 되지만 바둑에는 대신 무작위 플레이아웃이 필요하며, 이 기준선은 프로젝트에서 학습시킬 모든 신경망이 이겨야 할 상대입니다.
lichess의 체스 컴퓨터에는 레벨이 여덟 개 있습니다. 저는 기차에서 휴대폰으로 이 컴퓨터와 두는데, 이 컴퓨터와 두어 본 모든 사람이 그렇듯 저에게도 이길 수 있는 레벨과 저를 이기는 레벨이 있습니다. 지난달 제 엔진을 만들었을 때, 그것을 보여 준 사람마다 처음 던진 질문은 제가 스스로에게 묻고 있던 질문과 같았습니다. 몇 레벨이냐는 것입니다. 세상에서 가장 답하기 쉬운 질문처럼 들립니다. 알고 보니 그것은 프로젝트 전체에서 가장 어려운 부분이었고, 프로그램이 아예 두게 만드는 일보다도 어려웠으며, 그 답이 이 글의 요점입니다.
[첫 번째 글](https://raskell.io/articles/learning-to-play/)에서 저는 열두 살의 Demis Hassabis(데미스 허사비스)가 David Levy(데이비드 레비)의 체스 컴퓨터 핸드북을 읽고 체스 프로그램이 세 부분으로 이루어진다는 것을 배운 이야기를 했습니다. 숫자로 바꾼 판, 누가 더 나은지 말하는 함수, 그리고 앞을 내다보는 탐색입니다. 저는 그 세 부분을 Rust로 만들었고, 직접 만들어 보면 각 부분이 실제로 무엇인지 보여 드리고 싶습니다. 놀라운 점은 그중 어느 것이 체스를 담고 있느냐이기 때문입니다. 그다음에는 결과에 숫자를 붙이고, 그 숫자에 왜 오차 범위가 따라오는지 보여 드리고 싶습니다. 대부분의 사람이 슬그머니 빼 버리는 그 오차 범위 말입니다.
이 글에서는 아무것도 학습하지 않습니다. 의도한 것입니다. 체스 국면을 평가하는 법을 배우는 신경망에게는 학습 재료가 될 대국을 둘 상대가 필요하고, 나중에 이겨야 할 상대도 필요합니다. 그렇지 않으면 그것이 무엇이라도 배웠는지 알 길이 없습니다. 이 글이 다루는 것이 바로 그 상대입니다.
## 숫자로 바꾼 판 {#the-board-as-numbers}
레비의 첫 번째 부분은 사소하게 들리지만 그렇지 않습니다. 체스판에는 64칸이 있고 현대의 프로세서는 64비트 숫자를 다루므로, 자연스러운 표현은 기물 종류마다 숫자 하나를 두고, 그 종류의 기물이 서 있는 칸마다 비트 하나를 켜는 것입니다. 백과 흑의 여섯 가지 기물 종류마다 하나씩, 숫자 열두 개면 국면이 됩니다. 수 하나는 16비트입니다. 어디에서, 어디로, 그리고 어떤 종류의 수인지를 나타내는 비트 몇 개입니다. 대국의 전체 상태가 이 문단보다 적은 메모리에 들어갑니다.
이것이 중요한 이유는 속도입니다. “이 나이트는 어디로 갈 수 있는가”라는 질문은 표 하나를 찾아보는 일이 되고, “킹이 공격받고 있는가”라는 질문은 그 숫자들에 대한 AND와 OR 몇 번이 됩니다. 엔진은 이런 질문을 초당 수천만 번 던지고, 그 하나하나가 정확히 맞아야 합니다. 체스 규칙에는 까다로운 예외가 있기 때문입니다. 공격받는 칸을 지나가는 캐슬링이 그렇습니다. 앙파상으로 잡는 폰이, 그렇게 잡으면서 같은 가로줄을 따라 자기 킹에 대한 체크를 열어 버리는 경우도 그렇습니다. 수 생성에 드문 버그 하나가 있는 프로그램은 천 판을 아무 일 없이 두다가 불법 수를 두어 한 판을 지고, 그것이 어떤 규칙이었는지 아무도 알아채지 못합니다.
이것을 위한 시험에는 perft라는 이름이 있고, 모든 엔진 작성자가 가장 먼저 돌리는 것입니다. 알려진 국면에서 정해진 깊이까지 합법적인 수순을 빠짐없이 세고, 수십 년 동안 합의되어 온 공개된 숫자와 비교합니다.
| 내다보는 수 | 시작 국면에서 도달할 수 있는 국면 |
|---|---|
| 1 | 20 |
| 2 | 400 |
| 3 | 8,902 |
| 4 | 197,281 |
| 5 | 4,865,609 |
깊이 5에서 프로그램이 4,865,609라고 말한다면, 적어도 시작 국면에 대해서는 규칙이 맞는 것입니다. 모두가 쓰는 두 번째 국면도 있는데, Kiwipete라는 별명이 붙어 있고 캐슬링 권리와 앙파상과 프로모션이 한꺼번에 살아 있습니다. 그리고 더 고약한 종반 국면 몇 개가 있습니다. Kishi는 변경할 때마다 이 전체 묶음을 돌립니다. 또 프로젝트의 모든 매치 도구는 상대의 수를 Kishi 자신의 생성기와 대조하므로, 두 프로그램이 규칙에 대해 의견이 갈리면 그 대국은 조용히 점수가 매겨지는 대신 요란하게 실패합니다.
결정 하나가 그 뒤로 엔진을 어디서나 따라다닙니다. Kishi에서 국면은 수정되지 않고 복사되는 작은 값입니다. 수를 두면 새 국면이 돌아오고 옛 국면은 그대로 남으므로, “되돌리기(unmake)”가 없고 둘이 서로 어긋날 길도 없습니다. 수마다 이삼백 바이트를 복사하는 비용이 들고, 그 대가로 자기 자신과 어긋날 수 없는 코드를 얻습니다. 나중에 WebAssembly로 컴파일되어 여러 스레드에서 동시에 돌아갈 프로그램에게는 맞는 거래였고, 다시 하더라도 저는 같은 선택을 하겠습니다.
## 평가 함수 {#the-evaluation}
레비의 두 번째 부분은 체스를 담고 있으리라 예상했던 부분인데, 거의 아무것도 담고 있지 않습니다. 평가 함수는 앞을 내다보지 않고 국면 하나만 보고 숫자를 돌려줍니다. 누가 얼마나 더 나은지를 폰의 100분의 1 단위로 말합니다. +100은 둘 차례인 쪽이 폰 하나를 앞서 있거나, 위치상 그에 맞먹는 이점이 있다는 뜻입니다. 허사비스가 읽은 그 책에서 레비가 든 예는 기물 대 기동성이었습니다. 남은 기물이 그 기물들이 닿을 수 있는 칸보다 두 배 중요하다면, 기동성 점수를 더하기 전에 기물 점수를 두 배로 하라는 것입니다. 아이디어는 지금도 정확히 그것, 셀 수 있는 것들에 매긴 가중치입니다.
Kishi의 손으로 쓴 평가 함수는 PeSTO라는 잘 알려진 표 묶음입니다. 열두 가지 기물마다 칸 하나에 숫자 하나씩, 64개의 숫자로 된 표가 있습니다. 중앙의 나이트는 가장자리의 나이트보다 가치가 높고, 킹은 중반에는 구석에, 종반에는 중앙에 있어야 하며, 판 위로 멀리 나아간 폰은 제자리에 있는 폰보다 가치가 높습니다. 기물마다 표가 두 개, 중반용과 종반용이 있고, 평가 함수는 남은 기물의 양에 따라 둘을 섞습니다. 판 위에 있는 기물들의 항목을 더하면, 그것이 그 숫자입니다.
그 밖에는 아무것도 모릅니다. 각 폰이 어디 서 있는지 외에는 폰 구조에 대해, 킹이 어디 서 있는지 외에는 킹의 안전에 대해 아무것도 모르고, 룩이 오픈 파일에 있는지, 두 기물이 서로 어떤 관계인지도 모릅니다. 768개의 숫자 두 벌과 보간 하나가 전부인데, 체스를 두는 대부분의 사람을 이길 만큼 체스를 잘 둡니다. 이것은 이런 프로그램의 강함이 어디에 있는지에 대해 무언가를 말해 줍니다. 지식 속에는 없습니다.
768이라는 숫자는 다음 글에서 다시 다루겠습니다. 이 표를 대체하기로 되어 있는 신경망의 입력이 정확히 768개이고, 그것은 우연이 아니기 때문입니다.
엔진 안에는 이미 작은 학습이 하나 있는데, 이 프로젝트 전체가 다루는 아이디어의 가장 작은 예로서 한 문장을 할애할 만합니다. 탐색은 자기가 본 폰 구조마다 평가 함수가 최근에 얼마나 틀렸는지를 표에 기록하고, 평가 함수를 쓰기 전에 그 이동 평균으로 보정합니다. 이 보정은 대국 중에 탐색 자신의 더 깊은 결과로부터 학습되고, 대국이 끝나면 버려집니다.
## 탐색 {#the-search}
레비의 세 번째 부분에 엔지니어링이 있고, 강함도 여기서 나옵니다. 탐색은 모든 수와 모든 응수와 그 응수에 대한 모든 응수를 시도해 도달할 수 있는 국면들의 트리를 만들고, 끝에 있는 국면들에 대해 평가 함수에 묻습니다. 교과서적인 형태는 미니맥스입니다. 상대는 언제나 나에게 가장 나쁜 응수를 고른다고 가정하고, 최악의 경우가 가장 나은 수를 고릅니다. 알파베타는 트리의 대부분이 중요하지 않다는 증명을 곁들인 미니맥스입니다. 응수 하나가 어떤 수가 충분히 나쁘다는 것을 보여 주고 나면, 그 수의 나머지 진행은 더 읽지 않습니다. 계약서에서 거래를 깨뜨리는 문장을 찾으면 그 조항의 나머지를 더 읽지 않는 것과 같습니다. 매 단계에서 가장 좋은 수를 먼저 살펴본다면, 알파베타는 미니맥스만큼 멀리 보면서 방문하는 국면은 대략 미니맥스의 제곱근 정도에 그칩니다.
현대의 엔진이 그 위에 더하는 모든 것은 체스에 대한 내기이고, 모든 내기는 가끔 틀립니다. 엔진은 내기들이 사 주는 추가 깊이가 그것들이 치르게 하는 실수보다 값어치가 있도록 조정됩니다.
| 기법 | 내기 | Kishi에서 |
|---|---|---|
| 트랜스포지션 테이블 | 같은 국면에 서로 다른 수순으로 도달하므로, 찾아낸 것을 기억합니다 | 모든 스레드가 잠금 없이 공유하는 테이블의 16바이트 항목 |
| 수 정렬 | 가장 좋을 법한 수를 먼저 보아 컷오프가 일찍 일어나게 합니다 | 테이블이 기억하는 수, 그다음 가치 순으로 정렬한 잡는 수, 그다음 최근에 컷오프를 일으킨 수 |
| 널 무브 프루닝 | 아무것도 하지 않아도 이미 충분히 좋다면 수를 두어도 좋으니, 나머지는 건너뜁니다 | 패스한 뒤의 더 얕은 탐색, 앞서 있을수록 더 얕게 |
| 리버스 퓨틸리티 프루닝 | 얕은 깊이에서 목표보다 한참 위에 있으면 그만 봅니다 | 마진은 깊이 한 수당 폰의 100분의 75, 최대 여덟 수까지 |
| 레이트 무브 리덕션 | 정렬에서 뒤로 밀린 수는 최선인 경우가 드무니 더 얕게 탐색합니다 | 깊이와 수 순번의 로그로 된 공식 |
| 싱귤러 익스텐션 | 다른 모든 대안보다 훨씬 나은 수 하나는 더 깊이 볼 가치가 있습니다 | 깊이 여덟 수부터 |
| 정지 탐색 | 교환 도중에는 절대 평가하지 않습니다 | 국면이 잠잠해질 때까지 계속 잡고, 그다음에 묻습니다 |
이 가운데 제가 만든 것은 하나도 없습니다. 이것들은 오픈 소스 엔진들이 함께 물려받은 유산으로, 30년에 걸쳐 하나하나를 수만 판의 대국으로 시험한 사람들이 다듬어 낸 것이며, Kishi의 탐색이 연구 프로젝트가 아니라 수천 줄로 끝나는 이유이기도 합니다. 이 표에서 가져가셨으면 하는 것은 그 모양입니다. 체스 탐색은 통계적인 내기의 더미이고, 각 내기에는 폰의 100분의 1 단위로 적힌 마진이 있으며, 각각은 함께 돌아가는 특정한 평가 함수에 맞추어 조정되어 있습니다. 내기들은 평가 함수가 무엇인지 모릅니다. 다음 글에서 평가 함수가 바뀌고, 그 문장은 값비싼 문장이 됩니다.
이 모든 것을 갖추면, 노트북의 코어 하나에서 엔진은 초당 약 300만 개의 국면을 살펴보고, 판을 한 번 톡 치는 데 걸리는 시간인 0.5초 동안 열일곱에서 스무 반수 앞을 내다봅니다. 1997년의 Deep Blue는 오직 그 일만을 위해 만든 하드웨어 위에서 초당 2억 개의 국면을 살펴보며 열둘에서 열여섯 반수 앞을 내다보았습니다. 60배 적은 국면으로 조금 더 멀리 봅니다. 그 차이가 바로 내기들입니다.
## 무엇을 어떻게 아는가 {#how-you-know-anything}
이제 어려운 부분입니다. 두 체스 프로그램은 서로 둘 수 있고, 한쪽이 더 자주 이기며, 우리는 그것을 숫자로 바꾸고 싶습니다. 체스에는 1960년대부터 그런 숫자가 있었습니다. Elo 레이팅입니다. 모든 클럽 선수가 아는 숫자이고, 제가 십대 때 지역 대회에서 처음 만난 숫자이기도 해서, 그 산수가 저에게는 한 번도 추상적으로 느껴진 적이 없습니다. 400점 차이는 10대 1의 승산을 뜻합니다. 100점 차이는 강한 쪽이 약 64퍼센트의 점수를 얻는다는 뜻입니다. 두 프로그램 사이의 레이팅 차이는 둘 사이 매치의 점수로 계산되는데, 문제는 짧은 매치의 점수가 대부분 잡음이라는 것입니다.
체스 엔진 개발자들에게는 이를 위한 정직한 도구가 하나 있고, 그 정직함이 설계에 깃들어 있으므로 설명할 가치가 있습니다. 두 프로그램은 같은 무작위 오프닝에서 수백 판을 두는데, 각 오프닝은 색을 바꾸어 두 번씩 두어 운 좋은 오프닝이 한쪽에 유리하게 작용하지 못하게 합니다. 양쪽 모두 한 수에 탐색할 수 있는 국면 수를 똑같이 받으므로, 더 빠른 프로그램이 더 강한 프로그램으로 행세할 수 없습니다. 그리고 결과에는 95퍼센트 신뢰 수준의 오차 범위가 따라오는데, 그 크기는 둔 대국 수에 달려 있습니다.
| 대국 수 | 오차 범위 |
|---|---|
| 20 | 위아래로 약 200 레이팅 포인트 |
| 400 | 약 32 |
| 600 | 약 23 |
이 도구를 믿기 전에 저는 그것을 자기 자신에게 겨누어 보았습니다. 양쪽에 같은 프로그램, 한 수에 국면 1만 개, 600판입니다.
```text
Kishi vs Kishi, 10,000 nodes a move, 600 games: +211 =181 -208 elo +1.7 ± 23.3
```
오차 23에 +1.7은 도구가 0을 읽은 것이고, 아무것도 바뀌지 않았을 때 읽어야 하는 값이 바로 그것입니다. 그다음이 진짜 시험이었습니다. 앞에서 설명한 폰 구조 보정을 넣은 엔진 대 그것을 뺀 엔진입니다.
```text
Kishi vs Kishi without correction, 600 games: +219 =180 -201 elo +10.4 ± 23.3
```
아마 플러스이겠지만, 증명된 것은 아닙니다. 큰 엔진 프로젝트들은 변경 하나마다 이 시험을 수만 판으로 돌리고, 답이 어느 쪽으로든 분명해지는 순간 매치를 멈추는 통계 규칙을 씁니다. 노트북에서 600판은 하룻저녁 일이고, 오차 23에 +10을 정직하게 읽으면 “유지하되, 내세우지는 말 것”입니다. 저는 이 문장이 체스 밖에서도 꽤 쓸모 있다는 것을 알게 되었습니다.
## lichess 사다리 {#the-lichess-ladder}
Kishi의 두 버전 사이의 매치는 어느 쪽이 더 나은지 말해 줍니다. 둘 중 어느 쪽이 얼마나 좋은지는 아무것도 말해 주지 않습니다. 그러려면 프로그램은 사람들이 이미 그 강함을 아는 무언가와 두어야 하고, 제가 아는 가장 쓸모 있는 잣대는 여러분 주머니 속에 있는 것, 곧 lichess의 컴퓨터 상대입니다. 누구나 두어 보았고, 누구에게나 자기를 이기는 레벨이 있기 때문입니다.
여덟 레벨은 여덟 개의 서로 다른 프로그램이 아닙니다. 세계에서 가장 강한 오픈 소스 엔진인 Stockfish를 세 가지 방식으로 동시에 일부러 약하게 만든 것입니다. 일부러 더 나쁜 수를 고르게 하는 스킬 설정, 몇 수 앞까지 볼 수 있는지에 대한 상한, 그리고 한 수당 시간 제한입니다. 설정은 lichess가 돌리는 클라이언트에 공개되어 있으므로, 이 상대를 노트북에서 정확히 다시 만들 수 있습니다.
| 레벨 | 스킬 | 깊이 | 한 수당 시간 |
|---|---|---|---|
| 1 | −9 | 5 | 50 ms |
| 2 | −5 | 5 | 100 ms |
| 3 | −1 | 5 | 150 ms |
| 4 | 3 | 5 | 200 ms |
| 5 | 7 | 5 | 300 ms |
| 6 | 11 | 8 | 400 ms |
| 7 | 16 | 13 | 500 ms |
| 8 | 20 | 22 | 1,000 ms |
Stockfish 자체의 스킬 설정은 0에서 멈추므로, 제가 다시 만든 레벨 1부터 3은 실제보다 조금 강합니다. 레벨 4부터 8은 정확합니다. Kishi는 코어 하나에서 Stockfish 19와 레벨마다 20판씩, 자기 앱이 해당 레벨에 주는 시간으로 두었습니다.
| 상대 | Kishi의 한 수당 시간 | 점수 | 레이팅 차이 |
|---|---|---|---|
| lichess 레벨 4 | 200 ms | 20판에서 19점 | +511, 오차 ±646 |
| lichess 레벨 6 | 500 ms | 20판에서 13점 | +108, 오차 ±165 |
| lichess 레벨 7 | 500 ms | 20판에서 ½점 | −636, 오차 ±579 |
레벨당 20판으로는 버스가 지나갈 만큼 넓은 오차 범위가 나오며, 그래서 오차를 빼지 않고 표에 넣었습니다. 그래도 숫자로 말할 수 있는 것은 이것입니다. 손으로 쓴 평가 함수로, 코어 하나에서, 한 수에 0.5초를 쓸 때 Kishi는 lichess의 레벨 6과 레벨 7 사이에 있습니다. 여러분을 이기는 것이 레벨 6이라면, Kishi는 그것을 세 판에 두 판 꼴로 이깁니다. 레벨 7은 강함을 대부분 그대로 지닌 채 열세 수 깊이로 생각하는 Stockfish이고, 20판에 무승부 한 번은 그 거리를 정직하게 묘사한 것입니다. 레벨 8은 깊이 22의 Stockfish, 다시 말해 그냥 Stockfish이고, 노트북에서 손으로 쓴 어떤 평가 함수도 거기에 닿지 못할 것입니다.
앱은 휴대폰에서 코어 네 개로 두고 이 숫자들은 코어 하나에서 나온 것이므로, [kishi.raskell.io](https://kishi.raskell.io)에서 만나는 상대는 표보다 조금 강합니다. 학습한 신경망들이 나오는 대로 휴대폰의 예산으로 다시 측정하겠습니다. 그것들을 앱에 실을지 결정하는 측정이 바로 그것이기 때문입니다.
## 같은 세 부분, 두 번 더 {#the-same-three-parts-twice-more}
쇼기도 같은 방식으로 만들었습니다. 숫자로 바꾼 판에는, 잡은 말이 손에 들어갔다가 다시 판으로 돌아올 수 있다는 까다로운 점이 하나 더 있습니다. 손으로 쓴 평가 함수는 말의 가치를 세되 손에 든 말을 판 위의 말보다 조금 더 높게 치고, 자기 왕 가까이 있는 금장과 은장에 보상을 줍니다. 그리고 같은 내기들을 지닌 같은 탐색입니다. 쇼기를 두는 변형 엔진 Fairy-Stockfish를 상대로 한 수에 0.5초씩 주었을 때, 가장 약한 스킬 설정에는 20판 중 20판을, 중간 설정에는 20판 중 2판을 이깁니다. 괜찮은 클럽 상대이지만 강한 수준과는 거리가 멀고, 손으로 쓴 평가 함수는 이미 설계가 삐걱거리는 지점입니다. 말이 판으로 돌아오니 단순화해 들어갈 종반이 없고, 칸의 표가 말해 주는 것은 점점 줄어듭니다.
바둑은 세 부분을 얻지 못했습니다. 통하지 않기 때문입니다. 바둑 국면에서 누가 이기고 있는지 알려 주는 361개 점의 표는 없고, 19×19 판에서 네 수 앞을 내다보는 탐색은 거의 아무것도 보지 못합니다. Kishi의 바둑 엔진은 2008년의 프로그램들이 두던 방식으로 둡니다. 빠른 무작위 대국 수천 판을 끝까지 두어 보고 세는 것입니다. 그리고 가장 낮은 레벨의 GNU Go를 상대로 열 판 중 세 판을 이깁니다. 그 방법과, 그것이 왜 AlphaGo가 빠져나와야 했던 막다른 길이었는지는 따로 한 편의 글감입니다.
## 치른 비용 {#what-it-cost}
| | |
|---|---|
| 엔진 | Rust로 며칠, 코딩 에이전트와 함께 작성, 방향은 제가 잡음 |
| 규칙 시험 | 변경할 때마다 몇 초 |
| 코어 하나에서 초당 탐색한 국면 수 | 300만에서 370만 |
| 한 수에 국면 1만 개로 두는 600판 매치 | 코어 열 개로 하룻저녁 |
| lichess 레벨 하나와 두는 20판 | 몇 분 |
기준선은 이 프로젝트 전체에서 가장 중요한 숫자이고, 가장 화려하지 않은 숫자입니다. 그것은 학습한 모든 신경망이 이겨야 할 상대이고, 그것들이 처음 배울 대국을 만들어 낼 선수이며, 나머지 작업이 필요 없게 만들려고 애쓰는 대상입니다. 직접 만든 레비의 세 부분은 손으로 쓴 768개 숫자의 표와 아주 많은 탐색을 담고 있고, 여러분 휴대폰 속 컴퓨터의 레벨 6과 7 사이에 자리합니다. 다음 글에서는 그 표에 은닉층을 하나 더하고, 그 대가가 무엇인지 알아봅니다.
## 참고 문헌 {#references}
- Ronald Friederich, [PeSTO's evaluation function](https://www.chessprogramming.org/PeSTO%27s_Evaluation_Function), Chess Programming Wiki.
- [Perft results](https://www.chessprogramming.org/Perft_Results), Chess Programming Wiki.
- lichess, [fishnet](https://github.com/lichess-org/fishnet): 컴퓨터 레벨을 두는 클라이언트와 레벨 표.
- Arpad Elo, *The Rating of Chessplayers, Past and Present* (Arco, 1978).
- [Kishi](https://github.com/raskell-io/kishi): 탐색과 평가 함수는 `engine/`, 매치 실행기는 `tools/`, 여기 인용한 모든 매치는 `docs/study/notebook.md`.
================================================================================
---
title: "IT 인텔리전스(IT Intelligence): 엔터프라이즈 IT에 빠진 데이터 계층"
url: https://raskell.io/ko/articles/it-intelligence/
author: Raffael Schneider
date: 2026-11-04
description: "비즈니스 인텔리전스는 회사가 어떻게 팔고 있는지 알려 줍니다. 그러나 회사의 IT가 어떻게 맞물려 있는지는 아무것도 알려 주지 않습니다. 제가 엔터프라이즈 컨텍스트 플랫폼을 만들기 시작한 이유입니다."
tags: [enterprise-architecture, context-engineering, legibility, knowledge-management, provenance, democratisation, oss, future-of-work]
lang: ko
translation_of: https://raskell.io/articles/it-intelligence/
---
# IT 인텔리전스(IT Intelligence): 엔터프라이즈 IT에 빠진 데이터 계층
## 요약
기업들은 자신이 어떻게 팔고 있는지 알기 위해 비즈니스 인텔리전스를 만들었지만, 어떤 IT를 가지고 있는지, 누가 그것을 소유하는지, 그것이 어떻게 연결되어 있는지는 값싸게 답하지 못합니다. 저는 그 빠진 계층을 IT 인텔리전스라고 부릅니다. 사실들은 서로 분리된 기록 시스템에 흩어져 있고, 그 사이의 지식은 구전 지식과 지식 사일로 속으로 사라집니다. 암묵적 지식, 정보 정치, 지식 은폐에 관한 연구가 그 이유를 설명하는 데 도움이 됩니다. 제가 만들고 있는 엔터프라이즈 컨텍스트 플랫폼은 모든 소스를 수집하고, 정확도를 점수로 매기며, 출처와 신뢰도를 지닌 엔티티들의 온톨로지로 정리해 웹 UI, REST, MCP로 제공합니다. IT 컨텍스트는 기본적으로 열려 있어야 하고 오픈 소스 위에 지어져야 합니다. 컨텍스트가 없는 에이전트는 비싸게 탐색하고, 일을 중복하고, 추측하지만, 공유된 모델은 재발견을 조회로 바꾸기 때문입니다. 에이전트가 더 많은 코드를 쓰고 일이 한 단계 높은 추상화 수준으로 올라가면서, 희소한 구현 역량을 중심으로 만들어진 조직이 다음 병목이 되고, 조직은 그 모양을 바꿔야 할 것입니다.
큰 회사에 지난 분기 독일에서 보험 계약을 몇 건 팔았는지 물으면 몇 초 만에 답이 나옵니다. 차트와 추세선, 채널별 내역까지 함께 나옵니다. 같은 회사에 어떤 애플리케이션이 고객의 건강 데이터를 처리하는지, 누가 그것을 소유하는지, 어떤 클러스터에서 돌아가는지, 그중 어느 것이 이미 언어 모델을 호출하고 있는지 물으면, 회의가 잡히고, 이어서 스프레드시트가 오고, 그 스프레드시트가 CMDB와 맞지 않아서 두 번째 회의가 잡힙니다.
기업들은 30년 동안 비즈니스 인텔리전스를 만들어 왔습니다. 그러나 자기 IT를 위한 같은 것은 한 번도 만들지 않았습니다. 저는 그 빠진 것을 **IT Intelligence**(IT 인텔리전스)라고 부르기 시작했고, 그것을 제공하는 플랫폼을 **Enterprise Context Platform**(엔터프라이즈 컨텍스트 플랫폼)이라고 부르기 시작했습니다.
## 그 공백을 드러낸 일 {#the-job-that-made-the-gap-visible}
한동안 저는 스위스의 한 금융 그룹에서 에이전틱 AI와 AI 플랫폼을 담당하는 엔터프라이즈 솔루션 아키텍트로 일했습니다. 대형 보험 사업과 은행을 함께 거느리고, 열 개가 넘는 마켓 유닛을 통해 운영되는 그룹입니다. 제 과제는 조화였습니다. 모든 마켓 유닛의 솔루션 아키텍처 지침, 정책, 설계가 엔터프라이즈 아키텍처가 정의한 역량(capability)을 제대로 해석하고 있는지 확인하는 일이었고, 그 역량은 다시 기업 전략에서 도출된 것이었습니다.
서류상으로는 깔끔한 사슬입니다.
*The chain as it is drawn*
```text
┌──────────────────────────┐
│ corporate strategy │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ enterprise architecture │ capabilities, principles, target landscape
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ solution architecture │ directives, policies, reference designs
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ 10+ market units │ actual systems, actual teams, actual budgets
└──────────────────────────┘
```
실제로는 각각의 화살표가 사람이 문서로, 저마다 다른 속도로 하는 번역입니다. 전략은 1년 단위로 움직이고, 역량 맵는 누군가 시간이 날 때 움직이며, 솔루션 설계는 프로젝트마다, 시스템 자체는 매일 움직입니다. 하나의 역량이 열 개의 마켓 유닛에서 해석되고 나면 열 개의 해석이 생기고, 그것들이 어디서 갈라지는지 값싸게 볼 방법은 없습니다.
무엇이 좋은 상태인지 아는 것은 그 일에서 쉬운 부분이었습니다. 실제로 무엇이 있는지 아는 것이 어려운 부분이었습니다. 모든 검토는 고고학으로 시작했습니다. 어떤 애플리케이션이 존재하는지, 그것들이 어떤 플랫폼 서비스를 쓰는지, 어느 팀이 소유하는지, EA 리포지토리의 항목이 아직 코드 리포지토리와 일치하는지, 그 코드 리포지토리가 아직 클러스터에서 돌아가는 것과 일치하는지를 먼저 파헤쳐야 했습니다.
최근 저는 이 문제에 더 잘 맞는 역할로 옮겼습니다. 지금은 AI 및 데이터 부문 안에서 일하는 그룹 AI 아키텍트이고, 목표는 비슷합니다. 모든 마켓 유닛에서 AI를 조화롭게 쓰는 것입니다. 다른 점은 이제 데이터와 플랫폼을 바깥에서 검토하는 대신 그 바로 옆에 앉아 있다는 것입니다. 그 덕분에 제가 계속 있었으면 하고 바랐던 것을 만들기 시작할 수 있었습니다.
## 전에 작은 것을 하나 만든 적이 있습니다 {#i-built-a-small-one-before}
엔터프라이즈 솔루션 아키텍트가 되기 전에 저는 그룹의 웹 서비스 딜리버리 플랫폼을 맡은 플랫폼 엔지니어이자 솔루션 아키텍트였습니다. WAF, CDN, 그리고 트래픽 셰이핑을 하는 여러 인그레스 프록시로 이루어진 플랫폼으로, 회사가 내부 경계와 인터넷에 노출하는 모든 것에 웹 보안과 웹 딜리버리 역량을 함께 제공했습니다.
그 팀은 이것저것 시도해 보기 좋은 곳이었습니다. 그중 하나가 AI의 도움을 받은 WAF 규칙 큐레이션이었고, 동료 Milan Duric(밀란 두리치)과 저는 이것을 RSAC 2026에서 발표했습니다. 보안 분야 밖의 독자를 위해 덧붙이면, RSAC는 예전에 RSA Conference라고 불리던 세계 최대 규모의 보안 콘퍼런스 가운데 하나로, 매년 봄 샌프란시스코의 Moscone Center에서 열립니다. 2026년 행사에는 4만 명이 넘게 모였습니다. 실무자, 연구자, CISO들과 나란히, 그 무대에는 실리콘밸리와 정부, 때로는 할리우드의 유명 인사들도 자주 오릅니다. 저는 2024년과 2025년, 이전에 두 번 참석했고, 세 번째에 연사로 프로그램에 이름을 올린 것은 제가 조용히 자랑스럽게 여기는 일입니다. 저희 발표는 [Self-Learning WAF: Using Generative AI to Tame ModSecurity False Positives](https://path.rsaconference.com/flow/rsac/us26/FullAgenda/page/catalog/session/1753946922633001YdMq)였습니다. 콘퍼런스 자체에 관해서는 [RSAC 2026 참관기](https://raskell.io/articles/notes-from-rsac-2026/)에 썼습니다.
다른 하나는 돌이켜 보면 한 스쿼드의 권한 범위에 맞춘 작은 엔터프라이즈 컨텍스트 플랫폼이었습니다. 문제는 이 글이 다루는 것과 같았고, 크기만 더 작았습니다. 애플리케이션 팀들은 자기 웹 서비스가 어떻게 노출되어 있는지, 어떤 WAF 규칙이 적용되는지, 앞단의 CDN이 어떻게 동작하는지, 자기 DNS 레코드가 실제로 무엇을 하는지 알고 싶어 했습니다. 답은 프록시, WAF, CDN 제공자의 콘솔, DNS에 흩어져 있었고, 질문하는 팀들은 그중 어디에도 접근 권한이 없었습니다. 그래서 그들은 저희에게 물었고, 저희 한 주의 상당 부분은 질문에 답하고 변경을 손으로 수행하는 데 들어갔습니다.
저는 스쿼드 영역의 모든 데이터 구조를 **매니페스트**(manifest)로 형식화했습니다. 노출, WAF 정책, CDN 구성, DNS 레코드, 그리고 그것들이 서로 어떻게 연결되는지를 선언적으로 기술하고 Git에 저장한 것입니다. 매니페스트 위에는 세 개의 계층이 놓였습니다.
*The web delivery self-service, one squad's scope*
```text
┌──────────────────────────┐
│ Web frontend │ self-service portal: see what is
│ │ exposed and how, order changes
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ API backend │ control plane: validates requests,
│ │ starts workflows
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ Durable workflows │ create, adjust and remove resources,
│ │ do the operator work
└──────┬────────────┬──────┘
▼ ▼
manifests in Git WAF, CDN, ingress proxies, DNS
(source of truth)
```
포털은 매니페스트를 감싼 파사드였습니다. 팀은 자기 서비스를 찾아서, 그것이 어느 경계를 통해 도달 가능한지, 어떤 WAF 규칙이 적용되는지, CDN이 어떻게 캐시하고 전달하는지, 어떤 DNS 레코드가 어디를 가리키는지를 한곳에서 볼 수 있었고, CDN 벤더의 계정이 전혀 필요하지 않았습니다. 변경이 필요하면 포털에서 주문했습니다. 백엔드가 컨트롤 플레인 역할을 하며 요청을 검증하고 지속형 워크플로를 시작했고, 워크플로는 예전에 사람인 운영자가 하던 일을 했습니다. Git의 매니페스트를 갱신하고, 변경을 WAF, CDN, 프록시, DNS에 적용하고, 결과를 확인하고, 필요하면 롤백했습니다. 시간이 지나면서 워크플로는 전담 운영자가 필요했던 운영 업무를 사실상 전부 넘겨받았습니다.
밀란과 저는 이 시스템을 RSAC 2027 연사 모집에 발표 주제로 제출했습니다.
이 경험에서 얻은 세 가지 교훈이 이 글에서 다루는 플랫폼으로 곧바로 이어집니다. 데이터를 형식화하는 것이 어려운 부분이자 가치 있는 부분이었습니다. 매니페스트가 존재하고 나자 포털과 워크플로는 쉬웠습니다. 데이터를 모두가 읽을 수 있게 만들자 질문 대부분이 나오기도 전에 사라졌습니다. 그리고 데이터를 신뢰할 수 있게 되자 자동화는 거의 저절로 따라왔습니다. 엔터프라이즈 컨텍스트 플랫폼은 같은 내기를 훨씬 큰 범위와 훨씬 높은 야심으로 거는 것입니다. 한 스쿼드의 권한 범위가 아니라 그룹 전체의 IT 지형이 대상입니다.
## 비즈니스 인텔리전스에는 아무도 만들지 않은 쌍둥이가 있습니다 {#business-intelligence-has-a-twin-nobody-built}
비즈니스 인텔리전스가 작동하는 이유는 지루하고 잘 알려진 아키텍처 덕분입니다. 운영 시스템이 데이터를 만들고, 파이프라인이 그것을 추출하고, 웨어하우스가 그것을 팩트(fact)와 디멘션(dimension)으로 모델링하며, 분석가와 대시보드가 그 모델을 조회합니다. 판매 보고서를 열두 개 지역의 재무 담당자(controller)에게 이메일을 보내 취합해야 한다고 주장하는 사람은 없습니다.
IT에는 운영 시스템은 모두 있지만 나머지는 하나도 없습니다. 데이터는 있습니다. 각자 한 조각씩만 아는 기록 시스템들에 흩어져 있을 뿐입니다.
| 시스템 | 대표적인 예 | 아는 것 | 모르는 것 |
|---|---|---|---|
| EA 리포지토리(애플리케이션 포트폴리오) | Ardoq, LeanIX | 애플리케이션, 역량, 비즈니스 소유권, 수명 주기 | 그 애플리케이션이 아직 그 모양으로 존재하는지 |
| 데이터 거버넌스 카탈로그 | Alation, Collibra, Microsoft Purview | 데이터 도메인, 데이터 소유자, 분류, 리니지(lineage) | 어떤 런타임이 실제로 그 데이터를 다루는지 |
| IT 서비스 관리와 CMDB | Jira Service Management, ServiceNow | 서비스, 구성 항목, 인시던트, 변경 | 그 뒤에 있는 아키텍처상의 의도 |
| 소스 코드 플랫폼(git 호스팅) | Bitbucket, GitHub, GitLab | 리포지토리, 팀, 코드, 의존성, 활동 | 어떤 리포지토리가 어느 애플리케이션에 속하는지 |
| 컨테이너 플랫폼 | AKS, EKS, OpenShift | 클러스터, 네임스페이스, 워크로드, 이미지 | 네임스페이스에 대해 누가 책임지는지 |
| 옵저버빌리티 플랫폼 | Datadog, Dynatrace, Grafana | 대시보드, 알림, 사람들이 실제로 지켜보는 것 | 지표가 비즈니스에 무엇을 의미하는지 |
| 내부 플랫폼 서비스 | 통합 플랫폼이나 메시지 브로커, WAF, API 게이트웨이, CDN | 통합 흐름, WAF 규칙, API 노출, CDN 구성 | 요청이 거치는 처음부터 끝까지의 경로 |
예시는 각 범주에서 흔히 보이는 제품들을 알파벳순으로 나열한 것입니다. 대부분의 대기업은 각 행에서 한두 개씩 쓰고 있으며, 그것이 어느 제품인지는 논지를 바꾸지 않습니다.
모든 행은 누군가에게 무언가에 대한 진실의 원천(source of truth)입니다. 그러나 어느 행도 혼자서는 아키텍트의 질문에 답하지 못합니다. 아키텍트가 실제로 던지는 질문은 한 번에 서너 개의 행을 가로지릅니다. “마켓 유닛 X에서 고객 대면 애플리케이션 가운데 WAF 정책 없이 게이트웨이를 통해 API를 노출하는 것은 어느 것이고, 누가 그것을 소유하는가?” 같은 질문입니다.
그 질문에는 답이 있습니다. 하지만 답은 행과 행 사이의 조인(join)에 있고, 오늘날 그 조인은 사람들의 머릿속에 있습니다.
## 구전 지식과 지식 사일로 {#tribal-knowledge-and-knowledge-silos}
열 개가 넘는 마켓 유닛을 거느리고, 각 유닛이 저마다의 플랫폼과 스쿼드, 때로는 서로 경쟁하는 서비스를 가진 그룹은 두 가지 서로 다른 방식으로 지식을 잃습니다. 둘은 서로 다른 처방을 필요로 하므로 구분해 두는 것이 좋습니다. 둘 다 수십 년의 연구가 뒷받침하고 있고, 그 연구는 흔한 경영 구호보다 훨씬 쓸모가 있습니다.
### 구전 지식: 한 번도 적힌 적 없는 것 {#tribal-knowledge-what-was-never-written-down}
**구전 지식**(tribal knowledge)은 한 번도 글로 적힌 적이 없는 지식입니다. 어느 팀이 오래된 통합 허브를 실제로 운영하는지. 왜 두 애플리케이션이 데이터베이스 하나를 공유하는지. 한 마켓 유닛의 게이트웨이가 조용히 다른 유닛을 거쳐 라우팅된다는 사실. 일부러 숨긴 것이 아닙니다. 아무도 그것을 말로 옮긴 적이 없고, 구조화된 데이터로 옮긴 적은 더더욱 없을 뿐입니다. 그것은 몇 사람 안에 살고 있고, 그 사람들이 떠나면 함께 떠납니다.
철학자 Michael Polanyi(마이클 폴라니)는 *The Tacit Dimension*에서 그 바탕에 있는 현상을 고전적으로 정식화했습니다. “우리는 말할 수 있는 것보다 더 많이 알 수 있다.” 경험 많은 엔지니어가 어떤 지형에 대해 아는 것 가운데 일부는 이 엄밀한 의미에서 암묵적입니다. 그들은 어떤 설계가 통하지 않으리라는 것을, 그 이유를 말할 수 있게 되기 훨씬 전에 알아봅니다. Ikujiro Nonaka(노나카 이쿠지로)와 Hirotaka Takeuchi(다케우치 히로타카)는 그런 지식을 전환하는 과정을 중심으로 조직 학습의 모델인 SECI 모델을 세웠고, 암묵지에서 형식지로 넘어가는 단계를 *표출화*(externalisation)라고 불렀습니다. 비판자들은 암묵적 지식의 상당 부분이 끝내 명문화되지 않는다고 지적하는데, 저는 양쪽 모두 옳다고 생각합니다. IT에서 구전 지식으로 통하는 것의 상당수는 전혀 깊이 암묵적이지 않습니다. 그것은 아무도 적어 달라는 요청을 받은 적이 없는 형식지입니다. 적어 둘 곳이 없었기 때문입니다. 네임스페이스를 누가 소유하는지는 얼마든지 말로 할 수 있습니다. 단지 어디에도 기록되어 있지 않을 뿐입니다.
James C. Scott(제임스 C. 스콧)은 여기에 경고를 더합니다. 그는 『국가처럼 보기』(*Seeing Like a State*)에서 오랜 경험으로 얻는 실천적 지식인 *메티스*(mētis)를 묘사하고, 복잡한 시스템을 위에서 읽을 수 있게(legible) 만들려는 계획이 바로 그 지식을 파괴하는 경향이 있다는 것을 보여 줍니다. 단순화된 지도가 영토 자체로 취급되기 때문입니다. 회사가 스스로를 읽을 수 있게 만들어 주겠다고 약속하는 플랫폼이라면 이 경고를 진지하게 받아들여야 합니다. 컨텍스트 모델(Context Model)은 시스템을 운영하는 사람들이 아는 모든 것을 결코 담지 못할 것이고, 담고 있는 척해서도 안 됩니다. 컨텍스트 모델이 할 수 있는 일은 형식화할 수 있는 부분을 값싸게 만들고, 나머지를 지닌 사람들을 가리키는 것입니다.
그 두 번째 일에도 이름이 있습니다. Daniel Wegner(대니얼 웨그너)의 *교류 기억*(transactive memory) 이론은 집단이 어떻게 기억하는지를 설명합니다. 모두가 *누가 무엇을 아는지*만 알고 있다면, 모두가 모든 것을 알 필요는 없습니다. 작은 팀은 그런 안내 목록을 자연스럽게 만들어 냅니다. 열 개의 마켓 유닛에 걸친 수천 명의 그룹은 그럴 수 없고, 바로 그 지점에서 구전 지식은 하나의 특이한 버릇에서 위험으로 바뀝니다. 소프트웨어 공학은 이 위험의 한 형태를 *트럭 팩터*(truck factor)로 직접 측정합니다. 프로젝트가 멈추기 전에 몇 명이 떠나야 하는지를 나타내는 수입니다. Avelino(아벨리누)와 동료들은 GitHub의 인기 오픈 소스 프로젝트 133개의 트럭 팩터를 추정했고, 65퍼센트가 2 이하라는 것을 발견했습니다. 기업 내부 코드가 더 나으리라고 믿을 근거는 없습니다. 그리고 컨텍스트 모델은 이미 커밋 이력을 읽고 있으므로, 그룹의 모든 애플리케이션에 대해 트럭 팩터를 계산할 수 있습니다.
### 지식 사일로: 적혀 있지만 손이 닿지 않는 것 {#knowledge-silos-written-down-but-out-of-reach}
**지식 사일로**(knowledge silos)는 정반대의 문제입니다. 지식은 도구나 스프레드시트나 위키 공간 어딘가에 형식화되어 저장되어 있지만, 그것을 필요로 하는 사람들이 쉽게 접근할 수 없습니다. 이 불만에는 유명한 문장이 따로 있습니다. “HP가 HP가 아는 것을 알기만 한다면.” 흔히 Hewlett-Packard의 전 CEO Lew Platt(루 플랫)의 말로 알려져 있지만, Carl Sieloff(칼 실로프)는 이 표현의 뿌리를 1980년대 회사 안에서 늘 나오던 불만에서 찾습니다.
사일로는 우연일 때도 있고 의도적일 때도 있습니다. 제가 보아 온 것에 비추어 그 이유를 짐작해 보면, 다음 몇 가지가 섞여 있습니다.
- **반사적인 접근 통제.** 규제받는 회사에서 “이것을 누가 읽을 수 있는가?”에 대한 기본 답은 “가능한 한 적은 사람”이고, 이 원칙은 시스템에 관한 메타데이터에도 마치 고객 데이터인 것처럼 적용됩니다.
- **사용자 수 단위로 매겨지는 라이선스.** EA 리포지토리나 데이터 카탈로그의 독자 한 명 한 명이 라이선스 비용이라면, 읽는 일은 예산 결정이 됩니다.
- **협상 카드로서의 지식.** 어떤 질문에 답할 수 있는 유일한 팀은 회의에 초대받고, 인원을 지키고, 예산을 정당화하는 팀입니다.
- **드러나는 것에 대한 두려움.** 열린 인벤토리는 기술 부채, 중복된 플랫폼, 섀도 IT를 보여 줍니다. 모두가 그것이 보이기를 반기지는 않습니다.
- **인터페이스의 부재.** 데이터가 API 없는 레거시 도구에 들어 있고, 내보내기라고는 누군가 분기마다 손으로 만드는 스프레드시트뿐입니다.
- **유닛 사이의 경쟁.** 두 스쿼드가 겹치는 플랫폼을 제공할 때, 자기 지형을 투명하게 만드는 것은 상대에게 논거를 건네주는 일처럼 느껴질 수 있습니다.
문헌은 이 짐작 가운데 일부를 뒷받침하고 일부를 복잡하게 만듭니다. Thomas Davenport(토머스 대븐포트), Robert Eccles(로버트 에클스), Laurence Prusak(로런스 프루삭)은 스물다섯 곳이 넘는 기업의 정보 관리를 연구해 1992년에 “Information Politics”(정보 정치)로 발표했습니다. 그들의 관찰은, 정보 기술이 위계를 평평하게 하고 정보를 자유롭게 하리라 기대되었지만 종종 정반대의 일을 했다는 것이었습니다. 정보가 조직의 화폐가 되자 관리자들은 그것을 내주기에는 너무 값지다고 여겼습니다. 그들이 발견한 가장 흔한 형태를 그들은 *정보 봉건제*(information feudalism)라고 불렀습니다. 각 부서가 자기 정보를 어떻게 모으고, 저장하고, 공유할지를 스스로 통제하는 형태입니다. 30년이 지나 모든 부서가 자기 SaaS 도구를 돌리는 지금, 그 묘사는 지금도 잘 들어맞습니다.
Catherine Connelly(캐서린 코넬리)와 동료들은 한 걸음 더 나아가 *지식 은폐*(knowledge hiding), 곧 누군가 요청한 지식을 일부러 내주지 않는 행동을 연구했습니다. 그들은 세 가지 형태를 찾아냈습니다. 회피적 은폐(결코 오지 않는 답을 약속하거나 일부만 주는 것), 모르는 척하기, 그리고 합리화된 은폐(그 정보를 왜 공유할 수 없는지 설명하는 것)입니다. 세 가지 모두 불신이 예측 변인이었고, 공유를 장려하는 분위기에서는 회피적 은폐가 덜 흔했습니다. 연구가 나왔을 때 저자 가운데 한 명은 실천적 결론을 직설적으로 말했습니다. 신뢰의 분위기가 없다면 소프트웨어가 아무리 좋아도 상관없고, 사람들은 그것을 쓰지 않을 것이라고 말입니다.
Gabriel Szulanski(가브리엘 슐란스키)의 기업 내부 모범 사례 이전 연구는 제 냉소적인 목록에 대한 유용한 균형추입니다. 여덟 개 기업에서 122건의 이전을 살펴본 그는, 지식을 “끈적하게”(sticky) 만드는 것이 대개 동기가 아니라는 것을 발견했습니다. 주된 장벽은 지식 자체와 관련된 것이었습니다. 받는 쪽 유닛에 그것을 흡수할 역량이 없었고, 그 관행이 왜 효과가 있는지 완전히 이해하는 사람이 없었으며, 원천과 수신자 사이의 관계가 힘겨웠습니다. 많은 사일로는 그저 쓰기 어려울 뿐이고, 그래서 사일로는 정치적 문제인 만큼 설계의 문제이기도 합니다.
Morten Hansen(모르텐 한센)은 제가 이 플랫폼에 필수적이라고 보는 구분을 더합니다. 120개의 제품 개발 프로젝트를 연구한 그는, 유닛 사이의 약한 연결이 팀이 다른 곳의 유용한 지식을 *찾는* 데는 도움이 되지만, 복잡한 지식을 이전하려면 관련된 사람들 사이에 강한 연결이 필요하다는 것을 보여 주었습니다. 그는 이것을 탐색과 이전의 문제(search-transfer problem)라고 불렀습니다. 컨텍스트 모델은 탐색을 위한 기계입니다. 한 마켓 유닛의 엔지니어에게 그가 필요로 하는 플랫폼이 다른 유닛에 이미 있고 누가 그것을 운영하는지 알려 줄 수 있습니다. 그것을 운영해 본 경험을 이전해 줄 수는 없습니다. 그것은 여전히 대화를 필요로 합니다.
마지막으로, 조직 안의 사일로는 지형 안의 사일로가 됩니다. Melvin Conway(멜빈 콘웨이)는 1968년에, 시스템을 설계하는 조직은 자기 커뮤니케이션 구조를 복제한 설계를 만들어 내도록 제약받는다고 관찰했습니다. 서로 대화하지 않는 열 개의 마켓 유닛은 서로 대화하지 않는 열 개의 통합 플랫폼을 만듭니다. Matthew Skelton(매슈 스켈턴)과 Manuel Pais(마누엘 파이스)는 『팀 토폴로지』(*Team Topologies*)에서 이것을 뒤집어 “역콘웨이 전략”(inverse Conway manoeuvre)을 내놓습니다. 원하는 아키텍처에 맞춰 팀 구조를 설계하라는 것입니다. 그러나 지금 가진 아키텍처를 먼저 보지 않고는 그것을 잘 해낼 수 없습니다. 인류학자에서 금융 저널리스트가 된 Gillian Tett(질리언 테트)는 『사일로 이펙트』(*The Silo Effect*)에서 더 넓은 논지를 폅니다. 사일로는 나쁜 의도만이 아니라 전문성과 전문화의 부산물이며, 사일로를 가장 잘 다루는 조직은 그것을 가로질러 볼 방법을 의도적으로 만드는 조직이라는 것입니다.
### 플랫폼이 할 수 있는 것과 할 수 없는 것 {#what-the-platform-can-and-cannot-do-about-it}
| 현상 | 연구가 말하는 것 | 컨텍스트 모델이 하는 일 | 할 수 없는 일 |
|---|---|---|---|
| 암묵적 지식 | 어떤 지식은 말로 할 수 없고(Polanyi), 가독성을 위한 계획은 실천적 지식을 파괴할 수 있다(Scott) | 형식화할 수 있는 것을 기록하고, 나머지를 아는 사람들과 연결한다 | 판단과 경험을 담아내는 것 |
| 기록되지 않은 형식지 | 표출화에는 놓일 자리와 형식이 필요하다(Nonaka와 Takeuchi) | 모든 사실에 자리와 소유자와 출처를 준다 | 사람들이 그것을 적게 만드는 것 |
| 집중된 지식 | 집단은 누가 무엇을 아는지 아는 데 의존하고(Wegner), 트럭 팩터는 낮다(Avelino 외) | “누가 무엇을 아는지” 목록을 명시적으로 만들고, 애플리케이션마다 트럭 팩터를 계산한다 | 지식 자체를 퍼뜨리는 것 |
| 정보 봉건제와 지식 은폐 | 정보는 화폐이고, 은폐는 불신과 함께 커진다(Davenport 외, Connelly 외) | 읽기를 기본으로 만들고, 숨기기를 눈에 보이는 예외로 만든다 | 스스로 신뢰를 만드는 것 |
| 끈적한 지식 | 장벽은 대개 흡수 역량과 인과적 모호성이다(Szulanski) | 컨텍스트를 찾고 이해하는 비용을 낮춘다 | 학습을 대신하는 것 |
| 탐색과 이전 | 약한 연결은 찾고, 강한 연결은 이전한다(Hansen) | 모든 마켓 유닛에 걸쳐 탐색을 해결한다 | 복잡한 지식을 이전하는 대화를 대신하는 것 |
| 시스템을 빚는 조직의 사일로 | 시스템은 커뮤니케이션 구조를 닮는다(Conway) | 지형을 있는 그대로 보여 주어 팀 설계를 의도적으로 할 수 있게 한다 | 누군가를 재조직하는 것 |
마지막 열은 세 번째 열만큼 중요합니다. Jeffrey Pfeffer(제프리 페퍼)와 Robert Sutton(로버트 서튼)은 이 일반적인 실패를 *지행 격차*(knowing-doing gap)라고 불렀습니다. 조직은 무엇을 해야 하는지 알면서도 그것을 하지 않는 경우가 많습니다. 지형을 담은 열린 지도는 아는 쪽을 메워 줍니다. 하는 쪽은 여전히 인센티브, 소유권, 리더십의 문제로 남고, 그래서 이 플랫폼은 데이터만큼이나 기여와 권한을 중심으로 설계되어 있습니다.
두 문제는 아키텍트에게 같은 증상을 낳습니다. 무엇이 있는지 아는 비용이 추측하는 비용보다 높으니 사람들은 추측합니다. 결정은 부분적인 그림 위에서 내려지고, 플랫폼은 중복되며, 조화는 일련의 조회가 아니라 일련의 협상이 됩니다.
## 문제를 있는 그대로 말하면 {#the-problem-stated-plainly}
**대기업은 자기 IT에 관한 질문에 값싸고 믿을 만하게 답하지 못합니다.** 미래에 관한 어려운 질문이 아니라 현재에 관한 평범한 질문을 말하는 것입니다. 무엇이 존재하는지, 누가 그것을 소유하는지, 그것이 어떻게 연결되는지, 무엇을 위한 것인지, 그리고 그것이 전략이 말한 모습과 일치하는지입니다.
다른 모든 것은 이 하나의 공백에서 나옵니다. 전략은 늦게, 그리고 왜곡된 채로 시스템에 닿습니다. 프로젝트 없이는 누구도 시스템을 전략에 비추어 확인할 수 없기 때문입니다. 플랫폼은 두 번 만들어집니다. 두 번째 것을 만드는 팀이 첫 번째 것을 찾지 못했기 때문입니다. 아키텍처 검토는 제안을 판단하는 대신 현재 상태를 재구성하는 데 시간을 씁니다. 운영 팀은 매주 같은 질문에 답합니다. 사람이 찾아볼 수 있는 어디에도 답이 없기 때문입니다. 그리고 사람 안에, 혹은 누군가의 접근 정책 뒤에 있는 지식이, 어떤 결정이 고려하는 선택지를 조용히 정해 버립니다.
에이전트는 이것을 시급한 문제로 만듭니다. 모든 엔지니어에게 코딩 에이전트를 배포하고 딜리버리 파이프라인에서 에이전트 팩토리를 돌리는 회사는, IT에 관한 결정을 내리는 행위자의 수를 크게 늘리려 하고 있으며, 그 모두가 컨텍스트 없이 출발합니다. 엔터프라이즈 컨텍스트가 없는 에이전트는 컨텍스트가 없는 사람이 하는 일을 더 빨리 할 뿐입니다. 추측하고, 중복하고, 이미 있는 것을 만듭니다. 대안은 그들에게, 그리고 그들 주변의 사람들에게, 회사 IT의 현재 상태가 알려져 있고 신뢰할 수 있으며 누구나 읽을 수 있는 한 곳을 주는 것입니다.
그렇다면 목표는 엔터프라이즈 IT의 현재 상태를 값싸게 알 수 있고, 그것에 근거해 행동할 수 있을 만큼 신뢰할 수 있으며, 그 위에서 무언가를 만드는 모든 사람과 모든 에이전트에게 열려 있게 만드는 것입니다.
## 하나의 문제, 세 개의 규모 {#one-problem-three-scales}
돌아보면 저는 몇 년 동안 같은 문제를 점점 커지는 규모에서 다뤄 왔고, 최근에야 그것에 이름을 붙였습니다.
| 역할 | 범위 | 아무도 값싸게 답하지 못한 질문 | 제가 만들거나 한 것 |
|---|---|---|---|
| 웹 서비스 딜리버리의 플랫폼 엔지니어이자 솔루션 아키텍트 | 한 스쿼드의 권한 범위: WAF, CDN, 인그레스 프록시, DNS | 내 웹 서비스는 어떻게 노출되고 보호되는가? | Git의 매니페스트, 셀프서비스 포털, 운영자의 일을 하는 지속형 워크플로 |
| 에이전틱 AI와 AI 플랫폼의 엔터프라이즈 솔루션 아키텍트 | 10개가 넘는 마켓 유닛에 걸친 솔루션 아키텍처 | 우리가 만드는 것이 엔터프라이즈 아키텍처와 전략의 의도에 맞는가? | 검토, 지침, 참조 설계. 매번 고고학에서 시작 |
| AI 및 데이터 부문의 그룹 AI 아키텍트 | 그룹 전체의 IT 지형 | 무엇이 있고, 어떻게 맞물려 있으며, 무엇을 바꿔야 하는가? | 엔터프라이즈 컨텍스트 플랫폼 |
각 단계에서 같은 패턴이 되풀이됩니다. 먼저 데이터를 형식화해야 하고, 그다음 모두가 그것을 읽을 수 있어야 하며, 그래야 비로소 그 위에서 워크플로든 에이전트든 일을 자동화할 수 있습니다. 웹 딜리버리 스쿼드에서는 그 패턴이 통했습니다. 엔터프라이즈 솔루션 아키텍트 역할에서는 그 패턴의 부재가 그 일의 가장 큰 비용이었습니다. 엔터프라이즈 컨텍스트 플랫폼은 그 패턴을 회사 전체에 적용하려는 시도입니다.
이것은 제가 여기에 써 온 글들과도 이어집니다. [컨텍스트가 곧 제품입니다](https://raskell.io/articles/context-is-the-product/)와 [에이전트 플랫폼 핸드북](https://raskell.io/articles/what-an-agent-actually-is/)의 나머지 글들은, 리포지토리 하나의 규모에서, 에이전트가 읽는 컨텍스트가 그것이 돌아가는 모델보다 더 중요하다고 주장합니다. [메모리는 쓰기 경로입니다](https://raskell.io/articles/memory-is-a-write-path/)는 컨텍스트가 어떻게 안전하게 다시 쓰이는지에 관한 글인데, 이는 데이터 세트가 어떻게 1차 소스가 되는가라는 질문과 같습니다. 엔터프라이즈 컨텍스트 웨어하우스에 관한 노트는 제가 무엇 하나 만들기 전에 이 아이디어를 회사 규모로 스케치한 것이었습니다. 그리고 이 사이트도 같은 것의 장난감 판본입니다. [이 사이트는 지도가 되어 가고 있습니다](https://raskell.io/articles/this-site-is-becoming-a-map/)에서 설명한 것처럼, 모든 페이지가 기계를 위해 한 번 더 발행됩니다. 엔터프라이즈 컨텍스트 플랫폼은 그 실들이 프로덕션에서 만나는 곳입니다.
## 제가 말하는 엔터프라이즈 컨텍스트 플랫폼 {#what-i-mean-by-an-enterprise-context-platform}
EA 리포지토리는 아키텍트가 아키텍트를 위해 관리하는, 큐레이션된 지형 기술서입니다. 엔터프라이즈 컨텍스트 플랫폼은 IT 부서 안에서 일어나는 모든 것을 위한 데이터 계층입니다. 무엇이 만들어지고, 배포되고, 노출되고, 변경되고, 고장 나고, 관찰되고, 소유되고, 결정되는지를, 그것이 일어나는 대로, 그것이 일어나는 시스템에서 가져옵니다. EA 리포지토리는 그 소스 가운데 하나이고 아키텍트는 그 사용자 가운데 하나입니다. 주된 소비자는 점점 에이전트가 되어 가고 있습니다.
제가 만들기 시작한 플랫폼에는 세 개의 계층이 있고, 핵심은 가운데 계층입니다.
*Enterprise Context Platform*
```text
SOURCES CONTEXT MODEL SURFACES
EA repository ─────┐
data catalogue ────┤ ┌────────────────────┐
ITSM and CMDB ─────┤ │ entities │ ──▶ Web UI
source code ───────┼──▶ │ relationships │ ──▶ REST API
container platform─┤ │ provenance │ ──▶ MCP, for agents
observability ─────┤ │ confidence │
integration ───────┤ └─────────┬──────────┘
WAF and exposure ──┤ ▼
CDN ───────────────┘ analytics over the model
ingest ▼
artifacts: analyses, business
cases, diagrams, ADRs
```
**수집(ingestion).** 각 소스에는 커넥터가 하나씩 붙습니다. 그중 일부는 정적이고 결정론적입니다. 컨테이너 플랫폼의 네임스페이스는 네임스페이스이고, 소스 코드 플랫폼의 팀은 팀이며, EA 리포지토리의 애플리케이션에는 ID가 있습니다. 일부는 도움이 필요합니다. `pol-adm-svc-v2`라는 리포지토리를 EA 리포지토리의 애플리케이션 “Policy Administration”에 연결하는 것은 판단의 문제이고, 수집이 AI의 도움을 받는 곳이 바로 여기입니다. 모델이 이름, README, 소유자, 배포 레이블, 설명을 바탕으로 연결을 제안하고, 얼마나 확신하는지와 그 이유를 기록합니다.
수집 계층은 또한 모든 소스의 모든 데이터 세트에 정확도 점수를 매깁니다. 모든 기록 시스템이 같은 신뢰를 받을 자격이 있는 것은 아닙니다. 컨테이너 플랫폼에서 실시간으로 가져온 인벤토리는 실제 상태(ground truth)에 가깝지만, 1년에 한 번 손으로 관리하는 애플리케이션 목록은 그렇지 않습니다. 점수는 선언되는 것이 아니라 계산됩니다. 신선도, 필수 필드의 완전성, 같은 엔티티에 대해 그 소스가 다른 소스와 얼마나 자주 일치하는지, 그 레코드 가운데 얼마나 많은 것이 아이덴티티 해석(identity resolution)을 통과하는지 같은 신호에서 계산됩니다. 소스 스코어카드가 기록하는 내용을 스케치하면 다음과 같습니다.
```yaml
# ingestion/scorecards/ea-repository.yaml (illustrative)
source: ea_repository
dataset: applications
last_ingested: 2026-10-29T03:00:00Z
scores:
freshness: 0.62 # share of records touched in the last 180 days
completeness: 0.81 # mandatory fields present
agreement: 0.74 # facts confirmed by at least one other source
resolvability: 0.88 # records matched to a Context Model entity
overall: 0.76
```
점수는 모델 안으로 전달됩니다. 점수가 높은 데이터 세트에서 도출된 관계는 점수가 낮은 데이터 세트에서 도출된 관계보다 높은 신뢰도로 출발하고, 모든 소유자는 자기 소스가 나머지와 비교해 어떤지 볼 수 있습니다.
**컨텍스트 모델(Context Model).** 이것이 온톨로지이자 플랫폼의 심장입니다. 소스에서 온 원시 레코드는 모델이 아닙니다. 모델은 그 레코드들로부터 추론해 낸 추상적인 엔티티들과 그것들 사이의 관계의 집합입니다. 애플리케이션(Application)은 리포지토리(Repository)들로 구현되고, 네임스페이스(Namespace) 안의 워크로드(Workload)로 배포되며, 팀(Team)이 소유하고, 역량(Capability)을 지원하며, 특정 분류의 데이터 객체(Data Object)를 처리하고, 엔드포인트(Endpoint)를 통해 노출되며, WAF 정책 뒤에 있고, 대시보드(Dashboard)가 지켜봅니다. 이런 의미에서 애플리케이션이란, EA 리포지토리의 레코드 하나, 코드 리포지토리 세 개, 네임스페이스 두 개, IT 서비스 관리의 비즈니스 서비스 하나가 알고 보니 같은 것이었을 때 얻게 되는 것입니다.
**표면(surfaces).** 모델은 웹 UI, REST API, MCP의 세 가지 방식으로 노출되고, 각각은 서로 다른 종류의 소비자를 위한 것입니다. 세 가지 모두의 뒤에는 같은 의미를 지닌 같은 엔티티가 있습니다. [컨텍스트가 곧 제품입니다](https://raskell.io/articles/context-is-the-product/)에서 주장했듯이, 이는 달이 갈수록 더 중요해집니다.
| 소비자 | 표면 | 그것으로 하는 일 |
|---|---|---|
| 모든 개발자와 엔지니어의 노트북에 있는 코딩 에이전트(로컬 Claude Code 인스턴스) | MCP | 코드를 한 줄 쓰기 전에 어떤 서비스가 API를 소유하는지, 어느 플랫폼에 배포해야 하는지, 참조 아키텍처가 무엇을 말하는지 묻습니다 |
| SDLC 안의 원격 에이전트 팩토리 | MCP | 같은 질문을, 노트북이 아니라 파이프라인에서 소프트웨어를 만들고 테스트하고 바꾸는 에이전트가 묻습니다 |
| 엔터프라이즈 아키텍트, 솔루션 아키텍트, 엔지니어 | 웹 UI | 무엇이 있는지 찾아보고, 한 도메인이 어떻게 맞물려 있는지 배우고, 설계 검토 전에 의존성을 살펴봅니다 |
| 컨텍스트를 필요로 하는 다른 시스템 | REST API | 싱크 시스템들이 컨텍스트 모델 데이터를 자기 프로세스로 가져갑니다. 포트폴리오 도구, 리스크 및 컴플라이언스 보고, 온보딩, 비용 배분 등입니다 |
첫 두 행이 이 플랫폼이 5년 뒤가 아니라 지금 존재해야 하는 이유입니다. 노트북 위의 코딩 에이전트는 모든 세션을 자기가 일하는 회사에 대해 아무것도 모르는 상태로 시작합니다. 컨텍스트 모델로 들어가는 MCP 엔드포인트를 주면, 에이전트는 어느 팀에 물어야 하는지, 다시 만드는 대신 어떤 플랫폼 서비스를 재사용해야 하는지, 자기가 막 택하려던 접근을 어떤 아키텍처 결정이 이미 배제했는지 알게 됩니다. 이것을 그룹의 모든 엔지니어와 모든 에이전트 팩토리로 곱하면, 컨텍스트 모델은 회사가 소프트웨어를 어떻게 만드는지에 관한 공유된 기억이 됩니다.
모델 위에는 분석이 놓이고, 바로 그곳에서 모델은 카탈로그이기를 멈추고 인텔리전스가 되기 시작합니다. 모델이 연결되어 있기 때문에 산출물을 만들어 낼 수 있습니다. 한 마켓 유닛의 아키텍처 분석, 겹치는 세 플랫폼을 통합하기 위한 비즈니스 케이스의 초안, 실제로 돌아가는 것에서 생성한 솔루션 아키텍처 다이어그램, 역량 커버리지에 관한 EA 뷰, 현재 상태와 선택지가 미리 채워진 아키텍처 결정 기록(ADR) 같은 것입니다. 같은 분석은 비즈니스 유스케이스도 스스로 찾아냅니다. 두 시스템이면 될 일을 다섯 시스템에 걸쳐 하는 프로세스, 네 개의 마켓 유닛에 중복된 구성 요소, 더 효율적으로(같은 결과, 더 적은 비용) 또는 더 효과적으로(더 나은 결과, 같은 비용) 만들 수 있는 솔루션 같은 것입니다. 예전에는 이런 발견을 하려면 마침 양쪽을 다 아는 누군가가 필요했습니다. 이제는 조회 하나와, 그것에 따라 행동할 의지가 있는 누군가가 필요할 뿐입니다.
## 왜 온톨로지가 어려운 부분인가 {#why-the-ontology-is-the-hard-part}
수집은 배관 공사입니다. 표면은 UI 하나와 API 두 개입니다. 진짜 결정은 컨텍스트 모델에 있고, 제가 가장 많이 생각을 바꾼 곳도 거기입니다.
엔티티 모델의 최소한의 단면은 대략 다음과 같습니다. 실제 스키마가 아니라 예시입니다.
```yaml
# context-model/entities.yaml (illustrative)
Application:
identity: [ea_repository.application_id]
derived_from: [ea_repository.application, itsm.business_service]
relations:
realised_by: Repository # many
deployed_as: Workload # many
owned_by: Team # one, accountable
supports: Capability # many
processes: DataObject # many, with classification
exposed_via: Endpoint # many
Repository:
identity: [source_code.repository_path]
relations:
belongs_to: Application # inferred, carries confidence
```
예상보다 중요한 것으로 드러난 세 가지가 있습니다.
**아이덴티티 해석이 일의 대부분입니다.** 같은 애플리케이션이 시스템마다 다른 이름을 가지고 있고, 때로는 이름이 아예 없습니다. 두 레코드가 언제 같은 엔티티인지 판단하는 것이 핵심 문제입니다. 결정론적 키가 그 일부를 해결합니다(EA 리포지토리의 애플리케이션 ID를 담고 있는 배포 레이블은 선물과 같습니다). 나머지는 추론이고, 추론은 눈에 보여야 합니다.
**모든 엣지는 출처와 신뢰도를 지닙니다.** API의 외래 키에서 나온 엣지는 모델이 README를 보고 제안한 엣지와 다른 종류의 사실입니다. 둘 다 쓸모가 있습니다. 둘을 똑같이 취급하는 것이야말로 아무도 믿지 않는 아름다운 그래프를 만드는 방법입니다. 각 관계는 그것이 어디서 왔는지, 마지막으로 언제 관찰되었는지, 그리고 그것이 단언된(asserted) 것인지, 도출된(derived) 것인지, 추론된(inferred) 것인지를 기록합니다. 저는 컨텍스트 웨어하우스에 대해서도 같은 주장을 했고, 그래프가 사람들이 그에 따라 행동하는 산출물을 만들어 내기 시작하면 이 주장은 더욱 강하게 성립합니다.
**모델은 의견을 가져야 하고, 그 의견은 엔터프라이즈 아키텍처의 것이어야 합니다.** 엔티티 유형, 관계 유형, 역량 맵는 중립적이지 않습니다. 기업 전략과 EA의 역량이 플랫폼에 들어오는 곳이 바로 거기입니다. 컨텍스트 모델이 EA가 쓰는 것과 같은 역량 분류 체계를 쓴다면, “모든 마켓 유닛에서 역량 X를 지원하는 시스템은 무엇인가”는 프로젝트가 아니라 조회가 됩니다. 그것이 제 이전 역할에서의 조화 문제가 데이터 문제로 바뀐 모습입니다. 이에 대해서는 에이전트가 읽을 수 있는 분류 체계에 더 적었습니다.
## 1차 소스와 2차 소스 {#primary-and-secondary-sources}
컨텍스트 모델 안의 모든 데이터가 같은 지위를 가지는 것은 아니며, 모델은 그것을 명시적으로 밝힙니다.
대부분은 **2차 소스**로 시작합니다. 그 데이터에 대해 권위를 가진 시스템에서 수집한 사본입니다. 네임스페이스 안에서 무엇이 돌아가는지에 대해서는 컨테이너 플랫폼이 권위를 가집니다. 리포지토리에 누가 접근할 수 있는지에 대해서는 소스 코드 플랫폼이 권위를 가집니다. 컨텍스트 모델은 그 사실들을 비추고, 점수를 매기고, 연결하지만, 소스와 의견이 다르면 소스가 이기고 수정은 소스로 갑니다.
일부는 **1차 소스**입니다. 컨텍스트 모델이 그 데이터에 대해 권위를 가진 곳입니다. 처음에 이것은 대부분 다른 어떤 시스템도 지니지 않은 것, 곧 엔티티 사이의 확인된 연결입니다. 이 세 리포지토리, 이 두 네임스페이스, 그리고 저 비즈니스 서비스가 하나의 애플리케이션이라는 것을 기록하는 곳은 그 밖에 없습니다. 팀이 그것을 확인하고 나면 그 사실은 컨텍스트 모델에만 있고 다른 어디에도 없습니다.
시간이 지나면서 더 많은 데이터가 2차에서 1차로 옮겨 갑니다. 어떤 데이터 세트가 큐레이션되고, 높은 점수를 받고, 모델을 통해 어디서나 쓰이는데, 원래 도구는 그것을 관리할 두 번째 장소라는 것 말고는 아무것도 더하지 않는다면, 합리적인 일은 컨텍스트 모델을 그 데이터의 권위 있는 원천으로 선언하고 사본을 은퇴시키는 것입니다.
*How a data set changes standing*
```text
┌──────────────────────────┐
│ ingested from a source │ secondary: the source wins
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ scored and connected │
│ in the model │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ curated by its owner, │
│ used through the model │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ declared primary in │ an explicit decision, with
│ the Context Model │ an owner and a date
└──────────────────────────┘
```
이 이동은 언제나 데이터 세트마다 소유자와 날짜를 붙여 내리는 명시적인 결정이며, 그래서 모두가 사실을 어디서 고쳐야 하는지 압니다.
## 기본은 개방 {#open-by-default}
제가 가장 굳게 지키는 전제는 **엔터프라이즈 IT 컨텍스트는 민감하지 않다**는 것입니다. 어떤 애플리케이션이 존재하는지, 누가 소유하는지, 어떤 역량을 지원하는지, 어떤 플랫폼에서 돌아가는지, 어떻게 연결되는지. 이 모든 것은 회사의 누구에게나, 그리고 그들을 대신해 일하는 어떤 에이전트에게나 접근 가능해야 합니다.
여기서 IT 컨텍스트란 시스템 안의 데이터가 아니라 시스템에 관한 메타데이터를 뜻합니다. 고객 기록, 자격 증명, 시크릿은 IT 컨텍스트가 아니며 모델에 결코 들어가지 않습니다. 지형을 기술하는 모든 것은 들어갑니다.
이 논지는 누가 전체를 생각할 수 있느냐에 관한 것입니다. 컨텍스트가 제한되어 있으면 모든 사일로에 접근할 수 있는 소수만 전체를 볼 수 있고, 그들은 경계를 넘는 모든 결정의 병목이 됩니다. 컨텍스트가 열려 있으면, 한 마켓 유닛의 엔지니어가 자기가 막 만들려던 플랫폼 서비스가 다른 유닛에 이미 있다는 것을 알아챌 수 있습니다. 솔루션 아키텍트는 검토 전에 설계의 2차 효과를 볼 수 있습니다. 코딩 에이전트는 중복하는 대신 재사용할 수 있습니다. IT 컨텍스트를 민주화하는 것은, 모든 것을 볼 수 있는 소수를 기다리는 대신, 더 많은 사람과 더 많은 에이전트가 가장 큰 가치를 만드는 결정에 기여하게 하는 방법입니다.
## 열린 곳에서 만들고, 기여로 개선합니다 {#built-in-the-open-improved-by-contribution}
이 플랫폼은 전적으로 오픈 소스 기술 위에 지어집니다. 그 중심에는 어떤 벤더 제품도 없습니다. 이것은 의도적인 선택이었고, 비용 때문만은 아니었습니다.
회사 전체에 자기가 그린 지형의 그림을 믿어 달라고 요청하는 플랫폼은 그 그림이 어떻게 만들어지는지에 대해 투명해야 합니다. 모든 커넥터, 모든 점수 규칙, 모든 엔티티 유형, 모든 추론 프롬프트는 들여다보려는 누구든 읽고 이해할 수 있습니다. 누군가 왜 모델이 어떤 애플리케이션을 자기 팀의 것이라고 말하는지 물으면, 답은 블랙박스가 아니라 그가 따라갈 수 있는 소스와 규칙의 사슬입니다.
같은 개방성이 기여를 가능하게 합니다. 팀들은 자기 시스템을 위한 커넥터를 추가하고, 엔티티 유형을 제안하고, 매핑을 고치고, 자기 데이터 세트를 큐레이션할 수 있습니다. 그리고 그렇게 할 이유도 있습니다. 정확하고, 큐레이션되어 있고, 컨텍스트 모델 안에서 의미 있게 연결된 데이터 세트는 그룹의 모든 아키텍트, 모든 엔지니어, 모든 에이전트가 씁니다. 점수가 높고, 읽히며, 결국 권위 있는 원천으로 선언될 수도 있습니다. 낡은 데이터 세트는 점수가 낮고, 모두가 그것도 볼 수 있습니다. 인센티브는 모델 안에 들어 있습니다. 팀이 자기 데이터에 더 많은 정성을 들일수록 그 데이터는 그들 자신에게도, 다른 모두에게도 더 가치 있어집니다. 이 아이디어는 Zhamak Dehghani(자막 데가니)가 데이터 메시에서 *제품으로서의 데이터*(data as a product)라고 묘사한 것에 가깝습니다. 데이터를 아는 도메인이 그것을 소유하고, 큐레이션하고, 명시적인 품질 보증과 함께 다른 이들에게 제공한다는 것입니다. 컨텍스트 모델은 같은 원칙을 IT에 관한 메타데이터에 적용하며, 스코어카드가 그 품질 보증 역할을 합니다.
## 아키텍트에게 달라지는 것 {#what-it-changes-for-an-architect}
차이는 값싸지는 질문들에서 드러납니다.
| 질문 | 이전 | 컨텍스트 모델과 함께 |
|---|---|---|
| 마켓 유닛 X의 어떤 애플리케이션이 언어 모델을 쓰는가? | 설문, 2주 | 조회 하나, 그리고 확인이 필요한 낮은 신뢰도의 매칭 목록 |
| 네임스페이스 `claims-prod-07`은 누가 소유하는가? | 여기저기 물어본다 | 워크로드, 리포지토리, 애플리케이션을 거쳐 찾은 소유 팀 |
| 우리 AI 솔루션은 그룹 참조 아키텍처를 따르는가? | 설계를 하나하나 검토한다 | 실제 토폴로지를 마켓 유닛별로 참조 아키텍처와 비교한다 |
| 이 세 통합 플랫폼을 하나로 합치면 무엇이 영향을 받는가? | 워크숍 | 의존성 하위 그래프. 다이어그램과 비즈니스 케이스 초안으로 |
| 이 ADR은 아직 유효한가? | 아무도 모른다 | ADR의 가정을 현재 모델에 비추어 확인한다 |
이 답 가운데 완벽한 것은 없습니다. 하지만 모두 빈 페이지와 회의 초대보다는 나은 출발점입니다. 아키텍트의 일은 현재 상태를 모으는 것에서 그것을 판단하는 것으로 옮겨 가며, 이는 제가 아키텍트가 지금 하는 일에서 설명한 변화입니다.
## 컨텍스트에서 일로 {#from-context-to-work}
위의 표는 아키텍트의 관점이고, 이 플랫폼을 과소평가합니다. 아키텍트는 공백을 가장 먼저 알아채는 사용자일 뿐, 가장 큰 혜택을 받는 사용자는 아닙니다.
IT 부서의 일 대부분은 일상적인 일입니다. 무언가를 찾아보고, 시스템 사이를 번역하고, 팀 사이를 조율하고, 알려진 패턴을 따르는 변경을 수행하는 일입니다. 이것은 누가 소유하는지, 어디서 돌아가는지, 무엇이 여기에 의존하는지, 어떤 규칙이 적용되는지, 어떤 양식을 채워야 하는지, 누가 승인해야 하는지, 지난주에 무엇이 바뀌었는지. 오늘날 사람들이 그 일을 하는 이유는 그 일에 필요한 컨텍스트가 십여 개의 도구와 수백 명의 머릿속에 흩어져 있기 때문입니다. 에이전트는 그 대부분을 할 수 있지만, 그 컨텍스트를 읽을 수 있을 때에만 그렇고, 컨텍스트 모델이 제공하는 것이 바로 그것입니다.
| 오늘의 역할 | 대부분 컨텍스트 검색과 일상적 변경인 일 | 에이전트가 컨텍스트 모델에서 필요로 하는 것 |
|---|---|---|
| 서비스 데스크와 운영 | 인시던트 라우팅, 소유자 찾기, 표준 변경 적용 | 소유권, 의존성, 변경 이력, 런북 |
| 플랫폼 운영자 | 프로비저닝, 노출, 인증서, DNS, WAF 예외 | 매니페스트, 정책, 모든 리소스의 현재 상태 |
| 솔루션 아키텍트와 엔터프라이즈 아키텍트 | 현재 상태 분석, 원칙에 비춘 컴플라이언스 점검, 설계와 ADR의 첫 초안 | 지형, 역량 맵, 참조 아키텍처, 과거의 결정 |
| 보안과 컴플라이언스 | 증거 수집, 통제 점검, 노출 검토 | 무엇이 노출되어 있고, 무엇을 통해, 어떤 데이터 분류와 함께인지 |
| 엔지니어와 코딩 에이전트 | 만들기 전에 올바른 서비스, API, 플랫폼, 관례 찾기 | 위의 모든 것을, MCP를 통해, 에디터 안에서 |
| 포트폴리오와 IT 관리 | 인벤토리, 비용 배분, 합리화 후보 | 애플리케이션, 소유자, 사용량, 마켓 유닛 사이의 중복 |
저는 이것이 작은 규모에서 일어나는 것을 보았습니다. 웹 딜리버리 스쿼드에서 매니페스트가 존재하고 지속형 워크플로가 그것을 읽을 수 있게 되자, 워크플로는 전담 운영자가 필요했던 운영 업무를 사실상 전부 넘겨받았습니다. 자동화는 몇 년 전부터 가능했습니다. 빠져 있던 것은 안전하게 행동할 수 있을 만큼 좋은 컨텍스트였습니다.
IT 부서 전체의 규모에서 제대로 해낸다면, 이것은 IT 조직이 필요로 하는 인원을 상당히 줄입니다. 판단을 대체해서가 아닙니다. 아키텍트가 지금 하는 일에서 주장했듯이 판단은 오히려 더 값져집니다. 그보다는 컨텍스트를 얻는 비용이 비쌌기 때문에만 존재하던 일의 큰 몫을 없애기 때문입니다. 그것이 비즈니스 케이스이고, 더 나은 아키텍처 검토보다 훨씬 큰 비즈니스 케이스입니다. 회사가 그 변화의 사람 쪽 측면을 어떻게 다루느냐는 이 플랫폼이 답하지 않는 리더십의 질문이며, 블로그 글 하나가 줄 수 있는 것보다 더 많은 정성을 받아야 마땅합니다.
## 컨텍스트는 탐색보다 쌉니다 {#context-is-cheaper-than-exploration}
비즈니스 케이스에서 사람들이 알아채는 부분은 인원입니다. 그들이 놓치는 부분은 에이전트 자신에게 일어나는 일입니다.
엔터프라이즈 컨텍스트가 없는 에이전트도 어쨌든 일을 계속합니다. 탐색을 통해서입니다. 어떤 서비스를 누가 소유하고 무엇이 그것에 의존하는지 질문을 받으면, 노트북 위의 코딩 에이전트는 리포지토리를 검색하고, README를 읽고, 배포 파일을 grep하고, 접근 권한이 있다면 클러스터를 조회하고, 위키로 이어지는 링크를 따라가고, 찾아낸 모든 것을 놓고 추론합니다. 그 단계 하나하나가 도구 호출이고, 모든 도구 결과는 컨텍스트 윈도우에 들어가며, 점점 커지는 윈도우 전체가 이어지는 매 턴마다 다시 비용으로 청구됩니다. 그러고 나면 다음 노트북의 다음 에이전트가 같은 질문을 하고 같은 탐색을 처음부터 다시 하며, 그 뒤의 모든 에이전트도 그렇게 합니다.
그 차이는 자릿수로 보면 가장 쉽게 보입니다. 아래 숫자는 측정값이 아니라 제가 예시로 추정한 값입니다.
```text
Question: "Who owns payment-gateway, and what breaks if we change its API?"
Without a Context Model With a Context Model
--------------------------- --------------------
~25 tool calls (search, read, grep, ...) 1 to 2 MCP calls
~150,000 to 250,000 input tokens ~3,000 to 6,000 input tokens
over the whole exploration one entity and its subgraph
answer: plausible, unverified answer: sourced, scored, current
repeated by every agent that asks computed once, read by everyone
1,000 engineers x 20 such questions a day x ~200,000 tokens
= ~4 billion tokens a day spent rediscovering the same facts
```
토큰은 반올림 오차가 아닙니다. [추론의 경제학](https://raskell.io/articles/the-economics-of-inference/)에서 주장했듯이, 토큰은 소프트웨어 라이선스보다 전기에 가깝게 움직이는 계량 자원이고, 수천 명에게 에이전트를 배포하는 기업은 그것을 청구서에서 느끼게 될 것입니다. 컨텍스트 모델은 반복되는 탐색을 조회로 바꿉니다. 수집 계층이 비싼 일을 한 번 하고, 점수를 매기고, 최신 상태로 유지하며, 그 뒤의 모든 에이전트는 그 결과를 읽습니다. 캐시나 구체화된 뷰(materialised view)와 같은 수를, 회사가 자기 자신에 대해 아는 것에 적용한 것입니다.
두 번째 효과는 품질입니다. 컨텍스트 윈도우는 유한하고, 탐색에 쓰인 토큰은 실제 과제에 쓰이지 못한 토큰입니다. 깨끗하고 출처가 달린 하위 그래프에서 출발하는 에이전트는 검색에 우연히 걸린 것이 아니라 올바른 사실을 놓고 추론합니다. 또한 컨텍스트 없는 에이전트의 전형적인 실수도 멈춥니다. 이미 있는 서비스를 만들고, 회사가 은퇴시키고 있는 플랫폼을 고르고, 본 적 없는 아키텍처 결정에 어긋나는 실수입니다. 회사에 중요한 의미에서, 에이전트는 어떤 모델 위에서 돌아가든 회사가 이미 아는 것에서 출발함으로써 더 똑똑해집니다. 저는 리포지토리 하나에 대해 [컨텍스트가 곧 제품입니다](https://raskell.io/articles/context-is-the-product/)와 [검색은 계층이 아니라 도구입니다](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/)에서 같은 주장을 했습니다. 컨텍스트 모델은 그 주장의 엔터프라이즈 규모 판본입니다.
세 번째 효과는 제가 과소평가했던 것입니다. 커뮤니케이션이 더 명확해집니다. 오늘날 두 팀 사이에서 “결제 게이트웨이”에 관한 대화는 세 가지 다른 것에 관한 대화일 수 있고, 변경이 엉뚱한 것을 망가뜨리기 전까지 아무도 알아채지 못합니다. 컨텍스트 모델이 있으면 엔티티가 정의되는 곳이 하나, 각 엔티티의 식별자가 하나, 그리고 모두가 쓰는 어휘인 온톨로지가 하나 있습니다.
| 사이 | 이전 | 공유된 컨텍스트 모델과 함께 |
|---|---|---|
| 사람과 사람 | 같은 시스템에 대한 서로 다른 이름, 지형에 대한 서로 다른 그림 | 엔티티 하나, 식별자 하나, 가리킬 페이지 하나 |
| 에이전트와 사람 | 에이전트의 답은 그럴듯하지만 추적할 수 없다 | 답이 엔티티를 인용하고, 각 엔티티는 자기 2차 소스를 인용한다 |
| 에이전트와 에이전트 | 각 에이전트가 따로 탐색하고 산문으로 넘겨준다 | 에이전트들이 양쪽 모두 해석할 수 있는 엔티티 참조를 넘겨준다 |
이 가운데 어느 것도 원래의 소스를 가리지 않습니다. 컨텍스트 모델이 돌려주는 모든 사실은 자기 출처를 지니고 있습니다. 어떤 기록 시스템에서 왔는지, 마지막으로 언제 관찰되었는지, 그 소스가 어떤 점수를 받았는지입니다. 온톨로지는 공통 언어이고, 기록 시스템은 확인하고 싶은 누구에게나, 사람이든 에이전트든, 클릭 한 번 거리에 남아 있습니다.
## 새로운 추상화 수준 {#a-new-level-of-abstraction}
한 걸음 물러서 보면, 이것은 IT에서 익숙한 이야기입니다. 모든 큰 진보는 사람들이 문제를 푸는 수준을 옮겨 놓았습니다. 어셈블러 덕분에 프로그래머는 기계어를 쓰지 않아도 되었습니다. C 덕분에 레지스터로 생각하지 않아도 되었습니다. 객체 지향 언어와 관리형 언어 덕분에 메모리 관리를 그만두고 도메인을 모델링하기 시작했습니다. 프레임워크, 클라우드 플랫폼, 코드형 인프라는 배관의 계층 전체를 걷어 냈습니다. 매번 일은 사라지지 않고 위로 올라갔고, 그 일을 하던 사람들은 더 큰 문제를 풀기 시작했습니다.
코딩 에이전트는 다음 걸음이고, 더 큰 걸음입니다. 2025년 11월에 나온 Claude Opus 4.5 즈음의 모델 세대 이후로, Claude Code 같은 에이전트는 점점 더 많은 팀에서 코드의 대부분을 쓰고 있습니다. [요즘 제가 일하는 방식](https://raskell.io/articles/how-i-work-these-days/)에서 설명했듯이 제 팀도 그렇습니다. 이제 기술직 종사자가 주로 만들어 내는 것은 의도, 제약, 설계, 판단이고, 코드는 점점 줄어듭니다. 저는 [소스 코드는 새로운 어셈블리입니다](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/)에서, 어셈블리가 그랬던 것처럼 코드가 로어링(lowering)의 대상이 되어 가고 있다고 주장했습니다.
그것이 일을 바꿉니다. 에이전트와 함께 일하는 엔지니어는 솔루션 아키텍트나 요구 사항 엔지니어나 비즈니스 분석가처럼 시간을 씁니다. 문제를 이해하고, 무엇을 만들어야 할지 결정하고, 에이전트가 만들 수 있을 만큼 잘 명세하고, 결과가 회복력 있고 확장 가능하며 올바른지 판단합니다. 기술적 배경은 여전히 필수적입니다. 그것이 판단을 가능하게 하기 때문입니다. 하지만 그들이 일하는 수준은 계층 하나만큼 통째로 위로 올라갔습니다.
그 수준에서 가장 중요한 입력은 컨텍스트입니다. 아키텍트처럼 일하는 엔지니어는 지형을 알아야 하고, 그가 명세한 것을 만드는 에이전트도 그것을 알아야 합니다. 그래서 저는 IT 인텔리전스와 새로운 추상화가 함께 간다고 생각합니다. 컨텍스트 모델은 더 높은 수준에서 일하는 것을 안전하게 만드는 것입니다. 사람과 에이전트 모두가 그것에 맞춰 설계하는, 공유되고 최신이며 출처가 달린 그림이기 때문입니다.
## 조직이 다음 병목입니다 {#the-organisation-is-the-next-bottleneck}
엔지니어가 아키텍트와 분석가처럼 일하고 에이전트가 구현의 대부분을 수행한다면, 예전에는 서로 다른 역할과 조직도의 서로 다른 칸에 있던 역량들이 같은 사람들에게 모이기 시작합니다. 엔지니어링, 아키텍처, 요구 사항, 분석이 수렴합니다. 그리고 그것들은 관리와 의사 결정과도 경쟁하기 시작합니다. IT 조직에서 중간 관리자가 하는 일의 상당 부분은 조율입니다. 누가 무엇을 아는지 알아내고, 팀 사이를 번역하고, 일의 순서를 정하고, 상태를 보고하는 일입니다. 컨텍스트 모델과 에이전트 무리는 바로 그런 일을 많이 합니다. 에이전트를 거느린 작은 팀이 문제를 이해하고, 해법을 설계하고, 만들고, 운영할 수 있게 되면, 희소한 구현 역량을 둘러싸고 큰 팀을 조율하기 위해 존재하던 계층들은 존재 이유의 상당 부분을 잃습니다.
대부분의 엔터프라이즈 IT 조직은 그 희소성을 중심으로 설계되었습니다. 만드는 일은 느리고 비쌌기 때문에, 조직은 그것을 배급하는 구조를 키웠습니다. 수요 관리, 프로젝트 포트폴리오, 연간 예산 주기, 아키텍처 검토를 위한 긴 대기열, 요구 사항과 설계와 구축과 운영을 위한 별도의 팀들입니다. 콘웨이의 법칙은 여기서 양방향으로 작용합니다. 그 구조들이 이 글 첫머리에서 묘사한 파편화된 지형을 만들어 냈고, 바뀌지 않는다면 앞으로도 에이전트의 속도로 그것을 계속 만들어 낼 것입니다.
만드는 일이 빠르고 싸지면 병목은 옮겨 갑니다. 무엇을 만들지 결정하는 일로, 그리고 만들어진 것을 비즈니스가 흡수하는 일로 옮겨 갑니다. 돈을 버는 사업 부문들, 곧 IT가 전달하는 모든 것의 기능적 소비자들은 이제 따라와야 합니다. 필요를 충분히 정확하게 표현하고, 더 빨리 결정하고, 새 솔루션이 도착하면 자기 프로세스를 바꾸고, IT를 기다리는 대기열로 여기기를 그만두어야 합니다. 예전에는 몇 분기가 걸리던 것을 몇 주 만에 전달할 수 있는 IT 부서의 가치는 그것을 활용하는 비즈니스의 능력만큼일 뿐입니다.
올바른 조직의 형태가 무엇인지 저는 아직 모릅니다. 그 성질 가운데 몇 가지는 꽤 확신합니다.
- **더 넓은 권한을 가진 더 작은 팀.** 각 팀이 하나의 문제를 이해에서 운영까지 소유하고, 에이전트가 구현의 대부분을 합니다.
- **비즈니스에 더 가까운 결정권.** 필요를 이해하는 사람과 이제 해법을 만들 수 있는 사람이 점점 같은 사람이 되거나 같은 테이블에 앉게 되기 때문입니다.
- **프로젝트가 아니라 제품과 성과에 따른 예산 배정.** 프로젝트는 희소한 구현 역량의 단위인데, 그 역량은 더 이상 희소한 것이 아니기 때문입니다.
- **검토 대기열이 아니라 자동화된 관문으로서의 거버넌스.** 설계 시점에 설계를 컨텍스트 모델에 비추어 점수 매기고, 정말로 사람이 필요한 것만 위로 올립니다. 임계값을 둔 설계 시점의 리스크와 아키텍처는 루프가 됩니다에서처럼입니다.
- **인프라로서의 회사에 대한 공유된 그림.** 컨텍스트 모델이 존재하는 이유가 바로 이것입니다.
이것은 정도의 변화가 아니라 종류의 변화입니다. 기술이 만들어지는 방식을 바꾸고, 이제 기술이 생산될 수 있는 속도로 그것을 흡수하려면 조직이 어떻게 만들어져야 하는지도 바꿉니다. IT 인텔리전스 없이 코딩 에이전트를 도입하는 회사는 잘못된 것을 더 빨리 만들게 될 것입니다. 둘 다 도입하되 조직을 바꾸지 않는 회사는 올바른 것을 만들고 나서 조직이 따라잡기를 기다리게 될 것입니다. 세 가지를 모두 하는 회사는 5년 뒤에 그렇지 않은 회사와 아주 다른 모습일 것입니다.
## 관련 연구, 그리고 이것이 아닌 것 {#related-work-and-what-this-is-not}
여기 있는 개별 아이디어 가운데 새로운 것은 없으며, 앞서 이루어진 작업은 인정받아야 마땅합니다.
**자동화된 EA 문서화.** TU Munich(뮌헨 공과대학교)와 University of Innsbruck(인스브루크 대학교)의 연구자들은 10년 넘게 엔터프라이즈 아키텍처 모델을 손이 아니라 자동으로 최신 상태로 유지하는 방법을 연구해 왔습니다. Farwick(파르비크)과 동료들은 2011년에 자동화된 EA 모델 유지 관리의 요구 사항을 정리했고, 2013년에는 회사 안의 어떤 정보 소스가 EA 모델을 채울 수 있는지, 그리고 그 데이터의 품질이 어떤지를 분석했습니다. 이는 위에서 설명한 수집과 점수 매기기의 문제입니다. Martin Kleehaus(마르틴 클레하우스)와 Florian Matthes(플로리안 마테스)는 이후 서비스의 런타임 계측이 EA 모델을 어떻게 최신 상태로 유지할 수 있는지 보여 주었습니다. 더 최근에는 Reitemeyer(라이테마이어)와 Fill(필)이 대규모 언어 모델과 지식 그래프가 엔터프라이즈 모델링에서 어떻게 결합되는지를 조사했습니다. 이 연구들은 컨텍스트 모델의 가장 가까운 학문적 조상이며, 이 문제가 오래된 것임을 보여 줍니다. 하지만 그 목표는 더 나은 EA 모델입니다. 여기서의 목표는 에이전트가 그 위에서 일할 수 있는 데이터 계층입니다.
**AI 컨텍스트 플랫폼.** 2026년, 업계는 같은 공백을 반대편에서 발견했습니다. 벤더들이 요약한 보고서에 따르면 Gartner는 *AI 컨텍스트 플랫폼*(AI context platforms)이라는 범주를 설명하기 시작했습니다. 의미적으로 조직된 지식을 구성하고, 관리하고, AI 에이전트에게 전달하는 소프트웨어입니다. 올해 몇몇 제품이 그 깃발 아래 출시되었습니다. TopQuadrant는 TQ Data Foundation을 명시적으로 엔터프라이즈 컨텍스트 플랫폼으로 내세웁니다. DataHub는 백 개가 넘는 데이터 시스템의 메타데이터를 그래프로 합쳐 MCP로 에이전트에게 제공하는 컨텍스트 플랫폼을 출시했습니다. Neo4j는 컨텍스트 엔진을 발표했습니다. 그리고 EA 도구 벤더인 Ardoq는 그래프 데이터베이스 GraphLake를 인수해 스스로 “엔터프라이즈 AI를 위한 EA 수준의 컨텍스트 그래프”라고 부르는 것을 만들고 있으며, 그 CEO는 엔터프라이즈 아키텍처가 “AI 스택의 나머지가 그 위에서 돌아가는 기반”이라고 선언했습니다.
저는 시장의 등장을 이 공백이 실재한다는 확인으로 받아들이며, “엔터프라이즈 컨텍스트 플랫폼”이라는 말에 손을 뻗은 사람이 저 혼자가 아니라는 것도 분명합니다. 그러나 차이는 중요하고, 그 차이가 이것을 또 하나의 EA 리포지토리나 또 하나의 데이터 카탈로그로 읽어서는 안 되는 이유입니다.
| | EA 리포지토리 | 데이터 카탈로그와 컨텍스트 제품 | 엔터프라이즈 컨텍스트 플랫폼 |
|---|---|---|---|
| 무엇을 기술하는가 | 아키텍트가 큐레이션한 애플리케이션 포트폴리오 | 분석용 데이터: 테이블, 지표, 리니지 | IT에서 일어나는 모든 것: 포트폴리오, 코드, 런타임, 노출, 운영, 결정 |
| 데이터는 어디서 오는가 | 대부분 수동 입력 | 데이터 플랫폼과 BI 도구 | 모든 기록 시스템과 모든 플랫폼, 정확도 점수와 함께 |
| 얼마나 최신인가 | 마지막 검토만큼 | 데이터 스택에 가깝게 | 소스만큼, 모든 사실에 “마지막 관찰” 시점과 함께 |
| 누구를 위한 것인가 | 아키텍트 | 분석가와 분석 에이전트 | IT의 모든 사람과 모든 에이전트, 어떤 역할이든 |
| 권위 | 리포지토리가 기록이다 | 소스를 비춘다 | 기본은 2차, 선언된 곳에서는 1차 |
| 접근 | 라이선스를 가진 사용자 | 라이선스, 대개 사용자 단위 | 기본적으로 모두에게 열림 |
| 기술 | 벤더 제품 | 벤더 제품 | 오픈 소스, 읽을 수 있고, 기여로 확장 가능 |
가장 가까운 이웃은 Backstage 같은 개발자 포털입니다. 그 소프트웨어 카탈로그는 소프트웨어 조직에 무엇이 존재하는지에 관한 하나의 모델을 줍니다. 컨텍스트 모델은 그 아이디어를 하나의 엔지니어링 조직에서 IT 부서 전체로, 그리고 카탈로그를 둘러보는 사람에서 일을 하는 에이전트로 확장한 것입니다.
## 트레이드오프와 반론 {#tradeoffs-and-objections}
**“이건 그냥 CMDB입니다.”** CMDB는 팀들에게 손으로 관리해 달라고 요청하는 기록 시스템이고, 그래서 현실에서 멀어집니다. 컨텍스트 모델은 기본적으로 도출되는 것입니다. 누가 무언가를 입력해 주기를 기대지 않습니다. 시스템들이 이미 말하고 있는 것을 읽고, 자기 의견을 소스와 분리해 둡니다. CMDB가 옳은 곳에서는 모델이 그것에 동의합니다. CMDB가 틀린 곳에서는 모델이 그 불일치를 보여 주며, 그것 자체가 쓸모 있습니다.
**“이건 커넥터가 더 많은 EA 리포지토리일 뿐입니다.”** EA 리포지토리는 포트폴리오 관점에서 매우 뛰어나며, 여기서 가장 중요한 소스 가운데 하나입니다. 하지만 그것은 아키텍트가 의도하고 큐레이션한 대로의 지형을, 1년에 몇 번, 라이선스를 가진 소수의 독자를 위해 기술합니다. 클러스터에서 무엇이 돌아가는지, WAF가 무엇을 통과시키는지, 어떤 코드 리포지토리가 실제로 애플리케이션을 구현하는지, 어젯밤 어떤 인시던트가 그것을 덮쳤는지, 어떤 변경이 진행 중인지 알지 못합니다. 컨텍스트 모델은 그 모든 것으로, 지속적으로, IT에서 일하는 모든 사람과 에이전트를 위해 만들어집니다. EA 리포지토리는 그것을 먹여 주는 소스이고, 둘은 같은 종류의 것이 아닙니다.
**“AI의 도움을 받는 수집은 환각된 아키텍처를 뜻합니다.”** 추론된 엣지가 사실로 제시된다면 그렇겠지요. 그렇지 않습니다. 추론된 관계는 자기 신뢰도와 근거를 지니고, 신뢰도가 낮은 것은 소유 팀의 확인을 기다리는 대기열에 들어가며, 확인되면 이름과 날짜가 붙은 단언된 사실이 됩니다. 이것이 없다면 저는 이 플랫폼을 믿지 않을 것이고, 다른 누구도 믿어서는 안 됩니다.
**“왜 직접 만듭니까?”** 일부는 온톨로지가 곧 제품이고, 기성품으로 산 온톨로지는 다른 누군가의 기업을 담고 있기 때문입니다. 일부는 소스들이 벤더 도구와 내부 플랫폼의 특정한 조합이어서 어떤 제품도 그것을 다 다루지 못하기 때문입니다. 일부는 사람들에게 믿고 기여해 달라고 요청하는 플랫폼은 그들이 읽을 수 있는 것이어야 하는데, 오픈 소스 스택은 그것을 허락하고 벤더 제품은 그렇지 않기 때문입니다. 그리고 일부는 누군가에게 예산을 요청하기 전에 이 아이디어가 성립하는지 알아야 했기 때문입니다. 직접 만든 플랫폼은 정직한 시험 가운데 가장 저렴한 것입니다.
**“IT 지형의 열린 지도는 공격자를 돕습니다.”** 제가 가장 자주 듣는 반론입니다. 이미 네트워크 안에 들어온 공격자는 시간만 충분하면 지형의 대부분을 파악할 수 있습니다. 오늘날 방어자와 만드는 사람들은 그러지 못하는 경우가 많습니다. 지도를 닫아 두는 것은 주로 공격자의 인내심이라는 이점을 지켜 줄 뿐입니다. 진짜 보호는 시스템 자체에, 곧 아이덴티티, 네트워크 통제, 시크릿 관리에 있어야 하며, 동료들이 무엇이 존재하는지 알기 어렵게 만드는 데 있어서는 안 됩니다. 특정 취약점이나 자격 증명처럼 하나의 세부 사항이 정말로 위험한 경우, 그것은 IT 컨텍스트가 아니며 모델에 들어가지 않습니다.
치르는 비용은 이렇습니다. 소스가 API를 바꾸면 커넥터가 깨지고, 아이덴티티 해석은 지속적인 관리가 필요하며, 접근이 진짜 제약입니다. IT 지형 전체를 보는 플랫폼은 IT 지형 전체에 대한 읽기 접근이 필요하고, 규제받는 금융 그룹에서 그것은 설정 변경이 아니라 대화입니다. 이에 대해서는 병목은 읽기 접근입니다에 썼습니다.
## 제가 경계하고 있는 실패 양상 {#failure-modes-i-am-watching-for}
- **예쁜 그래프.** 데모에서는 인상적이지만 실제 질문에는 하나도 답하지 못하는 UI. 시험은 아키텍트들이 요청받지 않고도 검토 전에 그것을 여는지입니다.
- **조용한 낡음.** 소스 커넥터가 실패하고, 모델은 지난달의 상태를 계속 보여 주며, 아무도 알아채지 못합니다. 모든 엔티티에는 “마지막 관찰” 시점이 필요하고, UI는 그것을 보여 주어야 합니다.
- **온톨로지의 무분별한 팽창.** 모든 팀이 자기만의 엔티티 유형을 원합니다. 모델은 한 사람이 화이트보드에서 설명할 수 있을 만큼 작게 유지되어야 합니다.
- **산출물에 대한 과신.** 생성된 비즈니스 케이스가 잘 읽히지만, 소유 팀만 알아챌 수 있는 방식으로 틀려 있습니다. 산출물은 답이 아니라 출처가 달린 초안입니다.
- **두 번째 그림자 리포지토리.** 사람들이 2차 데이터를 기록 시스템이 아니라 플랫폼에서 고치기 시작하면, 플랫폼은 자기가 고치려던 바로 그것이 됩니다. 2차 데이터의 수정은 소스로 돌아갑니다. 명시적으로 1차로 선언된 데이터만 컨텍스트 모델 안에서 관리됩니다.
- **예외로 깎여 나가는 개방성.** 필드 하나를 숨겨 달라고 요청하는 팀마다 그럴듯한 이유가 있습니다. 그런 요청을 충분히 들어주면 모델은 또 하나의 사일로가 됩니다. 예외에는 높은 기준과 공개된 목록이 필요합니다.
- **조작된 점수.** 점수가 지위를 띠게 되면, 누군가는 정확도가 아니라 점수를 최적화할 것입니다. 신호는 다른 소스와의 일치에 근거를 두어야 하며, 그것은 꾸며 내기 어렵습니다.
## 맺으며 {#closing}
비즈니스 인텔리전스는 회사를 경영진이 읽을 수 있게 만들었습니다. IT 인텔리전스는 회사를 그것을 만드는 모든 이들, 사람과 에이전트 모두가 읽을 수 있게 만듭니다. 그리고 소프트웨어가 만들어지는 수준이 위로 올라가면서, 회사에 대한 그 공유된 그림은 다른 모든 것이 그 위에 지어지는 토대가 됩니다. 제가 아키텍처를 위해 스케치한 루프에는 출발할 곳과 다시 내려앉을 곳이 필요하고, 컨텍스트 모델은 그 둘 모두가 되고자 합니다.
이것이 실제로 돌아가는 코드로는 어떤 모습인지 보고 싶다면, [IT Intelligence 만들기](https://raskell.io/articles/building-it-intelligence/)에서 오픈 소스 리포지토리 하나에 담긴 참조 구현을 따라가 볼 수 있습니다. 그 안에는 노트북에서 실행할 수 있는 가상의 회사가 들어 있습니다.
## 참고 문헌 {#references}
지식, 암묵적인 것과 형식적인 것:
- Michael Polanyi, *The Tacit Dimension*, Doubleday, 1966; reissued by the University of Chicago Press, 2009, with a foreword by Amartya Sen.
- Ikujiro Nonaka and Hirotaka Takeuchi, *The Knowledge-Creating Company*, Oxford University Press, 1995; 두 사람의 [SECI 모델](https://en.wikipedia.org/wiki/SECI_model_of_knowledge_dimensions) 개요.
- James C. Scott, *Seeing Like a State*, Yale University Press, 1998, 메티스에 관한 9장.
- Daniel M. Wegner, "Transactive Memory: A Contemporary Analysis of the Group Mind", in B. Mullen and G. R. Goethals (eds.), *Theories of Group Behavior*, Springer, 1987; Wegner 자신이 쓴 [교류 기억 요약](https://dtg.sites.fas.harvard.edu/DANWEGNER/wjh/tm.htm).
- Guilherme Avelino, Leonardo Passos, Andre Hora and Marco Tulio Valente, [A Novel Approach for Estimating Truck Factors](https://arxiv.org/abs/1604.06766), ICPC 2016.
- [Tribal knowledge](https://en.wikipedia.org/wiki/Tribal_knowledge), Wikipedia, 용어와 그 쓰임에 관하여.
사일로, 은폐, 이전:
- Thomas H. Davenport, Robert G. Eccles and Laurence Prusak, "Information Politics", *Sloan Management Review* 34(1), 1992, pp. 53 to 65.
- Catherine E. Connelly, David Zweig, Jane Webster and John P. Trougakos, [Knowledge hiding in organizations](https://doi.org/10.1002/job.737), *Journal of Organizational Behavior* 33(1), 2012, pp. 64 to 88; Queen's University의 더 짧은 [연구 요약](https://smith.queensu.ca/insight/content/research-brief-knowledge-hiding-in-organizations.php).
- Gabriel Szulanski, "Exploring Internal Stickiness: Impediments to the Transfer of Best Practice Within the Firm", *Strategic Management Journal* 17, Winter Special Issue, 1996, pp. 27 to 43.
- Morten T. Hansen, [The Search-Transfer Problem: The Role of Weak Ties in Sharing Knowledge across Organization Subunits](https://doi.org/10.2307/2667032), *Administrative Science Quarterly* 44(1), 1999, pp. 82 to 111.
- Carl G. Sieloff, ["If only HP knew what HP knows": the roots of knowledge management at Hewlett-Packard](https://doi.org/10.1108/13673279910259385), *Journal of Knowledge Management* 3(1), 1999.
- Gillian Tett, *The Silo Effect: The Peril of Expertise and the Promise of Breaking Down Barriers*, Simon and Schuster, 2015.
- Jeffrey Pfeffer and Robert I. Sutton, *The Knowing-Doing Gap*, Harvard Business School Press, 2000.
자동화된 EA 문서화:
- Farwick, Agreiter, Breu, Ryll, Voges and Hanschke, "Requirements for Automated Enterprise Architecture Model Maintenance", ICEIS 2011.
- Farwick, Breu, Hauder, Roth and Matthes, "Enterprise Architecture Documentation: Empirical Analysis of Information Sources for Automation", HICSS 2013.
- Roth, Hauder, Farwick, Breu and Matthes, "Enterprise Architecture Documentation: Current Practices and Future Directions", Wirtschaftsinformatik 2013.
- Martin Kleehaus and Florian Matthes, [Automated Enterprise Architecture Model Maintenance via Runtime IT Discovery](https://doi.org/10.1007/978-3-030-49640-1_13), in *Intelligent Systems Reference Library* 188, Springer, 2021, pp. 247 to 263.
- Reitemeyer and Fill, [Applying Large Language Models in Knowledge Graph-based Enterprise Modeling: Challenges and Opportunities](https://arxiv.org/abs/2501.03566), 2025.
AI 컨텍스트 플랫폼(2026):
- Gartner, *Market Overview for AI Context Platforms*, 13 August 2026, and *How to Navigate the Emerging AI Context Platform Market*, 1 September 2026; 저는 [초록](https://www.gartner.com/en/documents/8486545)과, [Atlan의 것](https://atlan.com/know/ai-agent/context-layer/gartner-impact-radar-ai-context-platform/) 같은 벤더 요약만 읽었습니다.
- TopQuadrant, [TopQuadrant Launches Enterprise Context Platform to Build Trusted AI](https://www.einpresswire.com/article/893232971/topquadrant-launches-enterprise-context-platform-to-build-trusted-ai), 18 February 2026.
- DataHub, [Announcing the DataHub Context Platform](https://datahub.com/?p=14496), 2026.
- Neo4j, [Neo4j Context Engine](https://neo4j.com/?p=433599), October 2026.
- Ardoq, [Ardoq Acquires GraphLake to Establish the EA-Grade Context Graph for Enterprise AI](https://www.ardoq.com/news/ardoq-graphlake-context-graph-enterprise-ai), 8 June 2026.
- [Backstage software catalog](https://backstage.io/docs/features/software-catalog), 이 아이디어의 개발자 포털 판본.
조직과 아키텍처:
- Melvin E. Conway, [How Do Committees Invent?](http://www.melconway.com/Home/Committees_Paper.html), *Datamation* 14(4), 1968, pp. 28 to 31.
- Matthew Skelton and Manuel Pais, *Team Topologies*, IT Revolution, 2019.
- Zhamak Dehghani, [Data Mesh](https://www.thoughtworks.com/insights/books/data-mesh), O'Reilly, 2022.
- Jeanne W. Ross, Peter Weill and David C. Robertson, *Enterprise Architecture as Strategy*, Harvard Business School Press, 2006.
- Michael Nygard, [Documenting Architecture Decisions](https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions), ADR의 기원.
콘퍼런스:
- [RSAC Conference](https://www.rsaconference.com/About/FAQ), San Francisco.
- Raffael Schneider and Milan Duric, [Self-Learning WAF: Using Generative AI to Tame ModSecurity False Positives](https://path.rsaconference.com/flow/rsac/us26/FullAgenda/page/catalog/session/1753946922633001YdMq), RSAC 2026, session NCS-W01.
기술:
- Anthropic, [Introducing Claude Opus 4.5](https://www.anthropic.com/news/claude-opus-4-5), November 2025.
- [Model Context Protocol](https://modelcontextprotocol.io/), 에이전트 엔드포인트 뒤에 있는 프로토콜.
================================================================================
---
title: "최초의 데이터 기업"
url: https://raskell.io/ko/articles/the-original-data-company/
author: Raffael Schneider
date: 2026-11-01
description: "보험사는 자신들이 기술 기업이 아니라고 말합니다. 그러나 보험사는 약속으로 감싼 예측을 팔며, 1693년의 생명표 이래로 줄곧 그래 왔습니다. 최초의 데이터 기업입니다."
tags: [insurance, finance, cryptocurrency, trust, machine-learning, history-of-technology, determinism, fractals, money, probability, surveillance, mortality]
lang: ko
translation_of: https://raskell.io/articles/the-original-data-company/
---
# 최초의 데이터 기업
## 요약
자신들이 기술 기업이 아니라고 말하는 보험사와 은행은 자기 상품을 오해하고 있습니다. 보험사는 어쩌다 대차대조표를 가진 기술 기업이며, 현존하는 가장 오래된 데이터 기업입니다. 돈, 보험 증권, 계좌는 신뢰에 대한 추상적인 기록입니다. 저는 기술을 신뢰를 절차로 형식화하는 일, 즉 매번 같은 방식으로 일어나고 검증할 수 있는 무언가로 만드는 일로 정의합니다. Halley의 1693년 생명표에는 이미 보험의 구조 전체가 담겨 있었습니다. 수집된 데이터셋, 그것에 맞춘 모델, 그 모델에서 도출한 가격입니다. 언더라이팅, 가격 산정, 준비금 적립, 자본 모델링은 모두 예측입니다. 위험을 규정하는 데이터는 자동차, 휴대전화, 웨어러블, 건물 안으로 옮겨 가고 있습니다. 그러니 도로를 보는 쪽이 위험에 가장 좋은 가격을 매길 수 있고, 에이전트는 보험사가 이미 살고 있는 상징의 세계에 꼭 들어맞습니다. 자본, 플로트, 규제는 약속을 믿을 만하게 만들지만 누가 이길지를 정하지는 않습니다. 그러므로 보험사는 자신의 모델과 데이터를 소유하고, 절차를 코드처럼 다루며, 에이전트가 탐색하게 하되 효과가 있는 것은 남겨 두어야 합니다.
“우리는 기술 기업이 아닙니다.” 저는 이 문장을 제가 일하는 보험사의 회의에서 들었습니다. 이 보험사는 최근의 합병 이후 은행이기도 합니다. 그 전에는 제가 일했던 은행에서도 들었습니다. 똑똑하고 경험 많은 사람들이 이 말을 했고, 대개는 무언가의 이유로 꺼낸 말이었습니다. 플랫폼을 사내에서 만들 필요가 없는 이유, 엔지니어링이 억제해야 할 비용인 이유, 흥미로운 일은 다른 곳에서 일어나는 이유로 말입니다. 그럴 때마다 저는 당혹스럽습니다. 저는 그 반대가 사실이라고 생각하기 때문입니다. 보험사는 어쩌다 기술을 사용하는 금융 회사가 아닙니다. 어쩌다 대차대조표를 가진 기술 회사이며, 정확한 의미에서 현존하는 가장 오래된 데이터 기업입니다.
이 글은 그 주장을 펼치는 글입니다. 은행과 보험사는 한결같음을 판다는 관찰로 끝맺었던 [강과 운하](https://raskell.io/articles/the-river-and-the-canal/), 그리고 왜 신뢰는 한결같음으로 얻어지는가에 관한 노트 위에 서 있습니다. 화폐 정치에 관한 글은 아닙니다. 다만 돈에서 시작하는데, 추상화가 시작되는 곳이 바로 돈이기 때문입니다.
## 추상적인 사업 {#abstract-businesses}
보험 증권은 만질 수 없습니다. 은행 계좌도, 연금도, 펀드의 지분도 만질 수 없습니다. 이 사업들이 파는 것은 추상적입니다. 특정한 조건이 충족되면 무언가가 특정한 방식으로 일어나리라는 약속입니다. 경제의 큰 부분, 경제학자들이 서비스 부문이라 부르는 것의 대부분이 이렇게 작동합니다. 밖에서 보기에 서로 닮아 보이지 않더라도 그렇습니다. 은행, 보험사, 브로커, 결제 대행사, 토지 등기소는 상품은 다르지만 실체는 같습니다. 이들은 지켜지는 약속을 팝니다.
돈 그 자체가 가장 깊은 예입니다. 교과서의 이야기는 사람들이 물물교환을 하다가 누군가 주화를 발명했고, 신용은 그 뒤에 왔다고 말합니다. David Graeber의 [『부채, 그 첫 5,000년』](https://en.wikipedia.org/wiki/Debt:_The_First_5000_Years)은 그 이야기를 해체합니다. “사실 화폐의 역사에 대한 우리의 표준적인 설명은 정확히 거꾸로 되어 있다. 우리는 물물교환에서 시작해 돈을 발견하고, 그다음에 마침내 신용 체계를 발전시킨 것이 아니다. 일은 정확히 그 반대로 일어났다. 오늘날 우리가 가상 화폐라 부르는 것이 먼저 왔다.” 누가 누구에게 무엇을 빚졌는지 기록하는 방식인 신용 체계는, 대략 기원전 600년에서 500년 사이에 주화가 등장하기 수천 년 전에 이미 메소포타미아에서 기록으로 확인됩니다. 이렇게 읽으면 돈은 신뢰의 기록으로 시작했고, 지금도 여전히 그렇습니다. 통화는 사람들이 그것이 가치 있다고 믿는 만큼 가치가 있습니다. 그래서 돈을 가리키는 더 정확한 말은 오래된 말, 곧 신용(credit)입니다. 믿는다는 뜻의 라틴어 *credere*에서 온 말입니다.
오늘날 그 기록이 어떻게 만들어지는지는 들리는 것만큼 신비롭지 않고, 대부분의 사람들이 생각하는 것만큼 공개적이지도 않습니다. 2014년 영란은행은 분기 회보(Quarterly Bulletin)에 짧은 글 [“Money creation in the modern economy”](https://www.bankofengland.co.uk/quarterly-bulletin/2014/q1/money-creation-in-the-modern-economy)(현대 경제에서의 화폐 창출)를 실었습니다. 현대 경제에서 돈의 대부분은 은행 예금의 형태를 띠며, 그 예금이 만들어지는 주된 방식은 시중 은행의 대출이라는 설명이었습니다. 스위스의 경제학자 [Mathias Binswanger](https://www.fhnw.ch/de/personen/mathias-binswanger)는 그 결과를 다룬 책 한 권을 썼습니다. *Geld aus dem Nichts*(무에서 나온 돈, 2015)입니다. 시중 은행이 어떻게 돈을 만드는지 다루는 첫 장은 모든 것을 말해 주는 제목 아래에서 시작합니다. “금융 중개자로서의 은행이라는 잘못된 관념”(*"Die falsche Vorstellung von Banken als Finanzintermediäre"*)입니다. 저널리스트 Paul Schreyer는 *Wer regiert das Geld?*(누가 돈을 다스리는가?, 2016)에서 이 주장을 더 밀고 나갑니다.
> 한 사회의 모든 결정권과 주권은 두 가지 단순한 질문으로 귀결된다. 누가 돈을 만들어도 되는가? 그리고 누가 그 쓰임을 결정하는가?
>
> *Alle Entscheidungsgewalt und Souveränität einer Gesellschaft läuft auf zwei simple Fragen hinaus: Wer darf das Geld erschaffen? Und wer entscheidet über seine Verwendung?*
이것이 국가와 민주주의에 무엇을 뜻하는지를 두고 크고 뜨거운 논쟁이 있습니다. 저는 그 논쟁이 중요하다고 생각하지만, 여기서의 주제는 아닙니다. 제게 필요한 요점은 더 단순합니다. 금융 산업의 가장 기본적인 상품조차 추상화이며, 세심하게 유지되는 신뢰의 기록이라는 점입니다.
## 이 사업들은 무엇을 위해 있는가 {#what-these-businesses-are-for}
은행과 보험사에게 임무를 정해 준 사람은 아무도 없지만, 그들은 하나의 임무를 수행하고 있습니다. 모든 사회는 두 가지 질문에 거듭해서 답해야 하고, 제도 없이 그 질문에 답해 본 적이 한 번도 없습니다. 자원은 어디로 가야 하는가? 그리고 아무도 내다볼 수 없었던 일이 잘못되었을 때 그 비용은 누가 지는가? 경제학자들은 이 두 기능에 이름을 붙여 두었습니다. 첫째는 **자본 배분**, 또는 금융 중개입니다. 가능한 모든 미래 가운데 어느 것에 자금을 댈지 정하는 일입니다. 둘째는 **위험 결합**(risk pooling), 또는 상호화입니다. 소수에게 닥치는 불운의 비용을, 그 불운을 당할 수도 있었던 다수에게 나누는 일입니다. 은행은 첫째를, 보험사는 둘째를 합니다. 둘 다 우리가 인류라 부르는 집단이 설계한 것처럼 보이고, 어떤 의미에서는 실제로 그렇습니다. 수 세기에 걸쳐, 천천히, 시행착오를 통해서 말입니다.
첫째 기능을 누구보다 분명하게 본 사람은 Joseph Schumpeter였습니다. 『경제 발전의 이론』에서 그는 은행가를 다른 사람의 저축을 넘겨주는 중간 상인이 아니라, 어떤 새로운 사업이 애초에 일어날지를 정하는 사람으로 묘사합니다. “그는 새로운 결합의 수행을 가능하게 하고, 말하자면 사회의 이름으로 사람들에게 그것을 형성할 권한을 준다. 그는 교환 경제의 에포로스다.” 에포로스는 고대 스파르타의 행정관이었습니다. Schumpeter의 요점은, 누구에게 돈을 빌려줄지 정함으로써 은행이 사회를 대신해 무엇이 지어지고 문명이 어떻게 자랄지를 정한다는 것입니다.
둘째 기능도 그만큼 오래되었고 그만큼 사회적입니다. 보험사가 생기기 전에는 구성원 한 사람의 집이 불탔을 때 그 손실을 떠안는 가족과 씨족이 있었고, 병든 조합원을 부양하는 길드가 있었으며, 화재와 홍수에 대비한 공동 기금을 둔 마을이 있었습니다. Taleb은 『스킨 인 더 게임』에서 그런 종류의 내집단 보호를 일종의 자가 보험이라 부릅니다. “제한된 수의 사람들에게만 작동할 수 있고 보편화될 수 없는 것”입니다. 보험사는 그것이 보편화되었을 때 얻는 것입니다. 같은 일을 낯선 사람들과, 대규모로, 계약 아래에서 하는 것입니다. 모두가 조금씩 내서 아무도 전부를 내지 않아도 되게 합니다. 사회 보험은 그 일을 국가를 통해 합니다. 그 모든 것 아래에 놓인 원리는 같습니다. 계산할 수 있게 된 일종의 연대입니다.
두 기능 모두 프랙털이며, [모든 것은 프랙털입니다](https://raskell.io/notes/everything-is-a-fractal/)를 읽은 분이라면 이제 놀라지 않으실 것입니다. 한 사람은 자신의 시간과 주의와 돈을 어디에 둘지 정합니다. 한 가족은 어느 아이가 어느 학교에 갈지, 누가 농장을 이어받을지 정합니다. 한 부족은 누가 사냥을 나가고 누가 남을지 정합니다. 회사는 어느 상품에 자금을 댈지, 은행은 어느 회사에, 사회는 어느 산업에 댈지 정합니다. 모든 규모에서 같은 행위입니다. 한정된 자원으로 미래에 내기를 걸고, 실패한 내기의 손실을 나누는 일입니다.
그리고 모든 규모에서 그 내기에는 반대편에 서려는 누군가가 필요합니다. 크리스토퍼 콜럼버스가 유럽의 누구도 그 건너편을 지도에 그릴 수 없던 대양을 건너 서쪽으로 항해하려 했을 때, 그는 여러 해 동안 후원자를 찾아다녔습니다. 마침내 카스티야 왕실이 동의했는데, 자금의 상당 부분을 마련한 왕실 재정관 [Luis de Santángel](https://en.wikipedia.org/wiki/Luis_de_Sant%C3%A1ngel)이 왕실을 설득하고 도왔습니다. 그것이 가장 순수한 형태의 Knight식 불확실성입니다. 비슷한 항해를 모은 표도 없고, 측정할 수 있는 확률도 없으며, 판단과 잃을 각오만 있습니다. 누군가 그 내기를 받기로 선택했습니다. 새로운 사업에 대한 은행 대출은 모두 그 선택의 작은 판본입니다.
Nassim Nicholas Taleb은 일련의 책을 이 기능들의 가장자리에서 일어나는 일에 바쳤습니다. 『블랙 스완』은 “희소성, 극단적인 충격, 그리고 사후적인(사전적이지는 않은) 예측 가능성”으로 정의되는 사건들에 관한 책이며, 그곳이 바로 대출과 보험이 가장 고통스럽게 실패하는 곳입니다. Taleb은 이 산업의 한 부분에 대해서는 이례적으로 너그럽습니다. 원수보험사가 넘기는 재해 위험을 떠안는 재보험사는 그의 설명에서 “은행가들과 달리” “실제로는 훨씬 더 나빴을 수도 있었다는 것을 알 만큼 성찰적이다. 지난 20년 동안 큰 재해가 없었을 뿐이고, 그런 재해가 한 세기에 한 번만 일어나도 사업과는 작별이기 때문이다.”라고 합니다. 『스킨 인 더 게임』은 집이 무너져 집주인이 죽으면 그 집을 지은 건축업자를 처벌했던 함무라비 법전에서 시작합니다. “위험을 숨기기에 가장 좋은 곳은 ‘구석’, 곧 건축가(또는 트레이더)만이 감지할 수 있는 드문 사건에 대한 취약성을 묻어 두는 곳”이기 때문입니다. 보험에는 그 반대의 유명한 예가 있습니다. 역사의 대부분 동안 Lloyd's에서 보험 증권을 뒷받침한 개인 회원들, 이른바 네임(Names)은 자신이 가진 모든 것으로 책임을 졌습니다. 그리고 『안티프래질』은 다른 사람들의 충격을 흡수하는 것이 일인 기관에 가장 중요한 구분을 긋습니다. “회복력 있는 것은 충격에 저항하고 그대로 남는다. 안티프래질한 것은 더 나아진다.”
이 논증에서 중요한 것은 이 모든 기능에 공통된 무언가입니다. 차입자를 고르는 은행가든, 선박에 가격을 매기는 언더라이터든, 허리케인에 가격을 매기는 재보험사든, 일은 같습니다. 세계를 평가하고, 그것에 숫자를 붙이고, 누구에게 어떤 약속을 어떤 가격에 할지 정하는 것입니다. 사회는 가장 중요한 결정 가운데 두 가지를, 핵심 활동이 계산인 기관들에 위임했습니다. 그것이 이 논증의 다음 단계입니다.
## 기술이란 실제로 무엇인가 {#what-technology-actually-is}
상품이 신뢰의 기록이라면, 그것을 잘 만들어 내는 데에는 무엇이 필요하겠습니까? 대체로 매번 같은 일을 하는 것이 필요합니다. 신뢰에 관한 노트에서 저는 그것의 두 절반을 설명했습니다. **일관성**, 즉 같은 입력이 시간이 지나도 같은 결과를 내는 것, 그리고 **무결성**, 즉 그것이 온전하고 스스로 주장하는 바로 그것인 것입니다. 담당 직원에 따라 지급 건을 다르게 처리하는 은행이나, 보험 증권이 서류에 적힌 것과 다른 것을 뜻하는 보험사에게는 더 이상 팔 것이 남아 있지 않습니다.
이것은 적어도 여기서 중요한 종류의 기술에 대해 제가 쓰는 정의이기도 합니다. 하드웨어를 걷어 내면 기술은 신뢰를 절차로 형식화하는 일입니다. 그렇지 않으면 믿어야만 했을 무언가를, 매번 같은 방식으로 일어나고 검증할 수 있는 무언가로 바꾸는 것입니다. 이런 의미에서 원장은 기술이고, 복식부기도, 데이터베이스 트랜잭션도, 워크플로 엔진도 기술입니다. [강과 운하](https://raskell.io/articles/the-river-and-the-canal/)에서 저는 컴퓨팅의 모든 계층이 무언가를 하나씩 더 예측 가능하게 만들어, 그 위의 사람들이 그것에 대해 더는 생각하지 않아도 되게 했다고 설명했습니다. 금융 기관은 컴퓨터가 존재하기 훨씬 전부터 종이와 사람과 절차로 그 일을 하고 있었습니다. 그리고 컴퓨터가 등장했을 때 은행과 보험사는 가장 이른 상업적 사용자에 속했습니다. 그들은 이미 컴퓨터가 하라고 있는 바로 그 사업을 하고 있었기 때문입니다.
그래서 제 주장은 추상적인 사업이 기술 기업이 되어야 한다는 것이 아니라, 언제나 기술 기업이었다는 것입니다. 그리고 “우리는 기술 기업이 아닙니다”라는 문장은 자기 상품에 대한 오해라는 것입니다. 그 모두 가운데 보험사가 가장 분명한 사례입니다.
## 비트코인, 또는 기관 없는 신뢰 {#bitcoin-or-trust-without-an-institution}
기술이 형식화된 신뢰이고 돈이 신뢰의 기록이라면, 조만간 누군가는 돈 그 자체를 밑바닥까지, 어떤 기관도 남지 않을 때까지 형식화하려 했을 것입니다. 리먼 브라더스가 무너지고 6주 뒤이자 제가 이 글을 쓰기 시작한 날로부터 정확히 18년 전인 2008년 10월 31일, 스스로를 Satoshi Nakamoto라 부르는 누군가가 암호학자들의 메일링 리스트에 [“Bitcoin P2P e-cash paper”](https://www.metzdowd.com/pipermail/cryptography/2008-October/014810.html)라는 제목의 짧은 메시지를 보냈습니다. 거기에 링크된 논문 [“Bitcoin: A Peer-to-Peer Electronic Cash System”](https://bitcoin.org/bitcoin.pdf)은 첫 문장에서 목표를 밝힙니다. “순수한 P2P 방식의 전자 현금은 온라인 결제를 금융 기관을 거치지 않고 한 당사자에게서 다른 당사자에게로 직접 보낼 수 있게 할 것이다.” 몇 단락 뒤에는 무엇을 대체하려 하는지를 이름 붙입니다. “필요한 것은 신뢰 대신 암호학적 증명에 기반한 전자 결제 시스템이다.” 2009년 1월 네트워크가 시작되었을 때, 그 첫 번째 블록에는 그날 *The Times* 1면의 한 줄이 담겨 있었습니다. “Chancellor on brink of second bailout for banks.”(재무장관, 은행에 대한 두 번째 구제금융 임박)
비트코인, 그리고 그것이 소개한 분산 원장 또는 블록체인이라는 더 넓은 아이디어가 그런 소동을 일으킨 이유가 여기에 있습니다. 그것은 추상적인 금융 기관이 하는 일의 심장을 곧장 겨냥했습니다. 은행은 누가 무엇을 빚졌는지에 대한 원장을 관리하는데, Graeber가 보여 주듯 그것은 현존하는 가장 오래된 형태의 돈입니다. 중앙은행, 그리고 영란은행이 설명하듯 시중 은행은 얼마나 많은 돈이 존재할지를 정합니다. 비트코인은 첫째를 모든 참여자가 검증할 수 있고 아무도 몰래 고쳐 쓸 수 없는 공개 원장으로, 둘째를 알고리즘으로 대체했습니다. 새 코인은 정해진 일정에 따라 나타나고, 21만 블록마다 절반으로 줄어들며, 공급량이 2,100만에 다가가면 멈춥니다. 이 글의 용어로 말하면, 그것은 제가 정의한 기술을 극단까지 밀고 간 것입니다. 신뢰가 너무도 완전히 형식화되어 신뢰받는 기관이 더는 필요 없게 된 것입니다. 또한 그것은 Schreyer의 첫 번째 질문, 즉 누가 돈을 만들어도 되는가에 대해 누군가 내놓은 가장 순수한 답입니다. 아무도 아니고, 오직 프로토콜뿐입니다.
그다음에 일어난 일도 그만큼 많은 것을 알려 줍니다. 몇 년 안에 프로토콜 주변에 거래소, 수탁 기관, 브로커의 산업이 자라났습니다. 대부분의 사람들은 자기 키를 직접 보관하거나, 자기 거래를 직접 검증하거나, 무언가 잘못되었을 때 연락할 사람이 아무도 없는 상황을 원하지 않았기 때문입니다. [강과 운하](https://raskell.io/articles/the-river-and-the-canal/)에서 언급한 암호화폐 브로커는 은행이 파는 것과 똑같은 것을 팝니다. 한결같음, 안전한 보관, 그리고 약속입니다. 비트코인은 누가 돈을 만들어도 되는가에 답했습니다. 그러나 Schreyer의 두 번째 질문, 누가 그 쓰임을 결정하는가에는 답하지 않았고, 무엇에 자금을 댈지, 불운의 비용을 누가 질지에 대한 질문에도 답하지 않았습니다. 그 기능들, 즉 자본 배분과 위험 결합은 여전히 세계에 관한 숫자를 계산하는 기관들이 수행하고 있으며, 그것이 이 글의 주장입니다.
그리고 제가 가장 내려놓기 어려운 질문이 있습니다. 실제로 그것을 발명한 사람은 누구인가 하는 질문입니다. Satoshi Nakamoto는 2010년대 초에 공개적인 소통을 멈췄고, 그 정체는 끝내 확인되지 않았습니다. 2024년 영국 법원은 자신이 Satoshi라고 주장해 온 잘 알려진 인물 Craig Wright가 Satoshi가 아니라고 판결했습니다. 제 나름의 추측은, 그리고 이것이 추측일 뿐 그 이상이 아니라는 점을 분명히 해 두고 싶습니다만, 그것이 정보기관 내부에서, 어쩌면 NSA나 다른 기관에서 나왔을지도 모른다는 것입니다. 사람들이 가리키는 단서는 빈약하지만 실재합니다. 비트코인의 핵심에 있는 해시 함수 SHA-256은 [NSA가 설계한 SHA-2 계열](https://en.wikipedia.org/wiki/SHA-2)에 속하며 2001년과 2002년에 연방 표준으로 공표되었습니다. 그리고 1996년의 NSA 연구 보고서 “How to Make a Mint: The Cryptography of Anonymous Electronic Cash”는 그보다 10여 년 앞서 익명 디지털 화폐를 연구했습니다. 그중 어느 것도 증거는 아닙니다. SHA-256은 공개되어 널리 쓰였고, 전자 현금에 관한 문헌은 암호학자들 사이에 잘 알려져 있었습니다. 저는 이 아이디어를 바닷속 공장을 품는 방식으로 품고 있습니다. 이리저리 뒤집어 볼 만한 사고 실험으로서 말입니다. 만약 그것이 사실이라면, 그것은 무엇보다 기묘한 반전일 것입니다. 기관을 불필요하게 만들도록 설계된 도구를 한 기관이 만든 셈이니까요.
## 최초의 데이터 기업 {#the-original-data-company}
1693년, 혜성으로 유명한 천문학자 Edmond Halley는 *Philosophical Transactions of the Royal Society*에 건조한 제목의 논문을 발표했습니다. “An Estimate of the Degrees of the Mortality of Mankind”(인류의 사망률 정도에 대한 추정)입니다. 그는 브레슬라우 시의 출생 및 사망 기록을 받았고, 그것으로 생명표를 만들었습니다. 같은 해에 태어난 한 무리의 사람들 가운데 각 나이까지 몇 명이 살아남는지를 보여 주는 표입니다. 그리고 그는 그것으로 새로운 일을 했습니다. 그 표를 이용해 종신 연금이 얼마여야 하는지, 즉 주어진 나이의 사람이 죽을 때까지 받을 소득을 위해 얼마를 내야 하는지를 계산한 것입니다. 영국 왕실에 대한 Halley의 권고는 수십 년 동안 무시되었지만, 그 방법은 무시되지 않았습니다. 수집된 데이터셋, 그것에 맞춘 통계 모델, 그 모델에서 도출한 가격. 그것이 보험의 구조 전체이자 그 이후 모든 데이터 기업의 구조이며, 누군가 “빅데이터”라고 말하기 3세기 전에 이미 적혀 있었습니다.
나머지 도구들도 비슷한 시기에 도착했습니다. 1654년 Blaise Pascal과 Pierre de Fermat는 도박에 관한 서신을 주고받으며 우연의 수학을 정립했습니다. 1713년 Jacob Bernoulli의 유고작 *Ars Conjectandi*는 대수의 법칙을 내놓았습니다. 보험사가 개별 주택 하나에 대해서는 아무것도 모르면서도 천 채의 주택에 대해서는 확신할 수 있는 이유입니다. 그리고 1680년대 후반 런던의 Edward Lloyd 커피하우스에는 상인과 선주들이 그 가게가 제공하는 가장 값진 것, 즉 믿을 만한 해운 소식을 찾아 모여들었고, 그곳에서 항해의 보험을 인수하던 사람들이 [Lloyd's of London](https://en.wikipedia.org/wiki/Lloyd%27s_of_London)이 되었습니다. 그 가게는 해운 신문 *Lloyd's List*에도 이름을 남겼습니다. 최초의 거대한 보험 시장은 하나의 정보 서비스를 중심으로 자라났습니다.
강에 관한 에세이에서 기댔던 Frank Knight가 이것이 왜 작동하는지 설명해 줍니다. 그의 의미에서 위험이란 비슷한 많은 사례에 걸쳐 측정할 수 있는 불확실성이며, 측정할 수 있는 위험은 보험에 들 수 있습니다. 보험사는 측정할 수 있는 위험을 절차로 바꾸는 기계입니다. 그 우위는 전적으로 옆의 보험사보다 더 잘 측정하는 데에서 나옵니다.
## 모델을 모델링하기 {#modelling-the-model}
보험사가 하루 종일 실제로 무엇을 하는지 보고, 그것을 번역해 봅시다.
| 보험사가 부르는 이름 | 기술 기업이 부를 이름 |
|---|---|
| 언더라이팅 | 한 고객에 대해 손실의 확률과 크기를 예측하는 일 |
| 가격 산정 | 그 예측을 포트폴리오 전체에서 유지되는 가격으로 바꾸는 모델 |
| 보험금 처리 | 사기 탐지와 예외 처리를 갖춘 대량 워크플로 |
| 준비금 적립 | 이미 빚졌지만 아직 알려지지 않은 것을 예측하는 일 |
| 자본 모델링 | 수천 가지 시나리오 아래에서 대차대조표 전체를 시뮬레이션하는 일 |
| 재보험 | 당신의 모델을 모델링하는 누군가에게서 보호를 사는 일 |
| 판매 채널 | 퍼널, 추천 시스템, 그리고 고객 인터페이스 |
이 행들 가운데 은유는 하나도 없습니다. 가격 산정은 데이터에 맞춘 모델입니다. 준비금 적립은 예측입니다. 자본 모델링은 시뮬레이션이며, 규제 당국이 이를 요구합니다. 예를 들어 [Swiss Solvency Test](https://www.finma.ch/en/supervision/insurers/cross-sectoral-tools/swiss-solvency-test-sst/)에 따라 보험사는 매년 대차대조표 전체에 걸친 위험을 정량화해야 합니다. 표준 모델을 쓰거나, 그것이 자사의 위험에 맞지 않는 경우에는 감독 당국이 승인한 자체 내부 모델을 씁니다. 유럽연합의 Solvency II도 같은 원리로 작동합니다. 과거 보험금 청구를 바탕으로 폭풍의 가격을 매겼던 여러 보험사를 파산시킨 1992년의 허리케인 앤드루, 그리고 그 2년 뒤의 노스리지 지진 이후로, 재물보험사들은 포트폴리오 전체에 걸쳐 허리케인, 지진, 홍수를 시뮬레이션하는 재해 모델에 의존해 왔습니다.
그리고 여기에는 제가 지나칠 수 없는 프랙털이 있습니다. 보험사는 세계를 모델링합니다. 보험사의 보험사인 재보험사는 보험사의 모델을 모델링합니다. 규제 당국은 시스템 전체에 얼마나 많은 자본이 필요한지 정하기 위해 재보험사와 보험사를 모델링합니다. 각 계층은 한 단계 위 규모에서 하는 같은 활동입니다. 아래 계층의 모델을 만들고, 그것이 어디에서 틀렸는지 찾고, 그 오류에 가격을 매기는 것입니다.
*An insurer as a prediction pipeline*
```text
┌────────────────────────────┐
│ data about the world │ claims history, exposure, weather,
│ │ vehicles, buildings, health
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ model │ probability and size of loss,
│ │ per customer and per portfolio
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ price and promise │ the policy: a prediction wrapped
│ │ in a contract
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ procedure │ claims handled the same way,
│ │ every time, for decades
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ outcomes │ feed the next model
└────────────────────────────┘
```
이 파이프라인의 모든 단계는 제가 정의한 의미에서의 기술입니다. 예측을 하는 모델이거나, 매번 같은 방식으로 약속을 지키는 절차입니다. 대차대조표는 그 아래에 놓여 약속을 믿을 만하게 만드는 최후의 안전장치입니다. 그것은 상품이 아닙니다.
## 누가 도로를 보는가 {#who-sees-the-road}
보험사의 우위가 더 잘 측정하는 데 있다면, 그 미래에 관한 가장 중요한 질문은 누가 가장 좋은 측정값을 가지고 있는가입니다. 역사의 대부분 동안 그 답은 보험사 자신이었습니다. 보험사가 보험금 청구 이력과 계리사와 표를 가지고 있었습니다. 그것이 바뀌고 있으며, 가장 분명한 예는 자동차입니다.
현대의 자동차는 어쩌다 바퀴가 달린 센서 플랫폼입니다. 차는 당신이 얼마나 세게 브레이크를 밟는지, 얼마나 빠르게 코너를 도는지, 안전벨트를 매는지, 밤 몇 시에 운전하는지 압니다. Tesla는 이미 미국 일부 지역에서 정확히 그것으로 가격을 매기는 보험을 팔고 있습니다. 그 [실시간 보험](https://tesla.com/support/insurance/real-time-insurance)은 별도의 장치 없이 차량 자체의 데이터로 Safety Score를 계산하고, 그 점수와 주행 거리에 따라 매달 보험료를 조정합니다.
George Hotz는 같은 것을 더 기묘한 각도에서 보았습니다. 그는 iPhone과 PlayStation 3를 탈옥한 일로 유명해졌고, 그 뒤 사람들이 자기 차에 개조해 다는 오픈소스 운전자 보조 시스템을 만드는 [comma.ai](https://comma.ai/)를 세웠습니다. [Lex Fridman과의 대화](https://lexfridman.com/george-hotz/)를 비롯한 인터뷰에서 그는 comma의 진짜 장기 사업이 보험일 수도 있다는 아이디어를 내비쳤습니다. 자사 장치가 수백만 마일이 어떻게 주행되는지 보는 회사는, 나이와 우편번호와 보험금 청구 이력으로 일하는 어떤 보험사보다도 누가 좋은 운전자인지 더 잘 압니다. comma가 실제로 그 일을 하느냐는 그 논리보다 덜 중요하며, 그 논리는 빈틈이 없습니다. 위험에 대한 가장 좋은 모델을 가진 쪽이 그 위험에 가장 좋은 가격을 제시할 수 있고, 가장 좋은 모델은 도로를 보는 쪽에게 갑니다.
같은 논리는 자동차를 훨씬 넘어서까지 적용됩니다. 휴대전화는 사람들이 어떻게 움직이는지 알고, 시계는 그들이 어떻게 자고 심장이 어떻게 뛰는지 알며, 건물은 점점 더 자기 배관이 언제 새는지 압니다. 그 센서들 하나하나가 잠재적으로는 보험사가 아닌 누군가가 쥐고 있는 언더라이팅 모델입니다. 자신이 기술 기업이 아니라고 믿는 보험사는, 자신의 진짜 경쟁자가 누구인지 아직 알아차리지 못한 회사입니다.
## 은행과 브로커, 간단히 {#banks-and-brokers-briefly}
이 논증은 명사만 바꾸면 그대로 옮겨 갑니다. 은행의 핵심 결정, 즉 돈을 빌려줄지 말지는 예측입니다. 이 차입자는 갚을 것인가? 1989년 미국에서 FICO가 범용 점수로 만든 신용 평가는 하나의 모델이며, 현대의 대출 기관은 그보다 훨씬 풍부한 모델로 돌아갑니다. 결제는 거대한 실시간 사기 탐지 문제입니다. 트레이딩 데스크는 모델이자 체결 엔진입니다. 브로커는 공정한 체결이라는 약속이 붙은 매칭 및 라우팅 시스템입니다. 이들 각각은 신뢰로 감싸고 자본으로 뒷받침한 예측이나 절차를 팝니다. 대차대조표는 약속을 믿을 수 있게 만드는 것입니다. 기술은 그 약속을 참으로 만드는 것입니다.
## 그 문장이 사라지지 않는 이유 {#why-the-sentence-persists}
논증이 이렇게 분명하다면, 왜 이 회사들의 지적인 사람들은 계속 “우리는 기술 기업이 아닙니다”라고 말할까요? 저는 세 가지 이유가 있다고 생각하며, 그 어느 것도 어리석음은 아닙니다.
첫째는 회계입니다. 대부분의 은행과 보험사에서 IT는 “현업”을 지원하는 비용 센터로 자라났고, 조직도는 여전히 그것을 반영합니다. [강과 운하](https://raskell.io/articles/the-river-and-the-canal/)에서 다룬 Conway의 법칙이 나머지를 합니다. 기술이 지원 기능인 것처럼 조직된 회사는 지원 기능처럼 동작하는 시스템을 만들고, 그 시스템이 다시 그 믿음을 확인해 줍니다.
둘째는 정체성입니다. 대중의 상상 속에서 “기술 기업”은 실리콘밸리를 뜻합니다. 소비자용 앱, 후드티, 무슨 대가를 치르더라도 성장, 그리고 무언가를 부수는 습관입니다. 한 세기 반 동안 약속을 지켜 온 스위스의 보험사는 그런 것이 되고 싶어 하지 않으며, 그것은 옳습니다. 그러나 해법은 기술에 대한 더 나은 정의이지, 기술을 거부하는 것이 아닙니다. 한 세기 반 동안 일관되게 약속을 지키는 것은 기술적인 성취입니다.
셋째는 이 회사들의 기술이 보이지 않게 될 만큼 오래되었다는 것입니다. 강에 관한 에세이에서 설명한 래칫이 여기에도 적용됩니다. 한 계층이 일단 작동하면 아무도 그것을 더는 보지 않습니다. 보험사에서 보험계리 표나 보험 계약 관리 시스템이나 보험금 처리 워크플로에 감탄하는 사람은 아무도 없습니다. 수돗물에 감탄하는 사람이 아무도 없는 것과 같습니다. 그것들은 그저 일이 처리되는 방식일 뿐입니다. Marc Andreessen은 2011년에 소프트웨어가 세상을 먹어 치우고 있다고 썼습니다. 보험사는 오래전에 먹혔고, 그 뒤로 줄곧 소화되는 중입니다.
## 왜 지금 중요한가 {#why-it-matters-now}
아무것도 바뀌지 않는다면 이것은 흥미로운 이야깃거리에 그쳤을 것입니다. 두 가지가 바뀌고 있습니다.
첫째는 앞서 말한 센서입니다. 위험을 규정하는 데이터는 보험사의 손을 떠나 자동차, 휴대전화, 웨어러블, 건물 안으로 옮겨 가고 있습니다. 자신을 데이터 기업으로 생각하지 않는 보험사는 어느 날 깨어 보니 다른 누군가의 모델이 빌려 쓰는 대차대조표가 되어 있을 것입니다.
둘째는 에이전트입니다. 강에 관한 에세이에서 저는 언어 에이전트가 상징의 세계, 즉 문서와 계약과 절차와 코드의 세계에서 가장 강하며, 그곳이 바로 은행과 보험사가 이미 살고 있는 곳이라고 주장했습니다. 그들의 상품은 계약이고 그들의 공장은 절차입니다. 그 때문에 그들은 에이전트가 할 수 있는 일에 가장 많이 노출된 회사이자, 에이전트를 새로운 종류의 공급업체가 아니라 새로운 종류의 엔지니어링으로 다룬다면 그로부터 가장 많은 이익을 얻을 수 있는 위치에 있는 회사입니다. 스스로를 기술 기업으로 보는 보험사는 어떻게 하면 에이전트가 자사의 보험금 청구, 언더라이팅, 운영을 탐색하게 할지, 그리고 에이전트가 찾아낸 것을 어떻게 신뢰할 수 있는 절차로 바꿀지를 물을 것입니다. 스스로를 다른 무언가로 보는 보험사는 챗봇을 살 것입니다.
## 정직한 반론 {#the-honest-counterargument}
실제적인 반론이 있고, 그것은 실제적인 답을 받을 자격이 있습니다. 보험사는 모델만이 아닙니다. 그들은 위험 자본을 보유하는데, 어떤 소프트웨어 회사도 그렇게 하지 않습니다. 이익의 큰 부분은 보험금이 지급되기 전에 거둔 보험료를 투자하는 데에서 나옵니다. Warren Buffett이 플로트(float)라 부르는 것, 즉 보험사가 보유하지만 소유하지는 않는 돈입니다. 그들은 금융 기관으로서 규제를 받으며, 그들의 브랜드는 코드가 아니라 견고함 위에 세워져 있습니다. 그렇다면 그들은 무엇보다 먼저 금융 회사가 아니겠습니까?
저는 그것이 그들을 금융 회사이기도 하게 만든다고 생각하며, 그것은 같은 것이 아닙니다. 자본은 약속을 믿을 만하게 만드는 것입니다. 자본이 없으면 예측은 의견에 불과합니다. 플로트는 약속의 시점에서 생기는 결과입니다. 규제는 약속이 그토록 중요하기 때문에 존재합니다. 그러나 그 가운데 어느 것도 고객이 사는 것이 아니며, 그 가운데 어느 것도 한 보험사가 다른 보험사를 이길지를 정하지 않습니다. 같은 자본과 같은 규제 당국을 가진 두 보험사는 누가 위험을 더 잘 측정하고, 더 잘 가격을 매기고, 약속을 더 일관되게 더 저렴하게 지키느냐로 이기거나 집니다. 그것들은 모두 기술적인 문제입니다. Buffett 자신도 플로트가 부실한 언더라이팅 실적에 잠겨 버릴 수 있다고 경고했는데, 그것은 모델이 먼저라는 말을 달리 한 것입니다.
## 이것을 받아들이면 무엇이 달라지는가 {#what-changes-if-you-accept-it}
보험사가 기술 기업이라면 몇 가지가 따라 나오며, 그 어느 것에도 후드티는 필요하지 않습니다.
- **모델을 소유하십시오.** 가격 산정, 언더라이팅, 보험금 분류, 자본 모델은 상품 그 자체입니다. 그것들을 외주로 주는 것은 사업을 외주로 주는 것입니다.
- **데이터와 그 주변의 맥락을 소유하십시오.** 여기에는 자사 시스템에 관한 데이터도 포함되며, 이것이 [IT Intelligence](https://raskell.io/articles/it-intelligence/)의 주장입니다. 자기 자신에 관한 질문에 답하지 못하는 회사는 자기 자신 위에 믿을 만한 기술을 쌓을 수 없습니다.
- **엔지니어, 계리사, 데이터 과학자를 하나의 직능으로 다루십시오.** 그들은 서로 다른 도구로 같은 일을 하고 있습니다. 불확실성을 절차로 바꾸는 일입니다.
- **절차를 일급 시민으로 만드십시오.** 보험금 처리와 언더라이팅 절차는 매뉴얼에 적혀 있든 워크플로 엔진에 적혀 있든 코드입니다. 그것들을 코드처럼 다루십시오. 버전을 관리하고, 과거 사례로 테스트하고, 재실행할 수 있게 하십시오.
- **센서가 있는 곳으로 가십시오.** 도로와 집과 몸을 보는 회사들과 협력하거나, 스스로 그런 회사가 되십시오.
- **에이전트가 탐색하게 하고, 효과가 있는 것은 남겨 두십시오.** 측정된 위험을 매번 같은 방식으로 실행되는 절차로 바꾸는, 보험사의 가장 오래된 역량이 바로 에이전트 시대에 필요한 역량입니다.
## 맺으며 {#closing}
Halley의 생명표는 데이터셋이자 모델이자 가격이었습니다. Lloyd's는 뉴스 서비스를 중심으로 세워진 보험 시장이었습니다. 그 이후의 모든 보험 증권은 약속으로 감싼 예측이었고, 모든 보험금 처리 부서는 그 약속을 매번 같은 방식으로 지키도록 설계된 절차였습니다. 그것이 이 사업들에 중요한 유일한 의미에서의 기술, 곧 신뢰의 형식화입니다. 보험사는 기술 기업이 될 필요가 없습니다. 자신이 이미 기술 기업이라는 것, 그리고 세계에 대한 다음 모델을 둘러싼 경쟁이 이미 시작되었다는 것을 알아차리기만 하면 됩니다. 그 경쟁은 흔히 스스로를 보험사라고 전혀 부르지 않는 회사들에서 벌어지고 있습니다.
## 참고 문헌 {#references}
- David Graeber, *Debt: The First 5,000 Years*, Melville House, 2011, 2014년 개정 증보판.
- Michael McLeay, Amar Radia and Ryland Thomas, [Money creation in the modern economy](https://www.bankofengland.co.uk/quarterly-bulletin/2014/q1/money-creation-in-the-modern-economy), Bank of England Quarterly Bulletin, 2014 Q1.
- Mathias Binswanger, *Geld aus dem Nichts: Wie Banken Wachstum ermöglichen und Krisen verursachen* (Money Out of Nothing: How Banks Enable Growth and Cause Crises), Wiley-VCH, 2015; 인용문의 번역은 필자의 것입니다.
- Satoshi Nakamoto, [Bitcoin: A Peer-to-Peer Electronic Cash System](https://bitcoin.org/bitcoin.pdf), 2008, 그리고 [암호학 메일링 리스트의 발표](https://www.metzdowd.com/pipermail/cryptography/2008-October/014810.html), 2008년 10월 31일.
- [The Bitcoin genesis block](https://en.bitcoin.it/wiki/Genesis_block), 그리고 그 안에 담긴 *Times* 헤드라인.
- [SHA-2](https://en.wikipedia.org/wiki/SHA-2), NSA가 설계하고 NIST가 표준화한 해시 함수 계열.
- Laurie Law, Susan Sabett and Jerry Solinas, "How to Make a Mint: The Cryptography of Anonymous Electronic Cash", National Security Agency, 1996.
- Paul Schreyer, *Wer regiert das Geld? Banken, Demokratie und Täuschung* (Who Governs Money? Banks, Democracy and Deception), Westend, 2016; 인용문의 번역은 필자의 것입니다.
- Joseph A. Schumpeter, *The Theory of Economic Development*, 1911, 영어 번역 1934; 은행가 인용문은 [Festré and Nasica, MPRA paper 67694](https://mpra.ub.uni-muenchen.de/67694/1/MPRA_paper_67694.pdf)에서 1983년판 74쪽을 인용한 것에 따름.
- [Risk pool](https://en.wikipedia.org/wiki/Risk_pool), 위험 결합과 상호화에 관하여.
- [Luis de Santángel](https://en.wikipedia.org/wiki/Luis_de_Sant%C3%A1ngel), 콜럼버스의 첫 항해 자금 조달에 관하여.
- Nassim Nicholas Taleb, [*The Black Swan*](https://en.wikipedia.org/wiki/The_Black_Swan:_The_Impact_of_the_Highly_Improbable) (2007), [*Antifragile*](https://en.wikipedia.org/wiki/Antifragile_(book)) (2012), [*Skin in the Game*](https://en.wikipedia.org/wiki/Skin_in_the_Game_(book)) (2018).
- Edmond Halley, [An Estimate of the Degrees of the Mortality of Mankind](https://ui.adsabs.harvard.edu/abs/1693RSPT...17..596H/abstract), *Philosophical Transactions of the Royal Society* 17, 1693, 596~610쪽.
- Jacob Bernoulli, *Ars Conjectandi*, 1713.
- [Lloyd's of London](https://en.wikipedia.org/wiki/Lloyd%27s_of_London), Edward Lloyd 커피하우스에서의 기원에 관하여.
- Frank H. Knight, [*Risk, Uncertainty, and Profit*](https://www.econlib.org/library/Knight/knRUP.html), 1921.
- Tesla, [Real-Time Insurance](https://tesla.com/support/insurance/real-time-insurance)와 Safety Score.
- [comma.ai](https://comma.ai/), 그리고 [George Hotz가 출연한 Lex Fridman 팟캐스트](https://lexfridman.com/george-hotz/).
- 허리케인 앤드루 이후의 재해 모델링에 관하여: [Insurance Journal, Lessons Learned from Hurricane Andrew](https://www.insurancejournal.com/magazines/mag-features/2017/09/04/462873.htm).
- FINMA, [Swiss Solvency Test](https://www.finma.ch/en/supervision/insurers/cross-sectoral-tools/swiss-solvency-test-sst/).
- [The History of the FICO Score](https://blog.myfico.com/history-of-the-fico-score/).
- Marc Andreessen, "Why Software Is Eating the World", *The Wall Street Journal*, 2011.
- Warren Buffett, Berkshire Hathaway 주주 서한, 보험 플로트에 관하여.
================================================================================
---
title: "강과 운하"
url: https://raskell.io/ko/articles/the-river-and-the-canal/
author: Raffael Schneider
date: 2026-10-31
description: "에이전트는 험준한 세계를 탐색하고, 워크플로는 그 탐색이 남긴 것입니다. 체스, 스타크래프트, 바닷속 공장, 그리고 제가 엔진을 만드는 이유에 관하여."
tags: [agents, game-ai, fractals, abstraction, determinism, durable-execution, trust, factories, post-scarcity, legibility, finance, insurance, chess, go-game, starcraft, internet-culture]
lang: ko
translation_of: https://raskell.io/articles/the-river-and-the-canal/
---
# 강과 운하
## 요약
에이전트는 열려 있고 안개 낀 문제를 탐색하는 데 가장 뛰어나고, 결정론적 워크플로는 이미 아는 문제를 반복하는 데 가장 뛰어납니다. 은행과 보험사처럼 한결같음을 파는 기업은 후자에 기대고 있습니다. 컴퓨팅의 모든 계층은 무언가를 하나씩 더 예측 가능하게 만들어 사람들이 그것에 대해 더는 생각하지 않아도 되게 했습니다. 모든 것을 위한 에이전트 오케스트레이터는 그 생각을 다시 돌려보내는 첫 번째 계층입니다. 효과가 있는 설계는 메타 공장입니다. 에이전트가 탐색하고, 효과가 있는 것을 워크플로로 적어 두고, 결정론적 엔진이 그것을 실행하며, 세상이 바뀌면 에이전트가 그것을 고치거나 폐기합니다. 워크플로 안에도 운하의 갑문처럼 범위가 정해진 에이전트 단계를 둘 수 있습니다. 그러면 판단은 필요한 곳에 남고, 나머지는 감사할 수 있고 반복할 수 있으며 저렴해집니다. 모든 것이 절차가 되어야 하는 것은 아닙니다. 가장자리의 에이전트는 남습니다. 안개는 결코 완전히 걷히지 않기 때문입니다.
*시작하기 전에 한 가지 말씀드립니다. 이 글은 이 사이트의 다른 글들과 성격이 다릅니다. 기술적인 글이라기보다 철학적인 에세이이고, 읽는 데 45분쯤 걸리는 긴 글입니다. 한 장의 사진에서 시작해 워크플로 엔진의 이름으로 끝나며, 그 사이에 프랙털, 게임, 우주론, 조직에 관한 한 세기의 사유, 4chan에서 나온 이야기, 그리고 다음 주 월요일부터 쓸 수 있는 현장 안내서를 지나갑니다. 또한 제가 여기에 쓴 어떤 글보다도 제가 생각하는 방식을 그린 지도에 가깝습니다. 실용적인 부분만 원하신다면 [현장 안내서로 건너뛰셔도 됩니다](#a-field-guide).*
제가 이 글을 쓰고 있는 카페의 벽에 사진 한 장이 걸려 있습니다. 사진작가 Armin Grässl(아르민 그레슬)의 [*Whispering Current*](https://www.armingraessl.ch/collection/006-whispering-current)입니다. 작가가 직접 붙인 설명은 “거대한 바위들 사이로 물이 제 길을 새긴다”는 문장으로 시작하는데, 사진이 보여 주는 것이 바로 그것입니다. 바위 바닥 위를 흐르는 산속의 강은 부서지는 곳에서는 하얗고 고이는 곳에서는 검으며, 그 뒤로 소나무들이 안개 속으로 녹아듭니다. 그 강의 어느 2미터도 같은 방식으로 움직이지 않습니다. 물은 우리가 알아볼 수 있는 어떤 의미에서도 자신이 어디로 가는지 알지 못합니다. 모든 틈을 시도하고, 모든 움푹한 곳을 채우며, 아무도 계획하지 않은 지형 사이로 바위 하나씩 길을 찾아냅니다.
저는 이 사진을 자꾸 바라봅니다. 책상 앞에서는 답할 수 없던 질문에 이 사진이 답해 주기 때문입니다. 몇 주 전 저는 Rust로 지속형(durable) 워크플로 엔진을 만들기 시작했습니다. [Temporal](https://temporal.io/)과 [Restate](https://restate.dev/) 계열에 속하는 것으로, 가칭은 *tsumugi*였습니다. 합리적인 프로젝트입니다. 라이브러리로 시작해 클러스터로 자라는 자기 완결적인 엔진은 쓸모가 있고, 저는 그 이유를 긴 설계 문서에 적어 두었습니다. 그런데 그 문서는 끝내 답하지 못한 한 질문의 주위를 계속 맴돌았습니다. 에이전트가 일을 할 수 있는 2026년에, 누가 왜 워크플로 엔진을 필요로 하겠습니까?
[Claude Code](https://www.anthropic.com/claude-code) 같은 하네스 위에 만들어진 에이전트는 바로 그 강이 하는 일에 놀라울 만큼 능숙합니다. 낯선 코드베이스나 고장 난 배포, 모호한 요청을 목표와 함께 건네면, 에이전트는 더듬어 보고, 실패하고, 조정하고, 결국 길을 찾아냅니다. 그것이 일의 새로운 모습이라면, 고정된 단계와 결정론에 대한 고집을 지닌 워크플로 엔진은 저물어 가는 세계를 위한 도구처럼 보입니다.
저는 그렇게 생각하지 않지만, 답은 프로젝트보다 훨씬 큰 것으로 드러났습니다. 그리고 그 답은 프로젝트의 새 이름으로 끝나는데, 그 이름을 저는 이 에세이 안에서 찾았습니다.
## 모든 것은 프랙털입니다 {#everything-is-a-fractal}
강을 더 가까이 들여다보면 또 다른 것이 보입니다. 큰 바위 하나를 둘러싼 물의 무늬가 그보다 작은 바위들 주위에서, 그리고 그 사이의 자갈 주위에서 되풀이됩니다. 뒤편의 나무들은 강이 갈라지듯 가지를 치고, 그 가지들은 다시 가지를 칩니다. Benoit Mandelbrot(브누아 망델브로)는 1982년 [『자연의 프랙털 기하학』(*The Fractal Geometry of Nature*)](https://en.wikipedia.org/wiki/The_Fractal_Geometry_of_Nature)을 이런 시선을 유명하게 만든 문장으로 열었습니다. “구름은 구가 아니고, 산은 원뿔이 아니며, 해안선은 원이 아니고, 나무껍질은 매끄럽지 않으며, 번개도 직선으로 나아가지 않는다.” 자연은 거칠고, 그 거칠음은 서로 다른 규모에서 서로 닮아 보입니다. 그 [자기 유사성](https://en.wikipedia.org/wiki/Self-similarity)이 바로 [프랙털](https://en.wikipedia.org/wiki/Fractal)입니다.
이것은 제가 가장 오래 품어 온 생각입니다. 이 사이트의 어떤 프로젝트보다 오래되었고, 뒤에 이어지는 모든 것의 밑바닥에 흐르고 있습니다. 그 짧은 판본은 [모든 것은 프랙털입니다](https://raskell.io/notes/everything-is-a-fractal/)라는 노트로 따로 적어 두었습니다. 저는 우리가 시간에도 공간에도 한계가 없는 세계, 모든 방향으로 끝없이 뻗어 있는 세계에 살고 있을 가능성이 매우 높다고 생각합니다. 그런 세계에서 프랙털은 가장 자연스러운 형태입니다. 같은 패턴이 모든 규모에서 되풀이되고, 가장 큰 사례도 가장 작은 사례도 없습니다. 우주론자들은 이 생각의 강한 판본에 [프랙털 우주론](https://en.wikipedia.org/wiki/Fractal_cosmology)이라는 이름을 붙였습니다. 물질이 모든 규모에서 프랙털로 분포한다는 가설입니다. 이는 소수의 입장입니다. 대부분의 우주론자는 은하 탐사 자료가 수억 광년 너머에서는 우주가 균질해진다는 것을 보여 준다고 읽습니다. 그래서 저는 무한하고 프랙털적인 세계를 물리학 세미나에서 방어할 수 있는 주장이 아니라, 생각할 때 기대어 쓰는 직관으로 품고 있습니다. 아이디어와 조직과 기계가 어떻게 움직이는지에 관한 직관으로서는 한 번도 저를 실망시킨 적이 없습니다.
이 생각은 제 세대의 많은 사람에게 그랬듯 『쥬라기 공원』을 통해 제게 왔습니다. 제가 가장 좋아하는 책 가운데 하나인 Michael Crichton(마이클 크라이튼)의 [1990년 소설](https://en.wikipedia.org/wiki/Jurassic_Park_(novel))은 카오스 이론을 뼈대로 삼고 있는데, 대부분의 독자는 카오스 이론을 접했다면 1987년에 나온 James Gleick(제임스 글릭)의 [『카오스』(*Chaos: Making a New Science*)](https://en.wikipedia.org/wiki/Chaos:_Making_a_New_Science)을 통해서였을 것입니다. 크라이튼의 수학자 [Ian Malcolm(이언 맬컴)](https://en.wikipedia.org/wiki/Ian_Malcolm_(character))은 부분적으로 글릭에게서 영감을 받은 인물입니다. 소설은 ‘부’가 아니라 ‘반복(iteration)’으로 나뉘어 있고, 각 반복은 같은 프랙털인 [하이웨이 드래곤 곡선](https://en.wikipedia.org/wiki/Dragon_curve)의 그림으로 시작하는데, 그 그림은 앞의 것보다 조금씩 더 접혀 있습니다. 1993년 영화에서 맬컴은 모두가 기억하는 대사를 얻습니다. “생명은, 어, 길을 찾아내지.” 다시 그 강입니다.
이 모든 것에서 제가 얻은 것은 아이디어에 관한 하나의 아이디어입니다. 모든 프랙털 가운데 가장 유명한 [망델브로 집합](https://en.wikipedia.org/wiki/Mandelbrot_set)은 아주 작은 규칙 하나를 거듭 적용하는 데서 나옵니다. 수 하나를 취해 제곱하고, 상수를 더하고, 이를 반복합니다. 단순한 것을 반복하면 한없이 풍부한 것이 생겨납니다. 저는 좋은 아이디어도 같은 방식으로 작동한다고 생각합니다. 과학에서도, 공학에서도, 비즈니스에서도, 제가 아는 모든 기예에서도 그렇습니다. 가장 좋은 아이디어는 도약인 경우가 드뭅니다. 그것은 앞선 것 위에 얹힌 작은 반복이며, 새로운 행동이 창발할 만큼의 새로움만을 더한 단순한 개선입니다. 그리고 그것은 다른 모든 사람이 그 위에 쌓아 올리는 계층이 됩니다. [Stuart Kauffman(스튜어트 카우프만)](https://en.wikipedia.org/wiki/Stuart_Kauffman)은 그런 다음 걸음들의 공간을 *인접 가능성*(adjacent possible)이라고 불렀습니다. 어느 순간이든 지금 존재하는 것에서 한 걸음만 떨어진 걸음은 특정한 몇 개뿐이라는 뜻이며, Steven Johnson(스티븐 존슨)은 좋은 아이디어가 어디서 오는지를 다룬 자신의 책을 이 표현으로 열었습니다. Michael Tomasello(마이클 토마셀로)는 이 메커니즘의 나머지 절반을 [래칫(ratchet)](https://en.wikipedia.org/wiki/Ratchet_effect)으로 묘사했습니다. 각 세대는 앞 세대가 만든 것을 지키며 조금을 더하고, 그렇게 얻은 것은 뒤로 미끄러지지 않습니다.
그 래칫이 바로 진보가 지금과 같은 느낌을 주는 이유입니다. 어떤 계층이 일단 존재하면 우리는 더 이상 그것을 보지 않습니다. 수돗물이나 함수 호출이나 검색 엔진에 감탄하는 사람은 없고, 그것들이 없던 세계로 돌아갈 수 있는 사람도 없습니다. 이제 AI도 같은 래칫 위에 있습니다. 누가 AI를 어떻게 생각하든, 누군가는 다음 걸음을 내딛고 그다음 걸음도 내딛을 것이며, 그 계층은 평범한 것이 될 것입니다.
제 생각은 대개 이런 식으로 움직입니다. 혼합적이고 수렴적이어서, 아주 다른 곳에서 아이디어를 끌어오다 보면 그것들이 서로 다른 규모에 놓인 같은 아이디어였다는 것이 드러납니다. 이 에세이가 그 예입니다. 프랙털은 계속 돌아올 것입니다. 게임에서, 기업에서, 오케스트레이터에서, 바닷속 공장에서, 그리고 엔진의 이름에서 돌아올 것입니다.
## 두 종류의 게임 {#two-kinds-of-games}
저는 Sebastian Mallaby(서배스천 맬러비)의 『무한 기계』(*The Infinity Machine*)를 읽고 있습니다. Demis Hassabis(데미스 허사비스)와 DeepMind에 관한 책으로, [이곳에 서평을 썼습니다](https://raskell.io/articles/win-everything-control-no-one/). 13장에서 바둑과 체스의 승리 이후 DeepMind는 스타크래프트 II로 눈을 돌리고, 맬러비는 그것이 왜 다른 종류의 문제였는지 이렇게 설명합니다.
> 스타크래프트는 보드게임이라기보다 인간이 삶을 경험하는 방식에 가깝다. 선택과 하위 선택이 끊임없이 이어지는 흐름이며, 어떤 것은 장기적인 계획을, 어떤 것은 더 즉각적인 대응을 필요로 하고, 그 모든 것이 불완전한 정보라는 안개 때문에 더욱 당혹스러워진다.
체스는 존재하는 가장 순수한 닫힌 게임입니다. 판 전체가 보이고, 규칙은 결코 바뀌지 않으며, 수는 번갈아 두어지고, 끝은 정의되어 있습니다. 체크메이트이거나 무승부입니다. 일어날 수 있는 모든 일은 원리상 미리 알려져 있습니다. 스타크래프트는 그 반대입니다. 여러분은 자기 유닛이 보는 것만 볼 수 있고, 나머지는 말 그대로 [전장의 안개(fog of war)](https://en.wikipedia.org/wiki/Fog_of_war)라고 불립니다. 무엇도 여러분의 차례를 기다려 주지 않으며, 무엇이 승리인지는 상대가 지금 이 순간 무엇을 하고 있는지에 달려 있습니다. DeepMind는 결국 [AlphaStar](https://en.wikipedia.org/wiki/AlphaStar_(software))를 만들었고, 맬러비의 설명에 따르면 AlphaStar는 2019년 10월까지 순위에 오른 인간 플레이어를 상대로 99.8퍼센트의 게임에서 이겼습니다. 하지만 그러려면 다른 종류의 기계가 필요했습니다. 알려진 트리를 탐색하는 기계가 아니라, 불확실성 속에서 행동하는 법을 배운 기계였습니다.
저는 스타크래프트를 많이 했습니다. 두 게임의 차이는 제게 학문적인 이야기가 아닙니다. 체스에서는 옳을 수 있습니다. 스타크래프트에서는 상대보다 조금 덜 틀릴 수 있을 뿐이고, 그것도 조금 더 빨리 그래야 합니다. 스타크래프트는 체스와 달리 프랙털이기도 합니다. 맬러비의 “선택과 하위 선택”이라는 표현은 정확합니다. 안개 속에서 너무 적은 시간으로 결정해야 하는 같은 문제가, 게임 전체의 경제에서부터 단 1초 동안 단일 유닛이 움직이는 일에 이르기까지 모든 시간 규모에서 되풀이됩니다.
### 세 번째 게임 {#the-third-game}
같은 시기, 대양 건너편에서는 다른 연구소가 다른 내기를 하고 있었습니다. 2017년 Google의 한 팀이 [“Attention Is All You Need”](https://arxiv.org/abs/1706.03762)라는 제목의 논문에서 [트랜스포머](https://en.wikipedia.org/wiki/Transformer_(deep_learning_architecture))를 소개했습니다. 맬러비는 Ilya Sutskever(일리야 수츠케버)가 그 논문을 읽고 의자에서 벌떡 일어났다고 묘사합니다. OpenAI는 트랜스포머를 언어에 겨누었습니다. 텍스트를 이어 쓰도록 훈련된 [생성형 사전 학습 트랜스포머](https://en.wikipedia.org/wiki/Generative_pre-trained_transformer), 곧 GPT입니다. DeepMind가 스타크래프트에 깊이 빠져 있던 2019년 2월에 GPT-2가 나왔고, 2022년 말에는 그 대화형 후손인 [ChatGPT](https://en.wikipedia.org/wiki/ChatGPT)가 전 세계적인 돌풍을 일으켰습니다.
DeepMind에도 트랜스포머가 있었습니다. AlphaStar가 바로 그 위에 만들어졌습니다. DeepMind에 없었던 것은 언어야말로 해 볼 만한 게임이라는 확신이었습니다. 맬러비는 그 이유를 직설적으로 말합니다. “언어 모델링에 관해서는 허사비스의 감각이 빗나갔고, 그 이유에는 세계에 뿌리내리지 않은 기호에 대한 그의 회의, 게임에 대한 그의 사랑, 그리고 인간의 경험이 인터넷의 모든 텍스트보다 더 다채롭고 어쩌면 더 웅대하다는 그의 전제가 있었다.” 허사비스 자신은 이에 대해 너그럽습니다. “이봐요, 매번 노스트라다무스일 수는 없잖아요.”
저는 그것을 기술적인 실수라기보다 철학적인 실수로 읽습니다. 언어는 체스도 스타크래프트도 아닌 세 번째 종류의 지형입니다. 인간이 나머지 둘을 묘사하고, 압축하고, 조율하기 위해 기호로 지어 올린 세계입니다. 계약, 법, 절차, 코드, 문서, 리눅스 머신의 셸이 그렇습니다. 허사비스는 지능이 게임과 물리 세계에서 쟁취될 것이라는 데 걸었지만, 최초의 범용 에이전트는 텍스트를 통해 도착했습니다.
모두가 이것으로 무언가가 판가름 났다고 받아들이는 것은 아닙니다. [Yann LeCun(얀 르쿤)](https://en.wikipedia.org/wiki/Yann_LeCun)은 수년 동안 언어 모델만으로는 인간 수준의 지능에 도달할 수 없다고 주장해 왔습니다. 인간과 동물은 현실에 관해 읽어서가 아니라 현실 속에서 행동하면서 현실을 배우기 때문입니다. 그는 2025년 11월 Meta를 떠나 [AMI](https://techcrunch.com/2026/01/23/whos-behind-ami-labs-yann-lecuns-world-model-startup/)를 세웠고, AMI는 월드 모델을 만들기 위해 2026년에 10억 달러를 조금 넘는 자금을 모았습니다. AMI의 사명 선언문은 진정한 지능은 “언어에서 시작하지 않는다. 세계에서 시작한다”고 말합니다. 그의 관점에서 오늘날의 에이전트는 프로그래밍 언어와 인터프리터와 터미널 세션이라는 좁은 세계에 살고 있으며, 진짜 안개는 다른 곳에 있습니다.
그의 입장 뒤에는 오래된 관찰이 있습니다. 1988년 로봇공학자 Hans Moravec(한스 모라벡)은 『마음의 아이들』(*Mind Children*)에서, 컴퓨터가 지능 검사나 체커 게임에서 어른처럼 수행하게 만드는 것은 비교적 쉽지만, 한 살배기의 지각과 이동 능력을 주는 것은 매우 어렵다고 지적했습니다. 우리가 어렵다고 여기는 것, 곧 기호와 논리는 기계에게 쉬운 것으로 드러났습니다. 우리가 힘들이지 않고 하는 것, 이를테면 미끄러지지 않고 강바닥을 건너는 일은 어려운 부분으로 드러났습니다. 이 관찰은 [모라벡의 역설](https://en.wikipedia.org/wiki/Moravec%27s_paradox)로 알려져 있습니다.
저는 허사비스를 비판하는 사람들도, 르쿤도 각자 무언가에 대해서는 옳다고 생각하며, 그 구분은 이 에세이의 한가운데를 관통합니다. 제가 이 글에서 다루는 에이전트는 기호 세계 안의 안개를 탐색합니다. 낯선 코드베이스, 모호한 문서, 문서화되지 않은 API가 그렇습니다. 그 세계에도 규칙이 있지만, 규칙이 너무 많고 너무 느슨하게 집행되어서 안에서 보면 스타크래프트처럼 움직입니다. 사진 속의 강, 그리고 언젠가 그 강을 건너야 할 로봇들에게는 르쿤이 만들고 있는 것이 필요합니다. 하지만 한결같음을 파는 기업들, 곧 은행과 보험사와 행정 기관은 이미 거의 전적으로 기호 세계 안에 살고 있습니다. 그들의 제품은 계약이고 그들의 공장은 절차입니다. 그곳이 바로 언어 에이전트가 가장 강한 지형이며, 바로 그 때문에 에이전트가 무엇을 남겨야 하는가라는 질문이 그곳에서 그토록 중요합니다.
## 위험과 불확실성 {#risk-and-uncertainty}
체스와 스타크래프트의 차이에는 경제학에서 훨씬 오래된 이름이 있습니다. 1921년 Frank Knight(프랭크 나이트)는 [『위험, 불확실성, 그리고 이윤』(*Risk, Uncertainty, and Profit*)](https://www.econlib.org/library/Knight/knRUP.html)을 출간하며 지금도 쓸모 있는 선을 하나 그었습니다. **위험**(risk)은 측정할 수 있는 불확실성입니다. 하나의 사례에서 무슨 일이 일어날지는 모르지만, 비슷한 많은 사례에 걸친 분포는 압니다. 나이트의 엄밀한 의미에서의 **불확실성**([나이트적 불확실성](https://en.wikipedia.org/wiki/Knightian_uncertainty))은 측정할 수 없는 종류입니다. 셀 수 있는 유의미한 유사 사례의 집합이 없기 때문입니다. 위험은 원리상 보험으로 대비할 수 있습니다. 불확실성은 그럴 수 없습니다. 그리고 나이트는 경쟁 경제에서 이윤은 위험이 아니라 불확실성에서 나온다고 주장했습니다. 측정 가능한 위험은 가격이 매겨지고 경쟁 속에서 사라지기 때문입니다.
두 게임을 염두에 두고 이것을 읽어 보십시오. 보험회사는 말 그대로 위험을 절차로 바꾸는 기계입니다. 수도관 파열, 자동차 사고, 자전거 도난처럼 고객 한 사람 한 사람에게는 예측할 수 없는 사건을 받아서 전체로는 예측 가능하게 만들고, 그다음 각각을 매번 똑같은 절차로 처리합니다. 기업가, 연구자, 로봇 엔지니어는 나이트의 선 반대편에 삽니다. 그들의 이윤은, 생긴다면, 아무도 확률을 잴 수 없는 곳에서 잘 행동하는 데서 나옵니다.
이로써 두 종류의 게임은 경제적인 의미를 얻습니다. 닫힌 게임은 위험을 측정할 수 있는 게임이므로 올바른 대응은 절차입니다. 열린 게임은 불확실성을 측정할 수 없는 게임이므로 올바른 대응은 판단, 탐색, 적응입니다. 둘 다 가치가 있습니다. 다만 같은 종류의 가치는 아닙니다.
## 두 종류의 기업 {#two-kinds-of-businesses}
그 두 게임이 눈에 들어오면, 기업들은 놀라울 만큼 깔끔하게 갈라집니다.
은행, 보험사, 세무서, 토지 등기소, 연기금, 그리고 암호화폐 브로커 같은 새로운 참가자들은 추상적인 무언가를 팝니다. 보험 증권은 손으로 만질 수 없습니다. 고객이 사는 것은 특정한 조건이 충족되면 특정한 일이 특정한 방식으로, 매번, 모든 사람에게, 수십 년 동안 일어나리라는 약속입니다. 그런 기업의 가치는 한결같음에 있습니다. 그날의 기분에 따라 다르게 처리되는 보험금 청구는 기능이 아니라 제품의 실패입니다.
독일의 사회학자 [Niklas Luhmann(니클라스 루만)](https://en.wikipedia.org/wiki/Niklas_Luhmann)은 이것에 정확한 이름을 붙였습니다. 『신뢰』(*Vertrauen*, 1968, 영어로는 *Trust and Power*의 일부로 출간)에서 그는 신뢰를 복잡성을 줄이는 방법으로 설명합니다. 모든 것을 검증할 수는 없으므로 무엇에 기댈지를 정하는 것입니다. 그는 아는 사람에 대한 **인격적 신뢰**와, 그 안의 누구도 알지 못한 채 기대는 화폐와 은행 같은 제도에 대한 **체계 신뢰**를 구분합니다. 창구 직원을 믿어서 은행을 믿는 사람은 없습니다. 창구 직원이 누구든 체계가 똑같이 행동하리라고 믿기 때문에 은행을 믿습니다. [Max Weber(막스 베버)](https://en.wikipedia.org/wiki/Max_Weber)는 반세기 앞서 [관료제](https://en.wikipedia.org/wiki/Bureaucracy)에 대해 같은 지적을 했습니다. 관료제의 힘, 그리고 그 정당성의 원천은 계산 가능성, 곧 규칙을 사람을 가리지 않고 균일하게 적용하는 데 있습니다. 관료제란 그것이 무엇을 할지 예측할 수 있다는 약속입니다.
암호화폐 브로커는 이것의 가장 새롭고 가장 극단적인 판본입니다. 그 고객들은 [스마트 계약](https://en.wikipedia.org/wiki/Smart_contract)이라는 형태로 코드 자체를 믿으라는 요구를 받고, 가장 순수한 경우에는 절차가 너무나 결정론적이어서 누구나 재실행해 볼 수 있는 공개 원장 위에서 돌아갑니다. 이 업계를 어떻게 생각하든, 그것은 원리를 인상적으로 보여 줍니다. 인격적 신뢰가 전혀 없을 때는 결정론이 모든 것을 짊어져야 합니다.
다른 기업들은 물리 세계와 흥정합니다. 로봇공학, 에너지, 우주, 농업, 의학, 그리고 모든 연구소가 그렇습니다. 그들 발밑의 지형은 변합니다. 어제 잘 작동한 로봇 팔이 오늘은 살짝 휜 부품을 만납니다. 시추 장비는 아무도 예측하지 못한 암반을 만납니다. 그들의 가치는 그 자리에서 적응하는 데 있고, 휘어지지 못하는 절차는 부채가 됩니다.
대부분의 실제 회사는 둘 다를 담고 있으며, 그 경계는 회사와 회사 사이가 아니라 부서들 사이를 지나갑니다. 보험사의 보상 부서는 체스를 둡니다. 상품 개발 부서는 스타크래프트를 합니다. 그리고 이 패턴은 각각의 안에서 되풀이됩니다. 은행은 절차들로 이루어진 절차이고, 각 부서는 회사 전체가 하는 약속의 작은 판본이며, 그 끝에는 매번 같은 방식으로 채워야 하는 서식 한 장이 있습니다. 두 종류의 문제는 종류 자체가 다르고, 서로 다른 종류의 기계를 요구합니다.
## 두 종류의 기계 {#two-kinds-of-machines}
이 구분 또한 보기보다 오래되었습니다. 1960년 『경영 의사결정의 새로운 과학』(*The New Science of Management Decision*)에서 [Herbert Simon(허버트 사이먼)](https://en.wikipedia.org/wiki/Herbert_A._Simon)은 조직이 확립된 절차로 처리하는 일상적이고 반복적인 **정형적 의사결정**(programmed decisions)과, 문제 해결이 필요한 새롭고 구조화되지 않은 **비정형적 의사결정**(non-programmed decisions)을 구분했습니다. 그는 이 둘을 두 개의 상자가 아니라 하나의 연속체의 양 끝으로 다루었고, 정형적인 쪽 끝은 컴퓨터가 넘겨받으리라고 예상했습니다. 비정형적인 쪽 끝에 대해서는 당시의 컴퓨터가 내놓을 것이 거의 없었습니다.
64년 뒤인 2024년 12월, Anthropic은 [“Building effective agents”](https://www.anthropic.com/engineering/building-effective-agents)(효과적인 에이전트 만들기)라는 짧은 안내서를 발표했는데, 이 글은 언어 모델에 대해 거의 같은 선을 긋습니다. “워크플로는 LLM과 도구가 미리 정의된 코드 경로를 통해 오케스트레이션되는 시스템이다. 반면 에이전트는 LLM이 자신의 프로세스와 도구 사용을 동적으로 지휘하는 시스템이다.” 그 조언은 차분합니다. “워크플로는 잘 정의된 작업에 예측 가능성과 일관성을 제공하는 반면, 에이전트는 대규모로 유연성과 모델 주도의 의사결정이 필요할 때 더 나은 선택지다.” 그리고 비용을 분명하게 밝힙니다. “에이전트의 자율적인 특성은 더 높은 비용과, 오류가 누적될 가능성을 의미한다.”
그러니 한쪽에는 결정론적 기계가 있습니다. 워크플로 엔진, 프로세스 엔진, 스케줄러, 그리고 넓은 의미에서는 절차를 글로 적어 둔 적이 있는 모든 관료제입니다. 같은 입력이 주어지면 그것들은 같은 일을 하고, 무언가 잘못되면 일어난 일을 한 단계씩 재실행해 볼 수 있습니다. 다른 쪽에는 에이전트가 있습니다. 2026년에 에이전트란 도구를 쥐고 루프 안에서 도는 언어 모델을 뜻하지만, 이 말은 언제나 사람을 가리키기도 했습니다. 목표를 주면 그들은 길을 찾아내고, 그 길은 매번 다릅니다. 이 구분은 오래되었습니다. 새로운 소식은 처음으로 기계가 사이먼이 말한 비정형적인 쪽 끝에서 능숙해졌다는 것입니다.
두 종류의 문제를 두 종류의 기계와 맞대어 보면 네 칸이 나오고, 그중 두 칸은 실수입니다.
| | **결정론적 기계** (절차, 워크플로) | **에이전트형 기계** (실행 시점에 탐색) |
|---|---|---|
| **닫힌 문제** (측정 가능한 위험, 알려진 규칙, 정의된 끝) | 보험사의 보상 처리 절차: 한결같음을 통한 신뢰 | 값비싼 즉흥 연주: 대부분은 맞지만, 왜 그렇게 했는지 아무도 말할 수 없음 |
| **열린 문제** (불확실성, 안개, 변하는 지형) | 예상하지 못한 첫 바위에서 부서지는 깨지기 쉬운 자동화 | 탐험가: 시행착오로 길을 찾아냄 |
왼쪽 아래 칸은 엔터프라이즈 자동화의 역사입니다. 지저분한 현실 위에 덧씌운 경직된 프로세스, 그리고 그 뒤를 따르는 끝없는 예외 처리입니다. 오른쪽 위 칸은 지금 이 순간의 위험입니다. 에이전트는 이제 충분히 좋아져서, 닫힌 게임까지 포함해 모든 것을 맡기고 싶은 유혹이 생깁니다. 그리고 체스를 두는 에이전트는 대개 무난한 체스를 둘 것입니다. 하지만 “대개”와 “무난한”은 고객이 보험사에서 사는 것이 아닙니다.
산술은 가차 없습니다. 어떤 에이전트가 20단계 프로세스의 각 단계를 95퍼센트의 확률로 올바르게 수행한다고 해 봅시다. 이는 매우 좋은 수치일 것입니다. 스무 단계가 모두 옳을 확률은 0.95의 20제곱, 약 36퍼센트입니다. 단계당 99퍼센트라면 약 82퍼센트입니다. 결정론적 워크플로에는 결정론적인 단계에 관한 한 이런 문제가 없습니다. 그렇기 때문에 유용한 질문은 결코 프로세스 전체를 두고 “에이전트냐 워크플로냐”를 묻는 것이 아니라, 어떤 단계에 판단이 필요하고 어떤 단계에는 필요하지 않은가를 묻는 것입니다.
그리고 설명의 문제가 있습니다. 에이전트의 대화 기록(transcript)은 에이전트가 무엇을 생각하고 있다고 말했는지를 보여 주며, 이는 유용합니다. 하지만 그 추론은 아무도 읽을 수 없는 가중치에서 나옵니다. 에이전트가 무엇을 말했는지는 살펴볼 수 있습니다. 왜 그랬는지는 살펴볼 수 없고, 내일도 같은 말을 할지 확신할 수도 없습니다. 고객도, 감사인도, 규제 당국도 같은 질문에 같은 답을 기대하는 닫힌 게임에서는 그것만으로는 충분하지 않습니다.
## 모든 것은 언제나 오케스트레이터였습니다 {#everything-was-always-an-orchestrator}
저는 직업 생활의 대부분을 이런저런 종류의 오케스트레이션 계층에서 보냈습니다. 돌아보면 그 각각은 무언가를 하나 더 결정론적으로 만들어, 그 위의 사람들이 더는 그것을 걱정하지 않아도 되게 하는 방법이었습니다. [Alfred North Whitehead(앨프리드 노스 화이트헤드)](https://en.wikipedia.org/wiki/Alfred_North_Whitehead)는 1911년 『수학 입문』(*An Introduction to Mathematics*)에서 그 일반 원리를 한 문장으로 표현했습니다. “문명은 우리가 생각하지 않고도 수행할 수 있는 중요한 작업의 수를 늘려 감으로써 진보한다.” 모든 오케스트레이터는 화이트헤드의 문장을 위한 기계입니다.
| 계층 | 작업 단위 | 결정론적으로 만든 것 | 불확실성이 옮겨 간 곳 |
|---|---|---|---|
| 모놀리스 | 함수 호출 | 하나의 프로세스 안의 제어 흐름 | 인터페이스, 타입, ABI로 묶인 코드 안으로 |
| 마이크로서비스 | 서비스 | 소유권과 배포의 경계 | 서비스 사이의 네트워크로 |
| Kubernetes, Nomad | 컨테이너, 잡 | 배치, 재시작, 원하는 상태 | 조정 루프(reconciliation loop)와 설정으로 |
| WebAssembly 함수 플랫폼 | 함수 | 아주 작은 단위의 격리와 이식성 | 함수들을 조합하는 방식으로 |
| 워크플로 엔진 | 단계 | 프로세스의 순서, 지속성, 이력 | 두 번 이상 실행될 수 있는 단계 본문으로 |
| microVM 위의 에이전트 런타임 | 작업 | 샌드박스, 그 밖에는 거의 없음 | 모델 안으로 |
저는 한때 [Nomad](https://www.nomadproject.io/)를 무척 좋아했습니다. 추상화를 아주 분명하게 만들었기 때문입니다. 잡을 기술하면 스케줄러가 그대로 만들어 줍니다. [Kubernetes](https://kubernetes.io/)는 같은 일을 더 많은 격식과 함께 했습니다. WebAssembly 플랫폼들은 이 생각을 더 밀고 나갔습니다. 저는 [wasmCloud](https://wasmcloud.com/)를 가까이서 지켜보았는데, wasmCloud는 애플리케이션이란 이식 가능한 형식으로 컴파일되어 자리가 있는 곳 어디에든 배치되는 작은 함수들일 뿐이라고 제안했습니다. 이 계층들은 하나같이 복잡성을 제거한 것이 아니라 옮겼습니다. [마이크로서비스](https://en.wikipedia.org/wiki/Microservices)는 시스템을 더 단순하게 만들지 않았습니다. 어려운 부분을 하나의 프로그램 안의 인터페이스에서 여러 프로그램 사이의 네트워크로 옮겼을 뿐이고, 그래서 우리는 그 뒤에 서비스 메시와 트레이싱, 그리고 [로깅 이상의 관측 가능성](https://raskell.io/articles/observability-is-not-logging/)을 필요로 하게 되었습니다.
이 표를 프랙털로 읽어 보십시오. 모든 행은 한 단계 위의 규모에서 같은 움직임을 합니다. 아래 수준에서 불확실했던 것을 받아 예측 가능하게 만들고, 그 위의 사람들이 그것에 대해 생각하기를 멈추게 합니다. 그리고 모든 행은 자리를 잡고 나면 보이지 않게 되었습니다. 이제 함수 호출에 대해 생각하는 사람은 없고, 자기 컨테이너가 어느 머신에서 도는지 생각하는 사람도 드물며, 몇 년 뒤에는 자기 소프트웨어 밑에 있는 지속형 워크플로에 대해 생각하는 사람도 거의 없을 것입니다. 그것이 토마셀로의 래칫이자 동시에 화이트헤드의 문장입니다.
마지막 행은 종류가 다릅니다. 최근 저는 대형 컨설팅 회사 한 곳이 내부에서 에이전트를 어떻게 운영하는지 설명하는 발표를 끝까지 들었습니다. 안전한 microVM을 위한 Kubernetes 비슷한 오케스트레이터가 있고, 각 microVM은 코딩 에이전트 하네스를 실행하며, 맡길 직무나 작업, 또는 채워야 할 자리를 설명하는 Markdown 컨텍스트를 공급받습니다. 좋은 발표였고, 제가 직접 만들어 온 것들과도 가까웠습니다. [Kage](https://github.com/raskell-io/kage)는 에이전트 작업을 위한 로컬 우선 오케스트레이터였습니다. Shiioo는 [두 번째 형태](https://raskell.io/articles/shiioo-reimagined-and-a-home-ai-lab/)에서 에이전트들로 이루어진 작은 가상 회사를 운영하며, 그들이 혼자서 무엇을 해도 되는지는 규칙 파일이 정합니다. 그리고 [조직도를 가진 열여섯 에이전트](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/) 뒤에 있던 실험은 그것이 얼마나 빨리 복잡해지는지를 제게 가르쳐 주었습니다. 또 [에이전트는 루트 권한을 원합니다](https://raskell.io/articles/your-agent-wants-root/)를 쓰며 알게 되었듯이, 그런 런타임을 그저 가두어 두는 데에만도 얼마나 많은 일이 드는지 압니다.
앞선 모든 계층은 불확실한 무언가를 받아 예측 가능하게 만들어서, 위의 계층이 생각 없이 그것에 기댈 수 있게 했습니다. 모든 것을 위한 에이전트 오케스트레이터는 그 반대를 합니다. 기업들이 수십 년에 걸쳐 절차로 바꿔 놓은 일을 받아서, 즉흥으로 움직이는 무언가에게 되돌려줍니다. 열린 문제에 대해서는 그것이 정확히 옳습니다. 닫힌 문제에 대해서는 그 기업들이 실제로 파는 단 하나를 내주는 셈이고, 화이트헤드의 문장을 거꾸로 돌리는 셈입니다. 생각이 필요한 작업의 수를 늘리는 것입니다.
그렇다면 모든 것을 위한 에이전트 오케스트레이터를 만들어야 할까요? 저는 회의적입니다. 본질적으로 결정론적인 거대한 문제 공간은 언제나 존재할 것입니다. 확립된 프로세스가 만들어 내는 신뢰는 그 자체로 가치가 있기 때문입니다.
## 탐색과 활용 {#exploration-and-exploitation}
에이전트가 모든 것에 대한 답은 아니더라도 새로운 무언가에 대한 답이기는 하며, 조직 이론에는 그것을 가리키는 이름이 있습니다. 1991년 James March(제임스 마치)는 이 분야에서 가장 많이 인용되는 논문 가운데 하나인 [“Exploration and Exploitation in Organizational Learning”](https://doi.org/10.1287/orsc.2.1.71)(조직 학습에서의 탐색과 활용)을 발표했습니다. 탐색은 새로운 가능성의 추구입니다. 실험, 변이, 위험이 여기에 속합니다. 활용은 이미 아는 것의 정련입니다. 효율, 실행, 신뢰성이 여기에 속합니다. 모든 조직에는 둘 다 필요하고, 둘은 같은 희소한 자원을 두고 다툽니다. 마치의 경고는, 탐색보다 활용을 더 빨리 정련하는 적응 과정은 단기적으로는 효과적으로 보이지만 장기적으로는 스스로를 파괴하는 경향이 있다는 것이었습니다. 조직은 활용 쪽으로 표류합니다. 활용의 보상이 더 가깝고, 더 확실하며, 더 측정하기 쉽기 때문입니다.
[같은 트레이드오프](https://en.wikipedia.org/wiki/Exploration%E2%80%93exploitation_dilemma)가 DeepMind 자신의 분야인 [강화 학습](https://en.wikipedia.org/wiki/Reinforcement_learning)의 핵심에 놓여 있습니다. 이미 아는 것만 활용하는 에이전트는 더 나은 전략을 결코 찾지 못하고, 탐색만 하는 에이전트는 결코 보상을 거두지 못합니다. AlphaGo와 AlphaStar는 여러 면에서 이 딜레마에 대한 매우 정교한 답이기도 합니다. 이 트레이드오프 역시 프랙털입니다. 새 명령을 시도할지 정하는 하나의 에이전트 안에서, 다시 쓸지 고칠지 정하는 팀 안에서, 새 제품을 만들지 정하는 회사 안에서, 그리고 게임에 걸지 언어에 걸지 정하는 업계 안에서 나타납니다.
에이전트는 탐색의 가격을 바꿉니다. 역사의 대부분 동안 탐색은 비쌌습니다. 숙련된 사람과 시간, 그리고 실패에 대한 관용이 필요했고, 그래서 마치가 말한 조직들은 탐색에서 멀어져 갔습니다. 언어 에이전트는 기호 세계에서의 탐색을 저렴하게 만듭니다. 에이전트는 하룻밤 사이에 낯선 연동 작업에 열 가지 접근을 시도해 보거나, 규제 변경에 관한 모든 문서를 읽거나, 어떤 절차도 다루지 않는 특이한 사례들이 밀린 목록을 처리할 수 있습니다. 한편 활용은 언제나 결정론적 기계가 잘하는 일이었습니다.
이는 어느 쪽도 혼자서는 이루지 못하는 분업을 시사합니다. 에이전트는 탐색하고, 워크플로는 활용합니다. 설계의 질문은 그 둘 사이의 인터페이스입니다. 에이전트가 탐색으로 배운 것이 어떻게 워크플로가 활용할 수 있는 무언가가 되는지, 그리고 더는 작동하지 않는 워크플로가 어떻게 탐색으로 되돌려지는지입니다.
## 루틴은 회사의 기억입니다 {#routines-are-the-memory-of-a-company}
Richard Nelson(리처드 넬슨)과 [Sidney Winter(시드니 윈터)](https://en.wikipedia.org/wiki/Sidney_G._Winter)는 1982년, [진화 경제학](https://en.wikipedia.org/wiki/Evolutionary_economics)의 기초가 된 저작인 『경제 변동의 진화 이론』(*An Evolutionary Theory of Economic Change*)에서 그 질문의 일부에 답했습니다. 그들은 기업의 행동은 그 **루틴**, 곧 기업이 일을 하는 규칙적이고 예측 가능한 패턴을 통해 가장 잘 이해된다고 주장했습니다. 루틴은 생물학에서 유전자가 하는 역할을 조직 안에서 합니다. 루틴은 조직의 기억이고, 조직이 한 해에서 다음 해로 자신의 행동을 재생산하는 방식이며, 경제적 변화는 새로운 루틴의 탐색과 그 가운데에서의 선택을 통해 일어납니다.
넬슨과 윈터도 알았듯이, 루틴의 약점은 루틴이 사는 곳에 있습니다. 한 조직의 루틴 대부분은 그것을 수행하는 사람들의 머릿속에 있습니다. 일부는 절차서와 매뉴얼에 적혀 있지만, 대부분은 그렇지 않습니다. 저는 [IT Intelligence](https://raskell.io/articles/it-intelligence/)에서 이것을 부족 지식(tribal knowledge)이라는 이름으로 다룬 적이 있습니다. 아무도 적어 두지 않은 명시적 지식, 그리고 어쩌면 아무도 적을 수 없는 암묵적 지식입니다.
워크플로 엔진은 루틴이 사는 곳을 바꿉니다. 워크플로로 인코딩된 루틴은 더 이상 사람들이 해야 할 일에 대한 설명이 아닙니다. 그것은 그 일을 실제로 하는 주체이고, 모든 실행은 정확히 무슨 일이 일어났는지를 담은 저널을 남깁니다. 조직의 기억은 실행 가능해지는 동시에 들여다볼 수 있게 됩니다. 이는 회사가 인터뷰와 워크숍에서 자신의 루틴을 발견하는 대신, 그것을 읽고, 비교하고, 과거 사례에 대해 시험하고, 의도적으로 바꿀 수 있다는 뜻입니다.
최근까지 빠져 있던 것은 그 앞 단계였습니다. 루틴을 워크플로로 바꾸려면 사람 분석가와 개발자, 그리고 긴 프로젝트가 필요했습니다. Ikujiro Nonaka(노나카 이쿠지로)와 Hirotaka Takeuchi(다케우치 히로타카)는 암묵적 지식에서 명시적 지식으로 넘어가는 단계를 *표출화*(externalisation)라고 불렀습니다. 그들의 [SECI 모델](https://en.wikipedia.org/wiki/SECI_model_of_knowledge_dimensions)의 일부이며, 이 단계는 언제나 조직 학습에서 느리고 비싼 부분이었습니다. 이제 에이전트가 그 단계를 밟을 수 있습니다. 지켜보고, 탐색하고, 시도하고, 적어 둘 수 있습니다.
## 바닷속 공장 {#the-factory-under-the-sea}
여기서 잠시 옆길로 새겠습니다. 제가 인터넷을 어떻게 읽는지에 대해 무언가를 말해 주는 옆길입니다.
저는 4chan을 읽고, UFO학도 읽습니다. 다른 사람들이 SF를 읽는 것과 대략 같은 마음으로 읽습니다. 보고서로서가 아니라, 기묘하고 때로는 훌륭한 사고 실험의 원천으로서 읽습니다. UFOAnon이라는 이름으로 알려진 익명의 작성자가 언젠가 비인간 비행체가 지구 주변에서 어떻게 운용되는지 설명한다고 주장하는 [긴 스레드](https://imgur.com/a/4chan-whistleblower-NXjWQaN)를 쓴 적이 있습니다. 그 대부분을 저는 픽션으로 분류합니다. 그런데 그중 한 장면이 제 머릿속에 남았습니다. 공학적 상상력의 산물로서 너무나 훌륭하기 때문입니다.
이야기 속에는 바닷속 공장이 있습니다. 그 공장은 함대를 보관하지 않습니다. 필요할 때마다 비행체를 만드는데, 하나하나가 단 하나의 임무를 위해 설계됩니다. 채굴용, 운송용, 생물을 실어 나르는 용도, 관광 비슷한 무언가를 위한 용도가 따로 있습니다. 비행체는 자기 임무에 맞게 만들어지고, 그 임무를 수행하고, 돌아와서 해체됩니다. 필요하지 않은 것은 아무것도 남겨 두지 않습니다. 영구적인 것은 공장 자체뿐입니다.
출처를 어떻게 생각하든, 그 설계는 설득력이 있습니다. 그 이유는 외계인과는 아무 관계도 없습니다. 그것은 물건을 만드는 일이 사실상 공짜가 된 문명이 지을 법한 것입니다. 제작에 비용이 들지 않는다면, 여러 일을 서툴게 해내는 범용 기계를 유지하기를 멈추고, 한 가지 일을 잘 해낸 뒤 사라지는 특수 목적 기계를 만들기 시작합니다. SF에는 그런 상태를 가리키는 이름이 있습니다. [탈희소성(post-scarcity)](https://raskell.io/tags/post-scarcity/)입니다. 그 가장 잘 알려진 초상은 Iain M. Banks(이언 M. 뱅크스)의 [컬처(Culture)](https://en.wikipedia.org/wiki/The_Culture) 시리즈인데, 맬러비에 따르면 허사비스가 그 시리즈를 읽으며 자랐습니다.
이 생각에는 점잖은 혈통도 있습니다. 1940년대에 John von Neumann(존 폰 노이만)은 종이 위에서 [범용 생성자](https://en.wikipedia.org/wiki/Von_Neumann_universal_constructor)(universal constructor)를 설계했습니다. [세포 자동자](https://en.wikipedia.org/wiki/Cellular_automaton) 안의 기계로, 어떤 기계든 그 기계에 대한 기술(description)로부터 만들어 낼 수 있었고, 자기 자신의 사본도 만들 수 있었습니다. 그의 설계는 세 부분으로 이루어져 있었습니다. 청사진인 **기술**, 기술이 말하는 것은 무엇이든 만드는 **생성자**, 그리고 기술을 복제하는 **복사기**입니다. Arthur Burks(아서 버크스)는 폰 노이만이 세상을 떠난 뒤인 1966년에 이 작업을 완성해 『자기 증식 오토마타 이론』(*Theory of Self-Reproducing Automata*)으로 출간했습니다. 이 분리가 중요합니다. 기술이 그것을 실행하는 기계 장치와 분리되어 있기 때문에, 생성자가 그대로인 채로 기술은 바뀌고, 쌓이고, 진화할 수 있습니다.
소프트웨어는 수십 년 동안 그런 세계에서 살아왔습니다. 프로그램이나 컨테이너 이미지나 컴파일된 바이너리를 복사하는 데는 거의 비용이 들지 않고, 그래서 우리는 이미 개별 산출물이 아니라 공장과 템플릿과 패턴으로 생각합니다. 객체 지향 설계의 [팩토리](https://en.wikipedia.org/wiki/Factory_method_pattern) 패턴과 [전략](https://en.wikipedia.org/wiki/Strategy_pattern) 패턴은 같은 생각의 작고 일상적인 판본입니다.
제가 생각하기에 그것이 이 이야기가 저를 설득하는 가장 깊은 이유입니다. 그것은 프랙털입니다. 소스 코드의 팩토리 패턴, 곧 다른 객체를 만드는 것이 일인 객체는 자동차를 만드는 공장과 같은 생각이고, 그것은 다시 필요에 따라 비행체나 다른 공장을 만드는 공장과 같은 생각입니다. 폰 노이만의 생성자는 추상화 한 단계 위에서 또다시 같은 생각입니다. 서너 개의 규모에서 성립하는 패턴은 우연인 경우가 드뭅니다. 대개는 세계가 어떻게 짜여 있는지에 관해 무언가를 찾아냈다는 뜻입니다. 2026년에 바뀐 것은 공장이 이제 생각할 수 있다는 점입니다. 공장은 기술을 스스로 쓸 수 있습니다.
## 메타 공장 {#the-meta-factory}
조각들을 맞춰 보겠습니다. 에이전트는 탐험가입니다. 안개 속에서, 아무도 풀어 본 적 없는 문제들 사이로 길을 찾을 때 가장 빛납니다. 워크플로는 루틴입니다. 알려진 땅 위에서 매번 같은 일을 하며 누구나 읽을 수 있는 이력을 남길 때 가장 빛납니다. 둘 중 하나를 고르는 것이 실수입니다. 더 나은 설계는 둘을 연결해서, 탐험가가 찾아낸 것이 루틴이 되게 합니다.
*The meta-factory*
```text
┌──────────────────────────────┐
│ the rugged world: │
│ open, foggy, changing │
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ an agent explores │ trial and error, at runtime
└───────────────┬──────────────┘
│ a path is found, and it will be needed again
▼
┌──────────────────────────────┐
│ the agent writes a workflow │ typed, validated, simulated
│ │ against past cases, reviewed
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ a deterministic engine │ journaled, replayable, auditable;
│ runs it │ may contain bounded agent steps
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ observe │ exceptions, drift, new fog
└───────┬──────────────┬───────┘
▼ ▼
repaired retired
by an agent when the mission is over
```
폰 노이만의 용어로 말하면, 워크플로 정의는 기술이고, 엔진은 생성자이며, 버전 관리는 복사기입니다. 그 이야기의 용어로 말하면, 에이전트는 바닷속 공장이고 워크플로는 그 공장의 비행체입니다.
새로운 종류의 보험금 청구, 새로운 규제 보고서, 새로운 연동을 마주하면, 에이전트는 유능한 사람이라면 누구나 그러듯 그것을 어떻게 할지 알아냅니다. 일회성 작업이라면 그것으로 끝입니다. 다시 생길 일이라면, 에이전트는 좋은 직원이 무언가를 세 번째로 해결한 뒤에 하는 일을 합니다. 절차를 적어 둡니다. 여기서 적어 둔다는 것은 결정론적 엔진을 위한 워크플로 정의를 만든다는 뜻입니다. 검증할 수 있고, 과거 사례에 대해 시뮬레이션할 수 있고, 사람이 검토할 수 있으며, 버전을 매길 수 있는 정의입니다. 그때부터 그 절차는 엔진 위에서 매번 같은 방식으로 돌아가고, 모든 실행은 정확히 무슨 일이 일어났는지 보여 주는 저널을 남깁니다. 세상이 바뀌어 워크플로가 예외를 내기 시작하면, 에이전트가 조사하고 수리를 제안합니다. 임무가 끝나면 워크플로는 해체되기 위해 돌아오는 비행체처럼 폐기됩니다.
이것을 도식 이상의 것으로 만드는 세부가 두 가지 있습니다.
첫째, 워크플로는 자신의 형태를 포기하지 않고도 판단을 담을 수 있습니다. 어떤 단계에는 정말로 에이전트가 필요합니다. 구조화되지 않은 문서를 읽거나, 편지 초안을 쓰거나, 특이한 사례가 어떤 규칙에 들어맞는지 판단하는 일이 그렇습니다. 그런 단계는 워크플로 안의 에이전트 호출이 될 수 있고, 그 입력과 출력은 저널에 기록되며 범위는 제한됩니다. 저는 그것을 운하의 [갑문](https://en.wikipedia.org/wiki/Lock_(water_navigation))으로 생각합니다. 다른 곳에서는 곧게 흐르는 수로 안에서, 물이 오르내리도록 허락된 통제된 지점입니다. 앞에서 본 산술이 이것이 왜 중요한지 설명해 줍니다. 범위가 정해진 에이전트 단계 둘과 결정론적 단계 열여덟으로 이루어진 20단계 프로세스는 에이전트 단계 스물이 연달아 이어지는 것보다 훨씬 덜 실패하고, 실패하더라도 어느 갑문에서 물이 샜는지 알 수 있습니다.
둘째, 이것은 조직에 관한 가장 오래된 생각을 새로운 종류의 일꾼에게 적용한 것입니다. 사람은 거의 무엇이든 할 수 있습니다. 그것이 사람을 가치 있게 만들고, 또 믿고 맡기기 어렵게 만듭니다. 회사들은 언제나 같은 방식으로 대응해 왔습니다. 프로세스, 위계, 지침, 체크리스트, 교육입니다. 일이 반복 가능한 곳에서는 유능한 사람들의 즉흥을 절차로 바꾸었고, 그렇지 않은 곳에는 판단의 여지를 남겼습니다. 오늘날 회사들은 정책과 가드레일과 거버넌스 프레임워크로 에이전트를 가두려 하고 있는데, 이는 어휘만 다를 뿐 같은 움직임입니다. 메타 공장은 그것을 한 걸음 더 밀고 나갑니다. 에이전트가 하면 안 되는 일에 대한 규칙만으로 에이전트를 가두는 대신, 에이전트가 잘하는 일인 탐색을 하게 두고, 그 결과를 다른 일, 곧 반복을 잘하는 기계에게 넘기게 합니다.
### 모든 규모에서 같은 루프 {#the-same-loop-at-every-scale}
메타 공장은 모든 규모에서 되풀이되는 하나의 루프입니다. 절차는 에이전트가 탐색하는 갑문을 담고, 그 에이전트는 스스로 작은 절차를 실행할 수 있으며, 절차들은 더 큰 절차로 조합됩니다. 그리고 충분히 멀리서 보면, 하나의 부서는 회사가 한때 탐색을 거쳐 들어서게 된 절차입니다.
| 규모 | 무엇이 탐색하는가 | 무엇이 결정화되는가 |
|---|---|---|
| 단일 단계 | 특이한 문서 하나를 읽는 에이전트 | 저널에 기록된 하나의 답 |
| 절차 | 절차가 다루지 못하는 사례를 처리하는 에이전트 | 새로운 규칙이나 분기 |
| 부서 | 새로운 종류의 일을 처리하는 에이전트와 사람 | 새로운 절차 |
| 회사 | 새로운 시장을 시험하는 사람과 에이전트 | 새로운 제품과 부서 |
| 산업 | 서로 경쟁하는 회사들 | 표준, 규제, 공유 인프라 |
모든 행에서 같은 동사가 통합니다. 탐색하고, 결정화하고, 실행하고, 관찰하고, 수리하고, 폐기합니다. 그것이 이것을 구호가 아니라 설계로 만듭니다. 한 규모에서 이 루프를 지원하는 엔진은, 워크플로가 에이전트를 담을 수 있고 에이전트가 워크플로를 시작할 수 있는 한, 모든 규모에서 이 루프를 지원합니다.
### 빚어낸 절차의 모습 {#what-a-crafted-procedure-looks-like}
어떤 보험사의 보상 에이전트들이 고객의 사진이 없거나 쓸 수 없는 누수 피해 청구를 계속 마주친다고 해 봅시다. 그런 사례 수십 건을 직접 처리하고 나서, 한 에이전트가 절차를 제안합니다. 그것은 이런 모습일 수 있습니다.
```python
# procedures/claims/water_damage_photo_evidence.star (illustrative)
PROCEDURE = {
"name": "claims/water-damage-photo-evidence",
"version": 3,
"origin": {"explored_by": "agent/claims-explorer", "cases_studied": 37},
}
# Approval and replay evidence travel with the file, in a signed record:
# replayed against 412 closed claims, 0 divergences from human outcomes;
# approved by the claims process owner on 2026-10-12.
def run(claim):
docs = agent("classify_documents", claim["documents"], # a lock: bounded judgement, journaled
prompt = "prompts/classify-documents.md",
output_schema = "DocumentClassification",
budget_tokens = 20000)
coverage = step("coverage.water_damage@v7", claim)
if docs["missing_photos"]:
step("notify.customer", {"template": "claims/missing-photos", "to": claim["customer"]})
photos = wait(signal("photos_received"), timeout = days(14))
if photos == None:
escalate("no-photos", claim)
if claim["amount"] > 5000 or docs["confidence"] < 0.8:
escalate("manual-review", claim)
return call("claims/settle@v2", claim, coverage)
```
이것은 [Starlark](https://github.com/bazelbuild/starlark)로 쓰여 있습니다. 매번 같은 답을 내야 하는 빌드 시스템을 위해 만들어진 Python의 작은 방언입니다. 그 인터프리터에는 시계도, 난수도, 네트워크도, 파일도 없습니다. 스크립트가 세계에 닿을 수 있는 유일한 길은 엔진의 함수를 통하는 것이고, 그 호출 하나하나가 저널에 기록됩니다. 그래서 엔진은 그것을 정확히 재실행할 수 있고, 사람은 여전히 1분 안에 그것을 읽을 수 있습니다.
메타 공장의 중요한 속성은 모두 그 몇 줄 안에 보입니다. 절차는 자신이 어디서 왔는지 기록합니다. 어느 에이전트가 탐색했는지, 몇 건의 사례를 살폈는지, 누가 승인했는지입니다. 누군가 그것을 신뢰하기 전에 그것은 수백 건의 종결된 청구에 대해 재실행되었습니다. 모델이 판단하도록 허락된 곳은 정확히 한 군데이고, 그곳에는 예산과 답의 스키마가 있습니다. 나머지는 모두 단계, 메시지, 대기이며, 결정론적 엔진이 매번 같은 방식으로 실행합니다. 그리고 버전 번호가 있으므로 교체하고, 비교하고, 폐기할 수 있습니다.
## 현장 안내서 {#a-field-guide}
철학은 결정을 바꿀 때에만 쓸모가 있습니다. 에이전트와 워크플로 엔진을 갖추고 둘 다 잘 쓰고 싶은 회사라면, 저는 이렇게 적용하겠습니다.
### 언제 일을 에이전트에게 맡기고, 언제 결정화할 것인가 {#when-to-leave-work-to-an-agent-and-when-to-crystallise-it}
| 신호 | 에이전트에게 맡긴다 | 워크플로로 결정화한다 |
|---|---|---|
| 빈도 | 한 번, 또는 드물게 | 매주 또는 그보다 자주 |
| 사례 간 편차 | 큼: 사례마다 다름 | 작음: 사례들의 형태가 같음 |
| 잘못된 결과의 대가 | 낮음, 되돌릴 수 있음 | 높음, 고객과 직접 닿음, 규제 대상 |
| 사후 설명의 필요 | 있으면 좋음 | 필수: 감사인, 규제 당국, 법원, 고객 |
| 실행당 비용 | 일회성으로는 감수할 만함 | 수천 번 실행하면 쌓임 |
| 지형의 안정성 | 달마다 바뀜 | 여러 분기 동안 안정적 |
어느 한 행이 결정하지는 않습니다. 드물지만 걸린 것이 매우 큰 사례에는 그래도 절차가 어울릴 수 있고, 잦지만 편차가 극심한 사례에는 탄탄한 체크리스트를 갖춘 에이전트가 더 나을 수 있습니다. 하지만 대부분의 행이 오른쪽을 가리킨다면, 에이전트가 매번 그 일을 하는 것은 워크플로가 없애 줄 수 있는 비용이자 위험입니다.
### 빚어낸 절차의 생애 주기 {#the-lifecycle-of-a-crafted-procedure}
1. **탐색.** 에이전트가 새로운 종류의 일을 직접 처리하고, 사람이 결과를 검토합니다. 모든 사례는 재실행할 수 있을 만큼의 맥락과 함께 기록됩니다.
2. **제안.** 패턴이 되풀이되면, 에이전트가 자신이 처리한 사례들로부터 워크플로 정의의 초안을 쓰고, 여전히 판단이 필요한 단계를 표시합니다.
3. **증명.** 초안을 과거 사례에 대해 재실행합니다. 초안이 사람이나 에이전트가 이전에 한 것과 갈라지는 곳에서는, 그 차이를 설명하거나 초안을 고칩니다.
4. **승인.** 그 프로세스를 책임지는, 이름이 특정된 사람이 승인합니다. 승인은 위의 예에서처럼 절차 자체 안에 기록됩니다.
5. **실행.** 엔진이 그것을 결정론적으로 실행합니다. 그 안의 에이전트 단계는 예산과 출력 스키마로 제한됩니다.
6. **관찰.** 예외, 에스컬레이션, 타임아웃, 실행당 비용을 절차별, 버전별로 추적합니다.
7. **수리 또는 폐기.** 예외가 늘어나면 절차는 조사를 위해 에이전트에게 돌아갑니다. 일이 사라지면 절차는 폐기되고, 그 이력은 보존됩니다.
### 무엇을 측정할 것인가 {#what-to-measure}
- **결정화율:** 한 분기 동안 반복되는 일 가운데 얼마나 많은 부분이 에이전트에서 절차로 옮겨 갔는가.
- **절차별 예외율:** 에스컬레이션되는 실행의 비율. 예외가 늘어나는 것은 지형이 바뀌었다는 가장 이른 신호입니다.
- **재실행 시의 차이:** 절차가 바뀌었을 때, 과거 사례 가운데 몇 건을 이제 다르게 처리하게 되는가.
- **실행당 비용:** 토큰과 컴퓨팅 비용을 에이전트만 쓰는 대안과 비교한 것.
- **수리까지 걸리는 시간:** 실패하는 절차가 에이전트와 사람이 고칠 때까지 얼마나 오래 고장 난 채로 있는가.
- **폐기율:** 더 이상 아무도 실행하지 않는 절차. 아무것도 폐기하지 않는 회사는 좀비를 쌓아 가고 있는 것입니다.
### 규제 당국이 이것을 반길 이유 {#why-regulators-will-like-it}
규제 산업에서 이 설계는 감독 당국이 향하고 있는 방향이기도 합니다. [EU AI 법은](https://artificialintelligenceact.eu/article/12/) 고위험 AI 시스템이 그 수명 동안 이벤트를 자동으로 기록할 수 있도록 기술적으로 뒷받침해야 하며, 배포자가 그 로그를 보관해야 한다고 요구합니다. 워크플로 엔진은 그 기록을 구조상 만들어 냅니다. 모든 단계, 모든 입력, 모든 에이전트 호출과 그 답이 순서대로 남고, 재실행할 수 있습니다. 자유롭게 일하는 에이전트는 대화 기록을 남기는데, 이는 없는 것보다는 낫지만 감사하고, 비교하고, 재현하기가 훨씬 어렵습니다. 에이전트를 절차로 감싸는 것은 규제 대상 업무가 이미 요구하는 종류의 추적 가능성에 이르는 가장 저렴한 길입니다.
### 실패하는 방식 {#how-it-fails}
- **섣부른 결정화.** 지형을 이해하기도 전에 무언가를 절차로 바꾸는 것으로, 깨지기 쉬운 워크플로와 끝없는 예외를 낳습니다. 표의 왼쪽 아래 칸입니다.
- **좀비 절차.** 아무도 소유하거나 이해하지 못하는데도, 아무도 감히 폐기하지 못해서 여전히 돌아가는 워크플로.
- **갑문 안에서의 에이전트 표류.** 모델 업데이트가 범위가 정해진 에이전트 단계의 동작을 바꿉니다. 과거 사례에 대한 재실행이 방어책이며, 이 재실행은 절차가 바뀔 때만이 아니라 모델이 바뀔 때마다 돌아가야 합니다.
- **도장만 찍는 승인.** 에이전트가 쓴 절차를 읽지도 않고 승인하는 사람들. 승인이 의미를 가지려면 절차가 충분히 짧고 읽기 쉬워야 합니다.
- **지표에 작용하는 [굿하트의 법칙](https://en.wikipedia.org/wiki/Goodhart%27s_law).** 에이전트에게 남겨 두었어야 할 것들까지 결정화해서 결정화율을 최적화하는 것.
## 운하와 그 경고 {#the-canal-and-its-warning}
인간은 언제나 풍경에 이런 일을 해 왔습니다. 그레슬의 사진 속 강을 보고 나서 아무 도시나 보십시오. 우리는 정육면체, 구, 직선, 직각처럼 지형에서는 결코 나타나지 않는 형태를 짓습니다. 그것들이 하나의 관념에 봉사하기 때문입니다. 운하는 무엇을 하라는 지시를 받은 강입니다. 운하는 시간표에 따라 바지선을 실어 나르는데, 산속의 강은 결코 그러지 않을 것입니다.
망델브로의 용어로 말하면 운하는 [유클리드적](https://en.wikipedia.org/wiki/Euclidean_geometry)이고 강은 프랙털입니다. Euclid(유클리드)는 우리에게 직선과 평면과 매끄러운 곡선을 주는데, 이것들은 짓고, 재고, 믿기 쉽습니다. 자연은 우리에게 모든 규모의 거칠음을 주고, 정보의 대부분은 그 거칠음 속에 있습니다. 회사에는 두 기하학이 모두 필요하며, 매끄러운 쪽이 거친 쪽을 대체할 수 있다고 믿을 때 일이 틀어집니다.
여기에는 경고가 하나 있고, 저는 그것을 James C. Scott(제임스 C. 스콧)의 [『국가처럼 보기』(*Seeing Like a State*)](https://en.wikipedia.org/wiki/Seeing_Like_a_State)에서 가져옵니다. [IT Intelligence](https://raskell.io/articles/it-intelligence/)에서도 기댔던 책입니다. 스콧은 계획된 숲에서 계획된 도시에 이르기까지, 복잡한 시스템에 읽기 쉬운 질서를 부과하는 계획들이 원래의 시스템을 작동하게 했던 실천적 지식을 파괴하는 경향이 있음을 보여 줍니다. 그는 그 지식을 *메티스*(mētis)라고 부릅니다. 특정한 한 항구를 아는 도선사, 특정한 한 밭을 아는 농부의 솜씨입니다. 모든 강을 운하로 만들면 강이 하는 일을 잃습니다. 범람원, 물고기, 그리고 어떤 엔지니어도 그리지 않았을 물길들입니다.
베버는 관료제 안쪽에서 같은 위험을 보았습니다. 관료제를 믿을 만하게 만드는 계산 가능성은, 절차적 올바름이 실질적 정의를 이길 때 관료제를 비인간적으로 만들 수도 있습니다. 그 종착점을 가리키는 그의 이미지, 흔히 [쇠우리(iron cage)](https://en.wikipedia.org/wiki/Iron_cage)로 번역되는 표현은 그의 다른 문구 대부분보다 오래 살아남았습니다. 마치는 그것을 학습의 측면에서 보았습니다. 활용만 하는 조직은 작년의 문제에 매우 능숙해진 뒤에 실패합니다.
메타 공장은 세 가지 경고를 모두 존중해야 합니다. 모든 것이 워크플로가 되어야 하는 것은 아닙니다. 가장자리에서 탐색하는 에이전트는 모든 것이 자동화되기 전의 한 단계가 아니라 그림의 영구적인 일부입니다. 안개는 결코 완전히 걷히지 않기 때문입니다. 그리고 메티스를 지닌 사람들은 절차로 대체되지 않습니다. 그들의 역할이 바뀝니다. 무엇이 절차가 될 만한지 결정하고, 에이전트가 제안하는 것을 읽고 승인하며, 강이 움직였을 때 그것을 알아차리는 사람이 됩니다.
제가 추구하는 균형은 곁에 여전히 야생의 강이 흐르는 운하망이며, 언제 새 운하를 파고 언제 옛 운하를 메울지 아는 사람들과 에이전트들이 함께하는 모습입니다.
## 조직에 주는 의미 {#what-this-means-for-organisations}
이 그림이 옳다면, 주로 기호 세계에 사는 회사들, 곧 대부분의 회사에 몇 가지가 따라 나옵니다.
**프로세스 소유자는 편집자가 됩니다.** 오늘날 프로세스 소유자는 사람들이 무엇을 해야 하는지 설명하는 문서를 관리하고, 그것이 사람들이 실제로 하는 일과 맞기를 바랍니다. 메타 공장에서 소유자는 에이전트가 제안하는 절차를 검토하고, 버전을 승인하고, 예외 보고서를 읽고, 언제 무언가를 폐기할지 결정합니다. 이는 행정보다 편집에 가까우며, 비즈니스와 절차 언어를 모두 비판적으로 읽을 수 있을 만큼 잘 이해하는 사람이 필요합니다.
**조직도는 루틴의 집합처럼 보이기 시작합니다.** 중간 관리자가 해 온 일의 상당 부분은 루틴을 수행하는 사람들을 조율하고 예외를 처리하는 것이었습니다. 루틴이 엔진 위에서 돌아가고 예외가 먼저 에이전트에게, 그다음 사람에게 전달되면, 조율하는 계층은 줄어들고 편집하는 계층은 커집니다. 저는 같은 변화를 아키텍트의 관점에서 What the architect does now에서 다룬 적이 있습니다.
**신뢰는 사람에게서 절차로 옮겨 가고, 다시 얻어 내야 합니다.** 루만의 체계 신뢰는 언제나 절차에 대한 신뢰였습니다. 새로운 것은 이제 그 절차를 기계가 쓸 수 있다는 점입니다. 고객과 규제 당국은 출처가 보이고, 승인이 실질적이며, 이력을 재실행할 수 있을 때에만 에이전트가 쓴 절차에 체계 신뢰를 내줄 것입니다. 어떤 기술적 세부보다도, 그것이 이 생각 전체가 작동하기 위한 조건입니다.
**탐색은 예산 항목이 됩니다.** 에이전트가 탐색을 저렴하게 만든다면, 회사는 모든 부서의 가장자리에서 탐색을 계속할 여유가 생기며, 그렇게 해야 합니다. 마치가 말한 활용 쪽으로의 표류는 부분적으로 비용의 문제였습니다. 이제 그 핑계는 약해졌습니다.
## 엔진에 주는 의미 {#what-this-means-for-the-engine}
메타 공장이 옳다면, 에이전트 시대의 워크플로 엔진은 어쩌다 Rust로 쓰인 Temporal 대안이라기보다, 에이전트가 기술을 써서 건네는 생성자에 가깝습니다. 그리고 그것은 엔진이 무엇을 잘해야 하는지를 바꿉니다.
- **에이전트가 쓸 수 있고 사람이 읽을 수 있는 산출물로서의 절차.** 모델이 만들어 낼 수 있고, 스키마가 검증할 수 있고, 시뮬레이터가 과거 사례에 대해 돌려 볼 수 있으며, 사람이 한자리에서 검토할 수 있는 정의로, 그 출처를 안에 담고 있습니다.
- **증명할 수 있는 결정론.** 재실행은 충돌 이후의 복구 이상의 역할을 합니다. 감사인에게 무슨 일이 일어났는지 보여 주는 방법이고, 수리된 절차가 옛 사례에서 여전히 옛 절차처럼 동작하는지 확인하는 방법이며, 모델 업데이트가 에이전트 단계를 바꾸었는지 감지하는 방법입니다.
- **일급 개념으로서의 범위가 정해진 에이전트 단계.** 모델을 호출하고, 충돌이 나도 결코 두 번 실행되거나 두 번 과금되지 않도록 그 답 전체를 저널에 기록하고, 예산과 출력 스키마를 강제하며, 기록된 답으로 재실행할 수 있는 단계입니다.
- **일상적인 작업으로서의 탄생과 죽음.** 버전, 승인, 배포, 드레이닝, 폐기가 그렇습니다. 특정 목적으로 만든 절차는 나타났다 사라지게 되어 있기 때문입니다.
- **신호로서의 예외.** 에스컬레이션과 타임아웃은 오류인 만큼 데이터이기도 합니다. 지형이 어디서 바뀌었는지 에이전트에게 알려 줍니다.
- **어디에나 있을 만큼 작게.** 노트북의 단일 바이너리 안에 든 라이브러리로 시작해, 필요할 때 클러스터로 자랍니다. 공장은 일이 있는 곳 어디에든 비행체를 둘 수 있어야 하기 때문입니다.
### 공장이 만든 것을 검사하기 {#checking-what-the-factory-makes}
공장은 그 검사만큼만 믿을 만합니다. 에이전트가 절차를 쓰고, 머지않아 그 절차가 돌아가는 엔진과 런타임까지 쓰게 된다면, 무언가가 에이전트에 대한 신뢰에 기대지 않고 그 결과물을 확인해야 합니다. 그것이 제가 만들고 있는 또 다른 프로젝트인 [Arcanist](https://arcanist.sh/)와 그 [Basel Haskell Compiler](https://arcanist.sh/bhc/), 곧 BHC 뒤에 있는 내기입니다. 코드를 생성하는 일이 저렴해지면, 올바름은 확인 가능해야 합니다. Arcanist 사이트의 표현을 빌리면 이렇습니다. “모델이 옳을 필요는 없다. 확인 가능하기만 하면 된다.”
여기서 Haskell이 중요한 이유는 이 에세이 전체를 관통하는 이유와 같습니다. Haskell의 순수 함수는 구조상 결정론적입니다. 같은 입력이 주어지면 같은 결과를 돌려주고, 부수 효과가 있는 코드는 그것을 타입에 선언해야 합니다. 그것이 바로 지속형 실행 엔진이, 동일하게 재실행되어야 하는 워크플로 코드와 세계와 대화하는 단계 본문 사이에 그어야 하는 선입니다. Temporal 같은 엔진은 사후에 비결정성을 감지하는 방식으로 런타임에 그 선을 강제합니다. 타입 시스템은 코드가 실행되기도 전에 그 선을 강제할 수 있습니다. 아직 베타인 BHC는 같은 Haskell 소스를 서로 다른 런타임 프로필 아래에서 네이티브 코드와 WebAssembly로 컴파일하는데, 프로젝트는 각 프로필을 “당신의 코드와 그 코드가 돌아가는 런타임 사이의 계약”이라고 설명합니다. 그리고 프로젝트 자체의 측정에 따르면 243개의 테스트 프로그램 가운데 236개가 이미 WebAssembly에서 네이티브와 바이트 단위까지 똑같은 출력을 냅니다.
더 넓은 내기는 이런 컴파일러가 AI 지원 엔지니어링에서 핵심적인 도구가 될 수 있다는 것입니다. 에이전트가 코드를 쓰고, 컴파일러가 검증할 수 있는 것을 검증하며, 레지스트리가 무엇이 확인되었는지를 기록해서, 사람이든 모델이든 누구도 같은 것을 두 번 확인할 필요가 없게 합니다. 그 결과는 쓴 사람의 평판이 아닌 다른 이유로 동작을 믿을 수 있는 워크로드, 런타임, 또는 엔진입니다. 이것은 한 규모 아래에서 다시 나타난 메타 공장입니다. 에이전트가 탐색하고, 그 결과가 단단한 무언가로 결정화되며, 문 앞에는 검사관이 서 있습니다. 저는 검증 쪽에 대해서는 [한 번만 쓰면 되는 증명](https://raskell.io/articles/the-proof-you-only-have-to-write-once/)에서, 도구에 대해서는 [우리가 Rust로 Haskell 패키지 매니저를 만든 이유](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/)에서, 코드가 낮춤(lowering)의 대상이 되는 것에 대해서는 [소스 코드는 새로운 어셈블리입니다](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/)에서 썼습니다. Aqueduct의 절차는 당분간 Starlark로 쓰입니다. 인터프리터가 시계나 난수를 아예 볼 수 없는 언어입니다. 그 절차들이 언젠가 BHC 같은 컴파일러가 확인할 수 있는 언어로 쓰이게 될지는 아직 모르겠습니다. 그것이 제가 가장 궁금해하는 방향입니다.
### 이름 {#the-name}
설계 문서를 쓸 때 저는 거의 우연히 프로젝트에 가칭을 붙였습니다. *tsumugi*(紡ぎ), 날섬유를 자아 실로 만드는 일을 뜻하는 일본어입니다. 아름다운 단어였고, 저는 몇 주 동안 그 이름을 지켰습니다. 하지만 이름은 머릿속에 그림을 떠올리게 해야 하는데, 일본 밖의 대부분의 사람에게 이 이름은 그러지 못합니다. 제게 필요했던 그림은 이미 이 에세이 안에 있었습니다. 운하를 싣고 골짜기를 건너는 구조물입니다.
엔진의 이름은 **Aqueduct**(수도교)입니다.
로마인들은 먼 샘의 물을 도시로 끌어오기 위해 수도교를 지었습니다. 아무도 바꿀 수 없는 지형을 수십 킬로미터나 가로지르는 물길이었습니다. 돌 하나를 놓기 전에 누군가는 그 땅을 직접 걸으며, 물이 처음부터 끝까지 완만하게 흘러내리도록 언덕 사이로 길을 찾아내야 했습니다. 가르동강을 [퐁 뒤 가르](https://en.wikipedia.org/wiki/Pont_du_Gard)로 건너는 님(Nîmes)의 수도교는 길이가 약 50킬로미터에 이르는데, 수원은 수도교가 끝나는 님의 저수조보다 고작 17미터 높을 뿐입니다. 탐색이 먼저였고, 그 탐색은 느리고 거칠었습니다. 그것이 남긴 것은 수 세기 동안 날마다 같은 방식으로 물이 흐른 수로였습니다.
퐁 뒤 가르 또한 프랙털입니다. 세 층의 아치가 같은 형태를 되풀이하고, 각 층이 그 위의 층을 떠받칩니다. 엔진도 그렇게 작동해야 합니다. 단계는 워크플로가, 워크플로는 더 큰 워크플로가, 절차는 회사 전체의 루틴이 떠받치며, 각 계층은 그 아래 계층 위에 놓입니다.
운하와 수도교는 결국 만났습니다. 1805년 Thomas Telford(토머스 텔퍼드)와 William Jessop(윌리엄 제솝)은 웨일스에서 [폰트카사스테 수도교](https://en.wikipedia.org/wiki/Pontcysyllte_Aqueduct)를 완공했습니다. 돌 교각 위에 놓인 철제 수조로, 란골렌 운하를 디강 위 39미터 높이로 실어 나릅니다. 지금도 배들이 그 위를 건넙니다. 그것이 제가 엔진에 대해 품은 그림입니다. 강도 아니고 운하도 아닌, 운하가 휩쓸려 가지 않고 험준한 세계를 건너게 해 주며, 그것을 지은 사람들이 떠난 지 오래된 뒤에도 여전히 서 있는 구조물입니다.
로마인들은 이것을 이해한 행정가 한 사람도 남겨 주었습니다. 97년, 네르바 황제는 [Sextus Julius Frontinus(섹스투스 율리우스 프론티누스)](https://en.wikipedia.org/wiki/Sextus_Julius_Frontinus)를 로마의 수도 감독관으로 임명했고, 프론티누스는 『로마의 수도에 관하여』(*De aquaeductu*)를 썼습니다. 도시의 수도 체계가 실제로 어떻게 작동하는지를 담은 공식 보고서로, 아홉 개의 수도교가 각각 어디에서 물을 끌어오는지, 각각이 얼마나 많은 물을 공급하는지, 그리고 그것들을 사용하고 유지하는 규칙을 적었습니다. 넬슨과 윈터라면 그것을 루틴 집합의 기록된 기억으로 알아보았을 것입니다. 프론티누스는 자신의 수도교들을 자랑스러워했고, 그것들을 기념물과 구별하는 것이 무엇인지 알았습니다. “그토록 많은 물을 실어 나르는 이토록 필수적인 구조물들의 행렬을, 원한다면 한가로운 피라미드나, 유명하기는 하나 쓸모없는 그리스인들의 작품과 비교해 보라!” ([제1권 16절](https://penelope.uchicago.edu/Thayer/E/Roman/Texts/Frontinus/De_Aquis/Bennett/1*.html), Charles E. Bennett의 영어 번역에 따름)
저는 피라미드보다 수도교를 짓고 싶습니다. 기념물은 감탄의 대상이고, 수도교는 의지의 대상입니다. 그러다 결국에는 아무도 그것을 의식하지 않게 됩니다. 아그리파가 기원전 19년에 완공한 [아쿠아 비르고](https://en.wikipedia.org/wiki/Aqua_Virgo)는 르네상스 시대에 복원된 아쿠아 베르지네(Acqua Vergine)로 지금도 흐르며 트레비 분수에 물을 대고 있습니다. 그것이 제가 이 엔진에 바라는 종류의 의미입니다. 눈에 띄는 것이 아니라, 누가 지었는지 아무도 기억하지 못하게 된 뒤에도 여전히 물을 나르고 있는 것입니다.
## 맺으며 {#closing}
화이트헤드는 문명이 우리가 생각하지 않고도 수행할 수 있는 중요한 작업의 수를 늘려 감으로써 진보한다고 말했습니다. 역사의 대부분 동안 그 앞에 필요했던 생각은 사람이 느리고 비싸게 해냈고, 사람들이 루틴으로 바꾼 작업은 매뉴얼과 기억 속에 살았습니다. 이제 탐색은 기호 세계에서 놀라울 만큼 길을 잘 찾는 기계가 할 수 있고, 루틴은 매번 같은 일을 하며 자신이 한 일을 정확히 기억하는 기계 위에서 돌아갈 수 있습니다.
에이전트는 험준한 세계를 지나는 길을 찾아냅니다. 워크플로는 다시 걸을 만한 길 가운데 우리가 간직하는 것입니다. 적혀 있고, 반복할 수 있고, 들여다볼 수 있으며, 즉흥으로 움직이지 않기 때문에 신뢰받습니다. 에이전트와 함께 잘 해 나갈 회사는 에이전트에게 모든 것을 맡기는 회사도, 에이전트를 금지하는 회사도 아닐 것입니다. 에이전트가 탐색하게 두고, 그들이 찾은 것을 읽을 수 있는 런타임 위의 절차로 바꾸며, 강의 일부는 야생으로 남겨 두기를 잊지 않는 회사일 것입니다.
세계가 제 짐작만큼 경계가 없다면, 패턴은 거기서 끝나지 않습니다. 마지막 계층은 없고 다음 반복만이 있습니다. 우리가 아는 것의 가장자리에서 탐색하는 에이전트, 간직할 가치가 있었던 것을 간직하는 절차, 그리고 그 둘이 다음 계층이 딛고 설 땅이 되어 마침내 우리가 더는 그것들을 알아차리지 못하게 되는 일이 이어질 뿐입니다. 크라이튼은 자신의 소설을 반복들로 나누었습니다. 그것이 누구의 통제도 미치지 않는 지점을 넘어서까지 계속 펼쳐지는 시스템에 관한 이야기였기 때문입니다. 이것도 같은 종류의 이야기입니다. 생명은 길을 찾아내고, 강도 그렇습니다. 우리의 몫은 그 길들 가운데 무엇을 간직할 가치가 있는지 정하고, 그것을 실어 나를 수도교를 짓는 일입니다.
## 참고 문헌 {#references}
게임, 언어, AI에 관하여:
- Sebastian Mallaby, *The Infinity Machine: Demis Hassabis, DeepMind, and the Quest to Build a Mind*, Penguin Press, 2026, 13장: 스타크래프트, AlphaStar, 그리고 언어에 대한 내기.
- Ashish Vaswani and colleagues, [Attention Is All You Need](https://arxiv.org/abs/1706.03762), 2017, 트랜스포머 논문.
- Yann LeCun의 월드 모델 회사 AMI에 관하여: [TechCrunch, Who's behind AMI Labs](https://techcrunch.com/2026/01/23/whos-behind-ami-labs-yann-lecuns-world-model-startup/), 그리고 [10억 3천만 달러 투자 라운드에 관한 eWeek 기사](https://eweek.com/news/meta-ai-yann-lecun-ami-world-models-startup).
- Hans Moravec, *Mind Children: The Future of Robot and Human Intelligence*, Harvard University Press, 1988; [모라벡의 역설](https://en.wikipedia.org/wiki/Moravec%27s_paradox) 참조.
- Anthropic, [Building effective agents](https://www.anthropic.com/engineering/building-effective-agents), 19 December 2024.
프랙털, 반복, 아이디어에 관하여:
- Benoit B. Mandelbrot, *The Fractal Geometry of Nature*, W. H. Freeman, 1982.
- James Gleick, *Chaos: Making a New Science*, Viking, 1987.
- Michael Crichton, *Jurassic Park*, Alfred A. Knopf, 1990, 그리고 Steven Spielberg가 감독한 1993년 영화. 소설의 반복들에 관해서는 [하이웨이 드래곤 곡선](https://en.wikipedia.org/wiki/Dragon_curve).
- [프랙털 우주론](https://en.wikipedia.org/wiki/Fractal_cosmology), 은하 탐사에 근거한 대규모 균질성 논증을 포함하여.
- Stuart Kauffman, *At Home in the Universe*, Oxford University Press, 1995, 그리고 Steven Johnson, *Where Good Ideas Come From*, Riverhead, 2010, 인접 가능성에 관하여.
- Michael Tomasello, *The Cultural Origins of Human Cognition*, Harvard University Press, 1999, 래칫 효과에 관하여.
위험, 신뢰, 조직에 관하여:
- Frank H. Knight, [*Risk, Uncertainty, and Profit*](https://www.econlib.org/library/Knight/knRUP.html), 1921.
- Niklas Luhmann, *Trust and Power*, Polity; 신뢰에 관한 에세이는 1968년 독일어 *Vertrauen*으로 처음 나왔습니다.
- Max Weber, *Economy and Society*, 관료제와 합리적·법적 지배에 관하여.
- Herbert A. Simon, *The New Science of Management Decision*, Harper and Brothers, 1960.
- James G. March, "Exploration and Exploitation in Organizational Learning", *Organization Science* 2(1), 1991, pp. 71 to 87, [doi:10.1287/orsc.2.1.71](https://doi.org/10.1287/orsc.2.1.71).
- Richard R. Nelson and Sidney G. Winter, *An Evolutionary Theory of Economic Change*, Belknap Press of Harvard University Press, 1982.
- Ikujiro Nonaka and Hirotaka Takeuchi, *The Knowledge-Creating Company*, Oxford University Press, 1995.
- James C. Scott, *Seeing Like a State*, Yale University Press, 1998.
- Alfred North Whitehead, *An Introduction to Mathematics*, 1911.
공장과 기계에 관하여:
- John von Neumann, *Theory of Self-Reproducing Automata*, edited and completed by Arthur W. Burks, University of Illinois Press, 1966; [Von Neumann universal constructor](https://en.wikipedia.org/wiki/Von_Neumann_universal_constructor) 참조.
- Erich Gamma, Richard Helm, Ralph Johnson and John Vlissides, *Design Patterns: Elements of Reusable Object-Oriented Software*, Addison-Wesley, 1994, 팩토리 패턴과 전략 패턴의 출처.
- UFOAnon, 바닷속 공장이 등장하는 4chan 익명 스레드, 궁금한 분들을 위해 [imgur에 모아 둔 것](https://imgur.com/a/4chan-whistleblower-NXjWQaN). 픽션으로 읽으십시오.
- [Temporal](https://temporal.io/)과 [Restate](https://restate.dev/), 지속형 실행 엔진.
- [Arcanist](https://arcanist.sh/), AI가 작성하는 코드의 시대를 위한 Haskell 도구, 그리고 그 [Basel Haskell Compiler](https://arcanist.sh/bhc/).
- [Kubernetes](https://kubernetes.io/), [HashiCorp Nomad](https://www.nomadproject.io/), [wasmCloud](https://wasmcloud.com/), 오케스트레이터.
규제에 관하여:
- Regulation (EU) 2024/1689, the AI Act, [Article 12, record-keeping](https://artificialintelligenceact.eu/article/12/).
수도교에 관하여:
- Sextus Julius Frontinus, *De aquaeductu*, around AD 97 to 100, translated by Charles E. Bennett, Loeb Classical Library, 1925, [on LacusCurtius](https://penelope.uchicago.edu/Thayer/E/Roman/Texts/Frontinus/De_Aquis/Bennett/1*.html).
- [Pont du Gard](https://en.wikipedia.org/wiki/Pont_du_Gard), [Pontcysyllte Aqueduct](https://en.wikipedia.org/wiki/Pontcysyllte_Aqueduct), [Aqua Virgo](https://en.wikipedia.org/wiki/Aqua_Virgo).
- [The Starlark language specification](https://github.com/bazelbuild/starlark/blob/master/spec.md).
사진에 관하여:
- Armin Grässl, [*006 Whispering Current*](https://www.armingraessl.ch/collection/006-whispering-current), 사진, Transforming Spaces 에디션 가운데 하나.
================================================================================
---
title: "모든 것을 이기되, 아무도 통제하지 않기"
url: https://raskell.io/ko/articles/win-everything-control-no-one/
author: Raffael Schneider
date: 2026-10-29
description: "Sebastian Mallaby가 쓴 Demis Hassabis 전기는 제가 아는 가장 좋은 현대 AI의 역사이며, 통제를 싫어하면서도 통제를 행사하는 한 사람에 대한 정직한 연구입니다."
tags: [intelligence, reinforcement-learning, games, research-labs, ai-alignment, history-of-technology, technology-races, post-scarcity, chess, shogi, go-game, starcraft]
categories: [reviews]
review_of: "The Infinity Machine"
review_of_author: "Sebastian Mallaby"
review_of_kind: book
review_of_year: 2026
rating: 8.5/10
lang: ko
translation_of: https://raskell.io/articles/win-everything-control-no-one/
---
# 모든 것을 이기되, 아무도 통제하지 않기
## 요약
Sebastian Mallaby의 *The Infinity Machine*은 Demis Hassabis의 전기이자 제가 아는 가장 좋은 현대 AI의 역사입니다. 저는 10점 만점에 8.5점을 줍니다. 이 책은 모든 아이디어를 두 번, 먼저 비유로, 그다음 메커니즘으로 설명합니다. 그리고 이 분야를 강화학습과 딥러닝 사이의 긴 반목으로 들려주는데, 진짜 돌파구는 모두 둘을 결합한 것이었습니다. 언어 모델을 잘못 판단한 것부터 자체 챗봇을 내놓지 못한 것까지, 이 책은 DeepMind의 실수에 정직합니다. 그리고 실패한 거버넌스 시도들의 기록은 AI를 지금으로서는 멈출 수도 다스릴 수도 없다고 저를 설득했습니다. 책의 중심에 있는 초상은 맹렬하게 경쟁적이고 통제를 싫어한다고 말하면서도 통제를 행사하는 한 사람입니다. 교훈은 권력이 일을 위한 수단으로 남아야 하며, 그러려면 절제가 필요하다는 것입니다. 부족한 점은 거리감입니다. Hassabis에게 마지막 말을 맡기고 경쟁자들은 바깥에서만 보며, 마지막 장들은 속보처럼 읽힙니다. 그래도 AI 뒤에 있는 사람들을 이해하려면 꼭 읽어야 할 책입니다.
*The Infinity Machine*은 Demis Hassabis(데미스 허사비스)와 아무 관련 없는 장면으로 시작합니다. 2015년 왕립학회에서 열린 강연이 끝난 뒤, Nick Bostrom(닉 보스트롬)은 Geoffrey Hinton(제프리 힌턴)에게 정치 체제가 AI를 사람들을 공포에 몰아넣는 데 쓸 것이라고 생각하면서 왜 계속 AI를 연구하느냐고 묻습니다. 힌턴은 흔한 논거들을 댈 수도 있겠지만 “사실은 발견의 전망이 너무나 달콤하기 때문”이라고 답합니다. Mallaby(맬러비)는 이 이야기가 계속 머릿속을 떠나지 않았다고 말하고, 이 이야기는 책 전체의 질문을 정합니다. 이 기술을 만드는 사람들이 위험을 이해한다면, 그들은 왜 그래도 그것을 만드는가, 그리고 그들이 어떤 사람들인지가 중요한가 하는 질문입니다.
그의 답은 Demis Hassabis의 전기이며, 이 책은 AI가 게임을 하는 프로그램에서 지금의 자리까지 어떻게 왔는지에 대해 제가 읽은 가장 좋은 기록이기도 합니다. 저는 10점 만점에 8.5점을 줍니다. 이 기술 뒤에 있는 사람들, 그들을 움직이는 것, 그리고 왜 아무도 이것을 멈추지 못하는 것처럼 보이는지 이해하고 싶은 사람이라면 꼭 읽어야 할 책입니다.
## 이 책은 무엇인가 {#what-the-book-is}
이 책은 두 가지 일을 합니다. 하나는 한 사람의 생애를 들려주는 것입니다. 네 살 때 아버지가 체스 두는 것을 지켜보다가 몇 주 만에 어른들을 이긴 Hassabis, 열세 살의 체스 마스터, 대학에 가기 전 Bullfrog의 게임 디자이너, 실패한 게임 스튜디오, 신경과학 박사 학위, DeepMind, Google로의 매각, AlphaGo, AlphaFold, 노벨상, 그리고 ChatGPT 이후의 쟁탈전까지입니다. 다른 하나는 이 분야의 역사를 그 아이디어들을 통해, 아이디어들이 등장한 순서대로 들려주는 것입니다. 맬러비는 3년에 걸쳐 Hassabis와 약 30시간을 함께했고 그의 주변 인물 100명 이상을 인터뷰했습니다. 그래서 경쟁자들과 그와 사이가 틀어진 사람들도 자기 목소리로 말합니다.
제목은 케임브리지에서 왔습니다. Hassabis와 그의 친구 David Silver(데이비드 실버)는 거의 무한한 데이터 속에서 패턴을 찾아내는 기계를 상상했고, Hassabis는 훗날 무한 기계(infinity machine)는 무한한 잠재력을 지닐 것이라는 말로 Mustafa Suleyman(무스타파 술레이만)을 영입했습니다(2장과 4장). 이 표현 뒤에는 귀납의 문제가 있습니다. 기호주의 AI는 끝내 이 문제를 풀지 못했고, 책의 나머지 부분은 딥러닝과 강화학습이 그것을 한 조각씩 풀어 가는 과정을 지켜봅니다.
## 올바른 순서로 들려주는 AI의 역사 {#a-history-of-ai-told-in-the-right-order}
맬러비는 기술을 두 번 설명합니다. 한 번은 비유로, 한 번은 메커니즘으로 설명합니다. 예를 들면 다음과 같습니다.
- **이미지 신경망이 학습하는 방식**(6장). 첫 계층들은 가장자리와 색 조각을 찾고, 그다음 계층들은 곡선과 질감을 찾으며, 더 깊은 계층들은 발의 윤곽을 찾고, 마지막 계층들이 고양이라는 이름을 붙입니다. 그다음이 메커니즘입니다. 가중치, 편향, 그리고 입력이 출력과 맞아떨어질 때까지 조금씩 조정되는 6천만 개의 매개변수입니다.
- **Atari 에이전트에 경험 재생이 필요했던 이유**(6장). 고양이 사진이 전부 앞에 오도록 정렬된 사진 더미를 받은 이미지 분류기는 모든 것이 고양이라고 결론짓습니다. 게임의 한구석에 갇힌 에이전트도 같은 문제를 겪습니다. 경험을 저장해 두고 무작위로 뽑아 쓰는 방식이 이를 해결했고, Hassabis는 거기서 해마가 잠자는 동안 하는 일을 보았습니다.
- **Atari 에이전트에 두 번째 신경망이 필요했던 이유**(6장). 자기 추정치에 낙관을 계속 더하는 에이전트는 길바닥에서 100달러 지폐 몇 장을 줍고 한 달만 걸으면 억만장자가 되겠다고 결론짓는 사람과 같습니다. 맬러비가 내놓는 해법은 한동안 지켜본 뒤에야 조언하는 테니스 코치입니다. 한 신경망은 가중치를 고정한 채 플레이하고, 두 번째 신경망은 학습하며, 그 교훈은 일정한 관찰 기간이 지난 뒤에야 넘겨집니다.
- **두 종류의 사고로서의 AlphaGo**(9장). 정책망은 강한 기사가 한눈에 수를 보듯 수를 제안하고, 가치망은 국면을 판단하며, 트리 탐색은 느리고 신중한 부분을 맡습니다. 맬러비는 이를 Kahneman(카너먼)의 시스템 1과 시스템 2에 대응시킵니다.
- **잔차 신경망**(12장). 깊은 신경망은 귓속말 전달 게임처럼 신호를 뭉개 버립니다. 스킵 연결은 중간 계층들을 건너뛰는 급행 차선입니다.
- **트랜스포머**(12장). 임베딩은 수백 개의 차원을 가진 언어의 지도이고, 어텐션은 범죄 드라마의 이번 회를 이해하려면 앞의 어느 회가 필요한지 아는 것입니다. 그리고 시간을 순서가 아니라 주의로 본 Henri Bergson(앙리 베르그송)을 거쳐 가는 우회로도 있습니다.
이 설명들은 배경 지식이 필요 없고, 독자를 얕보지도 않습니다. 순서도 그만큼 중요합니다. 각 장은 앞선 돌파구가 무엇을 가능하게 했고 무엇을 하지 못했는지를 보여 주므로, ImageNet에서 Atari, AlphaGo, AlphaZero, 트랜스포머, AlphaFold, 추론 모델로 이어지는 사슬이 하나의 논증으로 읽힙니다. 저는 이 사슬을 연결마다 출처를 달아 그렸고, 그것을 이 연구실에서 저 연구실로 옮긴 사람들도 함께 그려, 짝을 이루는 노트에 두 개의 인터랙티브 그림으로 실었습니다: [Who contributed to AI](https://raskell.io/notes/who-contributed-to-ai/)(영어).
## 중심에 있는 반목 {#the-feud-at-the-centre}
역사를 하나로 묶는 실은 강화학습과 딥러닝 사이의 경쟁입니다. 이 경쟁은 지리에서 시작합니다. 토론토에는 힌턴의 딥러닝 연구자들이, 앨버타에는 Richard Sutton(리처드 서튼)의 강화학습 연구자들이 있었고, 서로 거의 말을 섞지 않았습니다. 강화학습 이론가 Csaba Szepesvári는 신경망이 실제로는 작동한다는 것을 인정하면서도, 그것에 대해 아무것도 증명할 수 없기 때문에 쓰지 않겠다고 말합니다. 둘을 결합하고 싶어 하던 제자 Vlad Mnih에게 힌턴은 “그거 해 봤어. 안 돼.”라고 말합니다. Mnih는 런던으로 가서 어쨌든 그것을 해냈고, 그 결과가 Atari 에이전트입니다(6장).
거기서부터 책은 진자가 오가는 모습을 보여 주며, 어느 쪽도 오래 이기게 두지 않습니다.
| 시기 | 옳아 보였던 쪽 | 일어난 일 | 다른 쪽이 기여한 것 |
|---|---|---|---|
| 2006년부터 2012년 | 딥러닝 | 힌턴의 심층 신뢰 신경망, 그다음 그래픽 칩, 그리고 자기 침실에서 학습시킨 Alex Krizhevsky의 ImageNet 우승. 그의 3인 회사는 4,400만 달러에 Google에 팔립니다(4장과 6장) | 아직 없음. 두 진영은 거의 대화하지 않습니다 |
| 2013년 | 처음으로 양쪽 모두 | DeepMind의 Atari 에이전트가 픽셀과 점수만으로 수십 개의 게임을 학습합니다. NIPS 학회장은 Breakout의 터널 장면에서 조용해집니다(6장) | 화면을 보는 합성곱 신경망은 딥러닝에서, Q-러닝과 경험 재생과 추정치를 정직하게 유지하는 두 번째 신경망은 강화학습에서 |
| 2014년부터 2016년 | 강화학습 | AlphaGo가 판후이를 5대 0으로, 이어서 이세돌을 4대 1로 이깁니다. 37수와 함께입니다(9장) | 직관을 대신하는 정책망과 가치망은 딥러닝이며, 먼저 사람의 대국 15만 판으로 학습되었습니다 |
| 2017년 | 강화학습, 요란하게 | AlphaZero가 사람의 기보 없이 오직 자기 대국만으로 바둑, 체스, 쇼기를 학습합니다(12장) | AlphaGo의 두 신경망을 하나로 합칠 만큼 깊은, Microsoft에서 나온 잔차 신경망 |
| 2017년부터 2019년 | 딥러닝 | LeCun(르쿤)은 강화학습을 “케이크 위의 체리”라고 부릅니다. 트랜스포머와 GPT는 레이블 없는 텍스트로 학습하고, 이는 강화학습의 두 가지 장점, 즉 사람의 레이블 없이 학습한다는 점과 자기 데이터를 스스로 만든다는 점을 지워 버립니다(12장) | 사후 학습 전까지는 거의 없음 |
| 2017년부터 2020년 | 어느 쪽도 혼자서는 아님 | 에이전트를 위한 시뮬레이션 자연 세계인 Gaia는 실패합니다. 스타크래프트 II 내장 봇을 상대로 한 AlphaStar의 승률은 트랜스포머 덕분에 10퍼센트에서 84퍼센트로 뛰고, 이어서 강화학습이 랭크 게임의 인간 플레이어들을 상대로 99.8퍼센트까지 끌어올립니다. 순수한 자기 대국만으로 만든 스타크래프트 에이전트는 끝내 제대로 진척되지 못합니다(13장) | 서로가 서로를 필요로 했고, 어느 쪽도 혼자서는 해낼 수 없었습니다 |
| 2018년부터 2020년 | 생물학과 함께한 딥러닝 | AlphaFold는 강화학습 프로젝트로 시작해 강화학습을 대부분 버리면서 이깁니다. Hassabis는 “단백질 접힘은 2인용 게임이 아니다”라고 말합니다(15장) | 첫 AlphaFold의 탐색 단계 하나, 그 뒤로는 없음. 결정적인 아이디어는 진화와 트랜스포머에서 왔습니다 |
| 2022년부터 2023년 | 강화학습으로 길들인 딥러닝 | ChatGPT와 공개되지 않은 DeepMind의 Sparrow는 모두 인간 피드백 기반 강화학습으로 쓸 만해집니다. 기계 강화학습을 Gemini에 들여오려던 실버의 시도는 멈춰 섭니다. 좋은 하이쿠에 대한 보상을 아무도 작성할 수 없기 때문입니다(16장부터 18장) | 게임 점수가 주던 보상을 이제 사람 평가자들이 줍니다 |
| 2024년 이후 | 다시 강화학습 | 정답이 있는 수학과 논리 문제에서 나온 보상이 모델에게 단계별로 추론하는 법을 가르칩니다. OpenAI의 o1, Gemini Flash Thinking, DeepSeek의 R1-Zero입니다. AlphaProof는 수학 올림피아드 은메달을 땁니다. 실버와 서튼은 “경험의 시대(Era of Experience)”를 선언합니다(19장과 20장) | 학습되는 언어 모델은 딥러닝입니다. 이제 강화학습은 그 위에서 돌아가고, 보상 해킹도 마찬가지입니다 |
이 책에 나오는 진짜 돌파구는 모두 두 방법을 결합한 것이며, 어느 순간에 틀려 보이는 쪽은 대개 상대편의 다음 진전을 기다리고 있을 뿐입니다.
## DeepMind가 틀린 것 {#what-deepmind-got-wrong}
맬러비는 공감하는 전기 작가이지만 DeepMind의 실수를 숨기지 않습니다. DeepMind의 2010년 사업 계획서는 언어가 곧 표현된 지능이라는 생각을 잘못된 관념이라고 부르며 일축했습니다. Hassabis는 모델이 세계를 이해하려면 세계 안에서 행동해야 한다고 믿었고, 수년 동안 GPT를 잘못 판단했습니다. 그는 이를 인정합니다. “매번 노스트라다무스일 수는 없다”(13장).
나중에 그는 그 이유를 설명합니다. 그는 인간 행동의 공간이 거의 무한하다고 가정했는데, 알고 보니 인터넷에 있는 약 14조 개의 단어가 그 대부분을 담고 있었습니다. 그는 인터넷을 산업혁명이 우연히 땅속에서 발견한 석탄과 석유에 비유합니다. 아무도 AI를 위해 그것을 만들지 않았고, 그것이 꼭 거기 있어야 할 이유도 없었습니다. 저는 Tim Berners-Lee의 회고록 서평인 [웹이 학습 데이터였다](https://raskell.io/articles/the-web-was-the-training-set/)에서 같은 주장을 반대편에서 펼쳤고, Hassabis는 연구소 안에서 같은 결론에 이릅니다.
다른 실수들은 조직의 실수였습니다. Google은 Xerox PARC의 딜레마에 갇혀 있었습니다. 트랜스포머를 발명했지만 검색을 위태롭게 하지 않고서는 챗봇을 내놓을 수 없었습니다. DeepMind는 Bell Labs의 딜레마에 갇혀 있었습니다. 열린 탐구를 위해 만들어진 문화는 길이 분명해졌을 때 엔지니어링으로 전환하지 못했습니다. DeepMind에는 스물세 개의 행동 규칙과 웹 검색을 갖춘 Sparrow라는 챗봇이 있었고, ChatGPT가 나왔을 때 거의 준비가 끝나 있었지만 끝내 출시되지 않았습니다(16장과 17장).
## 사람들 {#the-people}
Peter Thiel(피터 틸)은 DeepMind가 역발상적이고 싸 보여서 투자했지만 한 번도 그것을 믿지 않았고, 하마터면 자금이 바닥나게 둘 뻔했습니다(7장). Elon Musk(일론 머스크)는 돈을 약속했고, 옷장 안에서 건 전화로 DeepMind를 Tesla나 SpaceX를 위해 사들이려 했으며, DeepMind의 안전 위원회에 참여했으면서도 그 뒤 DeepMind에 맞서 OpenAI를 공동 창업했습니다(8장과 10장). Mark Zuckerberg(마크 저커버그)는 저녁 식사 자리에서 DeepMind를 놓쳤습니다. Hassabis가 그가 AI만큼이나 가상현실과 3D 프린팅에도 들떠 있다는 것을 알아챘기 때문입니다. 그 뒤 그는 DeepMind의 직원들을 빼 오려고 Yann LeCun(얀 르쿤)을 고용했습니다(8장). Larry Page(래리 페이지)는 기계보다 인간을 선호한다는 이유로 머스크를 “종차별주의자”라고 불렀습니다(10장). 주로 경쟁자들의 눈을 통해 그려지는 Sam Altman(샘 올트먼)은 2015년에 인류가 AI를 개발하지 못하게 막는 것은 “거의 확실히 불가능하다”고 쓰고, 그 뒤 누구보다도 그것을 증명하는 데 앞장선 사람으로 등장합니다. Dario Amodei(다리오 아모데이)는 GPT-2의 규모를 키우고 나중에 떠나 Anthropic을 세운 안전 연구자로 나타납니다.
무스타파 술레이만의 이야기는 읽기 가장 힘든 부분입니다. 그는 Hassabis의 남동생의 친구였고 공동 창업자가 되었습니다. NHS를 위한 그의 보건 사업은 훌륭했지만(Streams 앱은 놓친 긴급 신장 질환 사례의 비율을 12.4퍼센트에서 3.3퍼센트로 줄였습니다, 11장) 데이터에 관한 타블로이드 기사 하나로 무너졌습니다. DeepMind를 독립적인 감독 아래 두려는 그의 운동은 3년 동안 이어졌지만 실패했습니다(14장). 그다음에는 괴롭힘 조사, 안식 휴가, Bloomberg의 헤드라인이 이어졌고, 우정은 끝났습니다. 맬러비는 두 사람 모두에게 자기 입장을 말하게 합니다.
## 왜 다스릴 수 없는가 {#why-it-cannot-be-governed}
책을 덮고 나서 저는 AI를 멈출 수 없고, 적어도 지금으로서는 다스릴 수도 없다는 확신이 전보다 강해졌습니다. 이것은 제 결론이지만, 그 근거의 대부분은 이 책이 제공합니다. 업계 안에서 AI를 다스리려던 모든 시도는 실패하고, 정부들은 자발적 약속을 들고 뒤늦게 도착합니다.
- Google이 DeepMind를 인수하면서 합의한 **윤리 및 안전 위원회**는 SpaceX에서 단 한 번 모였습니다. 그 뒤 손님들 가운데 여럿이 경쟁 연구소를 세우거나 그에 자금을 댔습니다. Hassabis는 “우리의 이른바 자문위원들은 사실 우리의 경쟁자였다”고 말합니다(10장).
- DeepMind Health를 감시하던 **독립 패널**은 Google이 보건 팀을 흡수하면서 해체되었습니다(14장).
- Google 측 이사 셋, DeepMind 측 이사 셋, 독립 이사 셋으로 이사회를 꾸린 DeepMind를 위해 3년 동안 협상한 **Project Mario**는 아무것도 남기지 못했습니다. Reid Hoffman(리드 호프먼)은 독립해 나가는 DeepMind에 10억 달러를 약속했지만, 그 일은 일어나지 않았습니다(14장).
- **OpenAI의 비영리 이사회**는 올트먼을 해고했고 닷새를 버텼습니다(18장).
- 2023년의 **일시 중단 서한**에는 천 명이 넘는 사람이 서명했지만, 선도적인 연구소의 수장들은 서명하지 않았습니다. Hassabis의 반론은 설득력이 있습니다. 칩과 데이터 센터가 계속 발전하는 동안 모델에만 유예를 두면, 유예가 끝났을 때 가장 많은 연산 자원을 가진 쪽에게 다음 경주를 넘겨주게 된다는 것입니다(18장).
2025년이 되자 Hassabis는 “안전은 거버넌스 구조의 문제가 아니다”라고, 그리고 할 수 있는 최선은 테이블에 자리를 갖는 것이라고 결론짓습니다. 맬러비는 이를 “안심을 위한 허술한 비계”라고 부르면서도, 그것이 지금 가능한 최선일지도 모른다고 인정합니다. 저는 두 가지 모두에서 그에게 동의합니다.
## 제가 알아본 부분들 {#the-parts-i-recognised}
3장에는 Hassabis의 “무언가를, 무엇이든 겨루어 이기고 싶은 불타는 욕망”에 관한 문장이 있습니다. 그의 첫 게임 스튜디오는 판타지 풋볼과 스타크래프트로 그 욕망을 채우려 했습니다. 동료가 마침내 테이블 축구에서 그를 이겼을 때, 그는 자기 영혼이 불타고 있다고 선언했습니다. 저는 웃었습니다. 그 느낌을 알기 때문입니다. 저는 어릴 때 체스 클럽에서 체스를 두었고, 스타크래프트는 지금도 제가 가장 좋아하는 전략 게임이며, 한국의 브루드 워 씬을 [그에 관한 사이트](https://broodwar.live)를 만들 만큼 가까이 따라가고 있습니다. 그래서 AlphaStar에 관한 장들과, 한국에서 2억 명의 시청자 앞에서 AlphaGo가 이세돌과 맞선 장들은 대부분의 AI 역사와 달리 제게 개인적으로 다가왔습니다.
게임들도 그랬습니다. 저는 Peter Molyneux(피터 몰리뉴)의 *Black & White*와 나중의 *Fable*을 좋아했는데, Hassabis는 *Black & White*의 초기 설계에 참여했습니다. 이 게임은 생명체가 플레이어의 때리기와 쓰다듬기에 따라 자기 규칙을 바꾸는 최초의 게임이었고, 상업 게임 안에 들어간 작은 강화학습 시스템이었기 때문입니다(2장). 그보다 앞서 십 대였던 그는 *Theme Park*의 시뮬레이션 방문객들을 만들었습니다. 그들은 짭짤한 감자튀김을 먹고 목이 마르고 롤러코스터를 타고 속이 메스꺼워졌습니다. 이 책은 그 시뮬레이션 세계들에서 DeepMind가 시뮬레이션 생물권을 시도한 Gaia로, 그리고 Conway(콘웨이)의 생명 게임과 창발에 대한 Hassabis의 매혹으로 곧게 선을 긋습니다. 단순한 부분들을 함께 놓으면 어느 부분에도 없던 성질이 나타난다는 것입니다. 그것은 제가 제 시뮬레이션들에서 계속 되돌아가는 질문입니다. 퐁을 배우는 시뮬레이션 뉴런 배양체인 [Hotaru](https://hotaru.raskell.io)에서부터 [Kishi](https://kishi.raskell.io)의 엔진들까지 그렇습니다. Kishi는 체스, 쇼기, 바둑을 두는데, AlphaZero가 배운 바로 그 세 게임이며, [Learning to Play](https://raskell.io/articles/learning-to-play/) 시리즈는 9장과 12장의 질문들을 작은 규모로 옮긴 제 판본입니다. Hassabis는 영국 쇼기 순위에서 정상에 오르기도 했습니다.
그가 원하는 미래는 제가 원하는 미래와 가깝습니다. 계산으로 풀린 생물학, 일을 하는 로봇과 자동화, 그리고 풍요입니다. 그는 Iain Banks(이언 뱅크스)의 컬처 소설들을 읽으며 자랐고, 7장에서는 업계의 대다수 사람보다 더 멀리 나아갑니다. 그는 보편적 기본소득이 답인지 의심하며, 그가 보편적 기본 제공이라고 부르는 것을 선호합니다. 오늘날 백만장자들이 누리는 수준의 주거, 교육, 의료, 여행을 모든 시민에게 무료로 제공하고, 페라리를 원하는 사람에게는 일이 있는 세상입니다. 20장 끝에서 실버는 AI의 도움을 받을 인간의 권리를 제안합니다. 둘 다 계획은 아니지만, 둘 다 대부분의 정책 논쟁보다 나은 출발점입니다.
## 통제하지 않고 이기기 {#winning-without-controlling}
맬러비는 책 전체에 걸쳐 Hassabis의 두 가지 특성을 놓치지 않는데, 공교롭게도 둘 다 제가 공유하는 특성입니다. 그는 지독하게 경쟁적입니다. 힌턴은 그를 자기보다 더 경쟁적인 사람으로는 유일하게 만나 본 사람이라고 부릅니다. 그리고 그는 2장부터 줄곧 누구도 통제하고 싶지 않다고 고집하며 “사람을 조종하거나 통제하는 것은 정말 나쁘다”고 말합니다. 그는 이 가치를 어머니의 교회에서 찾습니다. 그는 돈에도 관심이 없어 보입니다. 열여덟 살 때 그는 케임브리지에 가기 위해 몰리뉴가 준 50만 파운드짜리 수표를 현금으로 바꾸기를 거절했습니다. DeepMind를 팔 때 그와 술레이만은 가격보다 연구 예산을 먼저 협상했고, 에필로그에서 그는 노벨상을 어떤 액수의 돈과도 바꾸지 않았을 것이라고 말합니다. 그는 10년 된 Audi를 몰고, 그의 유일한 사치는 리버풀 시즌 티켓입니다.
맬러비는 통제에 관한 주장을 시험하고, 증거는 엇갈립니다.
- Elixir에서 Hassabis의 “제다이 마인드 트릭”은 팀에게 정직한 피드백이 나올 수 없을 만큼 영감을 불어넣었습니다. 그는 나중에 “사람들에게 영감을 너무 많이 줄 수도 있다는 걸 누가 생각이나 했겠어요?”라고 말합니다(3장). 한 심리학자는 맬러비에게 카리스마 있는 사람은 아무리 애써도 다른 사람들을 지배하지 않을 수 없다고 말합니다.
- Elixir에서 그는 회사의 절반을 내준다는 것이 통제를 받는다는 뜻이었기 때문에 벤처 캐피털을 거절했습니다. DeepMind에서는 사명을 통제하고 싶었기 때문에 과학 쪽 공동 창업자보다 아홉 배 많은 지분을 가져갔습니다(5장).
- 그는 양방향의 지배를 모두 싫어했습니다. 지배하지도 않으려 했고, 지배당하지도 않으려 했습니다. 술레이만이 그의 방향에 이의를 제기했을 때, 그는 대화로 했어야 할 일을 조사에 맡겼습니다(14장).
- 에필로그에서 맬러비는 그에게 직접 묻습니다. “그는 다른 사람을 통제하고 싶지 않다고 내게 거듭 말했다. 그런데도 그는 사람들을 통제했다.” Hassabis는 자신이 마지못해 권력을 행사한다고 답합니다. 그가 하고 싶은 일들에는 큰 팀이 필요하기 때문입니다.
이기기를 좋아하고 권력을 싫어하는 사람에게 이것은 경고입니다. 첫 번째 특성이 두 번째 특성이 피하고 싶어 하는 권력을 행사해야 하는 상황으로 우리를 데려가기 때문입니다. 권력은 일을 위한 수단으로서는 받아들일 수 있지만 결코 목적이 되어서는 안 된다는 Hassabis의 답은 옳은 답입니다. 하지만 이 책은 그것을 수단으로 남겨 두는 데 얼마나 많은 절제가 필요한지를 보여 줍니다.
## 부족한 점 {#where-it-falls-short}
제가 남겨 둔 반 점은 주로 거리감에 관한 것입니다. 맬러비는 서문에서 증거보다 먼저 Hassabis가 “품위 있고 공익 정신을 지닌” 사람이라는 판정을 내놓습니다. 책이 그 판정을 시험하기는 하지만, 대부분의 논쟁에서 마지막 말은 Hassabis가 합니다. OpenAI와 Anthropic은 바깥에서, 주로 그곳을 떠났거나 그들과 경쟁한 사람들을 통해 보이므로, 올트먼은 거의 전적으로 그의 경쟁자들에 의해 그려집니다. 그리고 맬러비는 사실을 전하는 데 그칠 수 있었던 대목에서 논평을 덧붙입니다. DeepMind Health를 비판한 독립 패널에게는 가혹하고, Gemini 벤치마크를 둘러싼 논쟁에서는 DeepMind에 너그러우며, 한 대목에서는 DeepSeek의 R1-Zero가 “사실상” 자기 인식을 가졌다고 말합니다. 그가 제시하는 증거는 이 주장을 뒷받침하지 않습니다.
마지막 장들은 또한 속보처럼 읽힙니다. 이미 낡은 벤치마크와 제품 이름들을 서둘러 지나가고, 케임브리지와 Elixir와 AlphaGo에 관한 장들이 지닌 차분함이 없습니다. 아직 진행 중인 경주에 관해 2026년에 마무리된 책이라면 피할 수 없는 일일지도 모르고, 그 어느 것도 제 추천을 바꾸지 않습니다.
## 누가 읽어야 하는가 {#who-should-read-it}
지난 15년의 AI를 그것을 만든 사람들을 통해, 그 과정에서 개념들까지 설명받으며 이해하고 싶은 모든 사람입니다. 기술적 배경은 필요 없고, 배경이 있다 해도 그 순서와 비유 때문에 설명들은 여전히 읽을 가치가 있습니다. [제 독서 기록](https://raskell.io/reading/)에 있는 *AI 2027* 같은 전망들과 함께 읽으면 좋습니다. 그것들은 이 일이 어디로 갈 수 있는지를 묘사하고, 이 책은 누가 운전하고 있는지, 왜 그러는지, 그리고 운전하는 사람들을 포함해 누구도 경로를 거의 통제하지 못한다는 것을 보여 줍니다.
책은 펍에 앉은 Hassabis로 끝납니다. 그는 자기 꿈이 이루어지는 것을 지켜보는 일이 놀랍게 느껴져야 하는데 그렇지 않다고, 그 미친 듯한 질주 때문이라고 말합니다. 그래도 그는 여전히 낙관적입니다.
================================================================================
---
title: "두는 법을 배우기"
url: https://raskell.io/ko/articles/learning-to-play/
author: Raffael Schneider
date: 2026-10-25
description: "체스 신동이 읽은 핸드북, 오래된 세 가지 게임, 그리고 노트북 한 대. 게임 AI의 바탕이 된 아이디어를 휴대폰 브라우저에서 돌아가도록 Rust로 다시 만들고 측정한 기록입니다."
tags: [game-ai, machine-learning, reinforcement-learning, games, rust, webassembly, history-of-technology, chess, shogi, go-game]
series: learning-to-play
lang: ko
translation_of: https://raskell.io/articles/learning-to-play/
---
# 두는 법을 배우기
## 요약
*The Infinity Machine*을 읽다가, 어린 Demis Hassabis가 읽은 체스 핸드북의 세 부분이 지금도 체스 프로그램의 전부라는 사실에 놀랐습니다. 달라진 점은 평가 함수를 이제 학습한다는 것뿐입니다. 체스, 쇼기, 바둑은 게임 AI의 역사를 그대로 따라갑니다. 고전적인 방법은 체스에서 통하고, NNUE 네트워크가 발명된 쇼기에서 한계에 부딪히며, 바둑에서는 네트워크가 탐색을 이끌지 않으면 실패합니다. 저는 세 게임 모두를 위한 엔진을 Rust로 만들고 WebAssembly로 컴파일해 휴대폰에서 오프라인으로 두도록 했습니다. 탐색 안에 들어가는 네트워크는 작고 손으로 쓴 산술이어야 하기 때문입니다. 자기 대국으로 학습한 제 네트워크는 같은 탐색 깊이에서는 손으로 쓴 체스 평가 함수를 이겼지만, 같은 시간에서는 비기는 데 그쳤습니다. 국면 하나당 비용이 더 크기 때문입니다. 한 달이 지나고 나니 처음보다 더 나은 질문들이 남았습니다. 저는 실패를 포함한 모든 실행을 노트에 기록하고 있으며, 이것이 연재로 이어질 수도 있습니다.
이번 달에 저는 [*The Infinity Machine*](https://raskell.io/reading/#the-infinity-machine)을 읽고 있습니다. Sebastian Mallaby(서배스천 맬러비)가 쓴 Demis Hassabis(데미스 허사비스)의 전기입니다. 허사비스는 북런던 출신의 체스 신동으로, AlphaGo와 AlphaFold를 만든 연구소 DeepMind를 세운 사람입니다. 제가 이 책을 집어 든 것은 지금 우리가 함께 살아가는 AI를 초기에 설계한 사람 가운데 한 명을, 그와 서른 시간을 함께 보낸 저자의 목소리로 이해하고 싶었기 때문이고, 또 게임, 시뮬레이션, 기계가 스스로 무엇을 배울 수 있느냐는 질문처럼 저를 끄는 거의 모든 것이 그의 이야기를 관통하기 때문입니다. 100쪽쯤 읽었을 때 한 장면이 나왔는데, 저는 아직도 그 장면을 내려놓지 못하고 있습니다.
1988년, 허사비스는 열두 살입니다. 그는 체스 상금으로 Commodore Amiga 500을 샀고, 채링크로스 로드의 큰 서점 Foyles에서 얇은 페이퍼백 한 권을 발견합니다. David Levy(데이비드 레비)의 *The Chess Computer Handbook*입니다. 그는 그 책을 앉은 자리에서 다 읽습니다. 레비는 체스 프로그램이 세 부분으로 만들어진다고 설명합니다. 먼저 판을 숫자로 바꾸어야 합니다. 다음으로 어떤 함수가 국면을 보고 누가 더 나은지 말해야 합니다. 그리고 탐색이 수를 시도하고, 그 수에 대한 응수를 시도하고, 다시 그 응수에 대한 응수를 시도해야 하는데, 트리는 어떤 컴퓨터도 따라갈 수 없을 만큼 빠르게 자라므로 명백히 나쁜 가지는 잘라 내야 합니다. 허사비스는 이것을 만들어 보려 하지만 Amiga가 체스를 감당하지 못한다는 것을 깨닫고, 대신 오델로 프로그램을 짭니다. 그 프로그램은 다섯 살 남동생을 이깁니다.
저는 거기서 책을 내려놓았습니다. 그 소년에게서 제 모습을 조금 알아본 탓도 있고, 두 가지를 깨달았기 때문이기도 합니다. 첫째, 그 세 부분은 지금도 체스 프로그램의 전부입니다. 38년이 지난 지금, 세계에서 가장 강한 엔진도 숫자로 바꾼 판, 평가 함수, 가지치기를 하는 트리 탐색으로 이루어져 있습니다. 달라진 것은 평가 함수를 이제 사람이 쓰지 않고 기계가 학습한다는 점, 그리고 기계가 자기 자신과 두면서 그것을 학습했다는 점입니다. 둘째, 제 책상 위의 노트북은 그 Amiga보다 메모리가 3만 배나 많은데, 저는 그 세 부분을 직접 만들어 본 적이 한 번도 없었습니다.
그래서 이번 달에 만들었습니다. 저는 체스, 일본의 쇼기, 바둑을 위한 게임 엔진 세 개를 Rust로 작성하고, 휴대폰 브라우저에서 두도록 WebAssembly로 컴파일했으며, 그중 하나를 제가 손으로 만들 수 있는 것보다 더 강하게 만들어 줄 학습 루프를 구축했습니다. 앱은 [kishi.raskell.io](https://kishi.raskell.io)에 있고 코드는 [GitHub에](https://github.com/raskell-io/kishi) 있습니다. 이 글은 왜 그 세 게임이었는지, 왜 그 도구들이었는지, 그리고 책 속의 아이디어가 평범한 기계 한 대를 만났을 때 무슨 일이 일어났는지에 관한 기록입니다.
## 책, 사람, 그리고 연구소 {#the-book-the-man-and-the-lab}
맬러비는 본업이 기술 저술가가 아닙니다. 그는 *Financial Times*의 기고 편집자를 지냈고, 퓰리처상 최종 후보에 두 번 올랐으며, 지금은 미국외교협회(Council on Foreign Relations)의 선임 연구원입니다. 그의 이전 책들은 돈에 관한 것이었습니다. *More Money Than God*은 헤지펀드를, *The Man Who Knew*는 Alan Greenspan(앨런 그린스펀)을, *The Power Law*는 벤처 캐피털을 다룹니다. 알고 보니 이것이 딱 맞는 배경이었습니다. *The Infinity Machine*은 전기이자 동시에 회사의 역사이며, 허사비스와 나눈 약 서른 시간의 대화와 그 주변 인물들과의 100건이 넘는 인터뷰를 바탕으로 합니다. 그리고 누군가가 왜 스스로 위험하다고 믿는 기술을 만드는지라는 질문을, 어떻게 만드는지라는 질문만큼 진지하게 다룹니다. 이 책은 올해 초에 나왔습니다. 저는 천천히 읽고 있고, AlphaGo를 다룬 장들은 아직 앞에 남아 있습니다. 그게 그다지 아쉽지 않은데, 그 장들은 제 나름의 버전을 돌려 놓은 채로 만나고 싶기 때문입니다.
이 분야를 따라가지 않는 분께 덧붙이면, 허사비스는 쉰 살인 지금 이 분야가 원로로 대하는 인물입니다. 1976년 핀칠리에서 싱가포르 화교 어머니와 그리스계 키프로스인 아버지 사이에서 태어난 그는 열세 살에 체스 마스터가 되었고, 같은 나이대에서 세계 2위의 선수였습니다. 열여섯 살에는 게임 스튜디오 Bullfrog에서 *Theme Park*를 공동 개발했는데, 이 게임은 수백만 장이 팔렸습니다. 케임브리지에서 컴퓨터 과학을 공부했고, 7년 동안 자기 게임 스튜디오를 운영한 뒤, 신경과학 박사 과정을 밟으러 대학으로 돌아갔습니다. 지능을 가진 기계를 만드는 유일한 길은 먼저 현존하는 유일한 사례를 이해하는 것이라고 생각했기 때문입니다. 2010년, 러셀 스퀘어의 한 다락방에서 그는 Shane Legg(셰인 레그), Mustafa Suleyman(무스타파 술레이만)과 함께 DeepMind를 세웠습니다. 그들이 제안한 것이 가능하다고 믿는 사람이 이 분야에 거의 없던 시절이었습니다. 처음으로 들어온 제대로 된 돈은 Peter Thiel(피터 틸)의 펀드에서 나왔는데, 그 파트너들은 과학에는 A+를, 비즈니스 모델에는 F를 주었습니다.
DeepMind는 인공지능을 위한 맨해튼 프로젝트로 구상되었고, 그 방법론이 이 책과 이 글을 이어 줍니다. 그들이 건 승부는 2010년에는 둘 다 유행에서 벗어나 있던 이 분야의 두 갈래를 결합하는 것이었습니다. 하나는 Geoffrey Hinton(제프리 힌턴)이 사반세기 동안 옹호해 온 층층이 쌓인 신경망, 곧 딥러닝이고, 다른 하나는 프로그램이 레이블이 붙은 예제가 아니라 자기 행동의 결과로부터 배우는 강화학습이었습니다. 그 위에 신경과학의 아이디어를 얹었습니다. 시험장은 게임이었습니다. 게임에는 글로 적을 수 있는 규칙과 판 위에서 읽어 낼 수 있는 점수가 있기 때문입니다. 2013년에 공개된 첫 성과는 픽셀만 보고 Atari 게임을 배운 하나의 에이전트였습니다. 2014년에 Google이 회사를 인수했습니다. 2016년에 AlphaGo가 서울에서 이세돌을 이겼고, 2017년에는 그 후계자인 AlphaZero가 규칙과 자기 자신과의 대국 외에는 아무것도 없이 하나의 알고리즘으로 체스, 쇼기, 바둑을 배워 각 게임에서 당시 가장 강한 프로그램을 이겼습니다. 이 세 게임이 바로 이 글에 나오는 세 게임이고, 순서도 같습니다. 그리고 자기 대국이 제가 만든 루프입니다. 이어서 2020년에 AlphaFold가, 그다음에 2억 개 단백질의 예측 구조가, 그리고 2024년 노벨 화학상이 뒤따랐습니다. 이름조차 세 겹의 경의를 담고 있습니다. 딥러닝, Deep Blue, 그리고 『은하수를 여행하는 히치하이커를 위한 안내서』에서 모든 것에 대한 답을 요구받은 컴퓨터 Deep Thought에 대한 경의입니다.
저는 왜 이 책을 읽고 있을까요? 하나는 분명한 이유입니다. 저는 AI 플랫폼을 만드는 일로 생계를 꾸리고 있고, 이 혁명을 설계한 사람 가운데 한 명의 이야기를 안쪽에서 듣고 싶었습니다. 이 책은 정확히 그것이고, 그 이상입니다. 또 하나는 자꾸 저를 놀라게 한 유사점들 때문입니다. 놀이공원 게임 안에 시뮬레이션을 몰래 들여놓은 게임 디자이너, 보드게임을 보면 이기고 싶어서 그냥 지나치지 못하는 승부사, 세계를 정보로 여기고 마음을 현실을 기록하는 것이 아니라 현실을 짓는 것으로 생각하는 사람. 저는 그 안에서 편하다고 하기 어려울 만큼 많은 것을 알아봅니다. 그리고 마지막은 믿음 때문입니다. 허사비스는 거의 아무도 인공지능을 믿지 않을 때 그것을 믿었고, 책은 그 확신을 거의 종교에 가깝다고 부를 만큼 정직하며, 그는 옳았습니다. 이 이야기에는 트랜스휴머니즘의 한 갈래가 흐릅니다. 그가 Bullfrog 시절에 읽은 Iain Banks(이언 뱅크스)의 소설에서부터 DeepMind가 첫 투자자를 찾은 Singularity Summit에 이르기까지 말입니다. 그리고 그는 그 캘리포니아식 버전과는 건조한 영국식 거리를 둡니다. 저에게도 저만의 갈래가 있습니다. 다른 결을 지녔고 다른 방향에서 왔지만, 그것은 다른 글의 주제입니다. 여기서는 제가 회의론자로서 이 책을 펼친 것이 아니라는 정도만 말씀드리면 충분합니다.
그 초반부에서 저를 사로잡은 것은 신동 이야기보다도, 게임이 얼마나 자주 입구가 되는가 하는 점이었습니다. 허사비스는 체스를 통해 프로그래밍을 배웁니다. 그의 첫 지능형 프로그램은 오델로를 둡니다. 케임브리지에서 그는 한 교수에게 바둑을 배우고, 쇼기는 영국 랭킹 정상에 오를 만큼 깊이 파고듭니다. 훗날 AlphaGo 작업을 이끌게 될 그의 친구 David Silver(데이비드 실버)는, 두 사람의 게임 회사가 망한 뒤 남프랑스에서 읽은 강화학습 교과서를 통해 이 분야에 들어옵니다. 맬러비는 이 실마리를 컴퓨터가 체스를 두도록 프로그래밍하는 법에 관한 Claude Shannon(클로드 섀넌)의 1950년 논문까지 거슬러 올라가 추적하는데, 레비의 핸드북이 열두 살 소년에게 소개한 것이 바로 그 논문이었습니다. 섀넌은 체스 프로그램에 실용적인 중요성은 없지만, 게임을 정복하는 것이 “비슷한 성격을 지닌 더 중요한 다른 문제들을 공략하는 쐐기”가 될 수 있다고 썼습니다. 이 문장은 76년 전의 것이지만, 보드게임에 한 달을 쓰는 일을 정당화하는 한 줄짜리 문장으로는 제가 아는 것 가운데 여전히 가장 좋습니다.
## 저의 게임들 {#my-own-games}
제 체스 이야기는 그보다 작습니다. 저는 십대 초반에 체스 클럽에 들어가 지역 대회에 나갔고, 그중 몇몇 대회에서는 좋은 성적을 냈습니다. 허사비스가 여섯 살 때 그랬던 것처럼 체스 칼럼니스트가 홀을 가로질러 와서 제 아버지에게 말을 걸 만한 정도는 전혀 아니었고, 이 책이 우리 둘을 같은 서점에 세워 두지 않았다면 그의 경력과 같은 문단에 올릴 생각도 하지 않았을 정도입니다. 그래도 게임은 남았습니다. 저는 누가 한 판 두자고 하면 거절하지 않습니다. 마지막 대국은 올해 샌프란시스코 유니언 스퀘어에서 동료이자 친구와 둔 것이었습니다. 저는 무릎 높이의 말이 놓인 커다란 야외 체스판에 약한데, 좋아하는 곳이 두 군데 있습니다. 하나는 루체른에, 하나는 이곳 바젤의 라인강 옆에 있습니다. 기차에서는 휴대폰으로 lichess에서 둡니다. 그리고 2020년대에 이 게임이 맞이한 묘한 두 번째 삶을 기대 이상으로 즐겼습니다. 가상의 신동을 다룬 텔레비전 시리즈가 사람들을 체스판 사러 나가게 했고, 그랜드마스터들은 어떤 대회장도 담을 수 없을 만큼의 시청자를 거느린 스트리머가 되었습니다. 저는 그런 일이 올 줄 몰랐고, 불만도 없습니다.
제 게임 생활의 나머지 절반은 독일어로 Aufbauspiele라고 부르는 것, 곧 건설 게임입니다. Anno, Die Siedler, 타이쿤 장르 전체처럼, 규칙이 있는 세계를 깔아 두고 그것이 돌아가는 모습을 지켜보는 모든 게임입니다. 허사비스의 *Theme Park*도 그중 하나라서, 그 장은 개인적으로 다가왔습니다. 감자튀김에 소금을 너무 많이 치면 목이 말라 음료를 더 사는 방문객들, 롤러코스터가 너무 빠르면 멀미를 하는 탑승객들은 제가 이런 게임을 하는 이유가 되는 바로 그런 종류의 메커니즘입니다. 저는 게임이 현실을 흉내 내려 하고, 두툼한 규칙 집합이 아무도 쓰지 않은 이야기를 만들어 내게 할 때 가장 좋아합니다. 제가 Dwarf Fortress를 사랑하는 이유도 그것이고, 자극 속에서 학습하는 [접시 위의 뉴런](https://raskell.io/articles/brain-emulation-as-an-infrastructure-problem/)에서부터 진화하도록 내버려 둔 [테라리움](https://terrarium.raskell.io)까지 제가 계속 저만의 시뮬레이션을 만드는 이유도 그것입니다. 그 관점에서 보면 체스 엔진은 만들 가치가 있는 가장 작은 시뮬레이션입니다. 규칙을 갖춘 완결된 세계, 그리고 그 안에서 배워야 하는 에이전트입니다.
## 왜 게임인가, 그리고 왜 이 세 가지인가 {#why-games-and-why-these-three}
섀넌의 요점은 실용적입니다. 체스 같은 게임에는 완전히 글로 적을 수 있는 규칙이 있고, 논쟁의 여지 없이 판 위에서 읽어 낼 수 있는 결과가 있으며, 아무리 연구해도 바닥나지 않는 깊이가 있습니다. 이런 조합은 드뭅니다. 대부분의 현실 문제는 규칙이 흐릿하고, 결과에 다툼이 있으며, 잣대가 없습니다. 게임은 새로운 아이디어를 오후 한나절 만에, 수백 년에 걸친 인간의 지식에 맞대어 시험할 수 있는 실험실을 주며, 그 답은 숫자로 나옵니다.
게다가 체스, 쇼기, 바둑은 이 분야의 역사가 바로 그 순서대로 펼쳐진 세 게임이기도 하며, 각 게임은 앞의 게임에서 통하던 것을 무너뜨렸습니다. 제가 하나가 아니라 세 가지를 모두 고른 이유가 그것입니다.
**체스**는 6세기 무렵 북인도에서 차투랑가로 생겨나 페르시아를 거쳐 유럽으로 건너갔고, 15세기 말 스페인과 이탈리아에서 멀리 움직이는 퀸과 비숍을 갖춘 현대의 형태를 얻었습니다. 섀넌이 고른 게임이고, 레비의 핸드북이 가르치는 게임이며, 탐색과 평가라는 고전적인 방법이 바로 그것을 위해 만들어진 게임입니다. 1997년 IBM의 Deep Blue는 전용 칩 위에서 초당 2억 개의 국면을 탐색하고, 사람이 작성하고 조정한 평가 함수를 써서 Garry Kasparov(가리 카스파로프)를 이겼습니다. 그것은 세 부분의 승리였고, 통찰을 기대한 사람에게는 실망이었습니다. 기계는 더 많이 이해해서가 아니라 더 멀리 내다봐서 이겼습니다. 레비의 장 이후로 흥미로운 질문은 평가 함수를 작성하는 대신 학습할 수 있느냐는 것이었습니다. 체스에서 이 질문은 2018년에서 2020년 사이에, 엔진의 가장 안쪽 루프 안에 사는 작은 신경망으로 답해졌습니다. 그 이름은 NNUE이고, 체스를 위해 발명된 것이 아닙니다.
**쇼기**는 같은 계열의 일본 갈래입니다. 11세기 무렵까지 중국과 동남아시아를 거쳐 일본에 들어왔고, 16세기 무렵 지금의 형태를 갖추었으며, 가장 뛰어난 기사들에게 녹봉을 준 도쿠가와 쇼군들 아래에서 하나의 제도가 되었습니다. 지금도 쇼기 챔피언에게 주어지는 칭호인 첫 명인(名人)은 1612년에 수여되었습니다. 오늘날 쇼기는 일본에서 수백만 명이 두는 게임으로, 프로 제도와 텔레비전으로 중계되는 타이틀전이 있고, 2023년 스물한 살의 나이로 8대 타이틀을 한꺼번에 보유한 젊은 스타 Sota Fujii(후지이 소타)가 있습니다. 판은 9×9이고, 양쪽은 각각 여덟 종류의 말 스무 개를 가지며, 대부분의 말은 판의 맨 끝 세 줄에 들어서면 승격합니다. 규칙 하나가 이것을 다른 게임으로 만듭니다. 잡은 말은 편을 바꾸어 잡은 쪽의 손으로 들어가고, 나중에 한 수로서 거의 모든 빈칸에 내려놓을 수 있습니다. 아무것도 판을 영영 떠나지 않으므로, 게임은 체스처럼 단순해지지 않습니다. 보통의 차례에 고를 수 있는 수는 체스의 35개 남짓에 비해 80개쯤이고, 대국은 더 길며, 종반은 기술적인 소모전이 아니라 서로 먼저 도달하려는 경주가 됩니다. 프로그래머에게 말 내려놓기는 평가 함수를 손으로 작성하기 훨씬 어렵게 만들며, 그래서 학습은 여기서 먼저 일어났습니다. 컴퓨터 쇼기는 2006년 Bonanza로 탈바꿈했습니다. 손으로 조정하지 않고 프로 기보에 맞추어 평가 함수를 학습시킨 최초의 프로그램이었습니다. 2017년에는 Ponanza가 현역 명인 Amahiko Sato(사토 아마히코)를 이겼고, 2018년에는 Yu Nasu(나스 유)가 네트워크 설계를 발표했는데, 2년 뒤 Stockfish가 그것을 체스에 채택했습니다. 제가 쫓던 아이디어는 쇼기에서 왔습니다.
**바둑**은 둘보다 오래되었고 어느 쪽보다도 단순합니다. 중국에서 생겨나 적어도 2500년의 역사를 지녔고, 음악, 서예, 그림과 함께 교양인의 네 가지 소양 가운데 하나로 꼽혔습니다. 8세기 무렵 일본에 전해졌는데, 에도 시대에는 프로 기사들의 가문이 막부의 지원을 받았습니다. 그리고 바둑이라고 불리는 한국에도 깊은 뿌리를 두고 있습니다. 규칙은 카드 한 장에 들어갑니다. 두 사람이 번갈아 19×19 격자의 교차점에 흑돌과 백돌을 놓습니다. 바로 옆에 빈 점이 하나도 없는 돌 무리는 잡혀서 판에서 들어냅니다. 끝났을 때 판을 더 많이 둘러싼 쪽이 이기며, 나중에 두는 백에게는 몇 집의 덤이 주어집니다. 이 규칙들로부터 매 차례 250개 안팎의 선택지가 있고, 한 판이 200수나 300수에 이르며, 아무도 손으로 점수를 매기지 못한 국면들을 지닌 게임이 나옵니다. 레비의 세 부분은 여기서 무너집니다. 바둑에서 네 수 앞을 내다보는 탐색은 거의 아무것도 보지 못하고, 잎 노드에서 적용할 누가 이기고 있는지에 대한 공식도 없습니다. 바둑은 허사비스를 포함해 이 분야의 모든 사람이 거대한 도전이라고 부른 게임이었고, DeepMind가 자신들이 가진 것을 보여 주고 싶을 때 고른 게임이었습니다. 2000년대 후반의 프로그램들은 체스의 방법을 몬테카를로 트리 탐색으로 바꾸었습니다. 무작위 대국 수천 판을 끝까지 두어 보고 누가 이기는지 세는 방법입니다. 그것으로 강한 아마추어 수준에는 이르렀지만 거기서 멈추었습니다. AlphaGo는 그 탐색을 유지하면서 두 개의 신경망을 붙였습니다. 하나는 수를 제안하고, 하나는 국면을 판정하며, 처음에는 사람의 기보로, 그다음에는 자기 기보로 학습했습니다. 그리고 2016년 3월, 이세돌을 4대 1로 이겼습니다.
정리하면 이렇습니다. 하나는 고전적인 방법이 통하고 네트워크가 평가 함수를 대신하는 게임, 하나는 같은 방법이 한계에 부딪히고 네트워크가 발명된 게임, 하나는 그 방법이 실패하고 네트워크가 탐색 자체를 이끌어야 하는 게임입니다. 셋을 합치면 이 분야 40년의 짧은 강의가 되며, 각각은 누구나 내려받을 수 있는 상대와 겨루어 측정할 수 있습니다.
## 왜 읽는 대신 만들었는가 {#why-i-built-it-rather-than-read-about-it}
허사비스는 만들 수 없는 것은 이해하지 못한 것이라는 Feynman(파인먼)의 말을 즐겨 인용하는데, 이것이 이 프로젝트의 솔직한 이유입니다. 저는 AlphaGo 논문과 Stockfish NNUE 해설을 한 번 넘게 읽었습니다. 그림을 설명할 수도 있었습니다. 하지만 K가 무엇인지, 같은 탐색 깊이에서 이기는 네트워크가 왜 같은 시간에서는 질 수 있는지, 한 세대의 자기 대국이 노트북의 수명에서 몇 시간을 잡아먹는지는 말할 수 없었을 것입니다. 그런 것들은 논문이 빼놓는 것이고, 그것을 배우는 유일한 방법은 직접 대가를 치르는 것이기 때문입니다. 책을 읽으면서 그 간극이 불편해졌고, 저를 테라리움 만들게 하는 그 근질거림이, 규칙을 갖춘 세계와 그 안의 학습자가 제 기계 위에서 돌아가기를 원했습니다.
또 다른 이유는 재료가 처음으로 모두 제 책상 위에 있다는 것입니다. 아이디어는 발표되어 있고, 참조 구현은 오픈 소스입니다. 노트북은 Apple M4에 코어 열 개, 메모리 16기가바이트를 갖춘 MacBook Pro로, 연구용 기계는 아니지만 범용 연산 능력은 Deep Blue보다 큽니다. 제 휴대폰의 브라우저는 이제 벡터 명령어와 진짜 스레드를 갖춘 컴파일된 코드를 실행할 수 있습니다. 그리고 코드를 작성하는 일 자체는, 예전 같으면 겨울 내내 저녁 시간을 바쳐야 했을 텐데, 코딩 에이전트와 함께 며칠 만에 끝났습니다. 무엇을 만들지는 제가 정하고, 타이핑의 대부분은 에이전트가 했습니다. 이것은 방법론에 속하는 이야기입니다. 에이전트가 코드를 썼고, 두 엔진 사이의 대국이 그 코드가 쓸 만한지를 판정했으며, 대국은 누가 코드를 썼는지 신경 쓰지 않습니다.
## 왜 PyTorch가 아니라 Rust인가 {#why-rust-and-not-pytorch}
2026년에 머신러닝을 하는 뻔한 방법은 Python과 PyTorch이고, 목표가 서버에서 질문에 답하는 모델이었다면 저도 그것을 썼을 것입니다. 목표는 제 휴대폰의 브라우저 탭 안에서, 오프라인으로 두는 상대였고, 그것이 그 아래의 모든 것을 바꾸었습니다.
체스 평가 함수는 요청당 한 번이 아니라 탐색 안에서, 코어 하나로, 배치 없이, 초당 약 100만 번 호출됩니다. 거기에 사는 네트워크는 API 뒤의 모델일 수 없습니다. 엔진과 같은 언어로 쓰인 수백 줄의 산술이어야 하고, 정수로 돌아가야 하며, 매번 처음부터 다시 계산하는 대신 수를 둘 때마다 점진적으로 갱신되어야 합니다. 바로 그것이 NNUE의 비결입니다. 다시 말해 추론은 어차피 손으로 작성해야 했습니다. 일단 그렇게 하고 나니, 학습기는 같은 산술을 거꾸로 돌리는 것이었습니다. 100만 개의 파라미터와 거의 전부가 0인 입력 위에서 말입니다. 그것 역시 수백 줄에 들어갔습니다. 그것을 직접 작성하는 일은 프레임워크가 제게서 숨겼을 것을 알아내는 방법이기도 했습니다. 맞추어 학습시키지 않고 짐작으로 정한 상수 하나가 이기는 네트워크를 지는 네트워크로 바꾸었는데, 프레임워크를 썼다면 저는 그 이유를 몰랐을 것입니다.
Rust는 [뉴런 배양](https://hotaru.raskell.io)에서 [판타지 콘솔](https://wasmad.raskell.io)까지 이 사이트에 있는 모든 것을 제가 작성하는 언어이고, 흔한 이유들로 엔진에 맞는 도구입니다. 초당 100만 번 도는 루프에 가비지 컬렉터가 없고, 메모리 배치를 통제할 수 있으며, 네이티브 바이너리와 같은 소스에서 벡터 명령어를 갖춘 WebAssembly를 만들어 내는 컴파일러가 있습니다. 노트북 위의 자기 대국에서 휴대폰 위의 한 수까지 하나의 언어가 하나의 저장소 안에서 돌아가고, 웹 앱에는 빌드 단계가 없습니다. 트레이드오프도 솔직하게 말씀드리겠습니다. 작고 희소한 네트워크를 CPU에서 학습시키는 것은 괜찮습니다. 하지만 바둑 네트워크가 수백만 개의 조밀한 파라미터를 가진 합성곱 신경망이 된다면, 코어 열 개 위의 Rust는 느릴 것이고, 저는 Metal 커널을 작성할지, 아니면 여기가 노트북 연구가 GPU를 만나는 지점이라고 인정할지 정해야 할 것입니다.
## 왜 WebAssembly인가 {#why-webassembly}
휴대폰이 핵심이기 때문입니다. 서버에 사는 상대는 제 것이 아닙니다. 앱 스토어에 있는 상대는 다른 누군가의 승인을 받아야 합니다. 홈 화면에 추가할 수 있고, 비행기 안에서도 작동하며, 제 노트북에서 돌아가는 것과 똑같은 바이너리를 실행하는 웹 페이지가 제가 원한 버전이었고, 2026년의 브라우저는 그것을 할 수 있습니다. WebAssembly는 한동안 128비트 벡터 명령어를 지원해 왔고, Safari는 이제 올바른 격리 헤더와 함께 제공되는 페이지라면 스레드 사이에 메모리를 공유하도록 허용합니다. 그래서 제 휴대폰의 체스 엔진은 네 개의 코어로 탐색합니다. 무료 체스 사이트인 Lichess는 분석 보드에서 같은 방식으로 Stockfish를 돌리는데, 이것이 시작하기 전에 이 접근이 타당하다는 제 증거였습니다.
이 제약은 어떤 논문보다도 설계를 많이 빚었습니다. 페이지와 함께 내려받아 휴대폰에서 실행해야 하는 네트워크는 작아야 합니다. Kishi의 체스 네트워크는 820킬로바이트이고 엔진 바이너리 안에 컴파일되어 들어갑니다. 브라우저 탭에서 돌아가야 하는 탐색은 검소해야 합니다. 코드에서 취향처럼 보이는 모든 결정은 사실 휴대폰이 무언가에 아니라고 말한 결과입니다.
## 무슨 일이 일어났는가 {#what-happened}
체스 엔진이 먼저였습니다. 비트보드, 흔히 쓰이는 가지치기 휴리스틱 계열을 갖춘 탐색, 그리고 잘 알려진 기물-칸 표에서 빌려 온 손으로 쓴 평가 함수입니다. lichess가 컴퓨터 상대를 설정하는 방식대로 설정한 Stockfish를 상대로, 단계마다 코어 하나로 20판씩 두었을 때, 이 엔진은 레벨 4를 19대 1로 이기고, 레벨 6을 13대 7로 이기며, 레벨 7에게는 19.5대 0.5로 집니다. lichess 컴퓨터와 두어 본 적이 있다면 그것으로 위치가 잡힐 것입니다. 클럽 수준의 탄탄한 선수이고, 정상과는 거리가 멉니다.
그다음은 루프였습니다. 엔진은 무작위 오프닝에서 출발해 52분 동안 자기 자신과 두었고, 그 결과 5만 7천 판에서 560만 개의 국면이 나왔습니다. 각 국면에는 탐색이 그것을 어떻게 보았는지와 대국이 어떻게 끝났는지가 레이블로 붙었습니다. 그 국면들로 20분이 채 안 되게 학습한 네트워크는, 양쪽이 같은 수의 국면을 살펴보도록 허용했을 때, 자기가 대체한 손으로 쓴 평가 함수를 레이팅 85점, 오차 ±32점 차로 이겼습니다. 양쪽에 같은 밀리초를 허용하자 둘은 비겼습니다. 네트워크는 국면 하나당 두 배 반의 비용이 들기 때문입니다. 이것이 이런 종류의 학습이 지닌 문제 전체를 한 문장으로 담은 것이고, 저는 숫자를 손에 쥐기 전에는 그것을 이해하지 못했습니다.
쇼기는 같은 모양의 자기 엔진과 손으로 쓴 평가 함수를 얻었고, 이 엔진은 Fairy-Stockfish의 가장 약한 설정을 20대 0으로 이기고 중간 정도의 설정에는 18대 2로 집니다. 바둑은 2000년대 후반의 방법, 곧 옛 MoGo 프로그램의 모양 패턴을 쓰는 몬테카를로 트리 탐색을 얻었고, 가장 낮은 레벨의 GNU Go를 상대로 한 수에 1초씩 주었을 때 열 판 중 세 판을 이깁니다. 셋 모두 휴대폰에서 둡니다. 높은 레벨에서 만족스러운 상대라고 부를 만한 것은 체스 하나뿐이고, 그것도 손으로 쓴 평가 함수로 그렇습니다. 학습한 네트워크는 아직 시계 위에서 제자리를 얻어 내지 못했기 때문입니다.
## 이것이 열어 준 것 {#what-this-opened-up}
저는 레비의 세 부분을 만들 수 있을까라는 하나의 질문으로 시작했고, 한 달을 다섯 개의 더 나은 질문으로 마무리했습니다.
체스 네트워크는 같은 탐색에서 이기고 같은 시간에서 비깁니다. 이것은 자기 대국의 세대가 거듭되어 학습 재료가 되는 대국이 강해지면 달라질까요, 아니면 노트북 크기의 네트워크는 언제나 자기 비용을 치르느라 바쁠까요? 이 글을 쓰는 지금도 루프는 낮은 우선순위로 돌아가고 있어서 노트북은 계속 쓸 수 있습니다. 왜 상수 하나가 결과를 레이팅 176점이나 흔들었을까요, 그리고 그것은 학습된 구성 요소와 그것이 꽂히는 손으로 조정된 시스템 사이의 계약에 대해 무엇을 말해 줄까요? 네트워크가 왕의 위치를 볼 수 있게 되면 같은 루프가 쇼기에서도 통할까요? 나스의 원래 설계는 그렇게 했고, 제 것은 아직 그렇지 않습니다. 바둑에는 두 번째 종류의 루프가 필요합니다. 탐색이 네트워크에게 어떤 수를 살펴볼지 가르치는 루프입니다. 저는 노트북이 19×19 전체 판에서 무엇을 학습할 수 있을지 모릅니다. 곧 다다를 이 책의 AlphaGo 장들은 2016년에 무엇이 필요했는지 알려 줄 것이고, 저는 2026년에 가게에서 산 기계로는 무엇이 필요한지 알고 싶습니다. 그리고 그 모든 것의 밑바닥에는 이런 질문이 있습니다. 엔진의 강함 가운데 얼마가 네이티브 바이너리에서 휴대폰 브라우저 탭으로 가는 여정을 견뎌 낼까요, 그리고 스레드는 그중 얼마를 되찾아 줄까요?
이 질문들은 각각 며칠의 작업과 몇 개의 숫자에 해당합니다. 저는 저장소에 [노트](https://github.com/raskell-io/kishi/blob/main/docs/study/notebook.md)를 쓰기 시작해서, 숫자가 나오는 대로 실패까지 포함해 적어 두고 있습니다. 답이 질문만큼 흥미롭다면, 이것은 여러 편의 글 가운데 첫 편이 될 수도 있습니다. 한 번에 아이디어 하나씩, 체스 먼저, 그다음 쇼기, 그다음 바둑. 지켜보겠습니다.
## 참고 문헌 {#references}
- Sebastian Mallaby, *The Infinity Machine: Demis Hassabis, DeepMind, and the Quest for Superintelligence* (Penguin Press, 2026), 1장부터 5장까지.
- Claude Shannon, [Programming a Computer for Playing Chess](https://www.computerhistory.org/chess/doc-431614f6d9b4e/), *Philosophical Magazine* (1950).
- David Levy, *The Chess Computer Handbook* (Batsford, 1984).
- Yu Nasu, [Efficiently Updatable Neural-Network-based Evaluation Functions for Computer Shogi](https://www.apply.computer-shogi.org/wcsc28/appeal/the_end_of_genesis_T.N.K.evolution_turbo_type_D/nnue.pdf) (2018, 일본어); Stockfish, [Introducing NNUE Evaluation](https://stockfishchess.org/blog/2020/introducing-nnue-evaluation/) (2020).
- David Silver 외, [Mastering the game of Go with deep neural networks and tree search](https://www.nature.com/articles/nature16961), *Nature* (2016).
- [Kishi](https://github.com/raskell-io/kishi): 엔진, 학습 루프, 그리고 모든 실행을 기록한 노트.
================================================================================
---
title: "에이전트란 실제로 무엇인가"
url: https://raskell.io/ko/articles/what-an-agent-actually-is/
author: Raffael Schneider
date: 2026-06-02
description: "AI 에이전트는 업계에서 가장 많은 뜻을 떠안은 단어입니다. 그 해부학과 계보, 그리고 Bun 위의 TypeScript 약 200줄로 만든 동작하는 구현을 다룹니다. The Agent Platform Handbook의 첫 번째 편입니다."
tags: [agents, ai-platforms, durable-execution, typescript]
series: the-agent-platform-handbook
lang: ko
translation_of: https://raskell.io/articles/what-an-agent-actually-is/
---
# 에이전트란 실제로 무엇인가
## 요약
에이전트는 목표, 모델, 컨텍스트, 도구, 루프라는 다섯 가지 속성을 지닌 소프트웨어입니다. 하나라도 빠지면 챗봇이나 워크플로, 혹은 한 번으로 끝나는 컴플리션(completion)이 됩니다. 아키텍처는 SHRDLU와 BDI 연구 때부터 이미 옳았습니다. 빠져 있던 것은 쓸 만한 언어 모델이었고, 이후 함수 호출이 루프를 소프트웨어 문제로 바꾸어 놓았습니다. 2025년부터 2026년 사이 코딩 에이전트와 뒤이어 어시스턴트 에이전트가 루프와 도구와 런타임을 하나로 묶었지만, 그 아래에 일관된 플랫폼을 갖춘 조직은 거의 없습니다. 이 시리즈는 그 간극을 메우려 합니다. 저는 셸 도구 하나와 반복 예산을 갖춘, 동작하는 에이전트를 Bun 위의 TypeScript로 만들고, 채팅 제품이 조용히 도구를 늘려 가면서 이름표가 아키텍처보다 뒤처진다는 것을 보여 드립니다. 챗봇은 모르는 것 때문에 실패하고 에이전트는 잘못 행동해서 실패합니다. 폭주하는 루프와 비용, 거짓 성공 보고, 격리의 부재, 숨은 상태 같은 실패 양상은 이후의 글들에서 다룹니다.
> *The Agent Platform Handbook. From Loop to Platform.* 1편. 하나의 루프에서 프로덕션 플랫폼까지 에이전트 스택을 따라가는 22편짜리 시리즈입니다. 다음 편: [Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/).
같은 날 회의 세 개에 들어가 보면 *에이전트*라는 단어가 세 가지 다른 뜻으로 쓰이는 것을 듣게 됩니다. 벤더는 로고가 붙은 채팅 창을 뜻합니다. 플랫폼 팀은 재시도가 달린 워크플로를 뜻합니다. 보안 책임자는 들여다볼 수 없는 자격 증명을 쥔 채 오래 실행되는 프로세스를 뜻합니다. 이들 가운데 완전히 틀린 사람은 없습니다. 그리고 같은 것을 말하는 사람도 없습니다.
이 글은 하나의 에이전트 루프에서 시작해 프로덕션 플랫폼까지 올라가는 시리즈의 첫 편입니다. 격리, 도구, 아이덴티티, 오케스트레이션을 이야기하기 전에, 다이어그램 한가운데 있는 그것이 실제로 무엇인지부터 합의해야 합니다. 그래서 먼저 정의를 내리고, 그 해부학을 그려 보고, 업계가 여기까지 오게 된 경로를 따라간 다음, Bun 위의 TypeScript 약 200줄로 동작하는 에이전트를 직접 만들어 보겠습니다.
글이 끝날 무렵이면 이 추상명사는 실행할 수 있는 구체적인 파일이 되어 있을 것입니다.
## 실무적인 정의 {#a-working-definition}
에이전트는 다섯 가지 속성을 지닌 소프트웨어입니다. 어느 하나라도 빠지면 그것은 다른 무언가가 됩니다.
1. **목표.** 단 하나의 프롬프트가 아닙니다. 시스템이 충족하려고 하는 목표 상태, 작업 설명, 또는 문제 진술입니다.
2. **모델.** 현재 상태와 목표를 다음 단계로 옮겨 주는 하나 이상의 추론 엔진입니다. 오늘날 이것은 거의 언제나 대규모 언어 모델입니다.
3. **컨텍스트.** 사용자 입력 외에 모델이 읽을 수 있는 정보입니다. 시스템 프롬프트, 문서, 이전 턴, 환경 상태, 설정 파일 같은 것들입니다.
4. **도구.** 모델이 호출하도록 허용된, 부수 효과를 일으키는 연산들의 이름 붙은 유한한 집합입니다. 파일 읽기. 셸 명령 실행. API 호출.
5. **루프.** 모델이 도구를 고르고, 도구가 실행되고, 그 결과가 컨텍스트로 다시 들어가고, 모델이 다시 고릅니다. 루프는 목표가 충족되거나, 예산이 소진되거나, 정지 조건에 걸리면 끝납니다.
프로덕션에는 보통 여섯 번째 속성이 있습니다. 루프가 끝난 뒤에도 살아남는 상태인 **메모리**입니다. 메모리는 [여섯 번째 글](https://raskell.io/articles/memory-is-a-write-path/)에서 별도의 계층으로 다루기로 하고, 이 첫 에이전트는 상태 없이 두겠습니다.
다섯 가지 속성을 모두 갖춘 시스템은 에이전트입니다. 넷만 갖춘 시스템은 따로 이름을 붙일 만한 다른 무언가입니다. 채팅 창에는 목표, 모델, 컨텍스트, 루프가 있지만 도구가 없으므로 챗봇입니다. CI 파이프라인에는 목표, 컨텍스트, 도구, 루프가 있지만 모델이 없으므로 워크플로입니다. 함수 호출에는 목표, 모델, 컨텍스트, 도구가 있지만 루프가 없으므로 한 번으로 끝나는 컴플리션입니다. 행동을 열린 결말로 만드는 것은 루프의 존재입니다. 그 루프를 중요하게 만드는 것은 도구의 존재입니다.
지금까지 출시된 모든 에이전트의 아키텍처 다이어그램은 이렇게 생겼습니다.
*The agent loop*
```text
+--------------+
| Goal |
| (user task) |
+-------+------+
|
v
+------------+ +---------------+ +------------+
| Context +-------->| Model |<--------+ Memory |
| docs, env, | | next action? | | (optional) |
| prior turns| +-------+-------+ +------------+
+------------+ |
| tool call
v
+---------------+
| Tool |
| shell, http, |
| file, custom |
+-------+-------+
|
| result
v
+---------------+
| Runtime |
| (where the |
| side effect |
| happens) |
+-------+-------+
|
v
+----------+----------+
| done? --no--> loop |
| | |
| yes |
| v |
| return |
+---------------------+
```
다이어그램은 일부러 작게 그렸습니다. 이 시리즈의 거의 모든 글은 이 그림을 다시 그리면서 구성 요소 하나를 열어 볼 것입니다. 두 번째 글은 런타임을 엽니다. 세 번째 글은 도구를 엽니다. 네 번째 글은 컨텍스트를 엽니다. 여섯 번째 글은 메모리를 엽니다. 일곱 번째 글은 모델을 엽니다. 시리즈 끝의 마무리 글은 이 모두를 하나의 레퍼런스 아키텍처로 조립합니다.
이 그림을 머릿속에 담아 두십시오. 다시 이 그림으로 돌아오겠습니다.
## 여기까지 오게 된 길 {#how-we-got-here}
이 절의 나머지는 배경으로 읽으셔도 되고, 이미 겪어 오셨다면 처음 두 소절은 건너뛰셔도 됩니다. 2024년부터 2026년까지를 다루는 세 번째 소절은 어느 쪽이든 읽어 볼 만합니다. 함께 일하는 모든 사람이 왜 갑자기 *에이전트*라는 단어를 쓰는지 설명해 주기 때문입니다.
### 옛 AI {#the-old-ai}
소프트웨어 에이전트라는 아이디어는 현대의 LLM보다 약 50년 앞섭니다. 1970년 Terry Winograd(테리 위노그라드)의 SHRDLU는 자연어 명령을 받아, 시뮬레이션된 블록 세계에서 행동을 계획하고, 실행하고, 내부 상태를 갱신하는 프로그램이었습니다. 목표가 있었고, 세계에 대한 모델이 있었고, 도구 집합과 루프가 있었습니다. 그것은 에이전트였습니다. 블록 세계 안에서는 훌륭하게 작동했지만 그 밖으로 한 걸음만 나가면 곧바로 무너졌습니다. 세계에 대한 모델은 손으로 코딩한 것이었고 언어 이해는 깨지기 쉬웠기 때문입니다.
1980년대와 1990년대 내내 이 아이디어는 이름을 바꾸어 가며 계속 돌아왔습니다. 전문가 시스템은 비즈니스 로직을 추론 규칙으로 감쌌습니다. Bratman(브랫먼) 등이 정식화한 믿음-욕구-의도(Belief-Desire-Intention) 아키텍처는 에이전트에게 명시적인 인지 모델을 주었습니다. 에이전트가 무엇을 믿는지, 무엇을 원하는지, 다음에 무엇을 하려고 하는지에 대한 모델입니다. 좋은 논문들이 있었고, 동작하는 시스템과 출시된 제품도 있었습니다. 이들 모두가 놓친 것은 쓸 만한 언어 모델이었습니다. 에이전트의 목표를 형식 논리나 구조화된 DSL로 명세할 수는 있었습니다. 하지만 “비행기 표 좀 예약해 줘”라고 말해서 그것을 해석하게 할 수는 없었습니다.
이 시대의 교훈은 아키텍처가 수십 년 동안 옳았다는 것입니다. 병목은 모델이었습니다.
### 채팅의 시대 {#the-chat-era}
2020년 GPT-3가, 2022년 말 ChatGPT가 등장하자 언어의 병목이 무너졌습니다. 마침내 목표를 영어로 쓰면 시스템이 앞뒤가 맞게 응답했습니다. 업계의 첫 반응은 그 능력을 채팅 창으로 감싸서 파는 것이었습니다. 그것은 에이전트가 아닙니다. 루프도 도구도 없고, 모델은 자신이 사는 세계에 아무것도 할 수 없습니다. 대화를 기억하는 아주 좋은 자동 완성입니다.
에이전트 패턴은 누군가가 뻔한 다음 질문을 던졌을 때에야 돌아왔습니다. 모델이 영어를 읽고 쓸 수 있고, 우리가 모델에게 함수를 호출하게 할 수 있다면, 루프를 닫아서 모델이 행동하게 할 수 있지 않을까?
2022년 말부터 2023년 초 사이 두 편의 논문과 두 개의 화제가 된 데모가 그 질문에 답했습니다.
논문이 먼저였습니다. 2022년 10월에 발표된 Yao(야오) 등의 *ReAct: Synergizing Reasoning and Acting in Language Models*는 추론 단계와 도구 사용 단계를 번갈아 끼워 넣으면 어느 한쪽만 쓸 때보다 성능이 좋아진다는 것을 보여 주었습니다. 청사진은 냅킨 한 장에 들어갈 만큼 작았습니다. 생각하고, 행동하고, 관찰하고, 반복한다. 이것은 그 뒤로 출시된 거의 모든 에이전트의 사실상 표준 패턴이 되었습니다.
데모는 2023년 초에 나왔습니다. 2023년 3월 Toran Bruce Richards(토런 브루스 리처즈)가 공개한 Auto-GPT는 GPT-4를 바로 그 루프로 감싸 사람 없이 돌아가게 했습니다. 데모는 눈부셨고 끊임없이 고장 났습니다. 몇 주 뒤 Yohei Nakajima(나카지마 요헤이)의 BabyAGI는 약 100줄의 Python으로 같은 일을 했습니다. 둘 다 프로덕션 수준은 아니었습니다. 둘 다 ReAct 논문을 읽어 본 적 없는 사람들에게 그 아이디어를 알아볼 수 있게 만들었습니다. Auto-GPT 이후로는 “ChatGPT인데 작업이 끝날 때까지 계속 움직인다고 생각해 보세요”라는 말로 에이전트를 설명할 수 있었습니다. 그것은 엔지니어링이 아니라 마케팅의 돌파구였지만, 아이디어는 마케팅을 통해 퍼집니다.
뒤이은 엔지니어링의 돌파구는 2023년 6월에 출시된 OpenAI의 함수 호출 API였습니다. 자유로운 산문에서 “모델이 `search(query)`를 호출하고 싶어 한다”는 것을 파싱해 내려 애쓰는 대신, JSON 스키마로 도구를 선언하면 모델이 구조화된 도구 호출을 돌려주었습니다. Anthropic의 `tool_use`도 같은 패턴으로 출시되었습니다. 함수 호출과 함께 에이전트 루프는 정규식 문제이기를 멈추고 소프트웨어 문제가 되었습니다. 이 이야기는 [세 번째 글](https://raskell.io/articles/tools-how-agents-actually-do-things/)에서 다시 다룹니다.
2023년의 물결은 최초의 진짜 프레임워크들을 낳았습니다. 2022년 10월의 LangChain, 2023년 말의 AutoGen, 2024년의 CrewAI와 LangGraph입니다. 이들은 추상화로 경쟁했습니다. 어떤 것은 이겼고 어떤 것은 졌습니다. 이들은 이후의 글에서 살펴보겠습니다. 지금 중요한 것은 2024년 중반이 되자 에이전트를 만드는 일이 연구 프로젝트가 아니라 Python이나 TypeScript 연습 문제가 되었다는 점입니다.
### 2025년에서 2026년의 번들링 {#the-2025-to-2026-bundling}
여기서 *에이전트*라는 단어는 연구 용어이기를 멈추고 제품 범주가 되었습니다. 이 일은 두 차례의 물결로 일어났습니다.
첫 번째 물결은 빌더를 향한 것이었습니다. 2025년 초 Anthropic은 Claude Code를 출시했습니다. 노트북에서 돌아가며 파일을 편집하고, 셸 명령을 실행하고, 하위 에이전트를 띄울 수 있는 명령줄 에이전트였습니다. OpenAI는 Codex를 컴플리션 엔드포인트가 아닌 진짜 에이전트로 다시 내놓았습니다. 오픈 소스 커뮤니티는 OpenCode와 그 주변의 여섯 개 남짓한 프로젝트(aider, continue, opencoder)를 내놓아, 같은 형태에 벤더 중립적인 표면을 주었습니다. 이들 가운데 기술적으로 새로운 것은 없었습니다. 루프는 ReAct 루프였습니다. 도구는 `bash`와 `edit`였습니다. 새로웠던 것은 번들링이었습니다. 루프와 도구와 런타임이 30초 만에 설치할 수 있는 바이너리 하나에 함께 담겨 도착했습니다. 그것이 출시되자, 모든 인프라 및 플랫폼 엔지니어는 일주일 안에 노트북에 동작하는 에이전트를 갖게 되었습니다.
그다음에 일어난 일은 [What Sixteen AI Agents Taught Me About Management](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/)에 썼습니다. 빌더들은 동작하는 에이전트를 갖게 되자 하나보다 많이 돌리고 싶어 했습니다. 하나보다 많이 돌리자 조정 문제에 부딪혔습니다. 조정 문제에 부딪히자, 에이전트 오케스트레이션이 소프트웨어 포장을 두른 관리의 문제라는 것을 알게 되었습니다.
두 번째 물결은 어시스턴트를 향한 것이었고, 개발자 청중을 완전히 벗어났습니다. OpenClaw는 2026년 초에 출시되어 첫 주에 GitHub 스타 10만 개를 넘겼습니다. Hermes가 같은 길을 따랐습니다. 둘 다 에이전트 패턴을 코드를 쓰지 않는 사람들에게 건넸습니다. 리서치 작업. 계약서 검토. 일정 조율. 같은 루프에 다른 도구와 다른 컨텍스트를 붙인 것입니다. 기업의 구매자는 더 이상 개발자 도구 팀이 아니라 워크플로가 있는 모든 사업 부서가 되었습니다.
2026년 중반인 지금, 시장은 바로 여기에 있습니다. 모든 엔지니어링 조직에는 코딩 에이전트를 로컬에서 돌리는 빌더들이 있습니다. 모든 비즈니스 조직에는 어시스턴트 에이전트를 시범 운영하는 누군가가 있습니다. 그 모든 것 아래에 일관된 플랫폼을 갖춘 조직은 거의 없습니다. 이 시리즈의 목적은 그 간극을 메우는 것입니다.
## 하나 만들어 보기 {#build-one}
에이전트가 무엇인지는 하나를 만들어 보면서 배우게 됩니다. 이어지는 코드는 Bun 위의 TypeScript로 쓴, 완전히 동작하는 에이전트입니다. 약 200줄입니다. 명령줄에서 목표를 읽고, 작은 도구 레지스트리와 함께 Anthropic의 API를 호출하고, 도구 호출을 실행하고, 결과를 되먹이고, 모델이 끝내거나 반복 예산이 소진되면 멈춥니다.
따라 하려면 세 가지가 필요합니다.
```
bun --version # 1.1 or newer
echo $ANTHROPIC_API_KEY # any valid key
bun add @anthropic-ai/sdk
```
이 글의 전체 소스는 [`the-agent-platform-handbook`](https://github.com/raskell-io/the-agent-platform-handbook)의 `post-01` 태그에 있습니다. 코드를 에디터에서 읽고 싶으시다면 클론해서 `bun agent.ts "list the three largest files under /etc"`를 실행해 보셔도 됩니다.
### 도구 인터페이스 {#the-tool-interface}
가장 먼저 정의할 만한 가장 작은 단위는 도구입니다. 도구에는 이름, 모델이 읽을 수 있는 설명, 입력에 대한 JSON 스키마, 그리고 부수 효과를 실행하고 문자열을 돌려주는 함수가 있습니다.
```typescript
// tools.ts
export type Tool = {
name: string;
description: string;
input_schema: {
type: "object";
properties: Record;
required?: string[];
};
run: (input: Record) => Promise;
};
```
이것이 계약의 전부입니다. `run` 함수가 문자열을 돌려주는 것은 모델이 결과를 텍스트로 읽기 때문입니다. 도구가 구조화된 데이터를 돌려준다면 `JSON.stringify`로 직렬화하고 파싱은 모델에게 맡기십시오. 이 선택은 [세 번째 글](https://raskell.io/articles/tools-how-agents-actually-do-things/)에서 구조화된 출력을 더 자세히 볼 때 다시 살펴보겠습니다.
에이전트에게 줄 수 있는 단일 도구 가운데 가장 쓸모 있는 셸 도구는 이렇게 생겼습니다.
```typescript
// tools.ts (continued)
export const shell: Tool = {
name: "shell",
description:
"Run a shell command in the current working directory and return its stdout, stderr, and exit code as JSON.",
input_schema: {
type: "object",
properties: {
command: {
type: "string",
description: "The shell command to run. Runs under `sh -c`.",
},
},
required: ["command"],
},
run: async ({ command }) => {
const proc = Bun.spawn(["sh", "-c", String(command)], {
stdout: "pipe",
stderr: "pipe",
});
const [stdout, stderr] = await Promise.all([
new Response(proc.stdout).text(),
new Response(proc.stderr).text(),
]);
const code = await proc.exited;
return JSON.stringify({ code, stdout, stderr });
},
};
```
눈여겨볼 점이 몇 가지 있습니다. 설명은 여러분이 아니라 모델을 위해 쓴 것입니다. 도구가 무엇을 하는지, 무엇을 돌려주는지, 어떤 제약이 있는지 구체적으로 쓰십시오. JSON 스키마는 모델이 이 도구를 호출할지 결정할 때 보는 계약입니다. Bun의 `Bun.spawn`은 스트림을 돌려주므로, stdout과 stderr를 모두 읽어 종료 코드와 함께 모델이 추론할 수 있는 하나의 JSON 페이로드로 묶습니다.
이 도구는 어떤 셸 명령이든 실행합니다. 터무니없이 위험합니다. 배포하지 마십시오. 그 이유와 대처법을 설명하는 데 [두 번째 글](https://raskell.io/articles/your-agent-wants-root/)을 통째로 쓰겠습니다. 여러분의 노트북에서 사용자 한 명, 디렉터리 하나로 돌리는 데모라면 괜찮습니다.
### 루프 {#the-loop}
루프는 대부분의 설명이 서둘러 지나가는 부분입니다. 천천히 보겠습니다.
```typescript
// agent.ts
import Anthropic from "@anthropic-ai/sdk";
import type { MessageParam, ToolResultBlockParam } from "@anthropic-ai/sdk/resources/messages";
import { shell, type Tool } from "./tools";
const client = new Anthropic();
const tools: Tool[] = [shell];
const SYSTEM_PROMPT = `You are a careful command-line assistant.
You have access to a shell tool. Use it to investigate the user's
request and answer concretely. When you have the answer, stop calling
tools and reply in plain text.`;
```
SDK를 가져오고, 도구 하나를 등록하고, 시스템 프롬프트를 씁니다. 시스템 프롬프트는 사용자 입력이 아닌 첫 번째 컨텍스트입니다. 이것을 진짜 컨텍스트 전략으로 키우는 방법은 [네 번째 글](https://raskell.io/articles/context-is-the-product/)에서 다룹니다. 지금은 모델에게 어떻게 행동할지 알려 주는 한 문단일 뿐입니다.
```typescript
// agent.ts (continued)
async function step(messages: MessageParam[]) {
return client.messages.create({
model: "claude-sonnet-4-6",
max_tokens: 4096,
system: SYSTEM_PROMPT,
tools: tools.map(({ run, ...t }) => t),
messages,
});
}
```
모델을 부르는 한 번 한 번이 `step`입니다. 우리가 보내는 도구 목록은 스키마뿐이고 `run` 함수는 절대 보내지 않으므로, 그것을 떼어 냅니다. 모델이 돌려주는 메시지는 최종 텍스트 답변이거나, 하나 이상의 도구를 호출해 달라는 요청입니다.
루프 자체는 50줄입니다.
```typescript
// agent.ts (continued)
export async function run(goal: string, maxIterations = 10) {
const messages: MessageParam[] = [{ role: "user", content: goal }];
for (let i = 0; i < maxIterations; i++) {
const response = await step(messages);
messages.push({ role: "assistant", content: response.content });
if (response.stop_reason === "end_turn") {
const text = response.content
.filter((b) => b.type === "text")
.map((b) => (b as { text: string }).text)
.join("\n");
console.log(text);
return;
}
if (response.stop_reason !== "tool_use") {
throw new Error(`unexpected stop reason: ${response.stop_reason}`);
}
const toolResults: ToolResultBlockParam[] = [];
for (const block of response.content) {
if (block.type !== "tool_use") continue;
const tool = tools.find((t) => t.name === block.name);
if (!tool) {
toolResults.push({
type: "tool_result",
tool_use_id: block.id,
content: `unknown tool: ${block.name}`,
is_error: true,
});
continue;
}
console.error(`> ${block.name} ${JSON.stringify(block.input)}`);
try {
const result = await tool.run(block.input as Record);
toolResults.push({ type: "tool_result", tool_use_id: block.id, content: result });
} catch (err) {
toolResults.push({
type: "tool_result",
tool_use_id: block.id,
content: String(err),
is_error: true,
});
}
}
messages.push({ role: "user", content: toolResults });
}
console.error(`iteration limit (${maxIterations}) reached`);
}
```
한 번 따라가 보겠습니다. 목표를 첫 번째 사용자 메시지로 두고 시작합니다. 모델을 호출합니다. 모델의 응답을 대화에 덧붙입니다. 모델이 `end_turn`이라고 하면 최종 텍스트를 출력하고 반환합니다. 모델이 `tool_use`라고 하면 요청된 도구를 찾아 실행하고, 그 결과를 사용자 역할의 `tool_result` 블록으로 덧붙입니다. 모델은 다음 턴에서 그 결과를 보고 무엇을 할지 정합니다.
`maxIterations`가 달린 `for` 루프는 이 에이전트와 끝없는 실행 사이에 서 있는 유일한 것입니다. 반복 횟수가 올바른 예산 단위인지는 [여덟 번째 글](https://raskell.io/articles/the-bill-is-part-of-the-loop/)의 상당 부분을 들여 다루겠습니다. 올바른 단위는 아니지만 가장 단순한 단위입니다. 가장 단순한 것에서 시작하십시오.
진입점은 두 줄입니다.
```typescript
// agent.ts (continued)
const goal = process.argv.slice(2).join(" ");
if (!goal) {
console.error("usage: bun agent.ts ''");
process.exit(1);
}
await run(goal);
```
이것이 에이전트의 전부입니다. import와 시스템 프롬프트를 포함해 약 140줄의 코드입니다. 처음에 내린 정의에 따르면 이것은 진짜 에이전트입니다. 목표, 모델, 컨텍스트(시스템 프롬프트와 계속 쌓이는 메시지 목록), 도구(하나), 루프(`maxIterations`가 달린 `for`)가 있습니다.
### 실행해 보기 {#running-it}
짧은 실행 기록을 보면 루프가 구체적으로 보입니다.
```
$ bun agent.ts "what is the largest TypeScript file under src and what does it do?"
> shell {"command":"find src -name '*.ts' -type f -printf '%s %p\n' | sort -nr | head -5"}
> shell {"command":"wc -l src/agent.ts"}
> shell {"command":"head -40 src/agent.ts"}
The largest TypeScript file under src is src/agent.ts at 4837 bytes
(150 lines). It implements an agent loop against the Anthropic Messages
API. It defines a single shell tool, sends the user's goal to the model,
executes any tool calls the model requests, feeds the results back, and
stops when the model returns an end_turn response or the iteration
budget of 10 steps is exhausted.
```
`>`로 시작하는 줄은 에이전트의 도구 호출로, 루프 안의 `console.error`가 남긴 로그입니다. 마지막 문단은 모델의 `end_turn` 텍스트입니다. 도구 호출 세 번, 최종 답변 하나, 닫힌 루프 하나.
여러분은 이제 에이전트를 갖게 되었습니다.
## 대부분의 에이전트 데모가 에이전트가 아닌 이유 {#why-most-agent-demos-are-not-agents}
정의가 구체적이 되었고 동작하는 예시도 생겼으니, 무엇이 에이전트이고 무엇이 아닌지라는 질문이 쓸모 있어집니다. 정직한 답은 이 표에 있습니다.
| 시스템 | 목표 | 모델 | 컨텍스트 | 도구 | 루프 | 판정 |
|--------------------------------------|:----:|:-----:|:-------:|:-----:|:----:|-------------|
| ChatGPT, 2022년 출시 당시 | Y | Y | Y | N | Y | 챗봇 |
| 오늘의 ChatGPT(웹 탐색, 코드, 파일) | Y | Y | Y | Y | Y | 에이전트 |
| Cursor의 인라인 편집 | Y | Y | Y | Y | N | 컴플리션 |
| GitHub Actions 워크플로 | Y | N | Y | Y | Y | 워크플로 |
| 순수한 검색 증강(RAG) 채팅 | Y | Y | Y | N | Y | 챗봇+RAG |
| 함수 호출 API 호출 한 번 | Y | Y | Y | Y | N | 도구 호출 |
| 터미널의 Claude Code | Y | Y | Y | Y | Y | 에이전트 |
| 이 글의 스크립트 | Y | Y | Y | Y | Y | 에이전트 |
| Auto-GPT, BabyAGI | Y | Y | Y | Y | Y | 에이전트 |
| OpenClaw | Y | Y | Y | Y | Y | 에이전트 |
| LLM 단계가 있는 Temporal 워크플로 | Y | Y | Y | Y | Y | 에이전트 |
처음 두 행은 2년을 사이에 둔 같은 제품입니다. ChatGPT는 2022년 11월 도구 없는 채팅 창으로 출시되었습니다. 오늘날 같은 웹 UI는 실시간 웹을 탐색하고, 샌드박스 런타임에서 Python을 실행하고, PDF를 변환해 읽고, 이미지를 생성할 수 있습니다. 선을 넘은 것입니다. 흥미로운 점은 사용자에게 보이는 언어는 바뀌지 않았다는 것입니다. 여전히 챗봇이라고 불립니다. 우리가 쓰고 있는 정의로는 에이전트입니다. 마케팅 아래에서 경계가 움직였습니다.
앞으로 2년 동안 업계 전반에서 예상해야 할 패턴이 바로 이것입니다. 모든 채팅 제품은 조용히 도구를 늘려 갈 것입니다. 모든 워크플로 제품은 조용히 모델을 들여올 것입니다. 이름표는 아키텍처보다 1년이나 2년 뒤처질 것입니다. 이름표에만 귀를 기울이면, 어떤 시스템이 거버넌스를 다르게 적용해야 할 무언가로 바뀌는 순간을 놓치게 됩니다.
순수 RAG 행은 선을 넘지 않는 행입니다. 자기 컨텍스트를 풍부하게 하기만 하는 검색 증강 채팅은 중요한 의미에서의 도구를 얻지 못합니다. 모델은 찾아낸 것을 바탕으로 무언가 다른 일을 하기로 결정할 수 없습니다. 더 풍부한 컨텍스트에서 답할 뿐입니다. 쓸모 있고 때로는 훌륭하지만 에이전트는 아닙니다. 같은 시스템이 “다른 질의로 다시 검색하기”나 “이 문서 가져오기” 같은 도구를 얻는 순간, 그것은 에이전트가 됩니다.
LLM 단계가 있는 Temporal 행은 정반대의 이유로 흥미롭습니다. 그것은 에이전트입니다. 동시에 워크플로이기도 합니다. 두 범주는 서로 배타적이지 않습니다. 거의 모든 에이전트의 프로덕션 버전이 왜 결국 지속형(durable) 워크플로에 감싸이게 되는지는 이후의 글에서 설명하겠습니다.
이 표의 요점은 단어의 문지기 노릇을 하는 것이 아닙니다. 개념적인 구분을 가리키는 것입니다. 챗봇은 모르는 것 때문에 실패합니다. 에이전트는 잘못 행동해서 실패합니다. 시스템이 행동할 수 있게 되면 실패 양상이 바뀌고, 운영자에게 져야 할 책임도 바뀝니다.
## 실패 양상 {#failure-modes}
위의 스크립트는 처음 열 번은 잘 돌아갈 것입니다. 이 스크립트가 지닌 실패 양상 가운데 어떤 것은 뻔합니다. 어떤 것은 프로덕션에서만 보입니다. 대략 마주치게 될 순서대로 정직하게 꼽은 목록입니다.
- **진전으로 위장한 무한 루프.** 모델은 수렴하지 않은 채 끝없이 도구를 호출할 수 있습니다. 오늘은 `maxIterations = 10`이 여러분을 여러분 자신의 데모로부터 구해 줍니다. 내일 누군가 더 어려운 질문을 던지면 구해 주지 못합니다. 진짜 예산은 단계가 아니라 토큰이나 실제 경과 시간을 기준으로 합니다. 이 문제는 [여덟 번째 글](https://raskell.io/articles/the-bill-is-part-of-the-loop/)에서 제대로 고치겠습니다.
- **비용 폭주.** 모든 반복은 대화 전체를 입력으로 받는 완전한 모델 호출입니다. 새 턴마다 이전 턴을 모두 다시 보내기 때문에, 토큰 비용은 단계 수에 대해 대략 제곱으로 늘어납니다. 열 단계짜리 루프는 한 단계 호출의 열 배보다 많은 비용이 듭니다. 프롬프트 캐싱이 도움이 됩니다. 값싼 턴에 더 작은 모델을 쓰면 더 도움이 됩니다. 이 주제에는 [여덟 번째 글](https://raskell.io/articles/the-bill-is-part-of-the-loop/)을 쓰겠습니다.
- **성공에 대한 거짓말.** 모델은 실제로 확인하지 않고도 작업을 끝냈다고 주장할 수 있습니다. 셸 도구는 답이 맞는지 확인하지 않습니다. “X를 했나요?”라고 물으면, 사실은 “시도했고, 실패했고, 포기했다”인데도 “네”라는 답을 들을 수 있습니다. 평가(eval)는 이것을 위해 존재합니다. 이후의 글에서 설명하겠습니다.
- **망가진 도구 출력.** 도구가 1메가바이트짜리 바이너리 데이터를 돌려주면 모델은 숨이 막히거나 환각을 일으킵니다. 도구 출력은 요약하거나, 잘라 내거나, 스키마에 맞게 다듬어야 합니다. 에이전트가 대신 해 주지 않습니다.
- **격리의 부재.** 모델이 `rm -rf $HOME`이 맞는 명령이라고 판단하면 셸 도구는 그것을 실행합니다. 모델이 그렇게 판단하는 일은 자주 있지 않을 것입니다. 하지만 적어도 한 번은 있을 것입니다. 이것이 다음 글의 주제입니다.
- **숨은 상태.** 모든 도구 호출은 런타임에 부수 효과를 남깁니다. 파일이 생기고, 네트워크 호출이 일어나고, 데이터베이스 행이 삽입됩니다. 대화 로그는 그 어느 것도 담지 않습니다. 모델의 추론은 재생할 수 있습니다. 모델이 추론하던 대상인 세계는 재생할 수 없습니다. 진지한 시스템은 멱등성과 지속형 실행(durable execution)으로 이것을 다룹니다.
- **동시성 엣지 케이스.** 이 루프는 순차적입니다. 모델은 한 턴에 여러 도구를 요청할 수 있고, 위의 예시는 그것들을 차례로 실행합니다. 그 도구들 가운데 두 개가 같은 파일에 쓰려고 하면, 모델은 볼 수 없는 버그가 생깁니다.
이 가운데 어느 것도 에이전트를 만들지 말아야 할 이유는 아닙니다. 이것들은 이 시리즈의 나머지가 존재하는 이유입니다.
## 이 글이 일부러 빼놓은 것 {#what-this-post-left-out-on-purpose}
긴 글이라도 빠지는 것은 있습니다. 의도적으로 빼놓은 것들과, 그것을 다루는 글을 함께 적어 둡니다.
- **격리.** 셸 도구는 위험합니다. [두 번째 글: Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/)에서 고칩니다.
- **진짜 도구 레지스트리.** 도구 하나는 데모입니다. 쓸모 있는 에이전트에는 네 개에서 열두 개쯤의 도구가 있습니다. [세 번째 글](https://raskell.io/articles/tools-how-agents-actually-do-things/)에서 다룹니다.
- **컨텍스트 전략.** 시스템 프롬프트는 한 문단입니다. 진짜 시스템은 디스크에서 컨텍스트를 불러와 작업마다 다듬습니다. [네 번째 글](https://raskell.io/articles/context-is-the-product/)과 [다섯 번째 글](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/)에서 다룹니다.
- **세션을 넘나드는 메모리.** 이 에이전트는 실행과 실행 사이에 모든 것을 잊습니다. [여섯 번째 글](https://raskell.io/articles/memory-is-a-write-path/)에서 다룹니다.
- **모델 선택.** 우리는 모델 하나를 하드코딩했습니다. 프로덕션 에이전트는 라우팅을 합니다. [일곱 번째 글](https://raskell.io/articles/the-model-is-a-dependency/)에서 다룹니다.
- **도구 프로토콜.** 이 도구 인터페이스는 직접 만든 것입니다. 업계는 MCP로 수렴했습니다. 이후의 글에서 다룹니다.
- **프레임워크.** 우리는 이것을 맨손으로 만들었습니다. 프레임워크 이야기는 시리즈 후반에 나옵니다.
- **아이덴티티, 평가, 지속성, 경제성, 거버넌스.** 시리즈의 네 번째와 다섯 번째 아크(arc) 전체에서 다룹니다.
시리즈의 목차를 보시면 그 모양이 보입니다. 시리즈의 나머지 글은 하나하나가 방금 만든 에이전트의 한계를 하나씩 고칩니다.
## 플랫폼에서 이것이 놓이는 자리 {#where-this-lands-in-the-platform}
이 글 맨 위의 다이어그램은 최종 레퍼런스 아키텍처에서 가장 작은 상자입니다. 에이전트 루프는 런타임 안에 있습니다. 런타임은 플릿(fleet) 안에 있습니다. 플릿은 아이덴티티, 관측 가능성, 거버넌스, 컨트롤 플레인을 갖춘 플랫폼 안에 있습니다. 시리즈 끝에서 우리가 도달하는 모양은 처음에 시작한 모양과 같습니다. 그것을 엔터프라이즈 규모로 키우고, 모든 구성 요소를 열어 각자에 프로덕션 수준의 이야기를 붙인 것입니다.
시리즈 전체를 하나의 규칙으로 머릿속에 담아 둘 수 있습니다. 각 글은 스택에 계층 하나를 더하고, 그 아래 계층만으로는 왜 충분하지 않았는지를 설명합니다.
다음 계층은 런타임입니다. 방금 프런티어 모델에게 건넨 셸 도구는 장전된 총입니다. 다음 주에는 그 총구를 안전한 곳으로 돌리는 방법을 설명하겠습니다.
## 다음 글 {#next}
**2편: [Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/).** Docker 컨테이너만으로는 왜 충분하지 않은지, 그리고 Firecracker, gVisor, Kata가 실제로 무엇을 해결하는지. 목요일에 게시됩니다.
================================================================================
---
title: "추론의 경제학"
url: https://raskell.io/ko/articles/the-economics-of-inference/
author: Raffael Schneider
date: 2026-04-22
description: "추론 토큰은 API 호출이 아닙니다. 소비되고, 가치를 만들고, 전력 소모와 상관관계가 있는 계량 자원입니다. AI 이후 세계의 경제학은 소프트웨어보다 물, 전기, 가스에 더 가깝습니다."
tags: [inference, economics, sovereignty, edge-systems, gpus, energy, semiconductors]
lang: ko
translation_of: https://raskell.io/articles/the-economics-of-inference/
---
# 추론의 경제학
## 요약
에이전트 열여섯 개를 돌리다 토큰이 바닥난 일은 예산 문제가 아니었습니다. 그것은 추론을 유틸리티, 곧 전기나 수도 같은 공공 서비스로 처음 경험한 일이었습니다. 끊임없이 소비되고, 단위마다 계량되며, 무거운 물리적 인프라가 뒷받침하는 자원입니다. 추론은 성숙한 유틸리티와 같은 공급망을 갖고 있습니다. 칩, 데이터, 인재, 에너지 위에 세워져 있고, 병목은 칩 제조에 있으며, 지정학적 위험은 대만과 수출 통제를 둘러싸고 있습니다. AI의 능력이 그 뒤를 받치는 물리적 인프라보다 빠르게 자란다면, AI의 결정적 제약은 소프트웨어가 아니라 유틸리티 계층입니다. 병목은 계량기였습니다. 유틸리티식 요금 체계, 유럽이 러시아 가스로 배운 것과 같은 주권 문제, 공학의 한 분야로서의 토큰 효율, 그리고 필수 도구로서의 계량과 관측 가능성이 등장할 것입니다.
[이전 글](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/)에서 저는 2025년 크리스마스 동안 AI 에이전트 열여섯 개를 하나의 가상 회사로 운영한 이야기를 했습니다. 아키텍처는 제대로 작동했습니다. 조정 모델도 제대로 작동했습니다. 작동하지 않은 것은 경제성이었습니다. 제 토큰 예산은 며칠 만에 증발했습니다. 에이전트들이 생산적이지 않아서가 아니라, 모든 조정 행위, 모든 상태 보고, 모든 에스컬레이션이 제가 충분히 빨리 채워 넣을 수 없는 계량 자원을 소비했기 때문입니다.
당시 저는 이것을 예산 문제로 보았습니다. 제 개인용 구독으로는 에이전트끼리 주고받는 통신의 부담을 감당할 수 없었습니다. API 접근권과 제대로 된 예산을 가진 기업이라면 같은 제약을 겪지 않았을 것입니다. 그 해석은 옳았지만, 너무 작았습니다.
한 사람과 터미널 창 열여섯 개라는 규모에서 제가 실제로 겪고 있던 것은 훨씬 더 큰 무언가였습니다. 저는 추론을 유틸리티, 곧 공공 서비스로 경험하고 있었습니다. 전등을 켤 때 전기를 소비하고 수도꼭지를 열 때 물을 소비하는 것과 똑같이 소비되는 물리적 자원으로 말입니다.
이렇게 보면 AI의 경제학에 대해 생각하는 방식이 완전히 달라집니다.
## 무엇이 유틸리티를 유틸리티로 만드는가 {#what-makes-something-a-utility}
유틸리티는 일반적인 재화나 서비스와 구별되는 일련의 속성을 공유합니다. 선택 사항이 아닙니다. 현대의 삶이 그것에 의존합니다. 한 번 구매하는 것이 아니라 끊임없이 소비됩니다. 생산하고 공급하는 데 거대한 물리적 인프라가 필요합니다. 계량됩니다. 소비 단위당 가격이 매겨집니다. 공급망은 지리, 지정학, 규제의 영향을 받습니다. 그리고 비용 구조는 다음 한 단위를 공급하는 한계 비용이 아니라 인프라를 짓고 유지하는 자본 지출이 지배합니다.
물. 전기. 천연가스. 통신. 이것이 전통적인 네 가지 유틸리티입니다. 모든 현대 경제는 그 위에 세워져 있습니다. 그것들의 가용성, 신뢰성, 비용이 특정 관할 지역에서 무엇이 가능한지를 결정합니다. 전력망이 불안정한 곳에는 반도체 공장을 짓지 않습니다. 냉각용 물 공급이 불확실한 곳에서는 데이터 센터를 운영하지 않습니다. 유틸리티 계층은 토대이고, 그 위의 모든 것은 토대가 감당할 수 있는 만큼으로 제약됩니다.
추론은 이 속성들을 하나도 빠짐없이 갖춰 가고 있습니다.
추론은 끊임없이 소비됩니다. 모든 에이전트 상호작용, 모든 모델 호출, 생성되는 모든 토큰이 소비의 한 단위입니다. 제 에이전트 열여섯 개가 조정하고 있을 때, 그것들은 공장 작업장이 전기를 소비하듯 추론을 소비하고 있었습니다. 꾸준하게, 측정 가능하게, 그리고 수행되는 일에 정비례해서 말입니다.
추론에는 거대한 물리적 인프라가 필요합니다. 프런티어 모델을 돌리는 데이터 센터는 지금 세계 어디에서 지어지는 시설과 비교해도 가장 자본 집약적인 시설에 속합니다. 첨단 실리콘, 막대한 전력, 냉각용 물, 물리적 보안이 필요합니다. 그것은 소프트웨어 프로젝트가 아닙니다. 산업 프로젝트입니다.
추론은 계량되고 단위당 가격이 매겨집니다. 주요 추론 제공업체는 모두 토큰당 요금을 받습니다. 입력 토큰, 출력 토큰, 때로는 성능 등급에 따라 요율이 다릅니다. 청구 모델은 이미 유틸리티의 청구 모델입니다. 소비한 만큼 지불합니다.
추론의 공급망은 지리와 지정학의 영향을 받습니다.
## 칩, 데이터, 인재, 에너지 {#chips-data-talent-energy}
RSAC 2026에서 저는 전직 NSA 국장이자 미국 사이버사령부 사령관 네 명이 참여한 패널을 들었습니다. Paul Nakasone(폴 나카소네)는 이 시대에 한 국가의 전략적 잠재력을 결정한다고 그가 생각하는 네 가지 요소를 제시했습니다. GDP가 아닙니다. 군사력도 아닙니다. 네 가지입니다. 칩, 데이터, 인재, 그리고 에너지.
저는 당시 [이에 대해 썼습니다](https://raskell.io/articles/notes-from-rsac-2026/). 하지만 shiioo를 겪은 뒤로 저는 그 네 가지 요소를 다른 렌즈로 생각해 왔습니다. 나카소네는 국력에 대해 말하고 있었습니다. 저는 한 유틸리티의 공급망에 대해 말하고 있습니다.
모든 유틸리티에는 누가, 어떤 비용으로, 어떤 의존성을 안고 그것을 생산할 수 있는지를 결정하는 공급망이 있습니다. 전기의 경우 공급망은 연료(석탄, 가스, 우라늄, 햇빛, 바람), 발전 인프라(발전소, 터빈, 패널), 송전(전력망), 배전(콘센트까지의 마지막 구간)입니다. 물의 경우는 수원(강, 대수층, 담수화), 정수, 송수(관, 펌프), 배수입니다.
추론의 경우 공급망은 나카소네의 네 가지 요소입니다.
칩은 발전 용량입니다. 첨단 GPU, 특히 압도적으로 대만의 TSMC가 제조하고 주로 미국의 NVIDIA가 설계하는 프런티어 실리콘은 추론 경제의 터빈입니다. 그것 없이는 경쟁력 있는 비용으로 추론을 생산할 수 없습니다. 이 제조 능력이 지정학적으로 분쟁 중인 섬의 단일 시설에 전 세계적으로 집중되어 있다는 것은, 전 세계의 전기가 발전소 하나에 의존하는 것과 같습니다. 인프라 계획자들이 잠을 설치게 만드는 단일 장애점입니다.
에너지는 연료입니다. 프런티어 추론은 이제 메가와트가 아니라 기가와트 단위로 측정됩니다. 대규모 추론 클러스터 하나가 작은 도시보다 많은 전력을 끌어 씁니다. [AI 2027](https://ai-2027.com/) 시나리오는 전 세계 AI 데이터 센터의 전력 소비가 2026년까지 38GW에 이를 것으로 전망하며, 그 수치는 평평해질 기미가 전혀 없는 곡선을 따라 오르고 있습니다. 전력 없이는 추론을 돌릴 수 없고, 전력 인프라는 하룻밤에 지을 수 없습니다. 값싸고 풍부하며 신뢰할 수 있는 에너지를 가진 관할 지역은 어떤 소프트웨어적 영리함으로도 메울 수 없는 구조적 우위를 갖습니다.
데이터는 모델이 학습한 원재료이며, 추론을 무작위가 아니라 의미 있는 것으로 만드는 기반입니다. 누가 그것을 갖고 있는지, 어떤 법적 제약 아래에서 쓸 수 있는지, 얼마나 다양하고 대표성이 있는지가 모두 생산할 수 있는 추론의 질과 적용 가능성을 결정합니다.
인재는 운영 인력입니다. 모델을 설계하는 연구자만이 아니라 인프라를 짓는 엔지니어, 그것을 계속 돌아가게 하는 운영자, 그것을 방어하는 보안 전문가까지 포함합니다. 이것은 모든 유틸리티가 의존하는 인적 자본 계층이며, 석유화학 공학 인재가 정유 시설 근처에 모이는 것과 같은 이유로 몇몇 지리적 클러스터에 집중되어 있습니다.
이렇게 정리해 보면 추론은 여느 성숙한 유틸리티와 같은 공급망 구조를 갖고 있습니다. 그리고 전략적 함의는 거기서 곧바로 따라 나옵니다.
| 공급망 계층 | 전기 | 물 | 추론 |
|--------------------|-------------|-------|-----------|
| **원재료** | 연료(가스, 우라늄, 태양) | 수원(강, 대수층) | 데이터(학습 코퍼스) |
| **생산** | 발전소, 터빈 | 정수장 | GPU, 데이터 센터 |
| **전송** | 전력망 | 관, 펌프 | 네트워크, API 엔드포인트 |
| **생산용 연료** | 1차 에너지 | 펌프용 전기 | 전기(38GW 이상) |
| **핵심 병목** | 전력망 용량, 인허가 | 수리권, 가뭄 | 칩 제조(TSMC) |
| **지정학적 위험** | 파이프라인 정치, OPEC | 국경을 넘는 강 | 대만, 수출 통제 |
이 유추는 은유가 아닙니다. 구조에 대한 묘사입니다.
## AI 2027이 경제학에 대해 옳게 본 것 {#what-ai-2027-got-right-about-the-economics}
Daniel Kokotajlo, Scott Alexander, Thomas Larsen, Eli Lifland, Romeo Dean이 쓴 [AI 2027](https://ai-2027.com/) 시나리오는 추측에 기반한 가상의 연표입니다. 저자들도 신중하게 그렇게 밝힙니다. 하지만 그 안의 경제 전망에는 제가 계속 되돌아가게 되는 성질이 있습니다. AI 컴퓨팅을 소프트웨어 제품이 아니라 산업 자원으로 다룬다는 점입니다.
그들의 시나리오는 전 세계 AI 데이터 센터 지출이 조 달러 규모에 이르는 과정을 추적합니다. 프런티어 컴퓨팅 용량이 국가별로 어떻게 분포하는지를 그리는데, 미국이 자국 기업들을 통해 약 70%를, 중국이 약 12%를 보유합니다. 그리고 소프트웨어 엔지니어가 아니라 유틸리티 계획자가 의미 있다고 알아볼 만한 전력 소비 수치를 전망합니다.
이 관점을 쓸모 있게 만드는 것은 구체적인 숫자가 아닙니다. 범주입니다. AI 지출을 조 단위로, 전력 소비를 수십 기가와트 단위로 전망한다면, 그것은 소프트웨어 산업을 묘사하는 것이 아닙니다. 유틸리티 구축을 묘사하는 것입니다. 자본 지출 패턴, 인프라 일정, 규제 문제, 지정학적 경쟁, 그 모든 것이 국가들이 역사적으로 에너지 인프라, 통신 인프라, 산업 역량을 두고 경쟁해 온 방식에 그대로 대응합니다.
AI 2027의 저자들은 AI 시스템이 AI 연구를 가속하는 피드백 루프가 능력 향상의 일정을 앞당긴다고 전망합니다. 그들이 제시한 구체적인 날짜가 맞는지는 구조적 관찰보다 덜 중요합니다. 능력이 가파른 곡선을 따라 자라고 있는데 그 능력에 필요한 물리적 인프라는 훨씬 완만한 곡선을 따라 자란다면, AI의 결정적 제약은 소프트웨어가 아닙니다. 인프라입니다. 유틸리티 계층입니다.
이것이 제가 shiioo로 개인적인 규모에서 겪은 일입니다. 소프트웨어는 작동했습니다. 오케스트레이션 모델도 작동했습니다. 바닥난 것은 물리적 자원이었습니다. 토큰, 다시 말해 추론, 다시 말해 컴퓨팅, 다시 말해 실리콘과 전기였습니다. 병목은 아키텍처가 아니었습니다. 병목은 계량기였습니다.
## AI 이후 시스템에 주는 의미 {#what-this-means-for-post-ai-systems}
추론이 유틸리티라면, 추론에 의존하는 모든 시스템은 유틸리티 소비자입니다. 그리고 그것은 그런 시스템을 설계하는 방식을 바꿉니다.
shiioo를 만들 때 저는 토큰 소비를 관리해야 할 예산으로 다뤘습니다. 그것은 개인 개발자의 관점이었습니다. 정해진 할당량이 있고, 그것을 현명하게 써야 한다는 것입니다. 하지만 기업이나 국가로 시야를 넓히면 관점이 바뀝니다. 예산을 관리하는 것이 아닙니다. 유틸리티 의존성을 관리하는 것입니다.
질문들은 인프라의 질문이 됩니다. 추론 용량이 얼마나 필요한가? 그것은 어디서 오는가? 제공업체에 장애가 나면 어떻게 되는가? 가용성과 처리량에 대한 계약상의 보장은 무엇인가? 주 공급이 끊기면 대비책은 무엇인가? 자체 발전 용량을 조금이라도 갖고 있는가, 아니면 전적으로 외부 제공업체에 의존하는가?
이것은 기업들이 전기에 대해, 물에 대해, 통신에 대해 묻는 바로 그 질문들입니다. 그리고 대부분은 아직 그런 관점을 쓰지 않더라도, 기업들은 추론에 대해서도 이 질문들을 묻기 시작하고 있습니다.
이 전환을 잘 헤쳐 나갈 조직은 추론이 실제로 무엇인지를 알아보는 조직입니다. 전력 소모와 상관관계가 있고, 물리적 인프라를 필요로 하며, 정보의 맥락화와 평가라는 형태로 가치를 만들어 내는 소비 자원입니다. AI 이후의 시스템이 다른 시스템이나 사람과 소통할 때마다 그것은 추론을 소비합니다. 에이전트 사이의 모든 메시지, 모든 모델 평가, 생성되는 모든 응답은 뒤에 실제 물리적 비용이 있는 계량된 공급에서 끌어 쓰는 한 단위입니다.
그 함의는 여러 방향으로 갈라집니다.
**요금 체계는 유틸리티 모델로 수렴할 것입니다.** 토큰당 요금은 이미 표준이지만, 업계는 유틸리티가 쓰는 더 정교한 요금 구조로 옮겨 갈 것입니다. 단계별 요율, 시간대별 요금, 용량 예약, 현물 시장 같은 것들입니다. 그 일부는 이미 나타나고 있습니다. 기업들이 추론 지출을 에너지 지출처럼, 즉 전담 조달과 최적화가 필요한 주요 운영 비용으로 다루기 시작하면서 이 흐름은 빨라질 것입니다.
**주권이 중요해질 것입니다.** 추론이 유틸리티라면, 추론 공급을 외국 제공업체에 의존하는 것은 에너지 공급을 외국에 의존하는 것과 같은 종류의 전략적 취약성입니다. 유럽은 러시아 천연가스로 이 교훈을 배웠습니다. 자국 관할 안에서, 자체 인프라 위에서, 자국의 법적 틀 아래에서 추론 워크로드를 돌릴 수 있느냐는 질문은 데이터 저장 위치에 관한 추상적인 걱정이 아닙니다. 인프라 주권의 문제입니다. 이것이 제가 [Archipelag.io](https://archipelag.io/)를 만든 이유이고, 유럽의 컴퓨팅 주권 논의가 정책 보고서에서 물리적 인프라로 옮겨 가야 한다고 생각하는 이유입니다.
**효율은 공학의 한 분야가 될 것입니다.** 전기가 싸고 풍부했을 때는 아무도 에너지 효율을 최적화하지 않았습니다. 전기가 비싸지자 그것을 중심으로 한 공학 분야 전체가 생겨났습니다. 추론에서도 같은 일이 일어날 것입니다. 지금은 추론을 쓰는 대부분의 시스템이 그것을 낭비하듯 씁니다. 꽉 찬 컨텍스트 윈도우, 장황한 프롬프트, 중복 호출이 그렇습니다. 추론 비용이 의미 있는 비용 항목이 되면, 토큰 효율을 최적화하는 일은 에너지 효율을 최적화하는 일만큼 평범해질 것입니다. 제가 shiioo 글에서 설명한 구조화된 통신 프로토콜, 즉 자유로운 대화 대신 타입이 정해진 메시지는 그 초기 사례입니다. 모든 토큰은 예의가 아니라 정보를 실어 날라야 합니다.
**계량과 관측 가능성은 필수가 될 것입니다.** 측정할 수 없는 유틸리티는 관리할 수 없습니다. 기업에는 전력 모니터링과 네트워크 모니터링이 필요한 것과 똑같이 추론 관측 가능성이 필요해질 것입니다. 소비에 대한 실시간 가시성, 특정 워크로드와 팀별 비용 배분, 예상치 못한 사용량 급증에 대한 이상 탐지, 과거 패턴에 기반한 용량 계획이 그것입니다. 이를 위한 도구는 오늘날 거의 존재하지 않습니다. 몇 년 안에 상당한 시장이 될 것입니다.
## 계량기가 메시지다 {#the-meter-is-the-message}
크리스마스에 토큰이 바닥났을 때 제 첫 반응은 좌절이었습니다. 두 번째 반응은 아키텍처를 다르게 생각하는 것이었습니다. 토큰 효율을 염두에 두고 설계하고, 값싼 통신은 더 값싼 모델로 보내는 식으로 말입니다. 하지만 세 번째 반응, 가장 오래 제 곁에 머문 반응은 무언가를 알아본 것이었습니다.
저는 문제의 형태를 알아보았습니다. 새로운 형태가 아니었습니다. 제가 지금까지 마주친 모든 유틸리티 제약의 형태였습니다. “인프라가 병목이다”라는 형태. “자원은 유한하고 계량되며, 소비에 대해 생각해야 한다”라는 형태. “공급망은 지정학적이다”라는 형태.
나카소네의 네 가지 요소, 곧 칩, 데이터, 인재, 에너지는 국력을 평가하는 틀에 그치지 않습니다. 그것은 추론을 생산하기 위한 자재 명세서입니다. 그리고 그 자재 명세서를 통제하는 국가, 기업, 개인은 산업 시대에 에너지가 풍부한 국가들이, 정보 시대에 대역폭이 풍부한 국가들이 누렸던 것과 같은 구조적 우위를 갖게 될 것입니다.
다섯 번째 유틸리티가 이미 와 있습니다. 다만 아직 이른 시기라서, 대부분의 사람은 여전히 자신이 소프트웨어를 사고 있다고 생각합니다.
## 참고 문헌 {#references}
- [What Sixteen AI Agents Taught Me About Management](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/) - 이 글의 앞선 글
- [Notes from RSAC 2026](https://raskell.io/articles/notes-from-rsac-2026/) - Paul Nakasone의 네 가지 요소와 지정학적 차원
- [AI 2027](https://ai-2027.com/) - Kokotajlo, Alexander, Larsen, Lifland, Dean의 시나리오 작업
- [Archipelag.io](https://archipelag.io/) - 탈중앙화되고 주권을 우선하는 AI 컴퓨팅 네트워크
- [How I Work These Days](https://raskell.io/articles/how-i-work-these-days/) - 에이전트 주도 개발로의 전환에 대해 처음 쓴 글
================================================================================
---
title: "마지막 프로그래밍 언어는 인간을 위한 것이 아닐지도 모릅니다"
url: https://raskell.io/ko/articles/what-programming-languages-become-when-ai-writes-the-code/
author: Raffael Schneider
date: 2026-04-11
description: "AI가 코드의 주된 작성자가 될 때 프로그래밍 언어가 맞이할 세 가지 미래, 그리고 제가 Haskell에 거는 이유."
tags: [ai-engineering, programming-languages, abstraction, formal-methods, haskell, compilers, type-systems, linguistics, aerospace]
lang: ko
translation_of: https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/
---
# 마지막 프로그래밍 언어는 인간을 위한 것이 아닐지도 모릅니다
## 요약
프로그래밍 언어는 언제나 그것을 쓰는 사람에 의해 형태가 정해져 왔습니다. 그러니 AI가 코드의 주된 작성자가 된다면, 의도와 기계 사이의 중간 계층도 바뀔 것입니다. 첫 번째 미래는 *Vera* 같은 명시적인 언어입니다. 모호함을 없애고 기계가 읽을 수 있는 컴파일러 피드백을 주지만, 모델은 여전히 단계별 레시피를 쓰고 있습니다. 두 번째 미래는 제가 hx와 BHC로 걸고 있는 미래로, Haskell 같은 선언적 언어입니다. 모델은 결과가 무엇인지를 기술하고, 타입 검사기는 그것을 증명처럼 검증합니다. 세 번째 미래는 소스 코드를 완전히 건너뜁니다. 모델은 먼저 기존 기계어를 직접 생성하고, 나중에는 인간 독자가 아니라 기계를 위해 설계된 조밀한 실행 형식을 겨냥합니다. 이 셋은 경쟁자가 아니라 하나의 시간선 위에 놓인 지점들입니다. 소스 코드는 사라지지 않고 전문화될 것입니다. 어셈블리가 인프라를 유지하는 사람들의 영역이 된 것처럼 말입니다.
오늘 아침 저는 책상 앞에 서서 물을 탄 인스턴트커피를 마시며, 매일 아침 긴급한 이메일과 알림을 정리한 뒤에 늘 하는 일을 하고 있었습니다. HackerNews를 30분 동안 읽는 것입니다. 시간을 정해 두고 하는 의식이고, 거르는 일은 없습니다. 저는 매일 사무실에 나가는데, 그 책상 앞이든 집 책상 앞이든 아침은 똑같습니다. 커피, 자세, 첫 페이지.
HackerNews는 지금도 베이 에어리어, 기술, 과학, 그리고 밤사이 떠오른 지적으로 자극적인 생각이 무엇이든 그 맥박을 짚는 가장 좋은 방법 가운데 하나입니다. 엄선된 뉴스레터도 몇 개 구독하지만, 높은 신호와 낮은 신호를 가려낼 줄만 알면 HN이 그 내용 대부분을 어차피 다룬다는 것을 몇 해에 걸쳐 알게 되었습니다. 매일 다른 링크 하나씩을 두고 글을 쓸 수도 있을 것입니다. 대부분의 아침에는 참습니다. 오늘 아침은 참지 않았습니다.
링크 하나가 눈에 들어왔습니다. [Vera](https://veralang.dev/)라는 새 프로그래밍 언어로, “인간이 아니라 기계가 쓰도록 설계된” 언어라고 합니다. 정적 타입이고, 순수 함수형이며, WebAssembly로 컴파일되고, 계약 검증에 Microsoft의 Z3 솔버를 씁니다. 페럿 마스코트도 있습니다. 저는 기술 프로젝트의 동물 마스코트를 좋아합니다. Rust의 게 Ferris, Go의 고퍼, [Zentinel](https://zentinelproxy.io/)의 수호견 시사(Shisa)가 그렇습니다. 페럿은 좋은 선택입니다.
하지만 제가 스크롤을 멈춘 이유는 마스코트가 아니었습니다. 제가 지난 12월에 도달한 것과 같은 결론에 다른 누군가도 도달했기 때문입니다. 기존의 프로그래밍 언어는 이 새로운 기술의 능력에 맞춰져 있지 않으며, 무언가가 바뀌어야 한다는 결론입니다.
## 크리스마스의 깨달음 {#the-christmas-realization}
저는 Anthropic이 Claude Code를 처음 내놓은 2025년 5월부터 유료 구독자였습니다. 초기의 사용량 제한과 모델 품질은 아쉬움을 남겼지만, CLI 중심이라는 방향은 곧바로 납득이 갔습니다. 2025년 12월에는 Max 구독으로 올렸고, 휴가 중이었으며, Anthropic은 그달 일일 한도를 넉넉하게 풀어 두었습니다. 저는 몇 해에 걸쳐 쌓아 둔 아이디어를 하나도 남김없이 태워 버리고 있었습니다. 좋은 것도 있었고, 형편없는 것도 있었습니다. 그래도 모두 마침내 예전에는 불가능했던 방식으로 시험해 볼 수 있었습니다. 속도를 따라오는 모델과 페어 프로그래밍을 할 수 있었기 때문입니다. 그 변화에 대해서는 [How I Work These Days](https://raskell.io/articles/how-i-work-these-days/)에 더 자세히 썼는데, 짧게 말하면 2025년 말은 저에게 야망과 실행 사이의 관계가 근본적으로 바뀐 시기였습니다. 둑이 무너졌습니다. 몇 해 동안 공책 속에 머물던 아이디어들이 며칠 만에 실제 소프트웨어가 되기 시작했습니다.
컴파일러 설계를 두고 Claude Code와 깊은 대화를 나누던 그런 늦은 밤의 작업 중 하나에서, 한 가지 생각이 또렷해졌습니다. 저는 [hx](https://arcanist.sh/hx/)를 만들면서 AI가 사람들이 Haskell을 쓰는 방식을 어떻게 바꿀지 생각하고 있었는데, 그 질문이 Haskell보다 크다는 것을 깨달았습니다. 에이전트의 도움을 받는 소프트웨어 개발은 출력 언어 자체, 즉 정보가 어떻게 처리되어야 하는지를 표현하는 데 우리가 쓰는 중간 계층이 근본적으로 바뀌는 지점에 다가가고 있습니다.
이것은 추상적인 관찰이 아닙니다. 소프트웨어의 역사는 추상화 계층이 쌓여 온 역사이고, 각 계층은 다음 세대의 프로그래머가 이전 세대가 숙달해야 했던 것을 무시할 수 있게 해 주었습니다.
시작은 기계어였습니다. CPU 아키텍처마다 다른 날것의 옵코드입니다. 소프트웨어를 쓰고 싶으면 명령어 집합을 외워서 손으로 썼습니다. 사람들은 두꺼운 참조 매뉴얼을 펴냈고, 명령어 집합 아키텍처 전체를 머릿속에 담고 있는 엔지니어들도 있었습니다. 그중 몇몇은 아직 활동하고 있고, 몇몇은 여전히 그 방법론을 고집합니다.
그다음 어셈블러가 그 옵코드에 사람이 읽을 수 있는 이름을 붙였습니다. `89 D8` 대신 `MOV AX, BX`라고 쓰는 식입니다. 여전히 특정 아키텍처를 위해 썼고 여전히 레지스터 단위로 생각했지만, 이제 자신이 쓴 것을 읽을 수 있었습니다. 첫 번째 추상화는 새로운 능력이 아니었습니다. 그것은 가독성이었습니다.
그다음 C가 등장해 하드웨어 위에 이식 가능한 추상화를 주었습니다. 레지스터 단위로 생각하기를 그만두고 함수와 포인터 단위로 생각하기 시작했습니다. C는 아키텍처별 어셈블리로 컴파일되었지만, 어떤 아키텍처인지 신경 쓸 필요는 없었습니다. 하나의 언어, 여러 타깃입니다. 참조 매뉴얼은 명령어 집합에서 언어 명세로 옮겨 갔습니다.
그다음 인터프리터와 가상 머신이 또 하나의 계층을 더했습니다. JVM, Python, Perl입니다. 메모리 배치를 생각하기를 그만두고 객체, 이터레이터, 가비지 컬렉션을 생각하기 시작했습니다. 추상화는 더 두꺼워졌고, 피드백 루프는 더 빨라졌으며, 사용자층은 하드웨어 엔지니어에서 스크립트를 쓸 줄 아는 누구에게나로 넓어졌습니다.
그다음 IDE가 언어 자체와 상호작용하는 방식을 바꾸었습니다. 문법 강조, 자동 완성, 통합 디버거, 리팩터링 도구가 생겼습니다. 편집기가 대신 들고 있어 주었기 때문에 API 전체를 머릿속에 담고 있을 필요가 없어졌습니다. 언어는 바뀌지 않았지만, 그것을 쓰는 인지적 비용은 낮아졌습니다. IntelliSense는 언어 기능이 아니었습니다. 그것은 프로그래머의 기억 위에 놓인 추상화였습니다.
그다음 인터넷이 코드가 움직이는 방식을 바꾸었습니다. 오픈 소스 저장소, 패키지 관리자, 공유 라이브러리가 생겼습니다. 모든 것을 처음부터 쓰기를 그만두고 다른 사람들이 만든 부품을 조합하기 시작했습니다. 참고 자료는 인쇄된 책에서 웹 문서, 위키, 튜토리얼로 옮겨 갔습니다.
그다음 StackOverflow가 사람들이 배우는 방식을 바꾸었습니다. 매뉴얼을 처음부터 끝까지 읽는 대신, 지금 겪는 바로 그 문제를 검색해서 이미 그것을 해결한 사람을 찾았습니다. 지식 계층 자체가 하나의 추상화가 되었습니다. 시스템 전체를 이해할 필요는 없었습니다. 맞는 답을 찾아 자신의 맥락에 맞게 고치기만 하면 되었습니다. StackOverflow는 코드 한 줄도 컴파일한 적이 없지만, 인간의 혼란과 작동하는 소프트웨어 사이에 놓인 중간 계층이었고, 같은 10년 동안 나온 어떤 언어 기능보다도 평균적인 개발자의 생산성에 더 중요했다고 말할 수도 있습니다.
그리고 이제 StackOverflow는 물러나고 있습니다. 답이 나빠져서가 아닙니다. 다음 추상화 계층이 도착했기 때문입니다. AI 코딩 에이전트는 StackOverflow가 하던 일, 즉 알려진 문제에 대해 알려진 해법을 찾는 일을 합니다. 그런데 StackOverflow가 결코 할 수 없던 일도 합니다. 새로운 해법을 종합하고, 여러 파일에 걸친 프로젝트 맥락을 유지하며, 의도를 설명한 문장에서 작동하는 코드를 생성합니다. 패턴은 이전의 모든 전환과 같습니다. 각 계층은 이전 계층을 대체해서가 아니라 더 높은 수준의 추상화 안으로 흡수함으로써 그것을 덜 필수적으로 만듭니다.
프로그래밍 언어는 언제나 그것을 쓰는 사람에 의해 형태가 정해져 왔습니다. 어셈블리는 레지스터와 옵코드로 생각하던 하드웨어 엔지니어들이 빚었습니다. C는 메모리 위에 이식 가능한 추상화가 필요했던 시스템 프로그래머들이 빚었습니다. Python은 문법과 씨름하지 않고 일을 해내고 싶었던 사람들이 빚었습니다. COBOL은 영어처럼 읽히는 코드를 원했던 비즈니스 분석가들이 빚었습니다. 모든 언어에는 의도된 작성자의 지문이 남아 있습니다. AI가 코드의 주된 작성자가 된다면, 언어가 그 새 작성자의 강점과 약점에 맞춰 적응해야 한다는 결론이 따라 나옵니다. 이것은 패턴에서 벗어나는 일이 아닙니다. 패턴이 늘 해 오던 일을 하는 것입니다.
저는 계속 세 가지 구체적인 가능성으로 되돌아왔습니다. 중간 계층이 진화할 수 있는 세 가지 방식입니다. 정확히 말하면 서로 경쟁하는 비전은 아닙니다. 오히려 하나의 시간선 위에 놓인 세 지점에 가깝습니다.
## 기계를 위해 언어를 충분히 명시적으로 만들기 {#make-the-language-explicit-enough-for-machines}
코딩 에이전트와 실제로 시간을 보내 본 사람이라면 누구나 그 실패 양상을 보았을 것입니다. LLM에게 Python 함수를 써 달라고 합니다. 출력은 그럴듯해 보입니다. 린팅을 통과합니다. 변수 이름도 합리적입니다. 구조도 흔한 패턴을 따릅니다. 그런데 모델이 추적하지 못한 미묘한 암묵적 동작 때문에 런타임에 실패합니다. 호출 사이에 공유되는 가변 기본 인자. 두 번째 순회에서 조용히 소진되는 제너레이터. 어떤 라이브러리 작성자가 그쪽이 더 “Pythonic”하다고 판단했다는 이유로 예외를 던지는 대신 `None`을 반환하는 메서드. 모델은 알고리즘에 대해서는 틀리지 않았습니다. 언어의 숨은 동작에 대해 틀렸습니다.
이것이 Vera가 풀려는 문제이고, 제가 고민하던 첫 번째 접근법이기도 합니다. Go의 단순함과 명시성을 가져와 더 밀어붙이고, 모든 명령어, 모든 메서드, 모든 디자인 패턴이 최대한 모호하지 않은 언어를 설계하는 것입니다. 암묵적 동작도 없고, 이름의 모호함도 없고, 스타일의 선택지도 없습니다. 모든 것을 쓰는 표준적인 방법이 하나뿐이어서, LLM이 열일곱 가지 유효한 접근법 중 무엇을 택할지 따지느라 추론 토큰을 낭비할 필요가 없습니다.
그 언어에는 뛰어난 컴파일러 진단이 필요할 것입니다. 단순히 “47번째 줄에서 타입 불일치”가 아니라, 모델이 파싱하고 이해하고 곧바로 행동에 옮길 수 있는 구조화된 피드백입니다. Rust와 Elixir는 이미 인간을 위해 이것을 잘 해냅니다. 그것을 한층 더 잘, 그리고 기계를 위해 해내는 것입니다.
파이프라인은 다음과 같습니다.
*Explicit language feedback loop*
```text
+-------+ prompt +-------+ explicit +-----------+
| Human | -------------> | LLM | -------------> | Verifying |
+-------+ +-------+ source | Compiler |
^ +-----------+
| |
| structured error |
| + suggested fix |
+---------------------------+
|
verified
|
v
[correct program]
```
핵심은 피드백 루프입니다. 컴파일러는 나쁜 코드를 거부하는 데서 그치지 않습니다. 무엇이 잘못되었는지를 모델이 행동으로 옮길 수 있는 말로, 구체적인 수정 제안과 함께 설명합니다. 모델은 다시 생성합니다. 컴파일러는 다시 검사합니다. 반복을 통해 올바른 코드로 수렴하며, 그 루프가 얼마나 촘촘한지는 언어가 얼마나 모호하지 않은지, 오류가 얼마나 행동으로 옮기기 쉬운지에 달려 있습니다.
Vera는 바로 이 아이디어를 확신을 가지고 실행한 것입니다. 함수는 이렇게 생겼습니다.
```vera
public fn safe_divide(@Int, @Int -> @Int)
requires(@Int.1 != 0)
ensures(@Int.result == @Int.0 / @Int.1)
effects(pure)
{
@Int.0 / @Int.1
}
```
변수 이름이 아예 없습니다. 매개변수는 De Bruijn 슬롯 표기법을 써서 타입과 위치 인덱스로 참조합니다. `@Int.0`은 가장 최근에 바인딩된 정수이고, `@Int.1`은 그 앞의 것입니다. 모든 함수는 사전 조건(`requires`), 사후 조건(`ensures`), 부수 효과(`effects`)를 선언해야 합니다. 컴파일러는 가능한 곳에서는 Z3로 계약을 정적으로 검증하고, 컴파일 시점에 판정할 수 없는 것은 런타임 검사로 넘깁니다.
설계 원칙은 날카롭습니다. 모델이 옳을 필요는 없고, 검사 가능하기만 하면 됩니다. 언어가 유효한 프로그램의 공간을 아주 좁게 제약하기 때문에, 컴파일러는 실행 전에 실수를 잡아내고 그것을 자연어로 설명합니다. 0으로 나누기는 런타임 예외가 아닙니다. 컴파일 중에 잡히는 계약 위반입니다.
이렇게 생각해 보십시오. 전통적인 언어는 열린 들판입니다. 어느 방향으로든 걸을 수 있고, 쓸모 있는 곳에 닿을 수도 있지만 절벽에서 떨어질 수도 있습니다. Vera는 난간이 있는 안내된 길입니다. 정해진 방향으로만 갈 수 있고, 길에서 벗어나려 할 때마다 표지판이 대신 정확히 어디로 디뎌야 하는지 알려 줍니다. 열린 들판 위의 LLM은 헤맵니다. 안내된 길 위의 LLM은 수렴합니다.
초기 벤치마크 결과는 흥미롭지만 엇갈립니다. Kimi K2.5는 Vera 코드를 완벽하게 쓰는 것으로 보입니다. VeraBench에서 100%를 기록해 자신의 Python과 TypeScript 점수를 넘어섰습니다. 다른 모델들은 그만큼 잘하지 못합니다. Claude Opus 4는 Python에서 96%를 기록한 반면 Vera에서는 88%를 기록했습니다. Vera 팀은 이 편차에 대해 솔직하고, 저는 그 점을 높이 삽니다. [HackerNews 토론](https://news.ycombinator.com/item?id=47696263)은 빈약해서, 12점에 회의적인 댓글 세 개뿐이었습니다. 이 대화가 아직 얼마나 초기인지 알 수 있습니다. 더 넓은 개발자 커뮤니티는 아직 이 아이디어를 진지하게 다루지 않았습니다. 그것은 바뀔 것입니다.
하지만 기계가 해법을 반복해 가는 방식에 맞춰 언어를 최적화하는 데에는 마음에 걸리는 점이 있습니다. 파이프라인 다이어그램을 다시 보십시오. LLM은 여전히 단계별 명령을 생성하고 있습니다. 모호함을 걷어내고 계약을 명시했을 뿐, 여전히 일을 어떻게(HOW) 하는지를 기술하고 있습니다. 기계는 여전히 과정을 순차적으로 따라가며 추론합니다. 피드백 루프의 잡음은 줄였지만, 신호의 성격은 바꾸지 않았습니다. 모델은 여전히 레시피를 쓰고 있습니다. 더 정밀한 레시피일 뿐입니다.
레시피 쓰기를 아예 그만둔다면 어떨까요?
## 어떻게가 아니라 무엇을 기술하기 {#describe-what-not-how}
두 번째 아이디어는 다른 전제에서 출발합니다. 절차적 코드를 AI가 올바르게 쓰기 쉽게 만드는 대신, AI에게 표현하라고 요구하는 것 자체를 바꾸는 것입니다.
구체적으로 말해 보겠습니다. 로그에서 가장 최근의 서버 오류 열 개를 찾아야 한다고 합시다. 절차적 언어로 그 과정을 기술하면 이렇게 됩니다.
```python
errors = []
for entry in log_entries:
if entry.status >= 500:
errors.append({
"time": entry.timestamp,
"path": entry.path,
"code": entry.status
})
errors.sort(key=lambda e: e["time"], reverse=True)
return errors[:10]
```
기계에게 이렇게 말하고 있는 것입니다. 빈 리스트를 만들어라. 각 항목을 하나씩 훑어라. 조건을 검사하라. 맞으면 딕셔너리를 만들어 덧붙여라. 그다음 쌓인 리스트를 키로 정렬하라. 그다음 처음 열 개 요소를 가져가라. 모든 단계가 명령입니다. 기계는 가변 리스트, 순회 상태, 정렬, 슬라이스를 추적해야 합니다. 그리고 어느 한 단계를 틀려도 나머지는 성공할 수 있어서, 올바라 보이지만 미묘하게 망가진 출력이 나옵니다. `reverse=True` 하나가 빠지면 가장 최근 오류 대신 가장 오래된 오류를 조용히 받게 됩니다.
같은 일을 Haskell로 쓰면 이렇습니다.
```haskell
recentErrors :: [LogEntry] -> [ErrorSummary]
recentErrors =
take 10
. sortBy (flip compare `on` time)
. map toSummary
. filter isServerError
```
아래에서 위로 읽으십시오. 서버 오류를 걸러 내고, 각각을 요약으로 변환하고, 시간 역순으로 정렬하고, 열 개를 가져갑니다. 가변 누산기가 없습니다. 루프 변수도 없습니다. 중간 상태도 없습니다. 과정을 기술하는 것이 아닙니다. 입력과 출력 사이의 관계를 기술하는 것입니다. 이 함수는 결과를 단계별로 어떻게 계산하는지가 아니라, 결과가 무엇인지(IS)를 말합니다.
맨 위의 타입 시그니처 `[LogEntry] -> [ErrorSummary]`는 컴파일러가 강제하는 계약입니다. `toSummary`가 잘못된 타입을 반환하거나, `isServerError`가 `LogEntry`를 받지 않거나, 실수로 타입 검사를 통과하지 못하는 순서로 함수를 합성하면, 컴파일러는 프로그램이 실행되기 전에 그것을 거부합니다. 런타임의 모호한 “object has no attribute”가 아닙니다. 어느 조각이 맞지 않는지를 정확히 알려 주는, 컴파일 시점의 정밀한 타입 오류입니다.
이 차이는 AI에게 엄청나게 중요합니다. 각 경우에 LLM이 실제로 무엇을 추적해야 하는지 생각해 보십시오.
*Procedural vs declarative complexity*
```text
Procedural (Vera, Python, Go) Declarative (Haskell)
================================ ================================
- mutable variables and their - input type
current state at each step - output type
- loop iteration progress - which transformations to compose
- conditional branching outcomes - whether types align
- order of side effects
- implicit language behaviors
- names and what they refer to
```
절차적 모델은 AI에게 머릿속으로 실행을 시뮬레이션하라고 요구합니다. 선언적 모델은 AI에게 변환을 기술하고 그 검증은 컴파일러에게 맡기라고 요구합니다. 하나는 LLM의 약점(여러 단계에 걸친 상태 추적)을 시험하고, 다른 하나는 강점(형식적 제약을 만족하는 패턴을 알아보고 생성하는 일)을 살립니다.
파이프라인은 근본적으로 바뀝니다.
*Type-driven proof pipeline*
```text
+-------+ prompt +-------+ type sigs +-----------+
| Human | -------------> | LLM | -------------> | Compiler |
+-------+ +-------+ pure exprs +-----------+
|
types align?
/ \
yes no
| |
v v
[proven correct] [precise type error:
"Expected LogEntry,
got String at ...]
```
순조로운 경로에서는 피드백 루프가 필요 없습니다. 타입이 맞으면, 타입 시스템이 추적하는 속성에 관한 한 그 프로그램은 구성상 올바릅니다(correct by construction). 컴파일러는 모델과 함께 반복하고 있는 것이 아닙니다. 증명을 검사하고 있는 것입니다.
이것이 제가 거는 접근법입니다. 이 블로그가 존재하는 이유이기도 합니다.
이 사이트 뒤에 있는 이름 Raskell은 Rascal(라쿤라고 할 때의 그 Rascal로, 라쿤는 제 마스코트입니다)과 Haskell을 합친 말입니다. Haskell은 수학적 증명에 가까운 것들을 얼마나 우아하게 기술하는지 때문에 제가 몇 해 동안 사랑해 온 언어입니다. TODO가 아니라 QED입니다. 타입이 잘 맞는 Haskell 함수를 쓸 때, 여러분은 단지 코드를 쓰는 것이 아닙니다. 어떤 변환이 유효하다는 증명을 쓰는 것이고, 컴파일러는 그 증명 검사기입니다.
하지만 Haskell을 사랑하는 것과 Haskell을 프로덕션에 내보내는 것은 다른 경험이며, 그 사이의 간극은 대부분 도구에 있습니다. 생태계는 10년 넘게 사람들을 좌절시켜 온 방식으로 파편화되어 있습니다. `cabal`, `stack`, `ghcup`. 의존성이 어떻게 동작해야 하는지에 대해 서로 다른 의견을 지닌 채 겹치는 일을 하는 세 도구입니다. Python에서 오셨다면, `pip`, `poetry`, `pyenv`가 모두 따로 개발되어 락파일 형식도 다르고 리졸버 알고리즘도 다르며 가끔 서로 호환되지 않는다고 상상해 보십시오. 그것이 Haskell이었습니다. 빌드는 느렸습니다. 오류 메시지는 도움이 되는 것부터 암호 같은 것까지 다양했습니다. 런타임은 하나의 성능 프로파일이 모든 용도에 맞는다고 가정했습니다. 엣지 함수나 임베디드 시스템, GPU 가속 수치 계산에 Haskell을 쓰고 싶다면, 실제 코드를 쓰는 만큼의 시간을 툴체인과 씨름하는 데 썼습니다.
언어는 옳았습니다. 그것을 둘러싼 인프라가 그렇지 못했습니다.
그래서 저는 [astral.sh](https://astral.sh)가 Python 도구에 가져온 것과 같은 접근으로 [arcanist.sh](https://arcanist.sh)를 만들기 시작했습니다. astral.sh가 `uv`와 `ruff`를 내놓았을 때, 굳어진 도구를 지닌 성숙한 생태계라도 개발자 경험을 Rust로 처음부터 다시 만들어 모든 것을 극적으로 더 빠르고 일관되게 만들 수 있다는 것을 보여 주었습니다. 저는 Haskell에 같은 일을 하고 싶었습니다. arcanist.sh에는 두 프로젝트가 있습니다.
[hx](https://arcanist.sh/hx/)는 Rust로 만든, 빠르고 분명한 주관을 지닌 Haskell용 차세대 툴체인입니다. 파편화된 스택을 대체하는 하나의 도구입니다. 프로젝트별로 고정되는 관리형 컴파일러 버전. 지문 검증을 갖춘 결정론적 TOML 락파일. cabal보다 5.6배 빠른 콜드 빌드. 7.8배 빠른 증분 재빌드.
```bash
curl -fsSL https://arcanist.sh/install.sh | sh
hx new my-app && cd my-app
hx run
```
ghcup도, stack도, cabal-install도 없습니다. 그냥 `hx`입니다.
[BHC](https://arcanist.sh/bhc/), 즉 Basel Haskell Compiler는 한 걸음 더 나아갑니다. GHC의 포크가 아니라 Rust로 백지에서 새로 쓴 Haskell 컴파일러이며, Haskell 2026 Platform 명세를 겨냥합니다. 네이티브 코드 생성에 LLVM을 쓰고, 컴파일 시점에 고르는 여섯 가지 런타임 프로파일을 제공합니다.
| 프로파일 | 용도 | 핵심 특성 |
|---------|-------------|-----------|
| default | 일반 애플리케이션 | 지연 평가, GC 관리, GHC 호환 의미론 |
| server | 백엔드 서비스 | 구조적 동시성, 자동 취소, 관측 가능성 훅 |
| numeric | ML과 과학 계산 | 엄격한 수치 연산, 텐서 로어링(lowering), SIMD, GPU 백엔드(CUDA/ROCm) |
| edge | WASM과 CDN 워커 | 최소한의 풋프린트, LLVM 없이 WASM 직접 생성 |
| realtime | 게임, 오디오, 로보틱스 | 1ms 미만으로 제한된 GC 일시 정지, 아레나 할당 |
| embedded | 베어 메탈, 마이크로컨트롤러 | GC 전혀 없음, 정적 할당, ARM Cortex-M 같은 타깃 |
같은 Haskell 소스라도 무엇을 만드느냐에 따라 런타임 계약이 달라집니다. 보안 정책 엔진은 server 프로파일로 컴파일되어 트레이싱을 갖춘 구조적 동시성을 얻습니다. 텐서 파이프라인은 numeric 프로파일로 컴파일되어 GPU 가속을 얻습니다. 엣지 함수는 WASM으로 컴파일되어 Cloudflare Workers에서 실행됩니다. 같은 언어. 같은 타입 안전성. 다른 성능 범위.
이 작업 뒤에 있는 확신은 구체적입니다. AI가 코드를 쓸 때 살아남는 언어는 절차적 명시성에 최적화된 언어가 아닙니다. 무언가를 어떻게 계산하는지가 아니라 그것이 무엇인지를 기술함으로써 일관성과 순수성을 가져오는 언어입니다. AI는 형식적 제약을 만족하는 표현식을 생성하는 데 대단히 뛰어납니다. 그리고 증명처럼 읽히는 소스 코드는 시간을 견딜 수 있습니다. 메인테이너의 번아웃을 견딜 수 있습니다. 3년 뒤에는 어떤 함수가 왜 그렇게 쓰였는지 아무도 기억하지 못한다는 사실도 견딜 수 있습니다. 타입은 기억합니다. 타입이 의도를 담고 있기 때문에, 증명은 절차적 코드가 결코 그럴 수 없는 방식으로 스스로를 문서화합니다.
Vera와 arcanist.sh는 같은 전제를 받아들입니다. 중간 계층이 바뀌고 있다는 것입니다. 둘은 그것이 어느 방향으로 바뀌어야 하는지에 대해 의견이 다릅니다. Vera는 생성 루프의 오류를 줄이는 데 최적화합니다. 가치 있는 일입니다. 하지만 hx와 BHC는 생성된 코드를 구성상 올바르게 만드는 데 최적화합니다. 언어 자체가 구조적인 수준에서 유효한 프로그램의 모습을 제약하기 때문입니다.
## 언어를 완전히 건너뛰기 {#skip-the-language-entirely}
세 번째 가능성은 제가 늦은 밤에 생각하는 것이고, 구체적인 프로젝트는 아직 없습니다. 아직은요. 제가 가장 매혹적으로 느끼는 동시에 가장 불안하게 느끼는 가능성이기도 합니다.
AI가 소스 코드를 아예 쓰지 않게 된다면 어떨까요?
이것이 왜 그럴듯한지 이해하려면 소스 코드가 실제로 무엇인지 살펴보는 것이 도움이 됩니다. 소스 코드는 최종 제품이 아닙니다. 한 번도 그런 적이 없습니다. 소스 코드는 컴파일러가 기계어로 변환하는 명령의 집합입니다. 하드웨어가 실행하는 것은 기계어입니다. 소스 코드가 존재하는 이유는 인간에게 자신의 의도와 실리콘 사이의 추상화 계층이 필요했기 때문입니다. 우리는 “이 리스트를 정렬하라”나 “권한 없는 요청을 거부하라” 같은 개념으로 생각합니다. CPU는 레지스터 이동, 메모리 로드, 조건부 점프로 생각합니다. 소스 코드는 그 간극을 잇습니다.
하지만 그 다리는 인간 작성자를 위해 지어졌습니다. 작성자가 더 이상 인간이 아니라면, 그 다리는 다른 목적을 갖게 됩니다. 감사 추적이 됩니다. 인간이 AI가 만든 것을 읽고 검증하는 수단입니다. 저작의 매체가 아니라 투명성의 계층입니다.
저는 이것이 두 개의 뚜렷한 단계로 펼쳐질 것이라고 봅니다.
### 1단계: 기존 기계어를 겨냥하는 AI {#phase-one-ai-targets-existing-machine-code}
첫 번째 단계는 대부분의 사람들이 생각하는 것보다 가까이 있고, 개념적으로는 단순합니다. 우리는 이미 소스 코드로 모델을 훈련합니다. 컴파일된 산출물로도 대규모로 훈련하면 어떻게 될까요? 바이너리, 오브젝트 파일, 중간 표현, 즉 컴파일러의 실제 출력으로 말입니다.
컴파일러가 하는 일을 생각해 보십시오. 컴파일러는 소스 코드를 받아 잘 정의된 결정론적 규칙에 따라 기계 명령으로 변환합니다. 소스 패턴과 출력 패턴 사이에는 대응 관계가 있습니다. C의 `for` 루프는 x86에서 비교, 분기, 증가 명령의 특정한 순서가 됩니다. 함수 호출은 특정한 호출 규약을 따릅니다. 메모리 할당은 특정한 시스템 콜 패턴을 따릅니다. 이런 대응 관계는 학습할 수 있습니다. 그것들은 패턴이고, 패턴 인식이야말로 LLM이 뛰어난 분야입니다.
*Skipping the source layer*
```text
Today:
human intent → prompt → LLM → source code → compiler → x86/ARM → CPU
Phase one:
human intent → prompt → LLM → x86/ARM directly → CPU
(trained on source +
compiled artifact pairs)
```
이 단계에서 모델은 소스 코드 계층을 건너뛰고 기계어를 직접 생성합니다. 전통적인 의미의 “컴파일”을 통해서가 아닙니다. 의도의 설명에서 유효한 실행 파일을 만들어 낼 만큼 패턴을 충분히 잘 학습했기 때문입니다. 유창한 번역가가 문법 규칙을 의식적으로 분석하지 않고 의미에서 곧바로 올바른 문장을 만들어 내는 것과 같은 방식입니다.
이것은 급진적으로 들리지만, 우리가 이미 출력을 읽지 않는 컴파일러를 신뢰하고 있다는 것을 떠올리면 달라집니다. `gcc -O3`의 어셈블리 출력을 들여다보며 C 프로그램이 올바르게 컴파일되었는지 확인한 것이 언제였습니까? 여러분은 컴파일러를 신뢰합니다. 결과 바이너리의 동작을 테스트합니다. 중간 표현을 감사하지는 않습니다. AI가 같은 동작 테스트를 통과하는 바이너리를 만들어 낼 수 있다면, “AI가 생성한 기계어”와 “컴파일러가 생성한 기계어” 사이의 실질적인 차이는 근본적인 가능성의 문제가 아니라 신뢰를 어떻게 보정하느냐의 문제가 됩니다.
제가 계속 되돌아가는 비유는 항공입니다. 초기 조종사들은 손으로 비행했고 항공기의 모든 기계 장치를 이해했습니다. 플라이 바이 와이어가 그것을 바꾸었습니다. 조종사는 의도(상승, 선회, 고도 유지)를 전달합니다. 컴퓨터는 그것을 조종면의 움직임으로 옮깁니다. 조종사는 돌풍이 불 때마다 에일러론과 엘리베이터를 손으로 조정하지 않습니다. 시스템을 신뢰합니다. 중간 단계가 아니라 결과(고도, 방위, 대기 속도)를 확인합니다. 언어 이후 프로그래밍의 1단계는 소프트웨어를 위한 플라이 바이 와이어입니다.
이것이 추측처럼 들린다면, 이번 주에 일어난 일을 생각해 보십시오. Anthropic은 AWS, Apple, Google, Microsoft, NVIDIA, CrowdStrike, Palo Alto Networks, Linux Foundation 등이 참여하는 연합인 [Project Glasswing](https://www.anthropic.com/glasswing)을 발표했습니다. AI를 활용해 세계에서 가장 중요한 소프트웨어를 지키기 위해 결성된 연합입니다. Anthropic의 CEO Dario Amodei는 이렇게 분명히 말했습니다.
> “AI 모델은 소프트웨어 취약점을 찾아내고 악용하는 데 있어 가장 숙련된 인간을 제외한 모두를 능가할 수 있는 수준의 코딩 능력에 도달했습니다.”
그가 제시한 증거는 이것이었습니다. “OpenBSD에서 27년 동안 존재해 온 버그를 찾았습니다.”
그것이 무엇을 뜻하는지 생각해 보십시오. OpenBSD는 세계에서 가장 꼼꼼하게 감사되는 코드베이스 가운데 하나입니다. 살아 있는 가장 세심한 시스템 프로그래머들 일부가 수십 년 동안 보안에 초점을 맞춰 검토해 왔습니다. 그런데 AI 모델이 27년 동안 모든 인간 검토자가 놓친 것을 찾아냈습니다. AI가 인간이 찾지 못하는 취약점을 찾아낼 만큼 기존 코드를 깊이 이해할 수 있다면, 사람이 읽을 수 있는 소스를 중간 단계로 거치지 않고 코드를 생성할 만큼도 깊이 이해할 수 있습니다. 질문은 더 이상 AI가 구조적인 수준에서 코드를 이해하느냐가 아닙니다. 그 질문에는 이번 주에 답이 나왔습니다. 질문은 그 이해로 다음에 무엇을 하느냐입니다.
### 2단계: 새로운 종류의 기계 {#phase-two-a-new-kind-of-machine}
두 번째 단계는 더 멀리 있고 더 추측에 가깝습니다. 하지만 저는 결국 그쪽으로 가게 될 것이라고 생각합니다.
AI가 기계가 실행할 코드를 생성하고 인간은 아무도 그것을 읽을 필요가 없다면, 그 코드가 인간의 이해를 위해 설계된 명령어 집합을 겨냥할 이유가 없습니다. x86과 ARM은 누군가가 적어도 가끔은 명령어를 들여다볼 것이라는 가정 아래 설계되었습니다. 니모닉이 있습니다. 디스어셈블을 가능하게 하는 규약을 따릅니다. 인간이 이해하는 연산에 대략 대응하는 명령어들로 구성되어 있습니다.
그런데 실행 타깃이 AI가 생성하는 코드를 위해 처음부터 설계된다면 어떨까요? 새로운 종류의 바이트코드를 소비하는 가상 머신이나 런타임입니다. 사람이 읽기 좋도록 최적화되지도 않았고, 손으로 쓰는 어셈블리에 맞춰 최적화되지도 않았습니다. 오로지 실행 밀도와 기계 생성에만 최적화되어 있습니다.
*AI-native execution target*
```text
Phase two:
human intent → prompt → AI → dense symbolic bytecode → AI-native VM
(opaque to humans, |
optimized for machine v
generation + execution) [result]
```
저는 정보 밀도에 대해 계속 생각합니다. 한자는 라틴 알파벳 단어보다 훨씬 큰 의미의 무게를 지닌 개별 기호에 의미를 담습니다. 글자 하나가 영어로는 한 구절 전체가 필요한 개념을 나타낼 수 있습니다. 조밀한 기호를 자연스럽게 처리할 수 있는 독자를 위해 시스템이 설계되면, 표현은 압축됩니다. 설계 대상에 속하지 않았던 독자에게는 덜 접근하기 쉬워지는 대가로 더 효율적이 됩니다.
AI 네이티브 바이트코드도 같은 원리를 따를 수 있습니다. 각 명령어가 기존 명령어 수십 개로 표현해야 할 복잡한 복합 연산을 담을 수 있습니다. 그 바이트코드는 지금의 기계어가 장황해 보일 만큼 조밀할 것입니다. 디컴파일하거나 분석하면 완전히 불투명할 것입니다. 일부러 난독화한 것이 아닙니다. 훈련된 신경망의 가중치가 실제로 기능하는 지식을 담고 있으면서도 이해할 수 없는 것과 마찬가지로, 인간의 인지로는 본래 이해할 수 없을 뿐입니다.
이 바이트코드를 실행하는 가상 머신은 그 자체로 다른 종류의 시스템일 것입니다. 전통적인 의미의 스택 머신이나 레지스터 머신이 아닙니다. 어쩌면 바이트코드가 순차적인 명령이 아니라 변환 그래프를 기술하는 데이터플로 엔진에 더 가까운 무언가일 것입니다. 누군가에게 경로를 하나하나 알려 주는 운전 안내(북쪽으로 가서, 왼쪽으로 돌고, 2마일 계속 가라)를 주는 것과, 목적지가 표시된 지도를 건네는 것의 차이로 생각해 보십시오. 바이트코드는 지도입니다. 경로는 VM이 찾아냅니다.
우리가 지금 어디에 있는지는 솔직하게 말하고 싶습니다. 우리는 1단계에 와 있지 않습니다. 2026년 4월에는 아닙니다. 지금의 모델은 여전히 중간 계층이 필요합니다. 단계별로 추론해 나갈 수 있을 때 더 나은 코드를 만듭니다. 타입 시스템과 계약과 명시적인 오류 메시지에서 도움을 받습니다. 첫 번째와 두 번째 접근법은 단지 실현 가능한 정도가 아니라, 지금 당장 필요합니다.
하지만 궤적은 보입니다. 모델은 세대마다 올바른 프로그램을 생성하는 데 더 나아지고 있습니다. 형식 검증은 더 실용적이 되고 있습니다. 하드웨어는 더 저렴해지고 있습니다. “의도를 기술하는 프롬프트”와 “올바른 실행 가능 출력” 사이의 간극은 줄어들고 있습니다. 1단계는 충분한 소스와 바이너리 쌍으로 훈련된 모델이 올바른 실행 파일을 안정적으로 만들어 낼 수 있을 때 도착할 것입니다. 2단계는 누군가가 이렇게 물을 때 도착할 것입니다. 모델이 이미 바이너리를 생성하고 있다면, 왜 우리는 더 이상 쓰는 일을 하지 않는 종을 위해 설계된 명령어 집합을 겨냥하고 있는가?
어느 시점에 중간 계층은 선택 사항이 됩니다. 그리고 선택 사항인 것은 충분한 시간이 지나면 흔적 기관처럼 남게 됩니다.
## 이것이 의미하는 것 {#what-this-means}
저는 이 세 접근법이 서로 경쟁한다고 생각하지 않습니다. 이들은 하나의 시간선 위에 놓인 세 지점이고, 그 시간선은 중간 계층이 줄어드는 이야기입니다.
*The intermediate layer timeline*
```text
Near term Medium term Long term
(now) (2-5 years) (5-15 years)
Explicit Declarative Post-language
languages languages (AI-native targets)
(Vera) (Haskell + BHC)
Reduce noise --> Change the signal --> Remove the layer
in the loop entirely entirely
HOW, but WHAT, verified Intent to
unambiguous by types execution
```
가까운 시기에는 Vera 같은 명시적인 언어가 생성 공간을 제약하고 기계가 읽을 수 있는 진단을 제공함으로써 AI가 생성한 코드를 더 신뢰할 수 있게 만듭니다. 이것은 오늘 유용합니다. 지금 AI 코딩 파이프라인을 만들고 있고 다음 분기에 출시해야 한다면, 이 접근법은 통합니다.
중기적으로는 Haskell 같은 선언적 언어가, 특히 현대적인 도구와 현대적인 런타임을 갖추었을 때, AI가 생성한 코드를 구성상 올바르게 만듭니다. 타입 시스템이 근본적인 수준에서 무거운 검증 작업을 맡습니다. 살아남는 코드는 절차가 아니라 불변식을 기술하는 코드입니다. 이것이 제가 arcanist.sh로 대비하며 만들고 있는 시대입니다.
장기적으로는 언어가 사라집니다. 먼저 AI가 직접 생성하는 기존 기계어 속으로, 그다음 처음부터 AI 생성을 위해 설계된 새로운 실행 형식 속으로 사라집니다. 70년 동안 소프트웨어 엔지니어링을 규정해 온 중간 계층은 구현 세부 사항이 됩니다.
그 마지막 가능성은 어떤 사람들을 불편하게 합니다. 12월에 처음 그것을 생각했을 때 저도 불편했습니다. 그것은 우리가 아는 프로그래밍이라는 기예, 즉 문법의 유창함, 관용구의 숙달, 우아한 구현을 알아보는 감각이 핵심 기술이라기보다 수동 선반을 다루는 법을 아는 것에 가까워진다는 뜻입니다. 맞는 맥락에서는 가치가 있습니다. 어려운 경우에는 여전히 필요합니다. 하지만 더 이상 대부분의 소프트웨어가 만들어지는 주된 방식은 아닙니다.
이런 일은 전에도 있었습니다. 모든 프로그래머가 어셈블리를 이해하던 시절이 있었습니다. 그러다 C가 그것을 추상화했고, 대부분의 프로그래머는 기계어를 읽지 않게 되었습니다. 그러다 Python과 JavaScript가 C를 추상화했고, 대부분의 프로그래머는 메모리 관리를 생각하지 않게 되었습니다. 매번 이전 계층은 사라지지 않았습니다. 다른 모든 사람이 딛고 선 인프라를 유지하는 전문가들의 영역이 되었습니다. 소스 코드에도 같은 일이 일어날 것입니다. 사라지지 않을 것입니다. 전문화될 것입니다.
저는 지금도 매일 코드를 씁니다. 지금도 타입으로 생각합니다. 지금도 hx와 BHC를 만들고 있습니다. 중기적 미래가 실재하며 동시에 길다고 믿고, Haskell의 강점이 바로 그 미래가 요구하는 것이라고 믿기 때문입니다. 순수 함수, 강한 타입, 증명 가능한 정확성. 이것들은 AI가 구현을 쓰는 세상에서 사치가 아닙니다. 하중을 받치는 구조입니다. 하지만 저는 한쪽 눈을 지평선에 둔 채로 그 일을 합니다. 제가 투자하고 있는 중간 계층이 말 그대로 중간이라는 것을 알기 때문입니다.
Vera를 만든 사람은 아마 비슷한 시기에 제가 본 것과 같은 것을 보았을 것입니다. 그 사람은 첫 번째 접근법을 택했습니다. 저는 두 번째를 택했습니다. 누군가는 결국 세 번째를 만들 것입니다. 그러면 아무도 더 이상 프로그램을 쓰지 않을 때 우리가 “프로그래밍”이라는 말로 무엇을 뜻하는지, 우리 모두 알아내야 할 것입니다.
저는 벌써 그 답이 궁금합니다.
*덧붙임:* 같은 질문의 실용적인 면, 즉 에이전트가 코드 대부분을 쓰는 지금 제가 어떤 언어를 고르는지, 그리고 각 언어가 여전히 무엇을 주는지는 [Almost Irrelevant](https://raskell.io/articles/almost-irrelevant/)에 썼습니다.