三个部分,没有大脑
一个国际象棋程序由什么构成,以及在任何学习开始之前,一个手写的程序能在 lichess 的电脑对手面前走多远。
| 阅读时长 | 14 分钟 |
|---|---|
| 发布于 | |
| 系列 | Learning To Play |
| 主题 | 游戏 AI, 树搜索, 游戏, Rust, 指标, 概率, 国际象棋, 将棋, 围棋 |
简而言之
在任何学习开始之前,我按 Levy 描述的三个部分构建了 Kishi 的国际象棋引擎:变成数字的棋盘、判断谁占优的评估函数,以及向前看的搜索。 位棋盘表示在每次改动时都用 perft 检验;手写的 PeSTO 评估函数几乎不包含国际象棋知识,棋力在于搜索,以及搜索里那一堆调校过的统计赌注。 诚实地测量棋力是最难的部分:对抗赛需要成对的开局、相同的搜索预算和明确给出的误差范围,而一个没有得到证明的微小正向结果意味着:留着它,但不要宣称它。 对阵一个重建的 lichess 电脑对手,使用手写评估函数、单核运行的 Kishi 介于 6 级和 7 级之间,误差范围很宽,我把它们报告出来,而不是略去。 同样的构造在将棋上得到一个说得过去的俱乐部级对手,围棋则需要改用随机模拟对局;这条基线,就是本项目中每一个训练出来的神经网络都必须击败的对手。
lichess 上的国际象棋电脑有八个级别。我坐火车时用手机和它下棋,和每一个跟它下过棋的人一样,我有一个能赢的级别,也有一个会输的级别。上个月我造出自己的引擎后,我拿给谁看,谁问的第一个问题,都是我一直在问自己的那个:它是几级?这听起来是世界上最容易回答的问题。结果它成了整个项目里最难的部分,比让程序会下棋还难,而这个答案正是本文的重点。
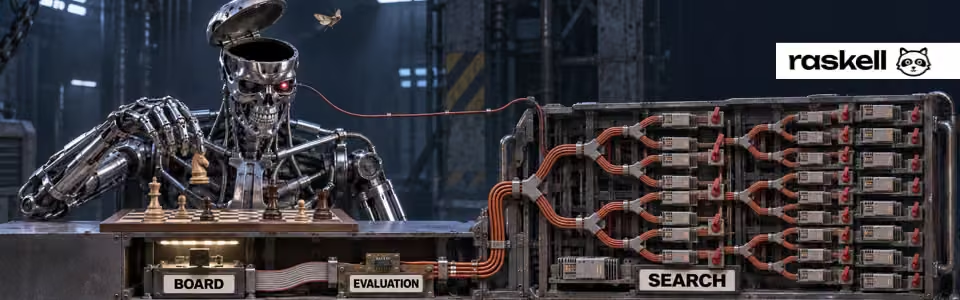
在第一篇里,我讲了十二岁的 Demis Hassabis 读 David Levy 关于国际象棋计算机的手册、得知一个国际象棋程序由三个部分构成的故事:变成数字的棋盘,一个判断谁占优的函数,以及一个向前看的搜索。我用 Rust 构建了这三个部分,我想展示每一个部分在真正动手构建之后是什么样子,因为出人意料的地方在于,国际象棋到底藏在哪一个部分里。然后我想给结果定一个数字,并说明为什么这个数字带着一个大多数人悄悄略去的误差范围。
本文里没有任何东西在学习。这是有意为之。一个学习评估国际象棋局面的神经网络,需要有东西来下它所学习的那些对局,事后还需要有东西让它去击败,否则就无从判断它是否学到了什么。本文讲的就是这个东西。
棋盘,变成数字
Levy 的第一个部分听起来微不足道,其实不然。棋盘有 64 个格子,现代处理器处理的是 64 位的数字,所以自然的表示方式是每种棋子一个数字,这种棋子站在哪个格子上,就把对应的位设为 1。十二个数字,白方和黑方各六种棋子各一个,局面就有了。一步棋是十六位:从哪里走,走到哪里,再加几位表示这是哪一类走法。一盘棋的全部状态,占用的内存比这一段文字还少。
之所以要在意这些,是为了速度。问「这个马能走到哪里」变成了查一张表;问「王是否被攻击」变成了对这些数字做几次与运算和或运算。一个引擎每秒要问这些问题几千万次,而每一次都必须完全正确,因为国际象棋的规则有很多犄角旮旯。王车易位时穿过受攻击的格子。吃过路兵的兵,在吃子的同时让己方的王沿横线暴露在将军之下。一个在走法生成里有一个罕见 bug 的程序,可以平安无事地下一千盘棋,然后因为走了一步非法棋而输掉一盘,而没有人注意到是哪一条规则出的错。
检验这一点的测试有个名字,叫 perft,它是每个引擎作者最先运行的东西。你从一个已知局面出发,数出到固定深度为止所有合法的走法序列,再与公开的数字比较,这些数字几十年来早有公论。
| 向前看的步数 | 从初始局面可到达的局面数 |
|---|---|
| 1 | 20 |
| 2 | 400 |
| 3 | 8,902 |
| 4 | 197,281 |
| 5 | 4,865,609 |
如果你的程序在深度五时给出 4,865,609,你的规则就是对的,至少对初始局面而言如此。还有第二个人人都用的局面,绰号 Kiwipete,其中王车易位权、吃过路兵和升变同时存在,另外还有几个更刁钻的残局。Kishi 在每次改动时都会跑完整套测试。项目中的每个对局工具还会用 Kishi 自己的走法生成器检查对手的走法,所以如果两个程序在规则上出现分歧,这盘棋会大声报错,而不是被悄悄计分。
有一个决定此后一直伴随着这个引擎。在 Kishi 里,一个局面是一个被复制、而不是被修改的小值。走一步棋会交给你一个新局面,旧局面原封不动,所以没有「撤销走法」,两者也就不可能逐渐错位。代价是每步棋复制几百个字节,换来的是不可能与自身失去同步的代码。对于一个后来要被编译成 WebAssembly、同时在多个线程上运行的程序来说,这是正确的取舍,换作今天我还会这样选。
评估函数
Levy 的第二个部分,是我以为国际象棋会藏在里面的那个,而它几乎什么都不包含。评估函数只看单个局面,不向前看,返回一个数字:谁占优,优势多大,以百分之一个兵为单位。正 100 表示轮到走棋的一方多一个兵,或者在局面上有相当于一个兵的优势。在 Hassabis 读过的那本书里,Levy 举的例子是子力与机动性的权衡:如果你剩下的棋子的重要性是它们能到达的格子的两倍,那就在加上机动性分数之前,先把子力分数翻倍。这个思路至今没有变:给能数出来的东西加权。
Kishi 的手写评估函数是一套知名的表,叫 PeSTO。十二种棋子各有一张 64 个数字的表,每个格子一个数字:中心的马比边线上的马更值钱,王在中局时应该待在角落,在残局时应该来到中心,一个挺进到远处的兵比待在原位的兵更值钱。每种棋子有两张表,一张用于中局,一张用于残局,评估函数根据剩余子力的多少把两者混合。把棋盘上各个棋子对应的表项加起来,就是那个数字。
除此之外它一无所知。对兵形的了解仅限于每个兵站在哪里,对王的安全的了解仅限于王站在哪里,不知道车是否在开放线上,也不知道任意两个棋子之间有什么关系。它就是两组 768 个数字,外加一次插值,而它下棋的水平足以击败大多数下国际象棋的人,这说明了这些程序的棋力究竟在哪里。不在知识里。
下一篇我还会回到 768 这个数字,因为那个本应取代这张表的神经网络恰好有 768 个输入,而这并非巧合。
引擎里其实已经有一小块学习,值得用一句话说说,因为它是整个项目所关注的那个思想最小的一个例子。搜索会维护一张表,记录评估函数最近对它见过的每种兵形错了多少,并在使用评估值之前用这个滑动平均对它加以修正。这个修正是在对局过程中、从搜索自身更深的结果里学来的,对局结束后就被丢弃。
搜索
Levy 的第三个部分,是工程所在之处,也是棋力的来源。搜索尝试每一步棋,以及每一步应着,再到应着的应着,构建一棵可能到达的局面树,并在叶节点上询问评估函数。教科书版本是极小化极大:假设对手总是选择对你最不利的应着,然后选择最坏情况最好的那步棋。Alpha-beta 是附带一个证明的极小化极大,证明这棵树的大部分并不重要。一旦某个应着已经表明一步棋足够糟糕,你就不再去读这步棋的其余变化,就像你在一份合同条款里找到那句足以让交易告吹的话之后,就不再读下去。如果每一步都先检查最好的走法,alpha-beta 能看得和极小化极大一样远,访问的局面数却大约只是后者的平方根。
现代引擎在此之上所做的一切,都是关于国际象棋的赌注,而每一个赌注都有输的时候。引擎经过调校,使得这些赌注换来的额外深度,比它们造成的失误更有价值。
| 技术 | 赌注 | 在 Kishi 中 |
|---|---|---|
| 置换表 | 同一个局面可以由不同的走法顺序到达,所以把找到的结果记下来 | 16 字节的表项,存在一张所有线程无锁共享的表里 |
| 走法排序 | 先看最可能最好的走法,让截断尽早发生 | 先是表里记住的走法,然后按价值排序的吃子,然后是最近引发过截断的走法 |
| 空着剪枝 | 如果什么都不做就已经足够好,那走一步也一样;跳过其余部分 | 停一手之后做一次较浅的搜索,领先越多,搜索越浅 |
| 反向无益剪枝(reverse futility pruning) | 深度很浅而局面远高于目标时,就停止查看 | 余量为每层深度 75(以百分之一个兵计),用于深度八层以内 |
| 后期走法缩减(LMR) | 排在后面的走法很少是最好的,所以用较浅的深度搜索它们 | 一个基于深度和走法序号的对数的公式 |
| 单一延伸(singular extension) | 一步远好于所有其他选择的棋,值得看得更深 | 深度八层起启用 |
| 静态搜索 | 永远不要在交换进行到一半时评估 | 一直吃下去,直到局面平稳,再去询问评估函数 |
这些都不是我发明的。它们是开源引擎的共同遗产,是三十年来由那些用数万盘对局逐一测试每项技术的人摸索出来的,也正是因为它们,Kishi 的搜索只有几千行,而不是一个研究项目。我希望你从这张表里记住的是它的形状。一个国际象棋搜索是一堆统计赌注,每一个都带着一个以百分之一个兵为单位写下的余量,每一个都针对与它一起运行的那个特定评估函数调校过。这些赌注并不知道评估函数是什么。下一篇里评估函数会换掉,而这句话就会变得代价高昂。
所有这些都就位之后,在笔记本电脑的一个核心上,引擎每秒检查大约三百万个局面,在半秒之内,也就是点一下棋盘的工夫,向前看十七到二十个半回合。1997 年的 Deep Blue 在专门为此打造的硬件上每秒检查两亿个局面,向前看十二到十六个半回合。局面少了六十倍,却看得稍远一些:差别就在于那些赌注。
凭什么说你知道
现在是难的部分。两个国际象棋程序可以彼此对弈,其中一个赢得更多,而你想把这一点变成一个数字。国际象棋从 1960 年代起就有这样一个数字:Elo 等级分,每个俱乐部棋手都知道的那个数字,也是我十几岁时在地区比赛上第一次接触到的数字,所以这套算术对我来说从来都不抽象。相差 400 分意味着十比一的胜算。相差 100 分意味着较强的一方大约得到 64% 的分数。两个程序之间的等级分差是根据它们之间一场对抗赛的得分算出来的,而问题在于,一场短对抗赛的得分大部分是噪声。
国际象棋引擎的开发者们为此有一件诚实的工具,值得描述一下,因为诚实就在它的设计里。两个程序从相同的随机开局下几百盘棋,每个开局下两次,交换执色,这样一个运气好的开局就不会偏袒某一方。双方每步棋都获得相同数量的可搜索局面,这样一个更快的程序就无法冒充一个更强的程序。结果还附带一个 95% 置信度下的误差范围,取决于下了多少盘棋。
| 对局数 | 误差范围 |
|---|---|
| 20 | 上下约 200 个等级分 |
| 400 | 约 32 |
| 600 | 约 23 |
在信任这件工具之前,我先把它对准了它自己。双方是同一个程序,每步一万个局面,六百盘棋:
Kishi vs Kishi, 10,000 nodes a move, 600 games: +211 =181 -208 elo +1.7 ± 23.3正 1.7,误差 23,这就是工具读出了零,在什么都没有改变时它就应该读出零。然后是真正的测试,前面描述的兵形修正,对阵没有它的引擎:
Kishi vs Kishi without correction, 600 games: +219 =180 -201 elo +10.4 ± 23.3这很可能是正的,但没有得到证明。大型引擎项目对每一次改动都用数万盘棋来做这个测试,并用一条统计规则:答案一旦明朗,无论偏向哪一边,就立即终止对抗赛。在一台笔记本电脑上,六百盘棋就是一个晚上,而对正十、误差二十三的诚实解读是「留着它,但不要宣称它」。我发现这句话在国际象棋之外也很有用。
lichess 的阶梯
两个版本的 Kishi 之间的对抗赛能说明哪一个更好。它说明不了任何一个有多好。要知道这一点,程序必须和一个人们已经知道其强度的对手下棋,而我所知道的最有用的标尺就在你的口袋里:lichess 的电脑对手,因为人人都和它下过,人人都有一个会击败自己的级别。
这八个级别并不是八个不同的程序。它们都是 Stockfish,世界上最强的开源引擎,被同时从三个方面刻意削弱:一个让它故意选择更差走法的技能设置,一个限制它向前看多少步的上限,以及每步棋的时间限制。这些设置是公开的,就在 lichess 运行的客户端里,所以这个对手可以在一台笔记本电脑上被精确重建。
| 级别 | 技能 | 深度 | 每步用时 |
|---|---|---|---|
| 1 | −9 | 5 | 50 ms |
| 2 | −5 | 5 | 100 ms |
| 3 | −1 | 5 | 150 ms |
| 4 | 3 | 5 | 200 ms |
| 5 | 7 | 5 | 300 ms |
| 6 | 11 | 8 | 400 ms |
| 7 | 16 | 13 | 500 ms |
| 8 | 20 | 22 | 1,000 ms |
Stockfish 自己的技能设置最低只到零,所以我重建的 1 到 3 级比真正的要强一点。4 到 8 级是精确的。Kishi 在单核上与 Stockfish 19 对弈,每个级别二十盘,用时是它自己的应用为相应级别给出的时间:
| 对手 | Kishi 每步用时 | 得分 | 等级分差 |
|---|---|---|---|
| lichess 4 级 | 200 ms | 20 盘得 19 分 | +511,上下浮动 646 |
| lichess 6 级 | 500 ms | 20 盘得 13 分 | +108,上下浮动 165 |
| lichess 7 级 | 500 ms | 20 盘得 ½ 分 | −636,上下浮动 579 |
每个级别二十盘棋,误差范围大到能开过一辆公共汽车,这正是它们写在表里、而没有被略去的原因。这些数字能支持的说法是:使用手写评估函数,在单核上,每步半秒,Kishi 介于 lichess 的 6 级和 7 级之间。如果 6 级是那个会击败你的级别,那么 Kishi 三盘里能赢它两盘。7 级是向前看十三步、棋力大部分完好的 Stockfish,二十盘棋只和一盘,是对这段差距的诚实描述。8 级是深度 22 的 Stockfish,也就是说,就是 Stockfish 本身,任何在笔记本电脑上手写的评估函数都到不了那里。
应用在手机上用四个核心下棋,而这些数字来自一个核心,所以你在 kishi.raskell.io 遇到的对手比表里的稍强一些。随着训练好的神经网络陆续到来,我会按手机的预算再测一次,因为正是这个测量将决定它们能否上线。
同样的三个部分,再来两次
将棋采用了同样的构造:变成数字的棋盘,额外的麻烦是被吃掉的棋子会进入手中,还能回到棋盘上;一个计算子力的手写评估函数,手中的棋子比棋盘上的棋子稍值钱一些,并奖励靠近己方王的金将和银将;以及同样的搜索和同样的赌注。对阵下将棋的变体引擎 Fairy-Stockfish,每步半秒,它在最弱的技能设置下二十盘全胜,在中等设置下二十盘只赢两盘。一个说得过去的俱乐部级对手,离高水平还差得很远,而手写评估函数已经到了设计吃力的地方:棋子会回到棋盘上,就没有可以简化进入的残局,一张格子表能说明的东西也越来越少。
围棋没有采用这三个部分,因为它们行不通。没有哪张 361 个格子的表能告诉你一个围棋局面里谁在领先,而在十九乘十九的棋盘上向前看四步的搜索几乎什么都看不到。Kishi 的围棋引擎像 2008 年的程序那样下棋:把成千上万盘快速的随机对局下到终局再数子。对阵最低级别的 GNU Go,它十盘赢三盘。这种方法,以及为什么它是 AlphaGo 必须走出的死胡同,值得单独写一篇。
代价是什么
| 引擎 | 几天的 Rust,借助编码智能体写成,由我掌舵 |
| 规则测试 | 几秒钟,每次改动都跑 |
| 每秒搜索的局面数,单核 | 300 万到 370 万 |
| 一场 600 盘、每步 10,000 个局面的对抗赛 | 十个核心上的一个晚上 |
| 对阵一个 lichess 级别的二十盘棋 | 几分钟 |
这条基线是整个项目里最重要的数字,也是最不起眼的。它是每一个训练出来的神经网络都必须击败的对手,是将要生成它们最初学习所用对局的棋手,也是其余所有工作试图让它变得多余的东西。Levy 的三个部分,构建出来之后,装着一张手写的 768 个数字的表和大量的搜索,落在你手机上那个电脑对手的 6 级和 7 级之间。下一篇会给这张表加上一个隐藏层,看看那要付出什么代价。
参考资料
- Ronald Friederich, PeSTO’s evaluation function, Chess Programming Wiki.
- Perft results, Chess Programming Wiki.
- lichess, fishnet:运行电脑对手各级别的客户端,附有级别表。
- Arpad Elo, The Rating of Chessplayers, Past and Present (Arco, 1978).
- Kishi:
engine/是搜索和评估函数,tools/是对局运行工具,docs/study/notebook.md记录了本文引用的每一场对抗赛。