赢下一切,不控制任何人
Sebastian Mallaby 为 Demis Hassabis 写的传记,是我所知最好的现代 AI 史,也是对一个厌恶控制却又行使控制的人的坦诚研究。
| 阅读时长 | 18 分钟 |
|---|---|
| 发布于 | |
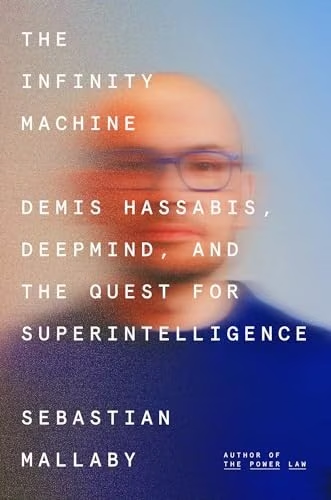
| 书评对象 | The Infinity Machine by Sebastian Mallaby (2026) |
| 评分 | 8.5 / 10 |
| 主题 | 智能, 强化学习, 游戏, 研究实验室, AI 对齐, 技术史, 技术竞赛, 后稀缺, 国际象棋, 将棋, 围棋, 星际争霸 |
简而言之
Sebastian Mallaby 的 The Infinity Machine 是 Demis Hassabis 的传记,也是我所知最好的现代 AI 史;我给它打 8.5 分(满分 10 分)。 它把每个概念讲两遍,先用类比,再讲机制;它把这个领域讲成强化学习与深度学习之间的一场长期纷争,而每一次真正的突破都结合了两者。 它坦诚面对 DeepMind 的错误,从误判语言模型到没能发布自己的聊天机器人;书中一次次失败的治理尝试让我相信,至少眼下,AI 既停不下来,也无法被治理。 它的核心是一幅人物肖像:一个极度好胜、自称厌恶控制、却又在行使控制的人;其中的教训是,权力必须始终只是做事的手段,而这需要自律。 它的不足在于距离感:Hassabis 往往拥有最后的发言权,对手则只是从外部看到的;最后几章读起来像新闻快讯。但要理解 AI 背后的人,这是必读之书。
The Infinity Machine 开篇的场景与 Demis Hassabis 毫无关系。2015 年,在皇家学会的一场讲座之后,Nick Bostrom 问 Geoffrey Hinton:既然他认为政治体制会用 AI 来恐吓民众,为什么还要继续做 AI 研究?Hinton 回答说,他可以搬出那些常见的理由,「但事实是,发现的前景实在太诱人了。」Mallaby 说这个故事一直萦绕在他心头,它也为整本书定下了问题:如果打造这项技术的人明白其中的危险,他们为什么还要造它?他们是什么样的人,这又是否重要?
他的回答是一部 Demis Hassabis 的传记,同时也是我读过的、关于 AI 如何从下棋打游戏的程序走到今天的最好的叙述。我给它打 8.5 分(满分 10 分)。想了解这项技术背后的人、驱动他们的是什么,以及为什么似乎没有人能让它停下来,这本书是必读的。
这本书讲的是什么
这本书做了两件事。它讲述一个人的一生:Hassabis 四岁时看父亲下棋,几周之内就能赢过大人;十三岁成为国际象棋大师;上大学前在 Bullfrog 当游戏设计师;一家失败的游戏工作室;神经科学博士;DeepMind;卖给 Google;AlphaGo;AlphaFold;诺贝尔奖;以及 ChatGPT 之后的手忙脚乱。它还通过观念来讲述这个领域的历史,按观念出现的先后顺序。Mallaby 在三年里与 Hassabis 相处了大约三十个小时,并采访了他身边一百多人,所以对手们和与他闹翻的人都能用自己的话发声。
书名来自剑桥。Hassabis 和他的朋友 David Silver 曾设想一台能在近乎无限的数据中找出规律的机器;后来 Hassabis 招揽 Mustafa Suleyman 时说,一台无限机器将拥有无限的潜力(第 2 章和第 4 章)。这个说法背后是归纳问题:符号 AI 从未解决它,而本书其余部分看着深度学习和强化学习一点一点地解决了它。
一部按正确顺序讲述的 AI 史
Mallaby 把技术讲两遍,一遍用类比,一遍讲机制。例如:
- 图像网络如何学习(第 6 章)。最前面几层找出边缘和色块,后面几层找出曲线和纹理,更深的层找出爪子的轮廓,最后几层说出「猫」。然后是机制:权重、偏置,六千万个参数被一点点调整,直到输入与输出对得上。
- 为什么 Atari 智能体需要经验回放(第 6 章)。一个图像分类器如果被喂入一叠排好序的照片,前面全是猫,就会断定一切都是猫。一个困在游戏某个角落的智能体也有同样的问题。把经验存下来再随机抽样,就解决了这个问题;Hassabis 从中看到了海马体在睡眠中所做的事。
- 为什么 Atari 智能体需要第二个网络(第 6 章)。一个不断给自己的估计添加乐观成分的智能体,就像一个在人行道上捡到几张百元钞票的人,断定自己只要走上一个月就能成为亿万富翁。Mallaby 为解决办法找的比喻是一位网球教练,他先观察一阵再给建议:一个网络用冻结的权重去玩,另一个网络学习,经过一段时间的学习之后才把心得交接过去。
- AlphaGo 作为两种思维(第 9 章)。策略网络提出着法,就像强手一眼看出的那样;价值网络评判局面;树搜索负责缓慢而审慎的部分。Mallaby 把它们对应到 Kahneman 的系统一和系统二。
- 残差网络(第 12 章)。深层网络会像传话游戏一样把信号传走样;跳跃连接是绕过中间层的快车道。
- Transformer(第 12 章)。嵌入是一张有数百个维度的语言地图;注意力就像知道要看懂这一集犯罪剧,需要回想前面哪一集;中间还绕道 Henri Bergson,谈时间是注意力而非序列。
这些解释不需要任何背景知识,也不居高临下。顺序同样重要:每一章都展示了上一次突破让什么成为可能,又做不到什么,所以从 ImageNet 到 Atari,到 AlphaGo,到 AlphaZero,到 Transformer,到 AlphaFold,再到推理模型,这条链读起来是一个完整的论证。
处于中心的纷争
把这段历史串起来的线索,是强化学习与深度学习之间的竞争。它起初是地理上的:Hinton 的深度学习派在多伦多,Richard Sutton 的强化学习派在阿尔伯塔,彼此几乎不说话。强化学习理论家 Csaba Szepesvári 承认神经网络在实践中有效,但他不愿使用,因为他无法就它们证明任何东西;Hinton 对想把两者结合起来的学生 Vlad Mnih 说:「我试过了,行不通。」Mnih 去了伦敦,还是做了,结果就是那个 Atari 智能体(第 6 章)。
从那以后,书中展示了钟摆来回摆动,而且从不让任何一方长久获胜:
| 时期 | 谁看起来是对的 | 发生了什么 | 另一方的贡献 |
|---|---|---|---|
| 2006 年至 2012 年 | 深度学习 | Hinton 的深度信念网络,然后是图形芯片,然后是 Alex Krizhevsky 在自己卧室里训练、赢下 ImageNet;他的三人公司以 4400 万美元卖给 Google(第 4 章和第 6 章) | 暂时没有:两个阵营几乎不交流 |
| 2013 年 | 第一次两者都对 | DeepMind 的 Atari 智能体仅凭像素和分数学会了几十款游戏;当《打砖块》里的隧道出现时,NIPS 会场一片寂静(第 6 章) | 来自深度学习的卷积网络负责看屏幕;来自强化学习的 Q 学习、经验回放,以及让估计保持诚实的第二个网络 |
| 2014 年至 2016 年 | 强化学习 | AlphaGo 以五比零击败樊麾,又以四比一击败李世石,留下了第 37 手(第 9 章) | 充当直觉的策略网络和价值网络属于深度学习,最初用 15 万盘人类棋谱训练 |
| 2017 年 | 强化学习,而且声势浩大 | AlphaZero 只靠自我对弈学会了围棋、国际象棋和将棋,完全不用人类棋谱(第 12 章) | 一个来自微软的残差网络,深到足以把 AlphaGo 的两个网络合而为一 |
| 2017 年至 2019 年 | 深度学习 | LeCun 把强化学习称为「蛋糕上的樱桃」;Transformer 和 GPT 从无标注文本中学习,这抽掉了强化学习的两大卖点:无需人类标注就能学习,以及自己生成数据(第 12 章) | 很少,直到后训练出现 |
| 2017 年至 2020 年 | 单靠哪一方都不行 | Gaia,一个供智能体使用的模拟自然世界,失败了;AlphaStar 对《星际争霸 II》内置 AI 的胜率因为一个 Transformer 从 10% 跃升到 84%,然后强化学习把它对排位人类玩家的胜率推到 99.8%;一个纯自我对弈的星际争霸智能体始终没能起步(第 13 章) | 每一方都需要另一方,哪一方都无法单独做到 |
| 2018 年至 2020 年 | 深度学习,加上生物学 | AlphaFold 起初是一个强化学习项目,最后却靠基本放弃强化学习而获胜;Hassabis 说:「蛋白质折叠不是双人游戏。」(第 15 章) | 第一版 AlphaFold 里有一个搜索步骤,之后就没有了;决定性的想法来自进化和 Transformer |
| 2022 年至 2023 年 | 深度学习,由强化学习驯服 | ChatGPT 和 DeepMind 未发布的 Sparrow 都是靠基于人类反馈的强化学习才变得可用;Silver 把机器强化学习引入 Gemini 的尝试陷入停滞,因为没有人能为一首好俳句写出奖励函数(第 16 章至第 18 章) | 人类评分员提供了过去由游戏分数提供的奖励 |
| 2024 年以后 | 再次是强化学习 | 来自有正确答案的数学和逻辑题的奖励,教会模型一步一步推理:OpenAI 的 o1、Gemini Flash Thinking、DeepSeek 的 R1-Zero;AlphaProof 拿下奥林匹克数学竞赛银牌;Silver 和 Sutton 宣告「经验时代」到来(第 19 章和第 20 章) | 被训练的语言模型属于深度学习;强化学习如今运行在它们之上,奖励黑客(reward hacking)也是 |
书中每一次真正的突破都结合了两种方法,而在任何时刻看起来错了的一方,通常只是在等待另一方的下一次进展。
DeepMind 错在哪里
Mallaby 是一位怀有同情的传记作者,但他没有掩盖 DeepMind 的错误。DeepMind 2010 年的商业计划书否定了它所说的那种错误观念,即语言就是表达出来的智能。Hassabis 相信,一个模型必须在世界中行动才能理解世界,他多年来一直误判 GPT。他也承认这一点:「你不可能每次都是诺查丹玛斯。」(第 13 章)
后来他解释了原因。他原以为人类行为的空间近乎无限;结果互联网上大约十四万亿个词就涵盖了其中大部分。他把互联网比作工业革命恰好在地下找到的煤和石油:没有人是为了 AI 建造它的,它本来也不一定存在。我在评论 Tim Berners-Lee 的回忆录时从另一个方向提出过同样的论点,见网络就是训练集;而 Hassabis 是从实验室内部得出这个结论的。
其他错误是组织层面的。Google 陷入了施乐 PARC 的困境:它发明了 Transformer,却无法在不危及搜索业务的情况下发布聊天机器人。DeepMind 陷入了贝尔实验室的困境:一种为开放式探索而建立的文化,在道路已经明朗时却无法转向工程。DeepMind 有一个聊天机器人 Sparrow,带有二十三条行为规则和网络搜索功能,ChatGPT 发布时它已几乎准备就绪,却始终没有发布(第 16 章和第 17 章)。
那些人
Peter Thiel 投资 DeepMind,是因为它看起来既反主流又便宜,但他从未真正相信它,还差点让它把钱烧光(第 7 章)。Elon Musk 承诺出钱,在壁橱里打了一通电话,试图为特斯拉或 SpaceX 收购 DeepMind,后来在坐过 DeepMind 自己的安全委员会之后,又联合创办了与之对抗的 OpenAI(第 8 章和第 10 章)。Mark Zuckerberg 在一顿晚餐上失去了 DeepMind,因为 Hassabis 注意到他对虚拟现实和 3D 打印的兴奋程度不亚于对 AI,随后他聘请 Yann LeCun 来挖 DeepMind 的人(第 8 章)。Larry Page 因为 Musk 偏爱人类胜过机器,称他为「物种主义者」(第 10 章)。Sam Altman 主要是通过对手的眼睛被看到的,他出场时是那个在 2015 年写下阻止人类发展 AI「几乎肯定不」可能的人,然后他比任何人都更卖力地证明了这一点。Dario Amodei 以安全研究员的身份出现,他推动了 GPT-2 的规模化,后来离开并创办了 Anthropic。
Mustafa Suleyman 的故事读来最令人难受。他是 Hassabis 弟弟的朋友,后来成了联合创始人。他为英国国家医疗服务体系 NHS 做的医疗工作很出色(Streams 应用把未被察觉的紧急肾病病例比例从 12.4% 降到 3.3%,第 11 章),却被一篇小报上关于数据的报道扼杀了。他为让 DeepMind 接受独立监督而进行的努力持续了三年,最终失败(第 14 章)。接着是一场霸凌调查、一次休假,以及彭博社的一个标题,这段友谊就此结束。Mallaby 让两个人都讲了自己的说法。
为什么它无法被治理
读完这本书,我比以前更加确信,AI 停不下来,也无法被治理,至少眼下如此。这是我的结论,但书中提供了大部分证据。每一次从行业内部治理它的尝试都失败了,而政府来得太晚,带来的只是自愿承诺:
- 伦理与安全委员会是 Google 收购 DeepMind 时同意设立的,只在 SpaceX 开过一次会。它的几位嘉宾随后创办或资助了一家竞争对手实验室。Hassabis 说:「我们所谓的顾问其实是我们的对手。」(第 10 章)
- 独立小组负责监督 DeepMind Health,在 Google 吸收医疗团队时被解散(第 14 章)。
- Project Mario,为一个由三名 Google 董事、三名 DeepMind 董事和三名独立董事组成董事会的 DeepMind 进行了三年谈判,最后一无所获。Reid Hoffman 承诺向一个独立出去的 DeepMind 投入十亿美元,但这件事从未发生(第 14 章)。
- OpenAI 的非营利董事会解雇了 Altman,结果只撑了五天(第 18 章)。
- 暂停公开信在 2023 年获得了一千多人签名,但没有一家领先实验室的负责人签字。Hassabis 的反对意见站得住脚:在芯片和数据中心持续进步的同时暂停模型,就等于把下一场竞赛交给暂停结束时算力最多的人(第 18 章)。
到 2025 年,Hassabis 得出结论:「安全不在于治理结构」,你所能做的最多是在谈判桌上占有一席之地。Mallaby 称之为「一副单薄的安慰脚手架」,并承认这可能已是现有的最好选择。这两点我都同意他的看法。
我熟悉的那些部分
第 3 章有一句话,说 Hassabis 有一种「想玩、想赢点什么、赢什么都行的强烈渴望」,他的第一家游戏工作室曾试图用梦幻足球和星际争霸来满足这种渴望。当一位同事终于在桌上足球上赢了他时,他宣称自己的灵魂着了火。我笑了,因为我认得这种感觉。我年轻时在国际象棋俱乐部下过棋,星际争霸至今仍是我最喜欢的策略游戏,而我对韩国《母巢之战》圈子的关注程度,足以让我为它做了一个网站。所以,关于 AlphaStar 的章节,以及关于 AlphaGo 在韩国两亿观众面前对阵李世石的章节,对我来说是一种大多数 AI 史都没有的切身体验。
那些游戏也是如此。我很喜欢 Peter Molyneux 的 Black & White,后来又喜欢 Fable;Hassabis 参与过 Black & White 的早期设计,因为在这款游戏里,生物第一次会根据玩家的拍打和抚摸改变自身的规则,这是商业游戏里的一个小型强化学习系统(第 2 章)。在那之前,他十几岁时就为 Theme Park 打造了模拟游客,他们吃了咸薯条会口渴,坐了过山车会吐。书中从那些模拟世界画了一条直线,连到 Gaia(DeepMind 模拟生物圈的尝试),也连到 Hassabis 对康威生命游戏和涌现的着迷:把简单的部件组合在一起,就会出现任何部件都不具备的性质。这正是我在自己的模拟中不断回到的问题,从 Hotaru,一个学会玩 Pong 的模拟神经元培养物,到 Kishi 里的引擎。Kishi 下国际象棋、将棋和围棋,正是 AlphaZero 学会的那三种棋,而 Learning to Play 系列则是我对第 9 章和第 12 章那些问题的小规模版本。Hassabis 还曾登上英国将棋排名的榜首。
他想要的未来和我想要的很接近:用计算解决生物学,由机器人和自动化来干活,以及富足。他是读 Iain Banks 的「文明」系列小说长大的,在第 7 章里他走得比业内大多数人都远。他怀疑全民基本收入是否是答案,更倾向于他所说的全民基本供给:住房、教育、医疗和出行,达到今天百万富翁所享受的水平,免费提供给每个公民,而想要一辆法拉利的人,可以去工作。Silver 在第 20 章末尾提出把获得 AI 协助列为一项人权。两者都算不上计划,但都比大多数政策辩论更适合作为起点。
赢而不控制
Mallaby 在整本书中始终关注 Hassabis 的两个特质,而这两个特质恰好我也有。他好胜到了凶猛的地步:Hinton 说他是自己见过的唯一一个比 Hinton 还好胜的人。而从第 2 章开始,他就坚持说自己不想控制任何人,说「操纵或控制别人真的很糟糕」,并把这一价值观追溯到他母亲的教会。他似乎也不在乎钱。十八岁时,为了去剑桥读书,他拒绝兑现 Molyneux 给他的一张 50 万英镑的支票。出售 DeepMind 时,他和 Suleyman 先谈研究预算,再谈价格;在尾声中,他说给他多少钱他也不会拿诺贝尔奖去换。他开一辆十年车龄的奥迪,唯一的奢侈是一张利物浦的季票。
Mallaby 检验了关于控制的说法,而证据有正有反:
- 在 Elixir,Hassabis 的「绝地控心术」把一个团队鼓舞到了听不进诚实反馈的地步。他后来说:「谁能想到,你真的会把人鼓舞得太过头?」(第 3 章)一位心理学家告诉 Mallaby,有魅力的人无论多么努力,都无法避免支配他人。
- 在 Elixir 时他拒绝了风险投资,因为让出一半公司就意味着被控制。在 DeepMind,他拿的股份是他的科学联合创始人的九倍,因为他想掌控使命(第 5 章)。
- 他厌恶两个方向的支配:他不愿支配别人,也不愿被别人支配。当 Suleyman 挑战他的方向时,他让一场调查去做本该由一次谈话完成的事(第 14 章)。
- 在尾声中,Mallaby 直截了当地向他提出:「他一再告诉我,他不想控制别人。然而他确实控制着人。」Hassabis 回答说,他行使的是一种不情愿的权力,因为他想做的事需要庞大的团队。
对任何喜欢赢、又不喜欢权力的人来说,这是一个警告:前一个特质会把你放到不得不行使权力的位置上,而那正是后一个特质想要回避的。Hassabis 的回答是,权力作为做事的手段可以接受,但永远不能成为目的,这个回答是对的。但这本书表明,要让权力始终只是手段,需要多大的自律。
不足之处
我扣下的那半分,主要是因为距离感。Mallaby 在引言里、在给出证据之前,就宣布了他的结论:Hassabis 是「正派而有公心的」;虽然书中确实检验了这一点,但在大多数争议上,最后的发言权都归 Hassabis。OpenAI 和 Anthropic 是从外部被看到的,主要通过离开它们或与它们竞争的人,所以 Altman 几乎完全是由他的对手描绘的。而且 Mallaby 在一些本可以只做报道的地方发表了议论:他对批评 DeepMind Health 的独立小组很严厉,在关于 Gemini 基准测试的争论中对 DeepMind 很宽容,还一度说 DeepSeek 的 R1-Zero「实际上」是有自我意识的,而他给出的证据并不支持这个说法。
最后几章读起来也像新闻快讯。它们匆匆掠过已经过时的基准测试和产品名称,缺少写剑桥、Elixir 和 AlphaGo 那几章的从容。对于一本 2026 年写完、讲述一场仍在进行的竞赛的书来说,这也许无法避免,而这些都不改变我的推荐。
谁应该读它
它适合任何想通过造就了过去十五年 AI 的那些人来理解这段历史的读者,书中还顺带把概念讲清楚了。不需要技术背景;即使你有,这些解释的顺序和类比也依然值得一读。它和我的阅读记录里的那些预测(比如 AI 2027)很搭:那些预测描述的是事情可能走向何方,而这本书展示的是谁在驾驶、为什么驾驶,以及包括驾驶者在内,任何人对路线的掌控是多么有限。
全书以 Hassabis 坐在一家酒吧里结束,他说,看着自己的梦想成真,本该感觉很美妙,但并没有,因为一切都在疯狂地往前赶。他依然乐观。