# Raskell:简体中文译文全文
> raskell.io 是 Raffael Schneider 的个人网站。他是瑞士巴塞尔的一名 AI 架构师。网站以英文为主;下列文章和页面有简体中文版本,其余文章、笔记、书评和演讲只有英文版。每篇译文都有一份 Markdown 副本(网址把结尾的斜杠换成 .md)。
================================================================================
---
title: "上下文为王:让模型属于你的那一层"
url: https://raskell.io/zh/articles/context-is-king/
author: Raffael Schneider
date: 2026-12-01
description: "模型是通用的,上下文让它属于你。为什么每个人都会有一层上下文,以及我为自己的智能体构建它时学到了什么。"
tags: [agent-experience, context-engineering, knowledge-management, external-memory, provenance, local-first, agents]
lang: zh-Hans
translation_of: https://raskell.io/articles/context-is-king/
---
# 上下文为王:让模型属于你的那一层
## 简而言之
生成式预训练 Transformer 让能力变得通用而廉价;让它对某一个人真正有效的是上下文,而下一次效果与效率的大幅提升正来自这里。 每个与智能体共事的人都会有一层个人上下文,他们交谈的助手有多好,取决于这一层有多好;模型是租来的,所以上下文应当由本人以开放格式拥有。 我为自己的智能体构建的这一层,是一个由 git 中相互链接的 Markdown 笔记组成的小型路由器,每个会话都从它开始,隔离由代码强制执行,唯一的接口是一条命令。 每晚的一次「做梦」对照会话记录来整理它,无需人工审核;这之所以站得住,只因为闸门是机械的,而且每一晚都可以回滚。 Kurumi 是建在这样一层之上的助手,IT Intelligence 则是同一层在整个组织上的版本:无论规模大小,模式都是同一个。
过去几年的大语言模型让能力变得通用。一个生成式预训练 Transformer 读过人类写下的很大一部分东西,几乎在任何领域都能起草、推理、翻译和写代码。那是一场革命。它没有做到的,是让模型知道任何关于你的事:你的项目、你的规则、你已经做过的决定以及原因、与你共事的人、你不想再犯的错误。模型对每个人都一样。凡是让它属于你的东西,都得从别处来。
那个别处就是上下文。我认为这些系统能力的下一大步正来自这里:同一个模型,拿到关于它所服务之人的恰当的两千字节。大多数人低估了这一层。我认为每个与智能体共事的人最终都会有这样一层,而构建我自己的那一层,让我对它的理解超过了任何一篇论文。
## 通用模型与缺失的上下文 {#the-general-model-and-the-missing-context}
通用性是这些模型的天赋,也是它们的缺口。一个几乎什么都能做的模型,并不知道你需要其中哪一件,用哪种风格,在哪些约束之下,带着怎样的历史。每一次与缺少这些知识的助手的会话,都从一个陌生人开始,而你为此付出两次代价:一次在效果上,因为陌生人会猜,有些猜错了;一次在效率上,因为它在做任何有用的事之前,要花 token 和时间重新摸清你的世界。
上下文同时填补这两个缺口。在 [Context Is the Product](https://raskell.io/articles/context-is-the-product/) 里我论证过,模型正在变成商品,而上下文不会。在 [Agent Experience](https://raskell.io/articles/agent-experience/) 里我把一个智能体需要猜多少,描述为衡量一个系统对它服务得有多好的标准。个人上下文层就是面向一个人的智能体体验:同一个模型,拿到一页简短的说明,写着你是谁、你在构建什么、哪些错误不要重犯,就会少问问题、少猜、少花 token 来熟悉情况,并做出你自己也会做的那种改动。它无需重新训练就变得量身定制。
这门手艺已经有了名字。Andrej Karpathy 的话,经 [Simon Willison 引用](https://simonwillison.net/2025/Jun/27/context-engineering/),在 2025 年 6 月把上下文工程称为「用恰好合适的信息填满上下文窗口的精妙艺术与科学」。这些信息大多关于任务。个人上下文层是其中关于你的那一部分,也是从一个任务到下一个任务都不会改变的那一部分。
有实测证据表明,一层经过整理的知识能带来单靠搜索带不来的东西。在 [The components of agent memory](https://www.anthropic.com/research/components-of-agent-memory) 中,Anthropic 报告说,当 Claude 同时拥有一个搜索工具和一个它逐渐积累起来的 wiki 时,它的得分「随着 wiki 的增长从 54% 升到 61%,而只能使用搜索工具时为 53%」。搜索找到存在的东西。整理过的一层说明什么重要。
## 每个人,一层上下文 {#every-person-a-context-layer}
我认为几年之内,每个与智能体共事的人都会有类似的东西,而人们与助手互动的方式也会由它塑造。你不会去提示一个模型;你会通过文字或语音,与一个已经了解你的项目、你的承诺和你的工作方式的助手交谈,它会在你的各种工具之间替你行动。大概还会有好几个助手,来自不同的厂商,做不同的工作。让它们属于你、并让它们彼此保持一致的,是它们共同取用的那一层。
重要的问题是这一层归谁所有。今天,记忆大多存在于产品内部。每个智能体工具都保存自己的一份,用自己的格式,一个工具了解到的关于你的东西就留在那里。这很方便,也是一个陷阱:助手对你了解得越多,你就越难离开,你的工作生活也就越多地存放在一个你无法阅读、迁移或更正的地方。另一种选择,是一层属于本人的上下文,以开放格式存放在本人自己的设备上,像代码一样做版本管理,并通过一个小接口提供给本人选择的任何助手。模型是租来的。上下文应当是自己的。
拥有它也意味着构建它,至少目前如此。下面是我如何构建我的那一层,用笼统的说法和简化过的名字,以及我会保留的那些决定。
## 构建一层 {#building-one}
我开启的每一个编程智能体会话,都从一个陌生人开始。智能体在会话中确实学到的东西,按工作目录、按工具分别保存,所以一个智能体在一个仓库里学到的教训,从来到不了下一个仓库里的另一个智能体。有一段时间,我在两个不同智能体工具的指令文件里手工维护同一套规则的两份副本,几天之内它们就各走各路了。于是我建了一个地方,它知道我在做什么、我的规则是什么、我喜欢怎样把事情做完,并且每个智能体会话都从它开始。我叫它我的大脑,因为对我的智能体来说它就是这个。它花了与一个编程智能体的一次长会话,以及与它就设计争论了相当一番。
我一开始提出的要求:
- 放在 git 里的纯 Markdown,相互链接,解析和搜索都很廉价;
- 可以被不止一个智能体工具使用,以后也能被其他工具使用;
- 相互隔离的上下文,比如个人项目和为客户或雇主做的工作,绝不能混在一起;
- 每晚一次「做梦」,整理、质疑并完善这些笔记,无需人工审核;
- 少数几条任何东西都不能推翻的绝对规则,其余一切都可以修改。
在动手构建之前,那个智能体和我几乎在每一条上都有分歧,而正是这些分歧产生了设计。
## 是路由器,不是仓库 {#a-router-not-a-store}
第一版设计想让大脑知道一切。这与加载成本低相冲突,而且会重复已经有归属的信息。经受住考验的版本是一个路由器:笔记保存提炼过的事实和指向,而每个项目自己的文件,它的 README、它的决策记录、它的状态文件,仍然是事实的来源。一个会话加载一个小小的入口页,实际大约 2,600 字节,需要更多时再从那里顺着链接走。
每条笔记是一个只讲一件事的 Markdown 文件:一个项目、一条规则、一个教训、一台机器、一个未决问题。这接近 Andy Matuschak 所说的 [evergreen notes](https://notes.andymatuschak.org/Evergreen_notes),它们「被写下和组织起来,以便随着时间、跨越项目不断演进、贡献和积累」。区别在于读者:这些笔记首先是写给智能体的,人是第二个读者。前置元数据说明它是什么,以及可以信任它到什么程度:
```markdown
---
id: lesson.verify-before-done
type: lesson
context: core
title: Verify before reporting done
summary: A passing build is not a finished change; look at the result.
status: confirmed
source: person
date: 2026-11-02
---
Screenshots of the page in light, dark and phone width before saying a site
change is done. Applies to every project with a UI; see [[rule.no-unverified-claims]].
```
`status` 把本人说过或确认过的内容,与智能体推断出的内容分开;`source` 说明笔记从哪里来:本人、一次会话、一次导入或一次做梦。这一个区分起了很大作用。智能体可以不经询问就遵循一条已确认的规则,而把一条未确认的规则当作需要核实的提示。
笔记之间用 `[[id]]` 互相链接。一个小编译器把这个文件夹变成两样东西:一份每条笔记一行的索引,给想要浏览的智能体;一个图文件,给任何想要遍历的东西:
```json
{
"nodes": [
{ "id": "lesson.verify-before-done", "type": "lesson", "status": "confirmed" },
{ "id": "rule.no-unverified-claims", "type": "rule", "status": "confirmed" }
],
"edges": [
{ "from": "lesson.verify-before-done", "to": "rule.no-unverified-claims" }
]
}
```
一个 linter 会拒绝失效的链接、未知的类型、长得过大的入口页,以及任何指向另一个上下文的笔记。这个结构有意贴近 Anthropic 为 Claude 自己的记忆所描述的样子:会话记录是事实依据,一个由相互链接的页面组成、每页讲一个主题的 wiki,以及顶上一小层注入的内容,因为「记忆层级的顶层必须保持相对较小」。Claude Code 本着同样的精神让它保持小巧;据同一篇文章,它「只加载前 200 行或 25 KB」的记忆索引到每个会话中。这种层级本身比这些产品都要古老。[MemGPT](https://arxiv.org/abs/2310.08560) 由 Charles Packer 等人在 2023 年提出了「虚拟上下文管理,一种借鉴层级式内存系统的技术」,其灵感来自操作系统:上下文窗口里一小层快的,外加一大层慢的,由智能体按需调入。
## 分开的仓库,和一堵墙 {#separate-repositories-and-a-wall}
用同一个仓库里的文件夹来隔离上下文是行不通的,因为任何能读这个仓库的东西都能读到全部。这个设计改为一个核心仓库,存放对本人在每个上下文中都成立的东西,比如工作风格和通用规则,再为每个上下文各设一个仓库,存放它的项目和教训。一个会话加载核心,外加恰好一个上下文。一个上下文里的笔记可以链接到核心,却根本无法表达指向另一个上下文的链接,因为 id 只在核心和当前上下文之内解析。
这是读取时的隔离。更难的问题是写入时的隔离,也就是有东西离开这台机器的时候。告诉智能体不要混用上下文,是一条指令,而指令大多数时候会被遵守。一个拒绝提交的钩子则是一堵墙。于是这堵墙变成了代码:提交、提交信息和推送上的钩子,以及智能体对外发出的 shell 命令上的一个钩子。每一个都会判断仓库属于哪个上下文,并拦下带有另一个上下文识别性词语的内容、作者身份、提交信息和推送目标。它在出错时选择拒绝,并且在启用之前,在一个一次性仓库里针对九种情况做过测试。
整次会话中最有用的一个小时,来自对已有仓库运行这堵墙的审计。它找到了从来没人找过的东西:一个工具的本地缓存文件被意外提交到一个公开仓库,里面有一个内部账户名;公开文件里的家目录绝对路径,暴露了机器的用户名;一个智能体指令文件,其内容被智能体复制进了各个项目的指令文件。有些修复是普通的提交,有一个需要重写历史,还有一个仓库改成了私有。在依赖历史重写之前,有两个限制值得知道:托管服务商可能让旧提交仍然可以通过哈希访问,而别人拥有的分叉会保持公开。总的教训是,**隔离必须在内容离开机器的地方强制执行,而不是在提示词里**,而且光是为了这次审计,构建这道防线就值得。
同样的想法也适用于规则本身。一小组公理,也就是绝不能改变的东西,用一个哈希锁定文件封存,而封存需要一个交互式终端,所以没有智能体能做到。其余一切,包括我自己定下的规则,都可以被质疑。我起初想让我写下的每一条规则都不受做梦影响,那个智能体反驳了:这太宽,因为它会冻结那些后来证明是错的规则;也太弱,因为一个做梦本身就能编辑的保护什么也保护不了。少数几条公理,机械地封存,其余开放,是更好的答案。
## 一条命令,任何智能体 {#one-command-any-agent}
每个会话都以同样的方式开始。一条命令 `ctx context` 打印出入口页、每条一行的公理、当前上下文的主页,以及当工作目录属于一个已知项目时,该项目的笔记。一个智能体工具从会话启动钩子里运行它;另一个则在它的指令文件里被告知去运行它。第三个工具,或者一个尚不存在的工具,也可以调用同一条命令。`ctx find` 和 `ctx show` 用来查找,`ctx capture "..."` 则追加到一个收件箱。
这是设计中最不起眼的部分,也是我会最先照搬的部分。通过一条打印文本的命令来集成,让每个使用方都不必知道大脑是怎样存储的。笔记可以搬家,格式可以改变,图的下面可以长出一个数据库,而任何智能体的配置都不用改。它是[可读性阶梯](https://raskell.io/articles/agent-experience/#the-legibility-ladder)第二级上的一份稳定契约,这意味着大脑不被绑定在任何一家智能体厂商身上。
## 做梦 {#dreaming}
让大脑成长的部分,是每晚的一次整理,我叫它做梦,因为 Anthropic 和其他人也这么叫。让我的笔记做梦这个想法,来自 Helvetia 的同事 [Joachim Prinzbach](https://www.linkedin.com/in/joachimprinzbach/),他在 Anthropic 发表关于智能体记忆的文章之前就给我看过;这个故事的简短版本在 [Memory that dreams](https://raskell.io/notes/memory-that-dreams/) 里。这个想法来自人们对人类记忆运作方式的理解:在睡眠和安静休息时,「海马体会重放我们最近的经历」,其中一部分会被提炼为持久的知识(Anthropic)。智能体版本的历史不长。[Generative Agents](https://arxiv.org/abs/2304.03442) 由 Joon Sung Park 等人在 2023 年提出,它为每个模拟角色保存完整的经历记录,并让它「随着时间把这些记忆综合为更高层次的反思」。Letta 在 2025 年 4 月提出了 [sleep-time compute](https://www.letta.com/blog/sleep-time-compute),论文作者为 Kevin Lin、Charlie Snell 等人,让智能体「利用空闲时间重新组织信息」。而 Anthropic 在 2026 年 5 月以研究预览的形式推出了 [Claude Managed Agents 中的做梦功能](https://claude.com/blog/new-in-claude-managed-agents)。
每晚,对每个上下文分别进行:
*One night of dreaming, for one context*
```text
step what happens
────────────── ───────────────────────────────────────────────────────────
1 harvest session transcripts (text only, capped), new inbox entries,
the tools' own memory files, notes written by hand in Kurumi
│
▼
2 consolidate a headless model, run in this context's repository:
test the notes against the transcripts; correct, merge
and prune; record what lasts; raise conflicts as open
questions; write a short journal of what changed
│
▼
3 gate touched a protected path? linter fails? hook refuses?
│
yes ─────┴───── no
│ │
▼ ▼
discard the commit and push:
whole run one dream, one commit
```
闸门是让这件事在没有人审核的情况下也站得住的原因。会话记录是事实依据,从不被编辑。受保护的路径,包括公理、上下文登记表、工具本身、钩子和做梦自己的提示词,都不能被触碰;一次触碰了其中任何一个的运行会被整个丢弃。linter 和提交钩子对做梦一视同仁,就像对待任何其他写入者。而且因为一次做梦就是一次提交,任何一晚都可以用一条命令回滚。当闸门是机械的、撤销的代价很低时,无人审核的自动化是合理的;当唯一的闸门是模型自己的判断时,它就是鲁莽的。
第一次真正的运行花了大约三分钟。它读了三个会话和各个工具自己的记忆文件,提交了十三个文件。它更正了我为了给大脑打底而手写的笔记里一个过时的说法。它把一个智能体工具写进自己私有记忆里的规则,变成了另一个工具也能看到的笔记。它还提出了一个未决问题,关于我的两个互相拉扯的立场,这正是我希望第二大脑做的事,也是我自己绝不会写下来的东西。
Anthropic 的文章里有一个很好的例子,说明为什么会话记录作为事实依据很重要。在一个游戏的长时间运行中,一条记忆笔记记错了 Claude 需要去的一个地方的位置,而做梦「把这条笔记与会话记录对照,发现了错误,并重写了它」。有了更正后的笔记,Claude 一路向前;用着未更正的笔记,它「三次退回到那条先前的路线上」。一份从不与实际发生的事对照的记忆不会保持中立。它会漂移,而智能体会跟着它走。
## Kurumi:建在这一层之上的助手 {#kurumi-the-assistant-on-top-of-the-layer}
一层只有智能体能读的上下文,会离它所描述的那个人越来越远,所以我自己也需要能舒服地阅读和更正它。我在 [Kurumi](https://kurumi.raskell.io) 里做这件事,它是我开发的本地优先笔记应用,而在个人上下文层之上建一个个人助手这个想法,也是在 Kurumi 里走得最远。
Kurumi 把数据保存在自己的数据库里,但它可以同步一个本地的 Markdown 文件夹,并把改动读回来。大脑并不让 Kurumi 直接指向它的笔记。一条命令 `ctx mirror` 用 Kurumi 自己的格式写出一份单向副本,每个上下文一个库。链接从 id 改写为标题,因为 Kurumi 按标题解析链接。做梦提出的未决问题变成 Kurumi 自己的问题记录,项目笔记变成它的项目记录,这样它们就出现在我本来就在跟踪问题和项目的地方。每晚的日志变成一条笔记,所以「昨晚改了什么」是我配着咖啡读的东西。一条离开大脑的笔记会被标记为已删除,而不是直接移除,因为 Kurumi 会恢复那些凭空消失的文件。而我在 Kurumi 里写下的任何东西,都会被下一次做梦当作我自己的话收进来,带着 `source: person`。
Kurumi 早已从人的一侧在做同样的事。它内置的智能体保存着一条叫「Kurumi memory」的笔记,每次对话开始时都会读,任何人都可以打开并编辑它,这正是上面所说的那种一小层注入内容。当你问它关于某个人或某个项目的事,它会沿着链接,双向地走过你的笔记,找到附在上面的待办、决定和未决问题,并用一张小图展示它走过的路径。还有一种「living note」,会根据它所在主题的笔记重写自己,最多每六小时一次,并带有指回每个来源的链接,这就是单页规模上的做梦。
这个镜像只是权宜之计。正式的版本是我已经开始做的一个 Kurumi 功能:一个链接文件夹库,直接打开大脑的文件,逐字节保留它们外来的前置元数据,按一个可配置的键解析链接,并用内容哈希守护每一次写入。第一部分,即 Kurumi 存储之后的只读链接库,已经在一个分支上;其余部分还在进行中。
## 同一层,面向整个公司 {#the-same-layer-for-a-whole-company}
在 [IT Intelligence](https://raskell.io/articles/it-intelligence/) 和它的[参考实现](https://raskell.io/articles/building-it-intelligence/)里,我描述过一个面向整个组织 IT 版图的知识层。个人上下文层是同一个模式,只是规模缩小到一个人:
| | IT Intelligence,面向一个组织 | 上下文层,面向一个人 |
|---|---|---|
| 原始材料 | 每个系统的导出和 API | 会话记录、收件箱、手写笔记 |
| 保存什么 | 实体和边,带有依据、置信度和来源 | 每个实体一条笔记,带有状态和来源 |
| 事实来源 | 每个记录系统 | 每个项目自己的文件 |
| 整理 | 按计划进行摄取、判断、构建和评分 | 每晚的做梦 |
| 人审阅什么 | 一个待确认的不确定链接队列 | 做梦提出的未决问题 |
| 智能体怎么读 | 一个给出简短答案和来源信息的 MCP 服务器 | 一条打印出一小页的命令 |
| 人怎么读 | 一个带有实体页面和图的网页界面 | Kurumi |
| 绝不能发生什么 | 一个推断出的链接被悄悄提升为事实 | 一个上下文的内容出现在另一个的仓库里 |
两种情况下,设计都建立在同样几条决定之上:把来源说了什么与得出了什么结论分开,说明每个事实可以信任到什么程度,让机器在不依赖其自身判断的闸门之下完成整理,给智能体一个小而稳定的入口,再给人一个可读的、同一份东西的视图。这个平行关系不是我计划的。它之所以出现,是因为问题是同一个:一个通用模型被丢进一个具体的世界,需要一张它能信任的、关于那个世界的地图。
## 值得照搬的 {#what-to-copy}
如果你想构建自己的那一层,这些是我会保留的决定,按它们的重要程度排列:
- **是路由器,不是仓库。** 指向真正来源的小笔记,以及一个小入口页。
- **每个实体一条笔记,带状态和来源。** 已确认的和推断出的是不同种类的知识;把它们标出来。
- **以 id 作链接,编译成索引和图。** 浏览廉价,遍历廉价,由 linter 检查。
- **一条命令作为唯一接口。** 每个智能体工具都调用它,没有一个知道笔记是怎样存储的。
- **隔离写成代码。** 不能混用的上下文用分开的仓库,再加上拒绝不该外流之物的钩子。
- **少数公理,手工封存。** 其余一切都可以修改。
- **带机械闸门的整理。** 会话记录作为事实依据,受保护的路径,一个 linter,每次运行一次可回滚的提交。
- **同一份笔记的人类视图。** 如果你不能舒服地阅读和更正你的上下文层,它就会离你越来越远。
## 尚未证明的 {#what-is-not-proven-yet}
这是一个能工作的系统,但还很年轻。第一次做梦是手动运行的,只针对一个上下文。此后,定时任务已经在凌晨三点半自行做梦,针对每个上下文,在它的第一周里有四个晚上,而两个智能体工具都从同一条命令开始它们的会话。一周还算不上可靠的记录。Kurumi 镜像最初是对照 Kurumi 的代码,也就是它的解析器、链接解析器和记录读取器来检查的,此后也已经在运行中的应用里试过了。将取代它的链接文件夹库,在一个分支上有单元测试,仅此而已。几个月的夜晚之后,我会写一写它表现如何。
## 模型是租来的 {#the-model-is-rented}
模型会越来越好,而每个人拥有的都是同样的模型。不同的,是每个模型对它所服务的那个人或那家公司知道多少。这种知识不随模型而来,也不必被锁在某个厂商的产品里,而且开始并不难:一个相互链接的笔记文件夹,一条打印出正确页面的命令,以及几道你可以信任的闸门。上下文是把一个通用模型变成你的助手的东西,也是你可以拥有的那一部分。
## 参考资料 {#references}
- Lance Martin, [The components of agent memory](https://www.anthropic.com/research/components-of-agent-memory), Anthropic, 6 November 2026.
- Anthropic, [New in Claude Managed Agents: dreaming, outcomes, and multiagent orchestration](https://claude.com/blog/new-in-claude-managed-agents), 19 May 2026.
- Letta, [Sleep-time Compute](https://www.letta.com/blog/sleep-time-compute), 21 April 2025.
- Kevin Lin, Charlie Snell, Yu Wang, Charles Packer, Sarah Wooders, Ion Stoica, and Joseph E. Gonzalez, *Sleep-time compute: Beyond inference scaling at test-time*, arXiv:2504.13171, 2025, as cited in the Letta post.
- Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G. Patil, Ion Stoica, and Joseph E. Gonzalez, [MemGPT: Towards LLMs as Operating Systems](https://arxiv.org/abs/2310.08560), arXiv:2310.08560, 2023.
- Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein, [Generative Agents: Interactive Simulacra of Human Behavior](https://arxiv.org/abs/2304.03442), arXiv:2304.03442, 2023.
- Simon Willison, [Context engineering](https://simonwillison.net/2025/Jun/27/context-engineering/), simonwillison.net, 27 June 2025, quoting Andrej Karpathy.
- Andy Matuschak, [Evergreen notes](https://notes.andymatuschak.org/Evergreen_notes), Andy's working notes.
- [Kurumi](https://kurumi.raskell.io), a local-first second brain, and its [documentation on AI and the agent](https://github.com/raskell-io/kurumi/blob/main/docs/ai.md).
- Raffael Schneider, [Memory that dreams](https://raskell.io/notes/memory-that-dreams/), [Context Is the Product](https://raskell.io/articles/context-is-the-product/), [Agent Experience](https://raskell.io/articles/agent-experience/), [IT Intelligence](https://raskell.io/articles/it-intelligence/) and [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/).
================================================================================
---
title: "智能体体验:你构建的一切的第三位读者"
url: https://raskell.io/zh/articles/agent-experience/
author: Raffael Schneider
date: 2026-11-24
description: "UX 服务于使用系统的人,DX 服务于构建系统的人。如今智能体两件事都在做,而它们需要猜多少,已经成了一个设计问题。"
tags: [agent-experience, agents, ai-engineering, developer-tooling, context-engineering, legibility, interfaces]
lang: zh-Hans
translation_of: https://raskell.io/articles/agent-experience/
---
# 智能体体验:你构建的一切的第三位读者
## 简而言之
当智能体来写代码,开发者花在语法和模式上的时间变少,花在架构、集成和需求上的时间变多,而智能体所驱动的工具比以前更重要了。 智能体体验(AX)是 Mathias Biilmann 在 2025 年提出的说法,衡量它最好的标准只有一个:一个智能体要在你的系统里做对一件事,需要猜多少。 接口排列在一架可读性阶梯上,从什么都不用猜的编译器和模式,一直到什么都得猜的 HTML 和截图;错误和反馈是所有接口里最重要的那一个。 工具已经变得可以廉价重写,Bun 从 Zig 移植到 Rust、Anthropic 弃用 git 都说明了这一点,所以如今选择一个生态系统,你所承诺的与其说是它的代码,不如说是它的前提。 智能体的上下文经由一条由仓库、协议、图谱和索引组成的供应链到来,它应当得到和其他任何供应链一样的对待:来源、新鲜度、稳定的契约和成本。 标准正在快速到来(AGENTS.md、MCP、Agent Skills、llms.txt),但缺口更大:命令行工具的契约、有保证的副作用、上下文的来源信息、衡量系统的方法,以及指令与数据之间的边界。
看一个编程智能体在一个它从没见过的仓库里工作十分钟,数一数它猜了多少次:哪个命令运行测试,linter 的抱怨是不是致命的,部署工具那两段散文加一个堆栈跟踪到底是什么意思,工单说的是三个都叫 `billing` 的服务里的哪一个,以及 README 是否仍然属实。每一次猜测都花费 token 和时间,有些猜错了,而猜错的那些最后会进到一个拉取请求里。
这些猜测几乎没有一个说明了模型的什么。它们来自智能体被丢进去的那个系统,而其中大多数可以通过设计消除。一个系统对如今承担其大量工作的智能体服务得有多好,已经成为一个独立的设计问题,这篇文章是我描述它的尝试。
## 开发者上移了一层 {#the-developer-moved-up-a-level}
在 [Almost Irrelevant](https://raskell.io/articles/almost-irrelevant/) 里我论证过,一旦智能体写下大部分代码,编程语言的选择就远没有以前那么重要了,因为智能体吸收了学习曲线、繁文缛节和样板代码。同样的转变也改变了开发者整天在想的事情。花在语法、设计模式和怎么写一个循环上的心思少了,更多的心思放在整体的形状上:哪个系统拥有哪些数据,一个改动如何波及旁边的三个系统,需求是什么,以及工作完成时什么必须为真。
没有变的是工具。它比以前更重要了,原因 Jarred Sumner 在 [Bun 加入 Anthropic](https://bun.com/blog/bun-joins-anthropic) 时说得很好:「如果大部分新代码将由 AI 智能体来编写、测试和部署:围绕这些代码的运行时和工具就变得重要得多。」他写道,人类「与每一行代码都更疏离了,所以代码运行的环境必须快速且可预测」。智能体一天把同一个命令运行上千次,并且按字面理解每一次输出,所以开发者早已学会忽略的那些怪癖,现在每运行一次都要付出代价。
## 三种读者 {#three-readers}
如今每个系统都有三种读者:
| | 用户体验(UX) | 开发者体验(DX) | 智能体体验(AX) |
|---|---|---|---|
| 是谁 | 使用系统的人 | 在系统之上或之中构建的人 | 做这两件事之一的智能体 |
| 读什么 | 界面、文字、流程 | 文档、API、错误、工具 | 一切,按字面,每一次 |
| 记得什么 | 习惯,跨越多年 | 团队口口相传的知识 | 会话之间什么都不记得,除非写了下来 |
| 向谁求助 | 客服、同事 | 同事、论坛 | 没有人;它去猜 |
| 困惑的代价 | 失去一个客户 | 损失一个下午 | 一个错误的改动,以机器的速度重复 |
第三种的名字来自 Netlify 的首席执行官 Mathias Biilmann,他在 2025 年 1 月的 [Introducing AX: Why Agent Experience Matters](https://biilmann.blog/articles/introducing-ax) 中提出了它,定义为「AI 智能体作为一个产品或平台的用户所获得的整体体验」。其他人很快接过了这个说法。一个月后,Resend 的 Zeno Rocha 在 [What is AX](https://resend.com/blog/agent-experience) 中写道:「智能体应当能在几毫秒内就上手运行。」这个术语诞生时,是一个关于卖给开发者的产品的问题:一个智能体能不能注册、读文档并完成部署,而不需要一个人去点完一张表单?
我用得更宽泛。智能体体验是每一个代码库、每一个内部工具、两个团队之间的每一个 API、一家公司保存的每一套知识的属性,因为智能体如今在所有这些地方工作,而不只是在一个产品的大门口。我还用一个更窄的定义,因为它更容易付诸行动:**智能体体验,就是一个智能体要在你的系统里做对一件事,需要猜多少**。一个好的系统留给它猜的很少,并且让剩下的猜测检查起来很便宜。
## 猜测从哪里来 {#where-the-guesses-come-from}
第一份有分量的证据表明,决定智能体能做什么的是接口,而不只是模型,它来自 2024 年的 SWE-agent 论文([Yang et al.](https://arxiv.org/abs/2405.15793))。这篇论文提出了智能体-计算机接口的概念,并给出了一个经得起时间检验的论点:「语言模型智能体代表了一类新的终端用户,有它们自己的需求和能力。」它的消融实验值得仔细读,因为每一处改动都在接口上,没有一处在模型上:
| 对接口的改动(SWE-bench Lite) | 解决率 |
|---|---|
| 完整的接口:一个带 linter 的编辑器,会拒绝有问题的编辑,摘要式的搜索,一个每次显示 100 行的文件查看器 | 18.0% |
| 同样的编辑器,去掉 linter 这道护栏 | 15.0% |
| 搜索结果逐页返回,而不是给出摘要 | 12.0% |
| 显示整个文件,而不是每次 100 行 | 12.7% |
| 完全没有编辑命令 | 10.3% |
让智能体看到更多的文件内容,结果反而更差;让它翻阅搜索结果,比完全不给搜索还差,后者得分 15.7%。有帮助的是更少的信息,以可预测的形状给出。Anthropic 在自己的智能体上得出了同样的教训:在 [Building effective agents](https://www.anthropic.com/engineering/building-effective-agents) 里,团队写道,对于他们的编程智能体,他们「花在优化工具上的时间比花在整体提示词上的还多」,并给出建议:「通过详尽的工具文档和测试,精心打造你的智能体-计算机接口(ACI)。」他们的建议有一个借自制造业的名字:「给你的工具做防错(poka-yoke)」,也就是改造它们,让错误一开始就很难犯。
在我自己的工作里,猜测来自一份很短的清单,而几乎所有这些地方一直都在;人们通过问同事把它们消化掉了。
- **会变形的输出**。一个为人打印表格的工具,带颜色和进度条,却没有稳定的机器格式。
- **用散文写的错误**。一条写给匆忙之中的人的消息,智能体得去解读它,而且它的措辞在版本之间会变。
- **存在于脑子里的约定**。团队怎么给分支命名,哪些测试不稳定,哪个目录已经废弃。
- **互相矛盾的名字**。同一个应用,在仓库里叫一个名字,在集群里叫另一个,在事故工具里又叫第三个。
- **漂移了的文档**。一份两年前属实的 README,没有任何东西说明这一点。
- **没有来源的知识**。一个答案,没有办法知道它从哪里来、有多旧。
## 可读性阶梯 {#the-legibility-ladder}
并非所有接口留下的猜测都一样多。我发现把它们排个序很有用,从什么都不用猜的,到几乎什么都得猜的:
| 级 | 接口 | 智能体仍然要猜什么 |
|---|---|---|
| 1 | 编译器或类型检查器 | 几乎什么都不用:答案是「是」,或者确切地指出哪里不行、为什么 |
| 2 | 带公开模式的结构化输出(JSON Schema、OpenAPI、RFC 9457 错误) | 下一步做什么,而不是发生了什么 |
| 3 | 有稳定参数、退出码和 `--json` 模式的 CLI | 没有文档说明的字段是什么意思 |
| 4 | 智能体可以获取的 Markdown 文档(`llms.txt`、`.md` 副本) | 它是否仍然有效,以及它与代码如何对应 |
| 5 | HTML 页面 | 在导航和脚本之间,内容在哪里 |
| 6 | 图形界面 | 几乎一切 |
改善智能体体验,主要就是把东西沿着这架阶梯往上挪的工作。Cloudflare 的数字说明了往上走一级值多少:当 [Markdown for Agents](https://blog.cloudflare.com/markdown-for-agents/) 向请求 Markdown 的客户端以 Markdown 提供页面时,他们的一篇博客文章从 16,180 个 token 降到了 3,150 个,用他们的话说:「把原始 HTML 喂给 AI,就像按字付费去读包装,而不是读里面的信。」Anthropic 的长时间运行智能体把功能清单保存在 JSON 而不是 Markdown 里,因为「模型不太可能不恰当地修改或覆盖 JSON 文件」([Effective harnesses for long-running agents](https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents))。所处的那一级,决定了智能体的注意力有多少用在工作上,有多少用在弄清楚自己在看什么上。
同一个命令可以处在两个不同的级上。这是一个为人编写的部署工具:
```text
⠋ Deploying claims-api to prod...
✗ Something went wrong. The rollout could not be completed because one or more
replicas failed their readiness checks. Check the dashboard for details.
```
而这是同一次失败,为每一种读者编写:
```text
$ deployctl rollout claims-api --env prod --json
{"status":"failed","stage":"readiness","service":"claims-api","env":"prod",
"replicas":{"ready":1,"wanted":3},"probe":"/healthz","last_status":503,
"logs":"deployctl logs claims-api --env prod --since 10m","exit_code":3}
```
第一个要求智能体去猜,然后把它打发到一个它看不见的仪表盘。第二个说明了什么失败了、差了多少、下一步去哪里看,以及根据哪个退出码分支,而人读它也一样清楚。
## 错误信息就是 API {#the-error-message-is-the-api}
一个系统里最值得为智能体用心的部分,是它的反馈:错误、警告、测试输出、评审意见。智能体大部分时间都处在一个循环里,尝试一件事,然后读返回了什么,所以返回的东西就是它用得最多的接口。
我所知道的最清楚的示范,是 Bun 的重写。Bun 原本用 Zig 写成,2026 年 5 月,Jarred Sumner [用 Rust 重写了它](https://bun.com/blog/bun-in-rust),「在 Claude Code 中使用了大约 50 个动态工作流,在 11 天里持续运行」。智能体先机械地移植了每一个文件,然后一个工作流把编译器的错误当作工作队列来处理,一个 crate 接一个 crate,起点大约是一万六千个错误。他对这为什么行得通的总结是:「编译器错误是比风格指南更好的反馈循环。」编译器错误指向一行代码,无可争辩,问题修好了它就消失,所以智能体可以在无人监督的情况下处理成千上万个,而风格指南没有人能这么说。
Nicholas Carlini 从另一边走到了同一个地方,当时他让十六个智能体[构建一个 C 编译器](https://www.anthropic.com/engineering/building-c-compiler):「我必须不断提醒自己,我是在为 Claude 而不是为自己编写这个测试框架」。他的规则很具体:「测试框架不应该打印成千上万字节的无用信息」,它应该只打印几行,其余的记录到文件里,而错误应该很容易用搜索找到。Cloudflare 把这一点用到了 Web 本身,向智能体返回 [RFC 9457 问题详情](https://blog.cloudflare.com/rfc-9457-agent-error-pages/),而不是那些「给智能体线索,而不是指令」的错误页面,并把原则浓缩成一句话:「核心价值不在于格式的选择,而在于语义的稳定。」
一个具有语义稳定性的错误看起来是这样的,而且它在每个版本里的意思都一样:
```json
{
"type": "https://errors.example.com/quota-exceeded",
"title": "Quota exceeded",
"status": 429,
"detail": "Project claims-api has used 1000 of 1000 builds this month.",
"retry_after": "2026-12-01T00:00:00Z",
"fix": "Raise the quota with: deployctl quota set claims-api --builds 2000"
}
```
Anthropic 给工具作者的建议直截了当地说了同样的事:「对你的错误响应做提示词工程,清楚地传达具体且可操作的改进」([Writing effective tools for agents](https://www.anthropic.com/engineering/writing-tools-for-agents))。对智能体来说,错误信息是 API 的一部分,它需要 API 的其余部分所得到的东西:版本、文档和测试。
## 当工具可以随手丢弃,前提依然存在 {#when-tooling-is-disposable-premises-remain}
工具过去替换起来很昂贵,所以我们与它们的缺陷共处了几十年。智能体让替换变得足够便宜,成了一个真正的选项,而我认为其后果还没有被充分认识到。
据 [The Register](https://www.theregister.com/devops/2026/07/14/zig-creator-calls-buns-claude-rust-rewrite-unreviewed-slop/5270743) 报道,Bun 的重写花费了「按 API 价格计算大约 165,000 美元」,而这个运行时第一次写成用了好几年。它在 8 月 20 日作为 [Bun 1.4](https://bun.com/blog/bun-v1.4) 发布。动机很实际:让团队疲于奔命的缺陷是内存缺陷,释放后使用和重复释放,正是换一门语言就能排除的那一类。它也有争议。Zig 的创造者在同一篇报道里称之为「未经评审的垃圾」,而十一天的智能体工作是否和多年的人工工作一样可靠,是一个公允的问题,只有在生产环境中经受时间才能回答。但重写确实发生了,代价是一家公司可以选择承担的,单是这一点就改变了算法。
Anthropic 在自己的工具上走得更远。10 月,它描述了[重新设计源代码管理](https://www.anthropic.com/research/redesigning-source-control):「如今的瓶颈,是所有为人类规模而建的开发者基础设施:源代码管理、构建和 CI。」每天合并的改动从 2026 年 5 月的大约 2,500 个增长到 9 月的超过 30,000 个,于是团队构建了自己的版本控制系统 Scion,并在五个月内把单一仓库迁离了 git。Git 假定客户端离线工作,并持有仓库的完整副本。「由于我们几乎所有的客户端都是智能体和作业」,团队为始终在线的客户端设计了 Scion。一个前提变了,一个服务了整个行业二十年的工具就不再合适。
我把这称为重写门槛:重写一个工具的代价低于与它的前提共处的那个临界点。智能体把这个门槛大幅压低了,由此引出两件事。
第一,实现变得没那么重要,前提变得更重要。当一个工具的代码可以在几周内重新生成,你选择一个生态系统时所承诺的就是它的设计前提:它的内存模型,它的兼容性承诺,它的输出是否确定,它的模块如何命名和查找,它的错误保证什么。智能体每天面对的正是这些,在重写之后幸存下来的也正是这些。Bun 重写的拉取请求承诺「同样的架构,同样的数据结构。」([#30412](https://github.com/oven-sh/bun/pull/30412));改变的是关于由谁来释放内存的那个前提。
第二,智能体体验成了重写的理由。一个错误用散文写、输出不稳定的工具,过去只是令人烦恼。现在它是每个智能体每次运行都要缴纳的一笔税,到了某个时候,花钱换一个更好的工具,比缴这笔税更便宜。
## 上下文供应链 {#the-context-supply-chain}
智能体体验的另一半,是智能体从哪里得到它所知道的东西。我在 [Context Is the Product](https://raskell.io/articles/context-is-the-product/) 里写过智能体所依赖的几类上下文,在 [Retrieval Is a Tool, Not a Layer](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/) 里写过为什么检索应该是一个工具。从智能体这一侧看,它的表现就像一条供应链:
*The context supply chain*
```text
sources channels the agent
───────────────── ─────────────────────── ──────────────
repository ──▶ AGENTS.md, docs/, code ──┐
systems of record ──▶ APIs, MCP servers ──┤
company knowledge ──▶ graphs, ontologies ──┼──▶ context window
documents ──▶ embeddings, search ──┤ (finite, costly)
people ──▶ reviews, approvals ──┘
│
every link carries: provenance · freshness · a stable contract · a cost in tokens
```
这条链上的每一环,都具有任何供应链都有的四个属性。**来源**:智能体能否知道一个事实从哪里来,一个人事后能否核查它?**新鲜度**:这个事实是否带有日期,还是智能体只能假设?**稳定的契约**:这个渠道在版本之间是否保持形状,还是每一次改动都会让下游的智能体出错?**成本**:把这个事实放进窗口要花多少 token?Anthropic 关于上下文工程的指南正是这样看待窗口的:「因此,上下文必须被当作一种边际收益递减的有限资源」([Effective context engineering](https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents)),而把 MCP 服务器作为智能体可以调用的代码呈现给它,而不是一长串工具,让他们的一个工作流「从 150,000 个 token 降到了 2,000 个」([Code execution with MCP](https://www.anthropic.com/engineering/code-execution-with-mcp))。
渠道正在标准化,对任何在其上构建的人来说这都是好消息。2025 年 12 月,Linux 基金会围绕三个捐赠的项目成立了 [Agentic AI Foundation](https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation):来自 Anthropic 的 Model Context Protocol,来自 Block 的 goose,以及来自 OpenAI 的 AGENTS.md。一个用于仓库的约定,一个用于系统的协议,一个参考智能体,置于中立的治理之下,这是这条供应链共享基础设施的开端。
没有任何标准能提供的是内容,而大多数公司的智能体体验恰恰在这里最糟糕。在一家公司内部,智能体最常问的问题是:「这个归谁负责,什么依赖它,它还在用吗?」而在大多数组织里,答案散落在六个互相矛盾的工具里。这正是 [IT Intelligence](https://raskell.io/articles/it-intelligence/) 所讨论的问题,也是[参考实现](https://raskell.io/articles/building-it-intelligence/)通过一个 MCP 服务器来回答、给出小而以实体为中心且始终附带来源的答案的原因。一个智能体可以查询的知识层,每个事实都附有出处,这就是组织本身的智能体体验。
## 目前的标准 {#the-standards-so-far}
对一个两年前还没有名字的领域来说,智能体体验已经有了相当多的共同基础。截至 2026 年 11 月,它看起来是这样的:
| 关注点 | 现有的东西 | 起始 | 背后是谁 |
|---|---|---|---|
| 仓库中给智能体的指令 | [AGENTS.md](https://agents.md/) | 2025 年 | OpenAI,现属 Agentic AI Foundation |
| 向模型说明一个网站 | [llms.txt](https://llmstxt.org/) | 2024 年 9 月 | Answer.AI,一份提案 |
| 把智能体连接到工具和数据 | [Model Context Protocol](https://modelcontextprotocol.io/),当前修订版 2026-07-28 | 2024 年 11 月 | Anthropic,现属 Agentic AI Foundation |
| 打包的专业知识和工作流 | [Agent Skills](https://www.anthropic.com/news/donating-agent-skills-to-the-agentic-ai-foundation) | 2025 年 10 月 | Anthropic,2026 年 10 月捐赠给 Agentic AI Foundation |
| HTTP API 的错误 | [RFC 9457](https://www.rfc-editor.org/rfc/rfc9457) 问题详情 | 2023 年 | IETF |
| 分析工具和编译器的发现 | [SARIF 2.1.0](https://docs.oasis-open.org/sarif/sarif/v2.1.0/sarif-v2.1.0.html),以及编译器格式,比如 GCC 的 SARIF 输出和 [rustc 的 JSON](https://doc.rust-lang.org/rustc/json.html) | 2020 年 | OASIS |
| 按需以 Markdown 提供页面 | `Accept: text/markdown` | 2026 年 | Cloudflare,出于实践 |
| 服务及其负责人的目录 | Backstage 的 [catalog-info.yaml](https://backstage.io/docs/features/software-catalog/descriptor-format) | 2020 年 | 事实上的约定 |
| 一个事实从哪里来 | [PROV-O](https://www.w3.org/TR/prov-o/) | 2013 年 | W3C |
有两点很突出。最新的条目是智能体每天都在用的,它们来自模型厂商,并很快转入了中立治理;按 Anthropic 的统计,自 2025 年 12 月这个标准发布以来,仅 Agent Skills 一项就有超过 70 个智能体平台接入。较早的条目来自标准组织,很好地解决了问题的一部分,但它们是为别的读者写的:SARIF 为代码扫描器,PROV-O 为语义网,Backstage 为开发者门户。还没有人为智能体把它们连接起来。
## 还缺什么 {#what-is-still-missing}
我预计未来几年的大部分工作、大部分有意思的想法,都会出现在这些缺口里。下面是我一再碰到的几个,每一个都附上了今天最接近的东西:
| 缺口 | 今天最接近的东西 | 它缺少什么 |
|---|---|---|
| 命令行工具的契约 | HTTP 有 RFC 9457,分析器有 SARIF | 智能体每天运行的成千上万个 CLI 之间的任何共同之处 |
| 可以信赖的副作用 | MCP 工具注解 | 保证:它们只是提示 |
| 上下文的来源和新鲜度 | PROV-O,几个产品约定 | 智能体读取的渠道里的一个字段 |
| 衡量智能体体验的方法 | SWE-bench 之类的模型基准测试 | 改变系统、固定智能体的基准测试 |
| 组织上下文 | Backstage 目录 | 今天什么是真实的,不止团队声明了什么 |
| 面向智能体的文本的变更管理 | API 版本管理 | 工具描述、指令和错误含义的版本与变更日志 |
| 指令与数据之间的边界 | 没有通用的做法 | 一种标记上下文中哪些内容可以服从的方式 |
| 持久的人工交接 | MCP 引导(elicitation) | 可以等上几天、有名字有记录的审批 |
**命令行工具的契约**。智能体一生中有很大一部分时间在 shell 里度过,而 shell 根本没有共享的契约。每个工具都自创机器模式(如果有的话)、自己的退出码和自己的错误措辞。RFC 9457 为 HTTP 解决了这个问题,SARIF 为静态分析解决了它;命令行需要同样的东西:一个用于机器输出的标准参数,每个错误都有带稳定类型的问题详情,下一步操作作为一个字段,以及含义有文档说明的退出码。这是不起眼的工作,而我怀疑它为智能体节省的时间,会比下一次模型发布还多。
**可以信赖的副作用**。在智能体运行某个东西之前,它需要知道这个操作是读还是写,能否安全地重复,能否撤销,是否会触及系统之外。MCP 恰好有用于这些的字段,`readOnlyHint`、`destructiveHint`、`idempotentHint` 和 `openWorldHint`,而规范对它们很坦诚:「ToolAnnotations 中的所有属性都是提示。它们不保证忠实地描述工具的行为」([schema](https://modelcontextprotocol.io/specification/2026-07-28/schema)),客户端「必须(MUST)将工具注解视为不可信的,除非它们来自可信的服务器」([tools](https://modelcontextprotocol.io/specification/2026-07-28/server/tools))。这种谨慎是对的,而缺口依然敞开着。缺少的是一种有东西去检查的副作用声明:一个强制只读的沙箱,或者一个标准的试运行,返回一份会改变什么的计划,就像基础设施工具在应用之前先展示一份计划那样。
**上下文的来源和新鲜度**。一个 `AGENTS.md` 没有负责人,也没有日期。一个 `llms.txt` 不说明它最后一次属实是什么时候。一个工具结果没有通用的字段说明它的事实从哪里来。语义网很久以前就在 PROV-O 里解决了来源问题,但智能体读取的渠道没有一个带着它。在它们带上之前,智能体分不清一个今天早上核查过的事实和一个三次重组之前写下的事实,评审它工作的人也分不清。我希望智能体收到的每一个事实都带有三样东西:一个来源,一个截至日期,一个负责人。这就是我在[参考实现](https://raskell.io/articles/building-it-intelligence/)里内置的东西,而它本不应该需要一个定制的平台。
**衡量智能体体验的方法**。我们有的每一个基准测试都固定环境、改变模型。智能体体验需要的恰恰相反:固定智能体,改变系统。谁也无法用别人认可的方式说明,一个仓库、API 或内部平台比另一个对智能体更友好,所以改进无法比较,甚至无法宣称。下面的冷启动测试是我的权宜之计。一个真正的方法,会是一套公开的任务,由一个固定的智能体在一个系统上运行,并且在任何地方都用同样的方式计数猜测。
**组织上下文**。Backstage 让在代码旁边用一个文件描述服务成为常态,这是真正的一步。但目录记录的是团队声明了什么,而智能体需要的是什么是真实的:在实践中谁负责这个命名空间,哪个应用还在调用旧的 API,哪条记录已经过时。对于一个带有置信度和证据的归属与依赖图谱,没有任何标准,每家想要它的公司都得独自构建。这正是 [IT Intelligence](https://raskell.io/articles/it-intelligence/) 所讨论的缺口。
**面向智能体的文本的变更管理**。我们给 API 打版本,因为它们一变,客户端就会出错。智能体也是客户端,但它们依赖的文本在悄无声息地变化:一个工具描述被改写,一个指令文件被重新组织,一条错误信息多了一句话。每一处这样的变化都会改变智能体的行为,而没有人看见出错,因为没有测试失败。更糟的是,工具描述本身就是给模型的指令,所以改动它会以代码评审者永远不会去留意的方式改变行为。面向智能体的文本需要 API 表面所拥有的东西:版本、变更日志,以及一份有人评审的差异。
**指令与数据之间的边界**。智能体上下文里的一切看起来都一样:用户的请求,仓库的约定,它获取的一个网页,一个陌生人写的议题评论。其中哪些可以服从、哪些只能阅读,一概不加标记,而这正是提示词注入的根源。更好的模型降低了风险,沙箱限制了损害,正如我在 [Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/) 里写的,但缺失的那一块是一种约定,贯穿每一个渠道,说明权威从哪里来。
**持久的人工交接**。MCP 的引导(elicitation)让服务器可以在会话中途向用户询问信息,这覆盖了快速提问的情形。更难的情形是必须等待的审批:一个需要第二个人点头的改动,而这个人休假到周四,事后还要有一份记录说明是谁同意的。这种交接至今仍缺一个标准。这正是带有人工等待的持久化执行引擎(比如 [Aqueduct](https://github.com/raskell-io/aqueduct))存在的原因,而我预计这种交接会成为一个独立的协议。
这些缺口没有一个需要突破,只需要几个人就某件乏味的事情达成一致,Web 就是这样得到 HTTP 状态码的,命令行也是这样得到 `--help` 的。这一次的不同在于速度:谁先把约定写下来,并让它易于采用,谁就会在很长时间里定义智能体的工作方式。
## 衡量它 {#measuring-it}
智能体体验可以衡量,而且衡量的成本很低。我用的是我称为冷启动测试的方法:
1. 在系统里挑一个真实的任务,就是新同事在第一周会接到的那种。
2. 把它交给一个全新的智能体,不给额外指令,没有记忆,没有帮助。
3. 让它去做,并保留完整记录。
4. 从记录中数出四样东西:
| 指标 | 它告诉你什么 |
|---|---|
| 猜测:尝试过的命令、打开过的文件或陈述过的假设,最后证明是错的 | 系统留下多少需要猜的东西 |
| 到第一次构建成功或测试通过为止的轮数 | 反馈循环有多快 |
| 第一次正确改动之前花掉的 token | 获取上下文有多昂贵 |
| 需要人介入的次数 | 知识还在哪些地方只存在于脑子里 |
每做一次旨在改善的改动,就再运行一次。数字会有噪声,因为智能体本身就有噪声,但记录不会:每一次猜错都指向一个具体的缺口,而大多数缺口一个下午就能补上。每一个没补上的缺口,都是我所说的智能体体验债务,和任何债务一样,它会利滚利,因为每个智能体在每次运行时都要再付一遍。
## 该怎么做 {#what-to-do-about-it}
对构建软件的人和运行软件的人来说,清单很短,而且没有一样是稀奇的。
- **把约定写在智能体会找到的地方**。根目录下一个 `AGENTS.md`,指向一个始终保持属实的 `docs/` 目录,胜过人们脑子里再多的知识。
- **给每个工具一种机器形式**。稳定的参数,有意义的退出码,一个 `--json` 模式,以及默认简短、细节写进日志文件的输出。
- **把错误当作 API 对待**。给它们稳定的类型,说明下一步做什么,并在版本之间保持它们的含义。
- **把检查放在评审之前**。类型、模式、linter 和测试在一个人需要去看之前,就把猜测变成了答案。
- **把你的知识作为带来源的数据发布**。归属、依赖和状态应该放在智能体可以查询的地方,每个事实都附有出处。
- **按前提选择生态系统**。兼容性承诺、确定性和一个会解释自己的编译器,如今比库目录的大小更有价值,因为目录可以重新生成,前提不能。
- **运行冷启动测试**。不是一次,而是每个季度一次,就像你运行负载测试那样。
我听到最多的反对意见是,这一切是换了个新名字的良好开发者体验。其中很多确实如此,而我认为这令人鼓舞:一个智能体体验好的系统,几乎总是对人也更好。区别在于宽容度。人在文档出错时会问同事,学一次就记住团队的习惯,而智能体会去猜,并且除非习惯被写下来,它在每次会话里都从零开始。一个误读了错误的人损失一个下午;智能体在每次运行时都误读它,并行地,比任何评审都跟得上的速度还快。
## 第三位读者 {#the-third-reader}
三十年来,我们为使用系统的人设计,十五年来,为构建系统的人设计。如今智能体承担了这两份工作中的很大一部分,而它们是最没有能力绕过我们留下的模糊之处的读者,这让它们成了我们所拥有的、关于什么仍需修复的最诚实的向导。
## 参考资料 {#references}
- Mathias Biilmann,[Introducing AX: Why Agent Experience Matters](https://biilmann.blog/articles/introducing-ax),2025 年 1 月 28 日。
- Zeno Rocha,[What is AX (Agent Experience) and how to improve it](https://resend.com/blog/agent-experience),Resend,2025 年 2 月。
- John Yang、Carlos E. Jimenez、Alexander Wettig、Kilian Lieret、Shunyu Yao、Karthik Narasimhan 和 Ofir Press,[SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering](https://arxiv.org/abs/2405.15793),2024。
- Erik S. 和 Barry Zhang,[Building effective agents](https://www.anthropic.com/engineering/building-effective-agents),Anthropic,2024 年 12 月 19 日。
- Ken Aizawa,[Writing effective tools for agents, with agents](https://www.anthropic.com/engineering/writing-tools-for-agents),Anthropic,2025 年 9 月 11 日。
- Anthropic,[Effective context engineering for AI agents](https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents),2025 年 9 月 29 日。
- Adam Jones 和 Conor Kelly,[Code execution with MCP: Building more efficient agents](https://www.anthropic.com/engineering/code-execution-with-mcp),Anthropic,2025 年 11 月 4 日。
- Justin Young,[Effective harnesses for long-running agents](https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents),Anthropic,2025 年 11 月 26 日。
- Jarred Sumner,[Bun is joining Anthropic](https://bun.com/blog/bun-joins-anthropic),2025 年 12 月 2 日,以及 [Rewriting Bun in Rust](https://bun.com/blog/bun-in-rust),2026 年 7 月 8 日;拉取请求 [Rewrite Bun in Rust](https://github.com/oven-sh/bun/pull/30412);[Bun 1.4](https://bun.com/blog/bun-v1.4)。
- [Zig creator calls Bun's Claude Rust rewrite "unreviewed slop"](https://www.theregister.com/devops/2026/07/14/zig-creator-calls-buns-claude-rust-rewrite-unreviewed-slop/5270743),The Register,2026 年 7 月 14 日。
- Linux Foundation,[Linux Foundation Announces the Formation of the Agentic AI Foundation](https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation),2025 年 12 月 9 日。
- Nicholas Carlini,[Building a C compiler with parallel Claudes](https://www.anthropic.com/engineering/building-c-compiler),Anthropic,2026 年 2 月 5 日。
- Celso Martinho 和 Will Allen,[Introducing Markdown for Agents](https://blog.cloudflare.com/markdown-for-agents/),Cloudflare,2026 年 2 月 12 日。
- Cloudflare,[Slashing agent token costs by 98% with RFC 9457-compliant error responses](https://blog.cloudflare.com/rfc-9457-agent-error-pages/),2026 年 3 月 11 日。
- Anthropic,[Redesigning source control at Anthropic](https://www.anthropic.com/research/redesigning-source-control),2026 年 10 月 13 日。
- [RFC 9457: Problem Details for HTTP APIs](https://www.rfc-editor.org/rfc/rfc9457),2023。
- Jeremy Howard,[/llms.txt: a proposal to provide information to help LLMs use websites](https://www.answer.ai/posts/2024-09-03-llmstxt.html),Answer.AI,2024 年 9 月 3 日,以及 [AGENTS.md](https://agents.md/)。
================================================================================
---
title: "约束在移动:Agentic Engineering Days Zurich 的一天"
url: https://raskell.io/zh/articles/agentic-engineering-days-zurich-2026/
author: Raffael Schneider
date: 2026-11-20
description: "Agentic Engineering Days Zurich 2026 的七场演讲,以及贯穿其中的主线:智能体不会消除约束,只会把它移到别处。"
tags: [agents, agent-harness, agent-protocols, data-fusion, multiplayer-work, switzerland]
lang: zh-Hans
translation_of: https://raskell.io/articles/agentic-engineering-days-zurich-2026/
---
# 约束在移动:Agentic Engineering Days Zurich 的一天
## 简而言之
Agentic Engineering Days Zurich 2026 是在苏黎世火车总站旁一家酒店里举办的一天,门票售罄,40 场分会从 344 份投稿中选出,而其中最好的部分是人。 Pini Reznik 的摘要给了我看这一天的视角:AI 不会消除约束,只会移动它。我看过的每一场演讲,都是在回答约束应该去往何处。 Exasol 主张把数据融合移进数据库,这样智能体就不必在每次调用时背负集成的负担。这是一场赞助演讲,也是我会最先去测试的一场。 协议那场演讲说,能消除最多不确定性的最简单协议会胜出;NVIDIA 的 NOOA 把智能体重新变回带类型的软件,这让我想要一个编译器来检查这些类型。 GitHub Next 展示了约束落在团队对齐上,这指向一种工作方式:人与智能体共享的对话,决策就存在于对话之中。
周五我和几位同事在 [Agentic Engineering Days Zurich](https://www.agenticdays.com/) 度过了一天。会议在苏黎世火车总站旁的 Marriott 举办,为期一天,由 [letsboot.ch](https://www.letsboot.ch/) 组织,五个会场共 40 场分会,从 344 份投稿中选出,门票售罄。明年它会换到更大的场地,办两天,这多少说明了这一年是怎么过的。
Jonas 和 Barbara Felix 以及他们的团队组织了这一切,作为第一届,几乎无可挑剔:会场准时,演讲准时,食物很好,apéro 也足够长,长到能容下演讲引出的那些对话。谢谢你们两位。
 开幕前半小时,苏黎世火车总站旁 Marriott 的大堂。我记得的大部分对话都发生在这里,而不是在会场里。
有些演讲者是几年前瑞士云原生圈子里的人,如今在做下一件事。那些分会不是我来的目的。我来是为了那些构建我们其他人所用部件的人,而议程里有他们:NVIDIA、GitHub、Red Hat 和 IBM、Google,还有一位来自 Exasol 的数据库创始人。我看了七场演讲,遇到的有趣的人比我预想的多,回家时带着一句我一直放不下的话。
## 约束在移动 {#the-constraint-moves}
这句话出自 Pini Reznik,他联合创办了 Container Solutions,为 O'Reilly 写了 [Cloud Native Transformation](https://www.oreilly.com/pub/au/7845),现在经营 re:cinq。他为“From Copilot to the Dark Factory”写的摘要描述了一家公司给所有人买了编程助手之后会发生什么:个人变快了,但“PR 数量上升,评审队列变长,测试变弱,上下文、安全和平台方面的瓶颈逐渐显现。”然后是那句话:“AI 不会消除约束;它只是移动约束。”(“AI does not remove the constraint; it moves it.”)
读过 Goldratt 的人会认出这个形状,而我自己一周前也在 [Every layer moves the uncertainty](https://raskell.io/notes/every-layer-moves-the-uncertainty/) 里写过它的一个版本。周五让它变得有用的是,它把一份互不相关的议程变成了一个问题。编程助手把约束从打字移到评审。一个能访问五个系统的智能体,把约束从集成层移进了智能体本身。所以对每一场演讲,我都问约束去了哪里,以及那是不是一个好地方。
Reznik 自己的演讲把这种移动画成了一张图,“Who Builds Software with AI?”,一条轴是复杂度,另一条轴是一个系统需要的开发者人数。Excel 宏和简单脚本靠近原点,然后是一到五名开发者的功能型工具,五十到一百名开发者的市场平台,比如 Booking.com 和 HubSpot,再是一千名以上开发者的超大系统,比如 Google Search 和 AWS。再往后,轴上写着“Impossible”(不可能),例子是气候模拟器、城市数字孪生和个性化医疗。他的红色箭头把每一档都向左移了一步:非开发者变成公民开发者,五个人的团队能造出过去需要一百人的东西,轴的最远端也不再是不可能。如果这大致正确,稀缺的就不再是会写代码的人,而是代码周围一切单个团队无法独自完成的事情,他的结束幻灯片说了该怎么做:“找到约束。构建能力。重复。”(“Find the constraint. Build the capability. Repeat.”)完整版本是他和 Michael Müller 合写的一本书,[From Cloud Native to AI Native](https://re-cinq.com/whitepapers),re:cinq 免费提供。
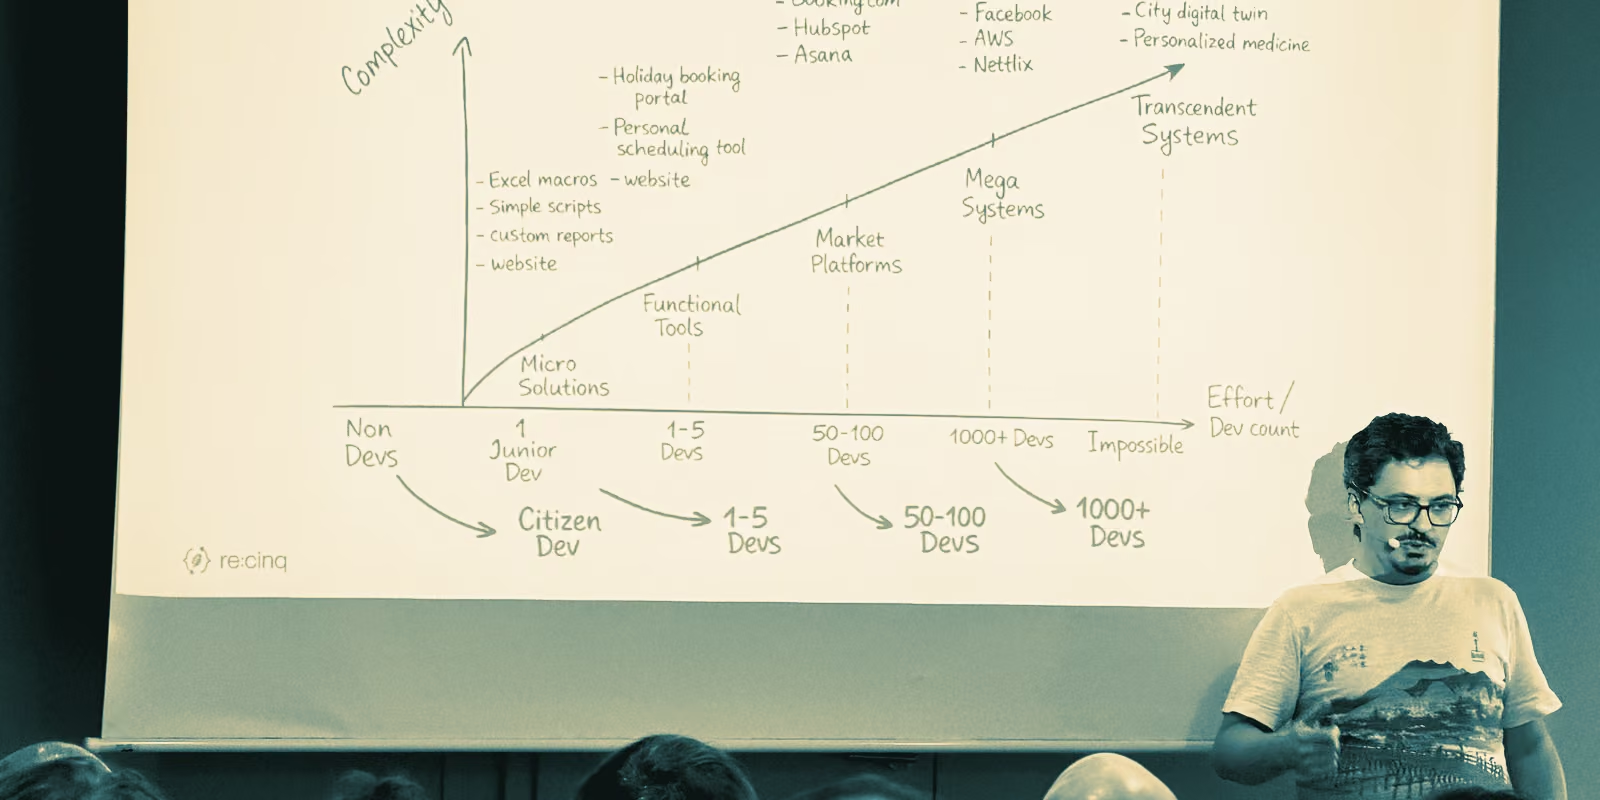 re:cinq 的 Pini Reznik 站在他的图表“Who Builds Software with AI?”前:每一档复杂度都向左移了一步,“Impossible”不再是轴的尽头。
| 演讲 | 约束去了哪里 |
|---|---|
| Wrike,生产环境中的 SRE 智能体 | 进入上下文,而没有人测试上下文 |
| Exasol,Beyond MCP | 离开智能体,进入数据库 |
| Red Hat 和 IBM,Agents Speak Protocol | 离开每一个集成,进入每个边界上的契约 |
| NVIDIA,NOOA | 离开提示词,回到普通的带类型软件 |
| GitHub Next,协作环境 | 从写代码转到就写什么达成一致 |
| Typeform,When Software Stops Being Deterministic | 从测试套件转到评估和追踪 |
| re:cinq,From Copilot to the Dark Factory | 从写代码的人转到写规格和检查的人 |
## 智能体成为集成层 {#the-agent-as-the-integration-layer}
我的上午从 Wrike 的 David Pech 和一个已在生产环境运行数月的 SRE 智能体开始。他的摘要把大多数这类智能体描述为“勉强算是初级系统管理员,裹着一件风衣”,他列出的教训与模型无关:框架没有预想的那么重要,误导性的文档误导了智能体,而没有人测试的上下文会在一个版本到下一个版本之间悄悄退化。我猜标题就是智能体自身指令里的一句话,而每一个构建这类智能体的团队最后都会写下它。
一小时后,Alexander Stigsen 把同一个问题往下推了一层。Stigsen 创办了 [Realm](https://en.wikipedia.org/wiki/Realm_(database)),也就是 MongoDB 在 2019 年收购的那个移动数据库,现在是 [Exasol](https://www.exasol.com/) 的首席产品与技术官,Exasol 是来自纽伦堡的内存分析数据库。他的演讲“Beyond MCP”是一个赞助时段,也是一场产品推介,我先把这一点说在前面,因为它同时也是我见过的对我所研究问题最清晰的诊断。
给智能体每个系统配一个 MCP 服务器,CRM、计费、客服,智能体就成了你的集成层。它要为上下文里的每一个工具 schema 和每一份原始结果付费,每个数据源一次往返,在没有查询规划器的情况下连接数据,跨数据源什么都不缓存,并且在每次调用时都要调和同一个客户的三种拼写。他的幻灯片列出了七项成本,并用一句话总结:“智能体背负着集成的负担。”(“The agent carries the integration burden.”)摘要还补充了一条排除了显而易见解决办法的约束:“受监管的组织无法把所有数据复制到一个 AI 平台里。”
他的答案是在一个联邦数据库之上提供一个 MCP 接口,在数据所在之处查询数据,并用一个语义层把每个数据源的词汇映射到共享的业务概念上。CRM 里的 `account_id` 和计费系统里的 `customer_ref` 变成同一个客户身份;发票、退款和币种变成以 CHF 计的净收入。一个语义层,每个智能体都复用它。
我知道数据融合这个想法。我没有考虑过的,是把它放进持久化层,由存储一次性完成繁重的工作,每个智能体都拿到结果。这是 [Context is cheaper than exploration](https://raskell.io/notes/context-is-cheaper-than-exploration/) 的论点往下一层,也直接触及 [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/) 里的模式。在那里,融合是一条流水线:来自每个数据源的观测,作为工作流步骤的身份解析,PostgreSQL 里的实体和边,以及每条链接都带着它的依据和置信度。
反驳很容易提出,我也对自己提出过。一个在查询时做融合的数据库会再次移动约束,移进一个我无法控制的产品,而我最在意的语义,也就是该信任哪个数据源、一次匹配有多确定,恰恰是流水线明确表达出来的东西。Exasol 自己的[文档](https://docs.exasol.com/db/latest/ai/ai_build_agents/mcp-server-as-agent-tool.htm)也提醒,一个只有 MCP 服务器的智能体可能会写出忽略 Exasol 方言的 SQL。所以我不会凭一张幻灯片做决定。周一我开始拿参考实现来测试它,并把这个问题记在了 [Data fusion belongs in the store](https://raskell.io/notes/data-fusion-belongs-in-the-store/) 里。
## 制定标准的人 {#the-people-who-wrote-the-standards}
下一场演讲由 Stefano Maestri 和 Alessio Soldano 主讲,能亲眼见到协议背后的人是一件乐事。Maestri 代表 IBM 担任 [A2A Technical Steering Committee](https://github.com/a2aproject/A2A/blob/main/GOVERNANCE.md) 成员,并为 [A2A Java SDK](https://quarkus.io/blog/a2a-project-launches-java-sdk) 写了发布文章;Soldano 在 Red Hat 领导过 RESTEasy,也是 Apache CXF 的提交者。他们两人从内部亲历了 SOAP 与 REST 之争,这场演讲就建立在那段历史之上。
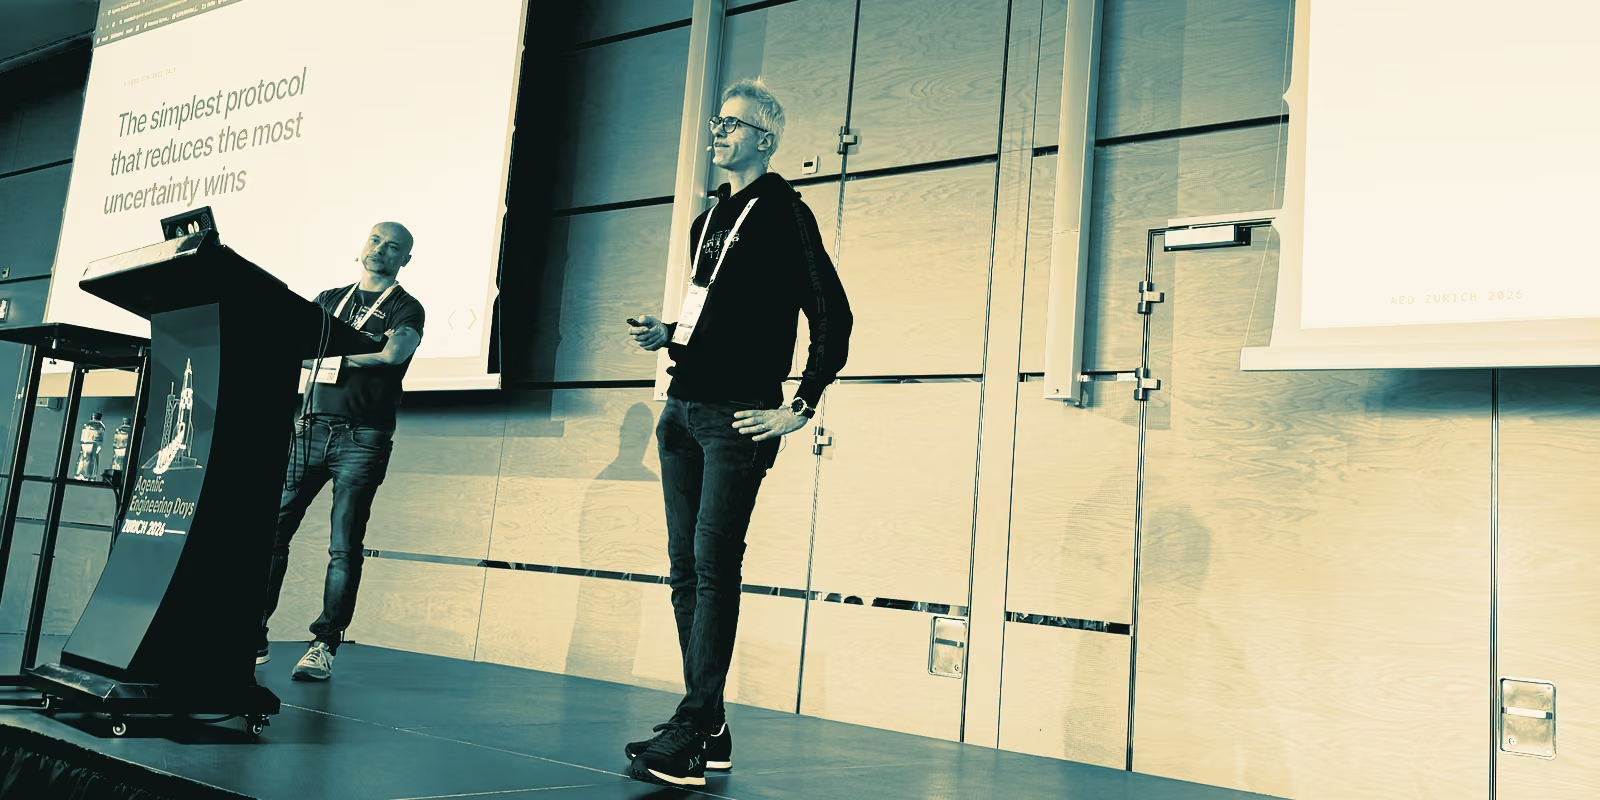 Stefano Maestri(左,讲台旁)和 Alessio Soldano,身后是他们演讲的视角:“能消除最多不确定性的最简单协议会胜出。”
他们的视角是“能消除最多不确定性的最简单协议会胜出。”(“The simplest protocol that reduces the most uncertainty wins.”)他们的地图把一个智能体放在中间,每个边界上都有一份约定:面向模型的 Open Responses,面向工具的 MCP,面向其他智能体的 A2A,面向用户的 AG-UI 和 A2UI,面向知识的 AGENTS.md 和 Skills,面向运维的 OpenTelemetry GenAI,面向编辑器的 ACP,以及面向支付的 x402。地图下面的问题是:“你想让什么变得可替换?”
这场演讲很抽象,与其说是一个故事,不如说是一张地图,我本希望能看到一个系统被从头到尾走一遍。但这张地图给了我一个更好的问题,用来回看我刚离开的那场 Exasol 演讲。“一个 MCP 接口”是押注在一个边界上:智能体保有一份标准契约,契约背后的数据变得可替换。只有当语义层随契约而走、而不是随产品而走时,这才成立,而这正是我要检查的。他们幻灯片里我一再回想的一句是:“打开一条通道并不等于达成约定。”(“Opening a channel is not the agreement.”)MCP 服务器打开一条通道。一个客户意味着什么,才是约定。更多内容见 [The simplest protocol that reduces the most uncertainty wins](https://raskell.io/notes/the-simplest-protocol-wins/)。
## 一切重新成为软件 {#everything-is-software-again}
NVIDIA 在夏天发布 [NOOA](https://github.com/NVIDIA-NeMo/labs-OO-Agents) 时我看过它,却一直没找到一个下午去试,所以我很高兴听到 Matt Staats 亲自讲解。Staats 的博士论文研究测试,还写过一篇关于测试预言的[获奖 ICSE 论文](https://bibtex.github.io/ICSE-2011-StaatsWH11a.html),也就是你如何知道一个程序的输出是对的,对一个如今工作是评估智能体的人来说,这是很好的背景。他的摘要开头是:“一个智能体的好坏,取决于模型周围的 harness。”
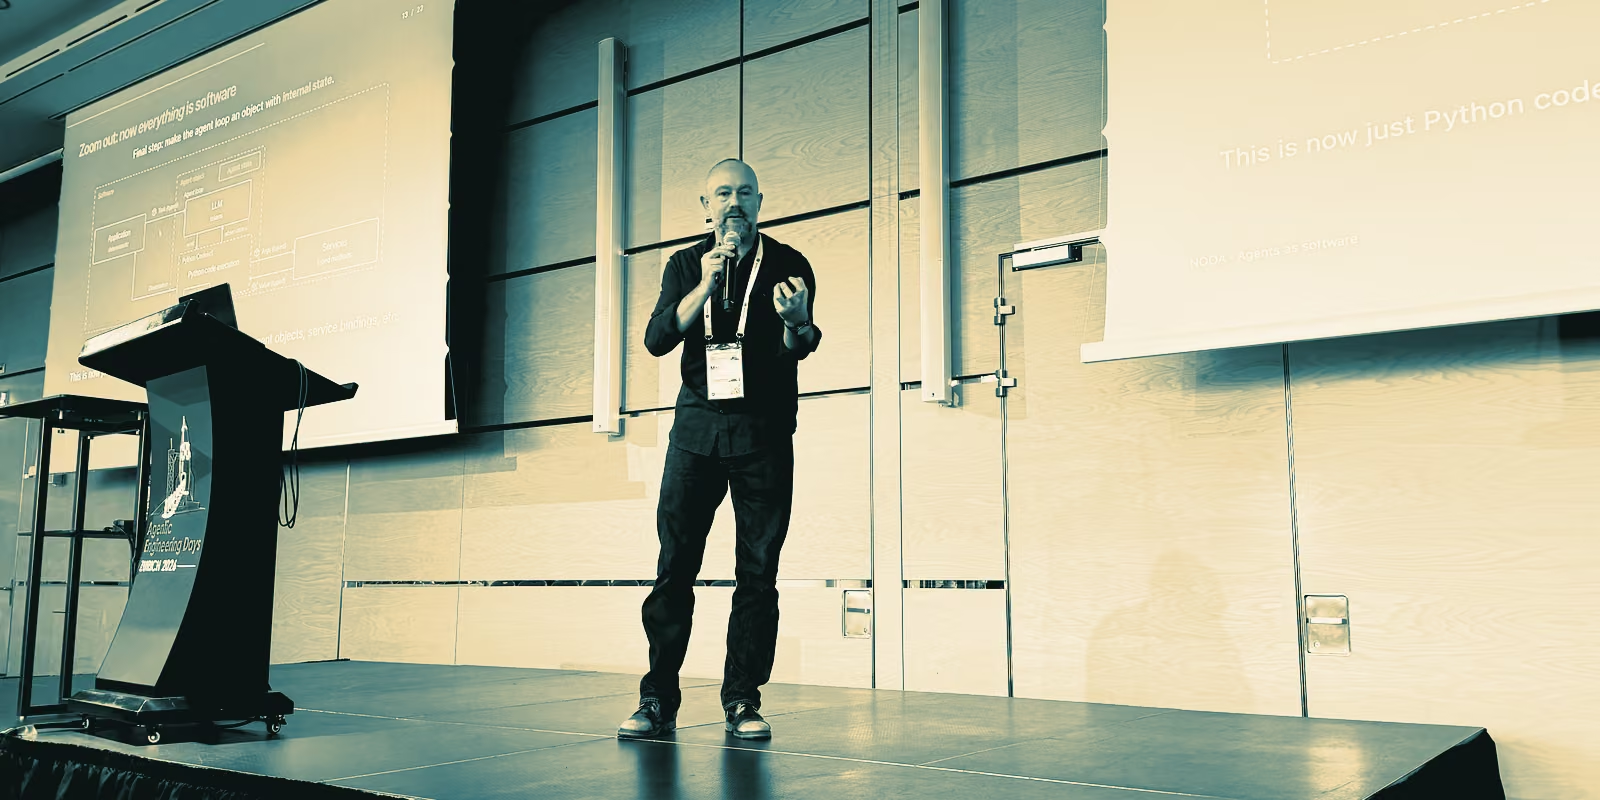 NVIDIA 的 Matt Staats 站在“Zoom out: now everything is software”前,这张幻灯片里智能体循环变成了一个带内部状态的对象。
NOOA 把智能体当作一个 Python 类。方法是能力,字段是状态,docstring 是提示词,签名是契约。一个方法体为空的方法在运行时由模型补全,模型的行动方式是编写调用带类型服务的 Python,也就是来自 [Wang et al.](https://arxiv.org/abs/2402.01030) 的 CodeAct 思路。NVIDIA 的[文章](https://developer.nvidia.com/blog/six-agent-harness-capabilities-for-higher-model-performance/)列出了六项能力:带类型的输入和输出,按引用传递,以代码为行动,可编程的循环工程,显式的对象状态,以及模型可调用的 harness API。它报告在 SWE-bench Verified 上用 GPT-5.5 达到 82.2%,这是 NVIDIA 的数字,不是我的。让我记住的那张幻灯片写着“Zoom out: now everything is software”(拉远看:现在一切都是软件):智能体循环变成一个带内部状态的对象,被一个确定性的应用调用,带类型的任务进去,带类型的值出来。下一张幻灯片上的例子小到可以放在这里。正如幻灯片所注明的,它改编自 NOOA 的框架导览,`llm` 是一个已配置好的客户端:
```python
from nooa import Agent
ItemPrice = tuple[str, float]
CategoryTotal = tuple[str, float]
class BillingAgent(Agent, llm=llm):
categories: set[str] = {"food", "travel", "other"}
async def categorize(self, prices: list[ItemPrice]) -> list[CategoryTotal]:
"""Group items by self.categories; sum prices for each category."""
...
async def run(self, raw: list[ItemPrice]) -> list[CategoryTotal]:
prices = []
for item, price in raw:
if price >= 0: prices.append((item, price))
return await self.categorize(prices)
```
`run` 是普通的 Python,像任何程序一样过滤输入。`categorize` 没有方法体:`...` 把它交给模型,docstring 是提示词,签名说明了必须返回什么。判断被委托了出去,契约没有。
Staats 展示的结果关于记忆,在 ARC-AGI-3 游戏上测量,全程使用同一个模型和同一个 skill。让智能体用 Markdown 自己记笔记达到了 38.4%;NOOA 的记忆 API 达到了 50.2%。智能体写下了 3,262 条记忆,但自动召回平均每轮只取回 4.1 条,所以上下文窗口保持得很小。之后那张幻灯片的标题是“Software is cheaper than thinking”(软件比思考便宜),副标题是“even if software is doing the thinking”(即使是软件在思考):要达到 Markdown 那次运行的分数,带世界模型和记忆 API 的版本估算 API 成本约 $290,对比约 $1,040。由 harness 管理的结构化记忆胜过模型必须反复重读的笔记,而从数千条记忆中只取回四条的召回,是一种 [strategic forgetting](https://raskell.io/notes/strategic-forgetting/),这次还附上了价格。
这是我见过的约束被移动得最令人信服的地方。提示词和松散的工具列表难以评审、版本化和测试;一个带签名的类则不然。它接近我在 [Tools: How Agents Actually Do Things](https://raskell.io/articles/tools-how-agents-actually-do-things/) 里描述的东西,只是走得比我更远。
我一直在想的,是“带类型”这个词出现在一门不强制类型的语言里。在 Python 中,应用与智能体之间的契约在调用发生时才被检查,NOOA 会重试直到输出符合。在一门由编译器强制契约的语言里,类型不一致,程序就构建不起来。这让我回到 [bhc](https://arcanist.sh/bhc/),想推理和 harness 绑定能否在那里成为原生原语,让一次智能体调用像任何其他 effect 一样带类型。我还不知道那会是一个库、一个语言特性,还是一个坏主意。半成形的版本在 [Harness types in the compiler](https://raskell.io/notes/harness-types-in-the-compiler/) 里。
## 约束落在对齐上 {#the-constraint-lands-on-alignment}
这一天最有远见的演讲来自 GitHub Next 的 Krzysztof Cieślak,他创造了 F# 工具 Ionide,并把自己列为 Copilot 的共同创造者之一。他的摘要说“到目前为止,智能体工程一直是一个人的故事”,这与我的经验相符:一个人,几个智能体,大量产出,房间里没有别人。一张幻灯片写着“大多数 AI 工具关注的是单个开发者的生产力”;让全场有反应的那张写着“代码很便宜。共同的理解和信任却不是。”(“Code is cheap. Shared understanding and trust aren't.”)
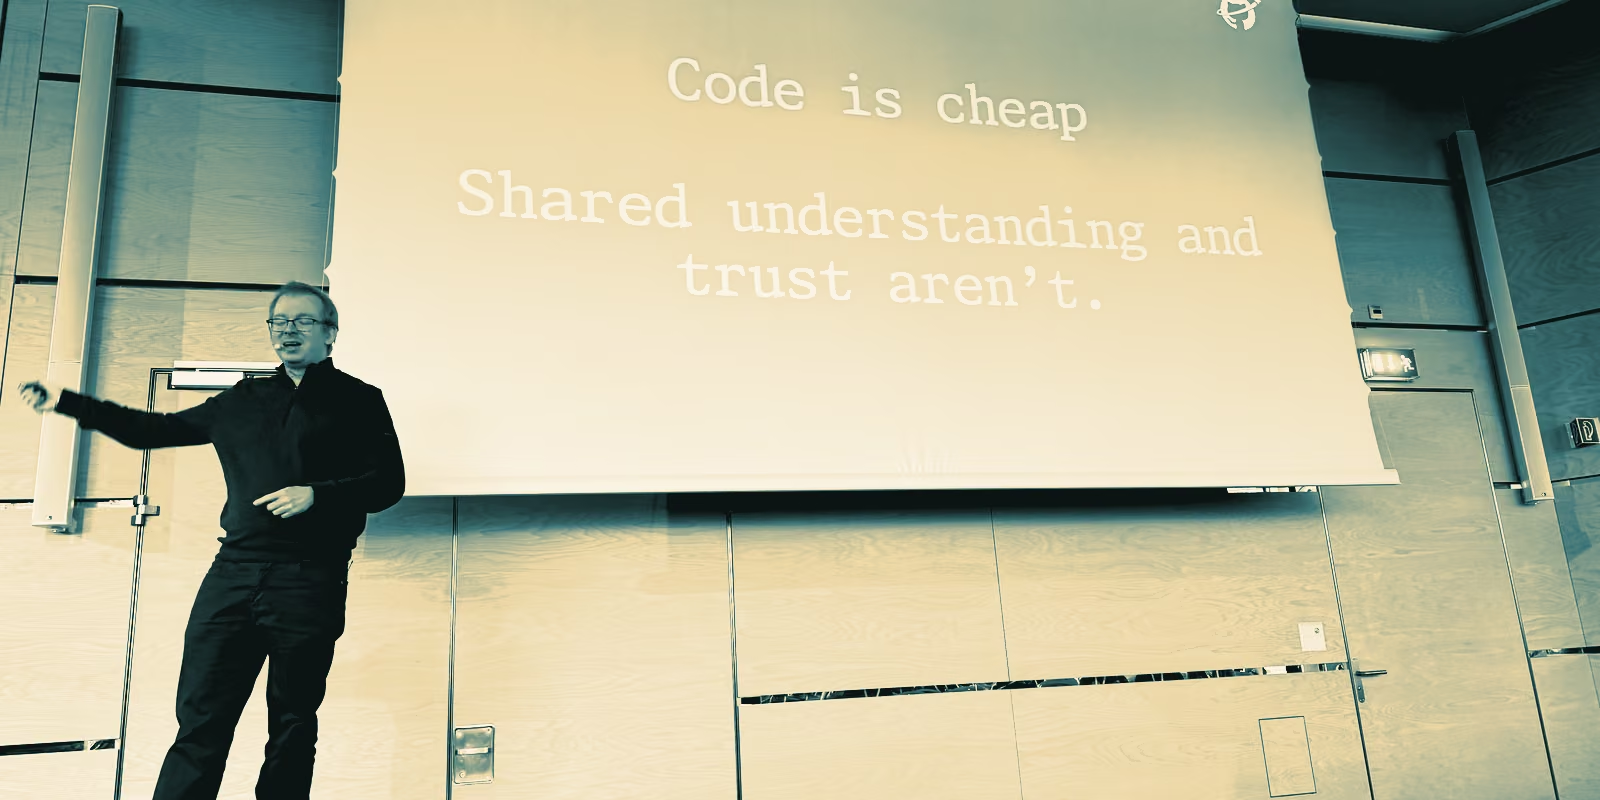 GitHub Next 的 Krzysztof Cieślak:“代码很便宜。共同的理解和信任却不是。”这张幻灯片让全场有了反应。
他展示了两个研究原型。Ace 把一个团队、它的聊天、它的编程智能体以及它们的 microVM 放进一个共享工作空间。它的后继者 [Chopin](https://githubnext.com/projects/chopin/) 是“一个实时多人、智能体化的规划环境”,同事和智能体围绕一个代码仓库一起写计划,并在所有人都能看到的地方敲定决策。GitHub Next 小心地称 Chopin“既不是产品,也不是完成的原型”,而 Ace 已经暂停。
它们背后的论点又是 Reznik 那句话。GitHub Next 的 Maggie Appleton 今年早些时候用一句话[说出了它](https://maggieappleton.com/zero-alignment):“就构建什么达成一致,是新的瓶颈。”当智能体让代码变得便宜,约束就移到了关于代码应该是什么的对话上,而 pull request、issue 和聊天并不是为那种速度下的那种对话而建的。
我相信工作正在往这里去:几个人和几个智能体共处其中的共享对话,决策、设计和代码都在对话里产生,并一直附着在对话上。这让我想到 [Zed](https://zed.dev/),我很早就用它,因为在智能体成为话题之前很久我就喜欢它的愿景。Zed 用 Rust 编写,用[他们的话](https://zed.dev/blog/videogame)说,“像电子游戏一样渲染”,建立在自己的 GPU 框架之上,并且从一开始就是多人协作的。今年他们发布了 [DeltaDB](https://zed.dev/blog/introducing-deltadb),一种“捕捉其间每一个操作并赋予每个操作稳定身份”的版本控制,以及构建在它之上的 [Delta](https://zed.dev/blog/introducing-delta),其发布文章写道:“如今软件发生在线程里,界面应该反映这一点。”Zed 来得早于它的时代,一路上失去了一些势头。我仍然在为他们加油。更多内容见 [The conversation is the workspace](https://raskell.io/notes/the-conversation-is-the-workspace/)。
## 确定性,以及黑灯工厂 {#determinism-and-the-dark-factory}
对我来说,下午以 Typeform 的 staff engineer Susanna Wong 收尾,讲的是当软件不再具有确定性时会发生什么。我们大部分工程实践都假定同样的输入给出同样的输出;她的摘要直白地说,“LLM 系统打破了这个假设”,演讲讲述了 Typeform 不得不改变的东西:用持续评估取代测试套件,用追踪取代日志,把提示词当作工程产物来评审,以及围绕那些不会两次表现相同的组件做编排。这是 [Evaluation Closes the Loop](https://raskell.io/articles/evaluation-closes-the-loop/) 涵盖的领域,能从一个必须在产品中亲历这一切的人那里听到它,很好。
她的最后一张幻灯片标着“The one thing to take home”(要带回家的一件事),写着“提示词买来的是产出率。系统买来的是保证。”(“Prompts buy yield. Systems buy guarantees.”)下面是:“可靠性是系统的属性,而不是模型的属性。”最底部用小字写着这一天那句话的另一种形式:“确定性没有消失。它移动了:从模型里出来,进入模型周围的系统。”(“Determinism didn't disappear. It moved: out of the model, into the system around it.”)提示词可以提高好答案的比例。只有模型周围的系统,评估、重试、带类型的契约、签字确认的人,才能承诺任何东西。
她的演讲也是 Reznik 的黑灯工厂通向的地方。这个词来自无人值守制造,Dan Shapiro 的 AI 编程[五个层级](https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/)以它结尾:一个“把规格变成软件的黑箱”。Simon Willison 的[总结](https://simonwillison.net/2026/Jan/28/the-five-levels/)描绘了一座工厂,那里“灯是关着的,因为机器人不需要看见”。Reznik 通向那里的六个系统是编排、沙箱、上下文、验证、治理和学习循环,没有一个是模型。把灯关掉,约束就移到了留给人的两件事上:写规格,以及知道输出是否正确。这就是 Wong 的演讲,也是 Staats 的老本行。
## 我带回家的东西 {#what-i-took-home}
 在 apéro 上和我的同事们一起,这是会议中任何演讲都无法替代的部分。
演讲很好,这一天更好,主要是因为演讲之间以及 apéro 上和同事们的那些对话。但如果只留下一件事,那就是 Reznik 那句话给我的习惯。我看过的每一场演讲都移动了一个约束:进入数据库,进入协议,进入类型,进入共享对话,进入评估。没有一场让约束消失。关于任何新的智能体工具,有用的问题不是它消除了什么,而是它把工作放到了哪里,以及那个地方是不是我能看见、测试并掌握的。
 黄昏时的苏黎世火车总站,在回巴塞尔的路上。
## 参考资料 {#references}
- [Agentic Engineering Days Zurich 2026, programme](https://www.agenticdays.com/sessions)
- Pini Reznik, [From Copilot to the Dark Factory](https://www.agenticdays.com/session/1301641-from-copilot-to-the-dark-factory),会议摘要
- David Pech, ["YOU MUST NOT ssh!" and Other Stories from Building Our SRE Agent](https://www.agenticdays.com/session/1250380-you-must-not-ssh-and-other-stories-from-building-our-sre),会议摘要
- Alexander Stigsen, [Beyond MCP: Supercharging your agents with a single unified data plane](https://www.agenticdays.com/session/1368894-beyond-mcp-supercharging-your-agents-with-a-single-unified),会议摘要
- Exasol, [MCP Server as an agent tool](https://docs.exasol.com/db/latest/ai/ai_build_agents/mcp-server-as-agent-tool.htm)
- Stefano Maestri and Alessio Soldano, [Agents Speak Protocol](https://maeste.it/agents-speak-protocol-aed/),幻灯片及[来源](https://maeste.it/agents-speak-protocol-aed/sources.html)
- A2A project, [GOVERNANCE.md](https://github.com/a2aproject/A2A/blob/main/GOVERNANCE.md)
- Matt Staats, [NOOA: Inside NVIDIA's Object-Oriented Agent Harness](https://www.agenticdays.com/session/1305345-nooa-inside-nvidia-s-object-oriented-agent-harness),会议摘要
- NVIDIA, [NVIDIA-NeMo/labs-OO-Agents](https://github.com/NVIDIA-NeMo/labs-OO-Agents) 和 [Six Agent Harness Capabilities for Higher Model Performance](https://developer.nvidia.com/blog/six-agent-harness-capabilities-for-higher-model-performance/)
- Xingyao Wang et al., [Executable Code Actions Elicit Better LLM Agents](https://arxiv.org/abs/2402.01030), ICML 2024
- Matt Staats, Michael W. Whalen and Mats P. E. Heimdahl, [Programs, Tests, and Oracles: The Foundations of Testing Revisited](https://bibtex.github.io/ICSE-2011-StaatsWH11a.html), ICSE 2011
- Krzysztof Cieślak, [The next frontier: agentic collaborative environments](https://www.agenticdays.com/session/1283743-the-next-frontier-agentic-collaborative-environments),会议摘要;GitHub Next, [Chopin](https://githubnext.com/projects/chopin/)
- Maggie Appleton, [One Developer, Two Dozen Agents, Zero Alignment](https://maggieappleton.com/zero-alignment)
- Zed, [Leveraging Rust and the GPU to render user interfaces at 120 FPS](https://zed.dev/blog/videogame)、[Software Is Made Between Commits](https://zed.dev/blog/introducing-deltadb) 和 [Introducing Delta](https://zed.dev/blog/introducing-delta)
- Susanna Wong, [When Software Stops Being Deterministic](https://www.agenticdays.com/session/1287383-when-software-stops-being-deterministic-rethinking),会议摘要
- Pini Reznik and Michael Müller, [From Cloud Native to AI Native](https://re-cinq.com/whitepapers)
- Susanna Wong,演讲的结束幻灯片,现场拍摄
- Dan Shapiro, [The Five Levels: from Spicy Autocomplete to the Dark Factory](https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/)
- Simon Willison, [The five levels](https://simonwillison.net/2026/Jan/28/the-five-levels/)
================================================================================
---
title: "几乎无关紧要:当智能体写代码时,如何选择编程语言"
url: https://raskell.io/zh/articles/almost-irrelevant/
author: Raffael Schneider
date: 2026-11-19
description: "当智能体写下大部分代码,语言没有以前那么重要了,但也并非毫不重要。Rust、Go、Elixir 和 Haskell 仍然能给你带来什么。"
tags: [programming-languages, ai-engineering, rust, golang, elixir, haskell, type-systems]
lang: zh-Hans
translation_of: https://raskell.io/articles/almost-irrelevant/
---
# 几乎无关紧要:当智能体写代码时,如何选择编程语言
## 简而言之
编程智能体吸收了过去决定语言选择的那些成本,也就是学习曲线、样板代码和招聘人才池,所以这个选择远没有以前那么重要了。 剩下的是智能体离开之后一门语言还能做出的承诺:编译器检查什么,运行时在故障下如何表现,代码在评审时读起来如何,以及它在整个公司范围内如何组合。 Rust 用于无论如何都必须正常工作的东西,也就是 C 和 C++ 过去占据的领地,以及替换大型机上用 COBOL 写的核心系统;Go 用于整个公司共享的朴素代码,也就是 Java 过去占据的领地。 Elixir 用于天生分布式的平台,以及一个人运营的雄心勃勃的项目,只是类型系统仍在到来的路上;通过 bhc 使用的 Haskell,则是押注一种不同的软件构建方式:经过验证的含义不断积累,而不是一再重写。 Python 和 TypeScript 在笔记本和浏览器里保住各自的位置,而人们越来越多写下的是需求,用 Markdown 和 JSON,而不是用编程语言。
如果大部分代码都由智能体来写,它用哪门语言写还重要吗?
在我职业生涯的大部分时间里,选择语言其实是在选择人。你能招到谁,他们要多久才能上手,他们已经会什么,以及他们在第一个月里会有多讨厌借用检查器。这些成本决定的语言之争,比任何基准测试决定的都多,而如今它们大多已经坍塌。智能体写地道的 Rust 和写 Python 一样顺手。它不介意样板代码,不需要花一个月学习生命周期,对制表符也没有任何意见。过去让团队对 Rust、Elixir 或 Haskell 望而却步的学习曲线,现在大体上成了智能体的问题。
所以我的回答是:语言已经变得几乎无关紧要,但并非完全无关紧要,因为一门语言从来不只是一种敲代码的方式。它还是一个编译器,决定在任何东西运行之前检查什么;是一个运行时,决定出故障时会发生什么;是一种风格,决定一个人能多快评审智能体写出来的东西;也是一个模块系统,决定这些代码如何与组织里已有的其他一切契合。这些都没有消失,其中有些比以前更重要。
关于编程语言长远的走向,我在 [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/) 里写过。这篇文章是它的实践篇:我今天会选用哪些语言,用来做什么,以及为什么。它带有我的立场,而且只谈四门语言,因为我用的就是这四门。
## 智能体吸收了什么,又没有吸收什么 {#what-the-agent-absorbs-and-what-it-does-not}
arcanist.sh 上的文章 [The Scorecard Is Right. The Weights Are Wrong.](https://arcanist.sh/blog/the-scorecard-is-right-the-weights-are-wrong/) 提出了一个我一再回想的论点:常见的语言评分表本身是公允的,但它们的权重假定作者是一个人,必须把整个程序装在脑子里。作者换了,权重也就换了。大致如下:
| 一门语言让你付出或给你的东西 | 由人写代码时的权重 | 由智能体写代码时的权重 |
|---|---|---|
| 学习曲线、繁文缛节、样板代码 | 高 | 低:由智能体承担 |
| 招聘人才池的大小 | 高 | 较低:写代码的人更少,评审代码的人更多 |
| 编译器在任何东西运行之前检查什么 | 中 | 高:生成很便宜,验证才是瓶颈 |
| 代码在评审者眼中读起来如何 | 中 | 高:每一行仍然需要一个读者 |
| 构建和测试的速度 | 中 | 高:这个循环以机器的速度运转 |
| 运行时在负载和故障下如何表现 | 高 | 不变 |
| 生态系统和库 | 高 | 依然高:智能体也复用库 |
失去权重的那些行关乎编写;获得权重的那些行关乎信任已经写好的东西。这就是本文其余部分的视角:对每一门语言,它对团队里没人亲手敲过的代码做出什么承诺?
为了让示例可以相互比较,下面每一段代码都处理同一个小需求的一部分,就是银行核心系统里比比皆是的那种:为一个账户计入月度利息,按远离零的方向四舍五入到分,并且绝不计入已关闭的账户。它在文章快结束时会被完整写出来,用的是我认为需求将来会采用的形式。
## Rust:用于必须正常工作的东西 {#rust-for-things-that-have-to-work}
Rust 占据着 C 和 C++ 过去占据的领地:代理、操作系统、运行时、编译器、引擎,以及任何要连续运行数月、处在热路径上、或者要处理怀有恶意的人所提供输入的东西。借用检查器在编译期就带来内存安全和无数据竞争,而且不需要垃圾回收器;类型系统则让人很自然地把不变量放在编译器看得见的地方。
Rust 出了名的代价,是与借用检查器的搏斗,而这场搏斗正是智能体能吸收的那类成本。Rust 甚至把它变成了优势,因为它的编译器错误精确、局部、可操作,这使它们几乎是在循环中工作的模型的理想反馈。智能体提出方案,编译器带着行号和建议提出异议,智能体修好它。等到一个人来读这段代码时,一整类错误已经消失了。
下面就是两个线程往同一个账本里追加记录时的那种反馈;在许多语言里,这段代码能编译通过,然后只在生产环境、在负载之下偶尔出错:
```rust
let mut ledger = Vec::new();
let a = thread::spawn(move || ledger.push("interest"));
let b = thread::spawn(move || ledger.push("fees"));
```
```text
error[E0382]: use of moved value: `ledger`
--> src/main.rs:6:27
|
5 | let a = thread::spawn(move || ledger.push("interest"));
| ------- ------ variable moved due to use in closure
| |
| value moved into closure here
6 | let b = thread::spawn(move || ledger.push("fees"));
| ^^^^^^^ ------ use occurs due to use in closure
| |
| value used here after move
|
help: consider cloning the value before moving it into the closure
```
程序根本不会运行,而错误信息准确地说明了在哪里、为什么。它也显示了编译器的局限,以及一个人或一条需求仍然重要的地方:建议的修复办法,也就是克隆这个向量,可以编译,但它给每个线程各自一个账本,而这并不是银行想要的。正确的修复是用一把锁保护的一个共享账本,`Arc>>`,而要选中它,就得知道这段代码是做什么用的。编译器把智能体的选项收窄到安全的那些;需求则在其中做出选择。
证明这一点在大规模上很重要的证据,并不是我的。Google 在 2024 年报告说,Android 中内存安全漏洞的占比「随着开发转向内存安全语言,在 6 年间从 76% 降到了 24%」,而且问题「绝大部分出在新代码上」([Google Security Blog](https://security.googleblog.com/2024/09/eliminating-memory-safety-vulnerabilities-Android.html))。一年之后,同一个团队报告说,Rust 中的内存安全漏洞密度比 Android 的 C 和 C++ 低「超过 1000 倍」,而且 Rust 改动的回滚率大约低四倍([Google Security Blog](https://security.googleblog.com/2025/11/rust-in-android-move-fast-fix-things.html))。如果智能体即将写出大量新代码,那么这些新代码最安全的落脚处,就是一门让这些错误无法编译通过的语言。
出于这个原因,我构建的大部分东西都用 Rust。[Zentinel](https://zentinelproxy.io/) 是一个反向代理,挡在别人的流量前面。Aqueduct 是一个持久化执行引擎,必须在崩溃之后把一次运行重放出同样的结果([The River and the Canal](https://raskell.io/articles/the-river-and-the-canal/) 解释了原因)。hx 和 bhc 是别人的构建所依赖的工具链([Why We Built a Haskell Package Manager in Rust](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/) 讲了这个故事)。Shiioo 在我自己的机器上运行智能体,并记录它们做了什么([Shiioo, Re-imagined](https://raskell.io/articles/shiioo-reimagined-and-a-home-ai-lab/))。这些东西一旦出错代价都很高,而且每一个都以单个静态二进制文件的形式发布。
同样的推理,让 Rust 成为我在这类工作中最大的一项上的首选:替换银行、保险公司和公共管理机构仍在大型机上运行的核心系统,其中大多数是几十年前用 COBOL 写的。这些系统能用。它们可靠,十进制运算做得正确,而且挺过了每一次替换它们的尝试,主要是因为没有人能有把握地说出它们的全部代码都做了什么。智能体改变了这个问题的一半。它们耐心地阅读 COBOL,解释一个程序做了什么,并且不知疲倦地写出新版本。它们改变不了的,是新系统必须至少和旧系统一样可靠,而这正是语言起作用的地方。Rust 给你大型机的优点,却不需要大型机:没有未定义行为,没有垃圾回收器在一次记账运行中途停顿(Discord 在 2020 年正是因为这个原因把一个服务从 Go 迁到了 Rust,此前 Go 的垃圾回收器至少每两分钟运行一次,造成了[周期性的延迟尖峰](https://discord.com/blog/why-discord-is-switching-from-go-to-rust)),有用于金额的精确十进制类型,比如 [rust_decimal](https://docs.rs/rust_decimal/),还有一个在程序运行之前就拒绝整类错误的编译器。利息本身算得对不对,仍然要由需求和它的测试来判断,前面那个被克隆的账本已经说明了这一点。
金额这部分很短。COBOL 程序把金额保存为定点十进制数,替换它的系统也必须这样做,绝不能用二进制浮点数,在那里 `0.1 + 0.2` 等于 `0.30000000000000004`:
```rust
use rust_decimal::{Decimal, RoundingStrategy};
use rust_decimal_macros::dec;
/// Monthly interest, rounded half away from zero to the cent.
fn monthly_interest(balance: Decimal, annual_rate: Decimal) -> Decimal {
(balance * annual_rate / dec!(12))
.round_dp_with_strategy(2, RoundingStrategy::MidpointAwayFromZero)
}
// monthly_interest(dec!(1234.56), dec!(0.015)) == dec!(1.54)
```
舍入规则按名字写进了代码,因为一条只存在于某人对旧系统行为记忆中的舍入规则,正是迁移出错的方式。
大型机用批处理窗口和事务监控器做的事,Rust 用它的异步运行时 [Tokio](https://tokio.rs/) 来做:在少数几个线程上运行成千上万个并发任务,带有定时器、超时和取消。Tokio 本身运行在一个进程里;分布来自于在负载所需的那么多台机器上运行许多小的二进制文件,前面是一个做复制的数据库。迁移本身应该刻意保持平淡:让新旧两个系统在相同的输入上并行运行,比较每一个输出,等它们一致之后,再一次切换一个产品或一个批次。用 Tokio,这种比较的核心只有几行:
```rust
/// Parallel run: the mainframe stays the system of record, the new core shadows it.
async fn post_interest(
legacy: &Legacy, core: &Core, divergences: &Divergences, balance: Decimal,
) -> Outcome {
let (old, new) = tokio::join!(legacy.post(balance), core.post(balance));
if old != new {
divergences.record(balance, &old, &new).await;
}
old
}
```
两个系统同时得到相同的输入,算数的是旧系统的答案,每一处分歧都被记录下来,等人去解释。这种比较才是真正的工作,而这正是智能体擅长的工作。语言则让人在此之后可以放心信任它们产出的东西。
Rust 有它的代价,智能体并不能把它们全部消除。构建比 Go 慢。异步 Rust 仍然比它应有的样子更难。而且对一个读不惯生命周期的人来说,Rust 评审起来并不快,当评审者来自另一个团队时,这一点很重要。(Google 的 Android 工程师报告的情况正好相反,说 Rust 改动在评审上花的时间少了大约四分之一,但他们比较的对象是 C++,不是 Go,而且他们每天都在评审 Rust。)我不会默认用它来写一家公司的内部服务,只会用它来写那些服务承受不起出错的部分。
## Go:用于整个公司共享的代码 {#go-for-code-a-whole-company-shares}
Go 就是 Java 过去之于大型组织的那个角色:它们成百上千地运行的那些朴素而长寿的服务所用的语言,由许多团队来写,由更多的团队来读。长版本我写在 [Building IT Intelligence](https://raskell.io/articles/building-it-intelligence/#why-go) 的「为什么用 Go」一节里,这里是短版本。
Go 地道到了乏味的地步,而在一家公司里,这是最高的赞誉。做一件事通常只有一种方式,`gofmt` 决定了排版,错误是值,在发生的地方处理,依赖是传进来的,而不是由框架变出来的,这门语言也不提供那套把企业级 Java 变成工厂的工厂的机制。导入的是模块路径,通常就是一个 Git 仓库的地址,所以引用另一个团队的代码只是文件里的一行,而不是给制品仓库团队提的一张工单。在一个模块内部,一切都从源码编译,这让全公司范围的单一仓库变得很便宜:没有需要发布、打版本、等待的内部库。它几秒钟就能编译完,运行很快,以单个二进制文件发布,它的工具链(测试、vet、竞态检测器、性能剖析、语言服务器)都是自带的。而 [Go 1 兼容性承诺](https://go.dev/doc/go1compat) 说,按照规范编写的程序「将继续编译并正确运行,无需改动」,这正是企业软件存活的时间尺度。
智能体带来的变化是,这种乏味成了双重的资产。智能体写的 Go 看起来和人写的 Go 一样,因为风格上的余地太小了,所以来自另一个团队的评审者读它,就像读散文一样快。同样的千篇一律也让智能体很容易在一个庞大的 Go 代码库里找到方向:一个函数做的就是它的签名所说的事,调用图就摆在那里。
用 Go 写的利息规则是这样的,无论哪个团队或哪个智能体写它,读起来都一样:
```go
var ErrClosed = errors.New("account is closed")
// MonthlyInterest returns the interest in cents for one month,
// rounded half away from zero, as the requirement says.
func MonthlyInterest(ctx context.Context, accounts Accounts, iban string, bps int64) (int64, error) {
acct, err := accounts.Get(ctx, iban)
if err != nil {
return 0, fmt.Errorf("monthly interest for %s: %w", iban, err)
}
if acct.Closed {
return 0, fmt.Errorf("monthly interest for %s: %w", iban, ErrClosed)
}
return roundHalfAway(acct.Balance*bps, 10000*12), nil
}
```
依赖是一个传进来的接口,每一次失败都是一个值,在向上传递的途中加上上下文,调用方可以问 `errors.Is(err, ErrClosed)`,而不必解析一条消息,这些都不需要向另一个团队的人解释。
代价是 Go 检查的比 Rust 或 Haskell 少。它没有和类型(sum types),`nil` 仍然是一个值,相当一部分正确性存在于测试之中,而不是类型之中。对一家公司来说,这通常是正确的取舍:必须正确的那个系统用 Rust,围绕它的上百个服务用 Go。
## Elixir:用于天生分布式的平台 {#elixir-for-platforms-that-are-distributed-by-nature}
Elixir 运行在 BEAM 上,也就是 Erlang 虚拟机,而 BEAM 是为电话交换机而建的:数以百万计的小型隔离进程,重启崩溃者的监督者,节点之间的消息作为一等公民,以及一种为故障而设计、而不是假装故障不会发生的文化。大多数语言靠库和基础设施来加上分布式能力。在 BEAM 上,它是默认的思考方式。
BEAM 上的一个进程并不是操作系统线程。根据 [Erlang efficiency guide](https://www.erlang.org/doc/system/eff_guide_processes.html),新建一个进程占用 327 个字的内存,大约 2.6 KB,并且有自己的堆,所以一台机器能运行几十万个进程,一个进程的垃圾回收也从不会让其他进程停下来。(基于 Erlang 构建的 WhatsApp 报告说,在 2012 年 1 月,单台服务器上维持了[超过两百万个 TCP 连接](https://blog.whatsapp.com/1-million-is-so-2011)。)进程之间不共享任何东西,通过消息交谈,并由监督者看管。一个应用是一棵监督者树,一个集群是分布在能相互发送消息的机器上的若干棵这样的树。这是 broodwar.live 的那棵树,做了删减:
```elixir
children = [
Broodwar.Repo, # the database pool
{DNSCluster, query: dns_cluster_query()}, # find the other nodes
{Phoenix.PubSub, name: Broodwar.PubSub}, # messages across nodes
{Oban, Application.fetch_env!(:broodwar, Oban)}, # durable jobs in PostgreSQL
Broodwar.Ingestion.LiquipediaThrottle, # one process, one rate limit
BroodwarWeb.Endpoint # one process per connection
]
Supervisor.start_link(children, strategy: :one_for_one, name: Broodwar.Supervisor)
```
而这是它在两台机器上运行时的样子:
*One application on the BEAM, on two nodes*
```text
node a node b
┌────────────────────────────────────┐ ┌──────────────────────┐
│ Broodwar.Supervisor (one_for_one) │ │ Broodwar.Supervisor │
│ ├─ Repo database pool │ │ ├─ Repo │
│ ├─ PubSub ◀───────────────────────┼──────┼─▶├─ PubSub │
│ ├─ Oban job queues │ │ ├─ Oban │
│ ├─ Throttle crashed, so the │ │ ├─ Throttle │
│ │ supervisor starts │ │ └─ Endpoint │
│ │ a fresh one alone │ │ ○ ○ ○ ○ ... │
│ └─ Endpoint │ └──────────┬───────────┘
│ ○ ○ ○ ○ ○ ○ ○ ○ ... │ │
│ one process per connection │ │
└─────────────────┬──────────────────┘ │
└─────────────────┬──────────────────┘
▼
PostgreSQL: data, and Oban's jobs
```
当限流进程崩溃时,它的监督者会启动一个新的,而打开的连接、作业队列和另一个节点都不会察觉。在一个节点上发布的消息会到达另一个节点上的订阅者。这就是整个分布式系统,其中没有任何一部分需要一件单独的基础设施。
这让 Elixir 成为我在天生分布式的平台上的选择:任何全渠道的东西,同一段对话会通过网页、聊天、邮件和电话到来;任何有实时在线状态和大量打开连接的东西;任何有大量必须在重启后存活的后台工作的东西。后台工作正是 [Oban](https://oban.hexdocs.pm/Oban.html) 发挥作用的地方,这是一个作业框架,它「使用 PostgreSQL、MySQL 或 SQLite3 进行持久化」。作业存放在你已有的数据库里,带有重试、唯一性和队列,不需要另外运行一个消息代理。在 [broodwar.live](https://broodwar.live) 里,一个从 Liquipedia 摄取赛事页面的作业是这样的:
```elixir
# api.broodwar.live, lib/broodwar/ingestion/match_sync.ex (trimmed)
use Oban.Worker,
queue: :ingestion,
max_attempts: 3,
unique: [period: 3600, fields: [:args]]
@impl Oban.Worker
def perform(%Oban.Job{args: %{"pages" => pages}}) when is_list(pages) do
case run(pages) do
{:ok, _summaries} -> :ok
{:error, {:rate_limited, _} = reason} -> {:cancel, reason}
{:error, reason} -> {:error, reason}
end
end
```
重试、一小时内去重,以及在数据源对我们限流时停下来而不是重试的决定:八行代码,每一行都能被从没见过 Elixir 的人读懂。[Humankind](https://humankind.plus) 是一个收藏人们的声音和故事的档案库,它以同样的方式运行八个队列(转写、嵌入、语音合成、故事生成等等),与 Phoenix 的实时更新并列,在同一个运行时里。
这也是为什么 Elixir 是我在一个人运营的雄心勃勃的项目上最喜欢的语言。一家公司会拆分成 Web 层、队列、消息代理、缓存和集群管理器的东西,BEAM 用一个你仍然可以装在脑子里的系统就给了你。它没有 Go 那样的招聘人才池或跨团队的约定,所以我不会把它作为大型组织的默认选择,但一个小团队靠它能走得很远。
它的弱点一直是类型,而有了智能体,这一点分量更重,因为动态语言在运行之前检查的智能体所写内容更少。这种情况正在改变。2026 年 6 月发布的 [Elixir 1.20](https://elixir-lang.org/blog/2026/06/03/elixir-v1-20-0-released) 能够「在不引入类型注解的情况下,对每一个 Elixir 程序进行类型推断和渐进式类型检查」。带类型的结构体和类型签名还在后面,没有确定的日期([路线图](https://elixir-lang.org/blog/2026/01/09/type-inference-of-all-and-next-15/))。在那之前,我依靠模式匹配、typespec 和测试,并且评审智能体写的 Elixir 比评审智能体写的 Rust 更加仔细。
如果你今天就想要带静态类型的 BEAM,有 [Gleam](https://gleam.run/),「一门用于构建可扩展的类型安全系统的友好语言」。它编译到同一个虚拟机,所以拥有进程、监督者和分布式能力,它能使用用 Erlang 和 Elixir 写的包,并且自 [2024 年 3 月的 1.0 版本](https://gleam.run/news/gleam-version-1/) 以来一直保持稳定。一切都有类型,并由编译器检查,而这正是智能体写代码时分量加重的那个性质。它的生态系统比 Elixir 的年轻,也没有用它写的 Phoenix 或 Oban,不过可以通过它的外部函数接口调用 Elixir 库,类型则要手写。对于 BEAM 上一个正确性比框架更重要的新服务,它是我会最先考虑的选择。
## Haskell 和 bhc:另一种押注 {#haskell-and-bhc-a-different-kind-of-bet}
Rust、Go 和 Elixir 是对我们早已有的问题的更好回答。而 Haskell,以我正在构建的这种形式,回答的是一个只有在智能体写代码之后才出现的问题:当生成变得廉价时,会发生什么?
模型几秒钟就能写出看似合理的代码,而看似合理的代码常常是错的,所以稀缺的工作从写代码转移到了确知代码正确(以及,正如我在 [The Behavioural Turn](https://raskell.io/articles/the-behavioural-turn/) 里论证的那样,转移到决定究竟有多少代码需要有人去读)。在生产语言里,Haskell 是让这一点可检查程度最高的那一门。一个类型良好的函数,就是一个变换有效的小小证明;副作用在签名里可见;非法状态可以被做成无法表示。模型不必是对的;它必须是可检查的,而编译器就是检查者。检查者甚至可以坐进生成过程内部:苏黎世联邦理工学院(ETH Zurich)和加州大学伯克利分校(UC Berkeley)的一个团队让类型检查器逐个 token 地约束模型的输出,把生成的 TypeScript 中的编译错误减少了一半以上([Mündler et al., 2025](https://arxiv.org/abs/2504.09246))。
利息需求说,利息绝不计入已关闭的账户。在大多数语言里,这条规则是一个需要有人记住的 `if`。在 Haskell 里,它可以就是数据的形状:
```haskell
newtype Cents = Cents Integer
newtype BasisPoints = BasisPoints Integer
data OpenAccount = OpenAccount { iban :: String, balance :: Cents }
data ClosedAccount = ClosedAccount { closedIban :: String }
data Account = Open OpenAccount | Closed ClosedAccount
-- Interest can only be posted to an open account: the type says so.
postInterest :: BasisPoints -> OpenAccount -> OpenAccount
postInterest (BasisPoints bps) acct = acct { balance = Cents (c + interest) }
where
Cents c = balance acct
interest = roundHalfAway (c * bps) (10000 * 12)
monthEnd :: BasisPoints -> Account -> Account
monthEnd rate (Open a) = Open (postInterest rate a)
monthEnd _ (Closed c) = Closed c
```
一个试图给已关闭账户计入利息的智能体,会在任何东西运行之前从 `bhc check` 得到这个,而不是一个失败的测试,或者几周后的一份缺陷报告:
```text
Type errors:
1: type mismatch: expected `OpenAccount`, found `ClosedAccount`
```
没有人需要记住这条规则,因为程序根本无法表达对它的违反。这正是 [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/) 的押注,也是 [arcanist.sh](https://arcanist.sh/manifesto/) 存在的原因。
[bhc](https://arcanist.sh/bhc/),即 Basel Haskell Compiler,是同一门语言的一个从零开始的编译器,用 Rust 写成,它加入了两个想法,我认为它们让这成为一种不同的软件构建方式,而不只是一个更好的 Haskell。
第一个想法是,运行时是你选择的一份契约。同一份源码在某个配置档下编译:`default` 是照常的惰性求值,`server` 是带截止时间的结构化并发,`numeric` 是融合的、严格的数值代码和张量内核,`edge` 是一个极简的 WebAssembly 运行时。性能边界不再是口口相传的经验,而成为一个函数本身的一部分:不只是「这是正确的」,而是「这在这份契约下是正确的」。
第二个想法是[公共资源(the commons)](https://arcanist.sh/commons/)。今天,每一个智能体,在每一次会话里,都要重新编写和检查同一个日期解析器,然后把验证结果扔掉。bhc 把每一个定义展开为它的显式含义,类型类实例都被写明,而这个含义可以按其内容来寻址。于是一个定义带有一个身份,一份关于它已经被检查了什么、还没有被检查什么的精确记录,以及所有编译、测试、评审过它或为它担保的人的签名。两个人用不同风格写出同一个函数,就是写出了同一个函数,他们的证据汇集在同一个对象上。智能体的工作从「写这段代码」变成了「用已经检查过的含义把它组装出来,在什么都没有的地方,把它写出来、证明它,并把它留给下一个人」。[The Proof You Only Have to Write Once](https://raskell.io/articles/the-proof-you-only-have-to-write-once/) 是长版本。
这就是我所说的一种不同的软件构建方式:软件的单位不再是一个装满指令的文件,而是一份在明确契约下经过验证的含义,在所有需要它的人之间共享。
这也是离完成最远的部分。bhc 处于 0.2 版本。它能对 Pandoc 的全部 221 个模块做类型检查并编译,Pandoc 的 Markdown 读取器和 HTML 写入器能端到端地运行,但垃圾回收器还没有接入编译后的代码,所以长时间运行的服务器暂时还不适合([现状](https://arcanist.sh/bhc/status/))。公共资源是一个方向,路线图上有了最初几步,还不是一个你今天就能使用的服务。我之所以朝它构建,是因为我认为一旦大部分代码都是生成的,验证就必须走向那里,而 Haskell 是离这一点最近、最可能达到的语言。
## 显而易见的反对意见 {#the-obvious-objection}
反对这一切最有力的论点是:智能体最擅长的是训练数据最多的语言,所以你应该什么都用 Python 和 TypeScript 写,然后不再操心。
这话有一定道理,两门语言也都赢得了自己的位置。Python 统治着数据科学、机器学习和笔记本,在那里它的库无可匹敌,很多代码运行一次就被扔掉。JavaScript 是浏览器的语言,而 TypeScript 是写它而不至于后悔的方式;用别的语言写前端,通常是自讨苦吃。但凡是必须长久存在的东西,我很少再回到它们中的任何一个。我过去选用它们,是为了写得快、为了熟悉,而这些正是智能体如今吸收掉的成本;剩下的,是一个在生产环境里才发现类型错误的运行时。
一个模型写一门语言有多流利,和写出来的结果能保证什么,是两个不同的问题。流利度的差距比这个反对意见所设想的要小:MultiPL-E 把标准的代码生成基准测试翻译成了 18 种语言,发现一个模型在其中几种语言上的得分与它的 Python 得分持平甚至更高([Cassano et al., 2022](https://arxiv.org/abs/2208.08227))。保证上的差距也可以衡量:研究者给那些逃过了测试和评审的 JavaScript 缺陷加上类型注解后,TypeScript 标记出了其中的 15%([Gao, Bird and Barr, 2017](https://earlbarr.com/publications/typestudy.pdf))。无论模型写 Rust 和写 Python 的水平之间还剩下多少差距,那都是便宜那部分里的差距;而两个编译器所检查内容之间的差距,在昂贵的那部分里。
另一个公允的反对意见是,对一个组织来说,四门语言多了三门。对大多数公司而言确实如此,这也是为什么我不会把这份清单作为政策交给一家公司。一家公司应该只挑很少的几门语言,并给每一门一份工作。我的是这样的:
| 如果你构建的东西 | 选用 | 因为 |
|---|---|---|
| 绝不能出错、处在热路径上、处理恶意输入,或者要替换一个大型机核心系统 | Rust | 编译器排除了整类整类的故障,而且没有垃圾回收器 |
| 是许多团队都要阅读和修改的上百个服务之一 | Go | 只有一种地道写法,构建快,单一仓库无需发布库 |
| 天生分布式、实时、全渠道,或者是一个小团队的整个平台 | Elixir | 监督、分布式和持久化作业随运行时而来 |
| 需要它的正确性被检查、被共享、被在其上继续构建 | Haskell 加 bhc | 类型即证明,运行时契约,不断积累的验证 |
| 存在于笔记本、训练循环或浏览器里 | Python 或 TypeScript | 它们的库就在那里,别的都难以企及 |
## 人们转而会写什么 {#what-people-will-write-instead}
如果代码由智能体来写,人写什么?越来越多的是需求:一个系统必须做什么,哪些情形重要,什么绝不能发生,以及谁批准什么。这种写作在精确时是声明式的,不精确时是描述性的,但无论哪种,它说的都是什么应当为真,而不是如何达到那里。
本文每一段代码背后的那条利息规则,按我现在写需求的方式写出来,就是一个简短的 Markdown 文件:
```markdown
## Monthly interest
- Interest is posted on the last business day of each month.
- Monthly interest is balance × annual rate ÷ 12, in cents,
rounded half away from zero.
- A closed account never receives interest.
- Until the switch-over, the mainframe's result is the one that counts,
and every difference from the new core is recorded.
```
以及把它钉牢的那些用例,用 JSON 写:
```json
[
{ "case": "ordinary month", "account": { "status": "open", "balance": "1234.56" },
"annual_rate": "0.015", "expect": { "interest": "1.54" } },
{ "case": "closed account", "account": { "status": "closed", "balance": "1200.00" },
"annual_rate": "0.015", "expect": { "interest": "0.00" } }
]
```
上面四门语言里的一切,都在这两个文件的下游。
这种写作的格式,一是 Markdown,用于意图、决策和智能体阅读的指令(一份简报、一份设计记录、一个 `AGENTS.md`),二是 JSON,以及作为它更友好亲戚的 YAML 和 TOML,用于任何有结构的东西:一份模式、一份配置、两个系统之间的一份契约、一个测试所对照的用例(也就是 [Evaluation Closes the Loop](https://raskell.io/articles/evaluation-closes-the-loop/) 用来给智能体打分的那些已知用例)。两者都不是编程语言,而它们是我现在手工编辑最多的两种格式。这个网站就是一个例子:文字是 Markdown,数据是 TOML 和 JSON,而把它们变成页面的代码,大部分是智能体写的。
就连这也可能只是一个过渡阶段。Markdown 和 JSON 对人重要,是因为人还在读它们,而随着它们所描述的内容越来越多地由机器来检查,人的那部分会收缩为陈述意图和批准结果。一条精确到机器可以检查的需求,离一个类型已经不远了(这是 [Source Code Is the New Assembly](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/) 的论点),这也是我认为 Haskell 这个押注不只是押在代码的去向上、也是押在需求的去向上的又一个理由。
## 选择还剩下什么 {#what-is-left-of-the-choice}
当写代码的成本趋近于零,一门语言就不再是写作的工具,而成为关于没人亲手敲过的代码的一组承诺。按照智能体离开房间之后它仍然做出的承诺来选择它。
## 参考资料 {#references}
- Jeff Vander Stoep 和 Alex Rebert,[Eliminating Memory Safety Vulnerabilities at the Source](https://security.googleblog.com/2024/09/eliminating-memory-safety-vulnerabilities-Android.html),Google Security Blog,2024 年 9 月 25 日。
- Jeff Vander Stoep,[Rust in Android: move fast and fix things](https://security.googleblog.com/2025/11/rust-in-android-move-fast-fix-things.html),Google Security Blog,2025 年 11 月 13 日。
- Jesse Howarth,[Why Discord is switching from Go to Rust](https://discord.com/blog/why-discord-is-switching-from-go-to-rust),2020 年 2 月 4 日。
- [Go 1 and the Future of Go Programs](https://go.dev/doc/go1compat),Go 1 兼容性承诺。
- WhatsApp,[1 million is so 2011](https://blog.whatsapp.com/1-million-is-so-2011),2012 年 1 月 6 日。
- José Valim,[Elixir v1.20 released: now a gradually typed language](https://elixir-lang.org/blog/2026/06/03/elixir-v1-20-0-released),2026 年 6 月 3 日,以及 [Type inference of all constructs and the next 15 months](https://elixir-lang.org/blog/2026/01/09/type-inference-of-all-and-next-15/),2026 年 1 月 9 日。
- [Gleam](https://gleam.run/),一门面向 BEAM 的静态类型语言,以及 [Gleam version 1](https://gleam.run/news/gleam-version-1/),2024 年 3 月 4 日。
- [Tokio](https://tokio.rs/),Rust 的异步运行时,以及 [rust_decimal](https://docs.rs/rust_decimal/),用于金融计算的十进制数。
- [Oban](https://oban.hexdocs.pm/Oban.html),以数据库为后端的 Elixir 后台作业。
- arcanist.sh,[Manifesto](https://arcanist.sh/manifesto/)、[The Commons](https://arcanist.sh/commons/) 和 [The Scorecard Is Right. The Weights Are Wrong.](https://arcanist.sh/blog/the-scorecard-is-right-the-weights-are-wrong/)
- [bhc](https://arcanist.sh/bhc/) 和 [where bhc stands](https://arcanist.sh/bhc/status/),最后更新于 2026 年 10 月 20 日。
- Federico Cassano et al.,[MultiPL-E: A Scalable and Extensible Approach to Benchmarking Neural Code Generation](https://arxiv.org/abs/2208.08227),2022。
- Zheng Gao、Christian Bird 和 Earl T. Barr,[To Type or Not to Type: Quantifying Detectable Bugs in JavaScript](https://earlbarr.com/publications/typestudy.pdf),ICSE 2017。
- Niels Mündler、Jingxuan He、Hao Wang、Koushik Sen、Dawn Song 和 Martin Vechev,[Type-Constrained Code Generation with Language Models](https://arxiv.org/abs/2504.09246),2025。
### 延伸阅读 {#further-reading}
本站上那些支撑这篇文章的更长的论证:
- [The Last Programming Language Might Not Be for Humans](https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/),关于显式的、声明式的和后语言时代的几种未来,以及我为什么押注 Haskell。
- [What Comes After the Last Programming Language](https://raskell.io/articles/what-comes-after-the-last-programming-language/),关于底层的机器会变成什么。
- [Why We Built a Haskell Package Manager in Rust](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/),Rust 和 Haskell 在同一个项目里,各司其职。
- [The River and the Canal](https://raskell.io/articles/the-river-and-the-canal/),Aqueduct 和持久化执行背后的那篇文章。
- [How I Work These Days](https://raskell.io/articles/how-i-work-these-days/),与编程智能体一起工作在日常中是什么样子。
- [The Proof You Only Have to Write Once](https://raskell.io/articles/the-proof-you-only-have-to-write-once/),经过验证的 Haskell 的公共资源,完整版。
Rust 与内存安全:
- [Fearless Concurrency](https://doc.rust-lang.org/book/ch16-00-concurrency.html),*The Rust Programming Language* 中讲编译器在并发代码里排除了什么的那一章。
- [The Case for Memory Safe Roadmaps](https://www.cisa.gov/resources-tools/resources/case-memory-safe-roadmaps),CISA 及合作机构,2023 年 12 月 6 日,关于规划从内存不安全语言迁出。
- [What is memory safety and why does it matter?](https://www.memorysafety.org/docs/memory-safety/),ISRG 的 Prossimo 项目,一篇简短的入门。
- [Rust in the Linux kernel](https://docs.kernel.org/rust/index.html),内核自己的文档。
- Martin Fowler,[Strangler Fig Application](https://martinfowler.com/bliki/StranglerFigApplication.html),在遗留核心系统继续运行的同时逐块替换它的模式。
Go 与大规模软件工程:
- Rob Pike,[Go at Google: Language Design in the Service of Software Engineering](https://go.dev/talks/2012/splash.article),2012,说明 Go 为什么刻意保持朴素。关于本文论点,这是最好的单篇文本。
- [Effective Go](https://go.dev/doc/effective_go) 和 [Go Proverbs](https://go-proverbs.github.io/),地道在实践中意味着什么。
- [Go Modules Reference](https://go.dev/ref/mod),导入路径、版本和校验和如何运作。
BEAM、Elixir 与 Gleam:
- Joe Armstrong,[Making reliable distributed systems in the presence of software errors](https://erlang.org/download/armstrong_thesis_2003.pdf),博士论文,2003,监督者和「let it crash」(任其崩溃)背后的推理。
- [OTP Design Principles](https://www.erlang.org/doc/system/design_principles.html),Erlang 文档中关于监督树和行为模式的部分。
- Gary Rennie,[The Road to 2 Million Websocket Connections in Phoenix](https://www.phoenixframework.org/blog/the-road-to-2-million-websocket-connections),2015 年 11 月 3 日,一台 BEAM 机器能保持多少打开的连接。
- Giuseppe Castagna、Guillaume Duboc 和 José Valim,[The Design Principles of the Elixir Type System](https://arxiv.org/abs/2306.06391),2023,以及 Elixir 关于[渐进集合论类型](https://hexdocs.pm/elixir/gradual-set-theoretic-types.html)的指南。
- [The Gleam language tour](https://tour.gleam.run/),看清 BEAM 上的带类型代码是什么样子的最快途径。
类型即证明,以及不断积累的验证:
- Philip Wadler,[Propositions as Types](https://homepages.inf.ed.ac.uk/wadler/papers/propositions-as-types/propositions-as-types.pdf),程序与证明之间的对应关系,Haskell 这个押注就建立在它之上。
- Alexis King,[Parse, don't validate](https://lexi-lambda.github.io/blog/2019/11/05/parse-don-t-validate/),2019,如何在日常代码中把不变量放进类型。
- Yaron Minsky,[Effective ML Revisited](https://blog.janestreet.com/effective-ml-revisited/),Jane Street,「让非法状态无法表示」(make illegal states unrepresentable)这句话的出处。
- [Unison](https://www.unison-lang.org/),引入了内容寻址代码的语言,以及 arcanist.sh 的 [Building the Commons](https://arcanist.sh/blog/building-the-commons/),讲把它带到 Haskell 背后的工程。
================================================================================
---
title: "构建 IT Intelligence:一个仓库里的参考实现"
url: https://raskell.io/zh/articles/building-it-intelligence/
author: Raffael Schneider
date: 2026-11-16
description: "如何用开源组件搭建一个 Enterprise Context Platform(企业上下文平台):本体、连接器、工作流、存储、API、MCP 和界面,全部放在一个你可以运行的仓库里。"
tags: [enterprise-architecture, context-engineering, agents, provenance, oss, durable-execution, knowledge-management]
lang: zh-Hans
translation_of: https://raskell.io/articles/building-it-intelligence/
---
# 构建 IT Intelligence:一个仓库里的参考实现
## 简而言之
这是我上一篇文章里那个 IT Intelligence 平台的参考实现,放在一个开源仓库里,里面住着一家刻意弄得杂乱的虚构公司:Kestrel Group。 本体先行,其余一切都由它生成或以它为准做校验;来自数据源的观测,与模型从中得出的实体分开保存。 每一条关系都是一行记录,带着依据、置信度和来源;身份解析从共享键到规则再到模型推断逐层进行,不确定的链接排进队列,等待所属团队确认。 一个独立于 API 的工作流编排器负责数据摄取,支持重试和断点续跑;数据源的评分公开可见;API 同时提供 REST 和一个 MCP 服务器,后者给出的回答以实体为中心、篇幅很小,并且总是带着出处。 层次的顺序比工具更重要;数据库、工作流引擎、前端和模型提供方都是可以日后再议的选择,而一套测试会对照运行中的系统检查这篇文章里的说法。
在 [IT Intelligence](https://raskell.io/articles/it-intelligence/) 一文里我提出,大公司为自己的销售数字建起来的东西,从来没有为自己的 IT 建过:一个模型,知道有哪些东西存在、归谁所有、彼此如何相连、是否符合战略,并且每一个为它工作的人和智能体都能读懂。接下来那个显而易见的问题很公道:真要把它建出来,是什么样子?
这篇文章就是回答,在不展示任何真实系统版图的前提下,我尽量写得具体。它会带你走一遍一个参考实现,全部放在一个开源仓库 [raskell-io/it-intelligence](https://github.com/raskell-io/it-intelligence) 里,里面有一家虚构的公司。你可以克隆它,在笔记本电脑上运行它,把一个编程智能体接到它上面,并看到第一篇文章描述过的每一层:连接器、工作流编排、持久化存储、Context Model 本身、带 MCP 服务器的 API 后端、前端,以及把模型变成产出物的分析。
这个参考实现比我在工作中运行的那个平台更小、更简单,也更平淡无奇,但它的形态是一样的,而我想展示的正是形态。
## 虚构的公司 {#the-fictional-company}
下面的每个例子都用 **Kestrel Group**:一家虚构的金融集团,有三个市场单元、大约四十个应用、十几个团队、两个容器集群、一个 WAF、一个 API 网关,以及常见的那一堆记录系统。仓库以种子文件的形式提供 Kestrel,这些文件模仿你从真实工具里导出的东西:企业架构仓库里的应用清单,IT 服务管理工具里的配置项和事件单,代码托管平台上的仓库和团队,集群里的命名空间和工作负载,WAF 里的策略,网关里的路由。
种子数据是刻意弄乱的。不同系统里的名字各不相同,两个应用声称拥有同一个仓库,一个命名空间没有所有者标签,一个市场单元运行着自己的集成平台而集团 IT 里没人知道,企业架构仓库里还列着一个一年前就已下线的应用。一个干净的演示什么也证明不了,因为 IT Intelligence 的价值,恰恰体现在数据源彼此矛盾的地方。
## 系统的形态 {#the-shape-of-the-system}
*it-intelligence, the reference implementation*
```text
┌────────────────────────┐
│ seed/ or real sources │
└────────────┬───────────┘
▼
┌────────────────────────┐
│ connectors (Go) │
└────────────┬───────────┘
▼
┌────────────────────────┐ ┌──────────────────────┐
│ workflow orchestrator: │ ──▶ │ PostgreSQL: │
│ extract, judge, │ │ observations, │
│ build, score │ │ entities, edges, │
└────────────┬───────────┘ │ scorecards, │
│ LLM calls │ artifacts │
▼ └──────────┬───────────┘
┌────────────────────────┐ │
│ resolver (pluggable │ │
│ model provider) │ │
└────────────────────────┘ ▼
┌──────────────────┐ ┌──────────────────────────┐
│ web (Next.js) │ ◀──▶ │ API (Go): REST, MCP, │
└──────────────────┘ │ artifacts; starts runs │
└─────┬──────────────┬─────┘
▲ ▲
coding agents (MCP) other systems (REST)
ontology/ (LinkML) ──▶ generated types, store vocabulary, JSON Schema, OWL
```
六个活动部件,外加一个凌驾于它们之上的文件。我会按照你构建它们的顺序逐一讲解,这和数据流经它们的顺序并不相同。本体排在最前,因为其余一切要么由它生成,要么以它为准做校验。
## 仓库 {#the-repository}
```text
it-intelligence/
ontology/ context_model.yaml, entities.yaml, relations.yaml: the Context Model in LinkML
generated/ JSON Schema, OWL, SHACL, the store vocabulary (do not edit)
cmd/itx/ the one binary: serve, worker, ingest, verify, runs, snapshot
connectors/ one package per source kind: earepo/ itsm/ githost/ cluster/ waf/ gateway/
mapping/ observations to candidate entities and edges, one mapper per connector
resolver/ identity resolution: keys, rules, inference, pluggable model providers
workflows/ the workflows, and runner/, the minimal orchestrator that runs them
store/ PostgreSQL migrations and the generated vocabulary
api/ REST, MCP and the queries both share
artifacts/ Mermaid diagrams and insights
web/ Next.js frontend
config/ sources, resolver thresholds and rules, people, the verify baseline
seed/ the Kestrel Group as source-shaped exports, plus an answer key
deploy/ docker compose for a laptop, a Helm chart for a cluster
docs/ architecture, decision records, adding a source
.mcp.json lets a coding agent in this repo use the MCP server
Makefile
```
这里选择单一仓库,理由很平淡:本体会变,而它一变,存储、映射器、API、MCP 工具和前端类型都得跟着变。在一个仓库里,这是一个拉取请求、一次评审、一次 CI 运行。分散在五个仓库里,它就成了一个协调问题,而这正是这个平台本来要消除的那类问题。
技术栈从头到尾都是开源的,选它们是因为它们不会带来意外:
| 关注点 | 参考实现中的选择 | 原因 | 合理的替代方案 |
|---|---|---|---|
| 本体 | [LinkML](https://linkml.io/) | 一份 YAML 模式,生成多种产物,并通向 RDF 和 OWL | 直接用 OWL 加 SHACL,或只用 JSON Schema |
| 持久化 | PostgreSQL | 人人都能运行,递归查询覆盖了大部分图需求 | PostgreSQL 上的 Apache AGE,专用图数据库 |
| 编排 | 一个持久化工作流编排器,作为独立于 API 的组件;参考实现自带一个基于 PostgreSQL 的最小编排器 | 重试、断点续跑、调度以及等待人来处理的长时间等待属于平台,而不属于每一个请求 | [Temporal](https://temporal.io/),[Restate](https://restate.dev/),[Aqueduct](https://github.com/raskell-io/aqueduct),或类似的引擎 |
| 后端 | Go | 一个静态二进制 `itx`,既作为 API 运行(`itx serve`),也作为工作流 worker 运行(`itx worker`) | 任何有 MCP SDK 的语言 |
| 智能体接口 | [Model Context Protocol](https://modelcontextprotocol.io/) | 编程智能体本来就会说的语言 | 带 OpenAPI 描述的 REST |
| 前端 | Next.js | 能很快做出实体页面、图视图和评审队列 | 任何 Web 框架 |
| 图表 | 文本形式的 [Mermaid](https://mermaid.js.org/) | 可做差异比对,能在代码托管平台、维基和聊天工具里渲染 | Structurizr DSL,PlantUML |
换掉其中任何一个,设计都不会改变。换不掉的,是各层的顺序以及每一层遵循的规则。
### 为什么用 Go {#why-go}
有一个选择值得多说几句,而不只是表格里的一行,因为几乎任何一个大公司要运行十年的平台,我都会再这样选一次:后端用 Go 来写。
企业里的代码被阅读的次数远多于被编写的次数,读它的人往往不是写它的人,常常是在多年以后,而且带着一些压力。Go 正是为这样的读者而设计的。做一件事通常只有一种地道的写法,`gofmt` 决定了排版,所以一个团队写的代码和另一个大洲上的外包人员写的代码看起来一模一样。一切都是显式的、有类型的:错误是值,在发生的地方处理;依赖是传进来的,而不是由框架注入;也没有一层层的继承体系要先爬完,才能找到真正干活的那一行。企业级 Java 出了名的那套机制,这门语言大多根本不提供,所以工厂的工厂永远不会被写出来。一位新同事,或者一个编程智能体,可以打开 `resolver/`,不用向导就能顺着读下去。
依赖按它们所在的位置命名。导入路径就是模块路径,对大多数模块来说,那就是一个 Git 仓库的地址;模块文件锁定版本,校验和文件守护着它们:
```go
// go.mod (trimmed)
module github.com/raskell-io/it-intelligence
require (
github.com/jackc/pgx/v5 v5.12.0
github.com/modelcontextprotocol/go-sdk v1.8.0
)
```
在模块内部,包按路径互相导入,并从源码编译。正是这一点让单一仓库的成本很低:映射器、解析器、REST API 和 MCP 服务器共用生成的 `vocab` 包,没有人需要发布一个内部库、给它打版本、再等它进入制品仓库。改动本体,重新生成,`go build ./...` 几秒之内就会告诉你所有坏掉的地方。
它快在两处。整个仓库连同依赖做一次干净构建,在我的笔记本电脑上大约需要二十秒,改动之后的重新构建不到两秒,所以反馈回路一直很短;而构建的结果是一个静态二进制,启动即用,处理请求时占用的内存很少,这正是 API 和 worker 都需要的。工具链是自带的:`go test`、`go vet`、竞态检测器、用于性能剖析的 `pprof`,以及适用于各种编辑器的 `gopls`,没有什么需要挑选或配置。而且 [Go 1 兼容性承诺](https://go.dev/doc/go1compat) 意味着今天写的代码十年后依然能构建,而这正是企业软件真正存活的时间尺度。
Go 也有它的代价。`if err != nil` 写多了会显得重复;类型系统没有和类型(sum type),所以本体的一部分精确性只能落在校验里,而不是类型里;泛型来得晚,而且刻意做得很克制。前端我用 TypeScript,因为生态在那里。但对于平台中那个必须正确、平淡、并且下一个人读得懂的部分,我不知道还有什么更合适的选择。
## 第一层:本体 {#layer-one-the-ontology}
Context Model 就是本体,它放在 `ontology/` 里:`context_model.yaml`,以及它导入的两个文件 `entities.yaml` 和 `relations.yaml`。我用 LinkML,是因为它让模型只需用可读的 YAML 写一次,然后生成系统各部分所需的形式:用于校验的 [JSON Schema](https://json-schema.org/),存储的词汇表(实体种类和关系种类的表,以及一个拒绝任何超出定义域和值域的边的触发器),供想用语义网工具对它做推理的人使用的 [OWL](https://www.w3.org/TR/owl2-overview/) 和 [SHACL](https://www.w3.org/TR/shacl/),Python 和 TypeScript 模型,以及人能读的文档。Go 类型则由 JSON Schema 生成。
Kestrel 模型的精简版:
```yaml
# ontology/entities.yaml (trimmed)
classes:
Entity:
abstract: true
slots: [id, name, standing, last_seen]
Application:
is_a: Entity
description: A thing the business recognises as one system, however many parts it has.
Repository:
is_a: Entity
Workload:
is_a: Entity
Namespace:
is_a: Entity
Team:
is_a: Entity
Capability:
is_a: Entity
description: A business capability from the enterprise architecture capability map.
Endpoint:
is_a: Entity
Decision:
is_a: Entity
description: An architecture decision record, with the entities it constrains.
MarketUnit:
is_a: Entity
enums:
Standing:
permissible_values:
secondary: {description: mirrored from an authoritative system}
primary: {description: the Context Model is authoritative}
```
关系是一套由槽构成的封闭词汇。LinkML 每个槽只允许一个定义域,所以当一种关系可以从几种实体出发时,就由注解为生成存储词汇表的那个生成器携带完整的定义域和值域:
```yaml
# ontology/relations.yaml (trimmed)
slots:
deployed_as:
description: The application runs as this workload.
domain: Application
range: Workload
multivalued: true
annotations: {ctx_domain: Application, ctx_range: Workload, ctx_cardinality: many}
runs_in:
description: The workload runs in this namespace.
domain: Workload
range: Namespace
annotations: {ctx_domain: Workload, ctx_range: Namespace, ctx_cardinality: one}
owned_by:
description: The accountable team.
range: Team
annotations: {ctx_domain: "Application Repository Workload Namespace Endpoint", ctx_range: Team, ctx_cardinality: one}
```
构建它的过程中得出了四条建模规则,它们比语法更重要。
**核心要小。** Kestrel 有九种实体和正好十五种关系。每一个新种类都必须用它能让人回答的某个问题来证明自己存在的必要。正如我在第一篇文章里写的,失败模式是本体无序膨胀,而防线是一份一个人能在白板上讲清楚的模式。
**把实体和观测分开。** 观测是某个数据源在某个时间点说过的话:导出文件里的一行,API 返回的一个 JSON 对象。实体是 Context Model 综合所有观测得出的结论。把两者混在一起,目录就会变成数据源的副本,连同它们所有的矛盾。
**让关系成为一等公民。** 在本体里,关系是一个槽。在存储里,每一条关系都成为单独的一行,带着依据、置信度、来源和「最后一次见到」的时间。只有这样才能回答「模型为什么这么认为?」,而这个问题决定了是否有人信任它。
**能力地图取自企业架构,而不是平台团队。** `Capability` 由集团自己的能力模型填充。正是这一个决定,让「哪些系统在每个市场单元里支撑理赔处理」这样的问题成为一次查询,战略也正是由此进入模型的。
`make ontology` 会重新生成 `ontology/generated/` 里的一切,生成文件过期时 CI 会失败。本体就是代码,像代码一样接受评审。
## 第二层:存储 {#layer-two-the-store}
PostgreSQL 存放五样东西:观测、实体、边、记分卡和产出物。它们周围还有几张辅助表:别名(每个数据源对某个实体使用的名字),数据集登记表,一份记录每一次确认和声明的只追加日志,录制下来的模型判断,快照,以及工作流运行的状态。核心部分短到可以展示出来:
```sql
-- store/schema.sql (trimmed)
create table observation (
id bigserial primary key,
source text not null, -- 'earepo', 'cluster', ...
dataset text not null, -- 'applications', 'workloads', ...
external_id text not null, -- the id inside the source
payload jsonb not null,
observed_at timestamptz not null
);
create table entity (
id text primary key, -- 'ctx:Application/policy-admin'
kind text not null,
name text not null,
standing text not null default 'secondary',
attributes jsonb not null default '{}',
last_seen timestamptz not null
);
create table edge (
id text primary key, -- a stable hash of kind, endpoints and source
kind text not null references relation_kind(kind),
from_id text not null references entity(id),
to_id text not null references entity(id),
basis text not null, -- 'asserted' | 'derived' | 'inferred'
confidence double precision not null,
status text not null, -- 'active' | 'pending' | 'rejected'
source text not null,
evidence jsonb not null default '{}',
confirmed_by text,
confirmed_at timestamptz,
last_seen timestamptz,
unique (kind, from_id, to_id, source)
);
```
观测只追加。任何东西都不会被覆盖,所以模型总能根据数据源说过的话重建,每一条边也都能通过它的 `evidence` 指回产生它的那些观测。
`basis` 这一列承载着第一篇文章里的那个区分。**asserted**(断言)边直接来自数据源自己的键:集群说这个工作负载运行在那个命名空间里。**derived**(推导)边由规则从其他边得出:工作负载运行在某个团队所有的命名空间里,所以除非另有说明,这个团队就拥有这个工作负载。**inferred**(推断)边由解析器提出,通常借助模型,带着置信度和背后的理由。当一个团队确认了一条推断边,`confirmed_by` 和 `confirmed_at` 就会被填上,这条边变成断言边,上面写着一个人的名字。表上的一个触发器会对照由本体生成的词汇表检查每一条边,所以存储里不可能存放模型不允许的关系。
这些都不需要一个出处标准就能运作,但它与一个现成的标准对得上。用 W3C [PROV-O](https://www.w3.org/TR/prov-o/) 的术语来说,一条边是一个实体(entity),它派生自其 `evidence` 里的那些观测,并归属于它的 `source`,或者在确认之后归属于某个人。参考实现不导出 PROV,也还没有记录是哪一次摄取运行产生了某条边,也就是 PROV 术语中的活动(activity);如果另一个工具需要这条谱系,这两处就是起点。
为什么用 PostgreSQL 而不是图数据库?因为架构师和智能体问的大部分问题,都在离某个实体一两跳的范围之内,其余的是有界遍历,递归查询处理得很好。经典的「我改了这个会坏掉什么」问题:
```sql
-- everything that depends on payment-gateway, up to four hops away
with recursive impact(id, depth) as (
select 'ctx:Application/payment-gateway'::text, 0
union
select e.from_id, i.depth + 1
from edge e
join impact i on e.to_id = i.id
where e.kind = 'depends_on' and i.depth < 4
)
select id, min(depth) as distance
from impact
where depth > 0
group by id
order by distance, id;
```
如果图增长到这种方式难以从容应对的规模,[Apache AGE](https://age.apache.org/) 可以在同一个 PostgreSQL 实例上加入 openCypher 查询,而专用图数据库则是之后另行做出的决定。从每个团队都已经会运维的数据库起步,比第一天就追求图查询语言的优雅更有价值。
## 第三层:连接器与映射 {#layer-three-connectors-and-mapping}
连接器只做一件事:读取一个数据源,产出观测。它对本体一无所知。
```go
// connectors/connector.go
type Observation struct {
Source string
Dataset string
ExternalID string
Payload json.RawMessage
ObservedAt time.Time
}
type Connector interface {
Name() string
Datasets() []string
Extract(ctx context.Context, dataset string, since time.Time) iter.Seq2[Observation, error]
}
```
映射是单独的一步,每个连接器配一个映射器,它把观测变成**断言**:候选实体和候选边,每一个都标记着它来自哪条观测。种类和关系的常量来自一个由本体生成的 `vocab` 包,所以映射器无法凭空发明一种关系。
```go
// mapping/mappers.go, the cluster mapper (trimmed)
func (clusterMapper) Map(ctx Context, o connectors.Observation) (Assertions, error) {
a := start(o)
var k k8sObject
if err := decode(o, &k); err != nil {
return a, err
}
if o.Dataset == "workloads" {
wl := a.Entity(vocab.Workload, k.Metadata.Namespace+"/"+k.Metadata.Name, k.Metadata.Name, nil)
a.Edge(vocab.RunsIn, wl, Key(vocab.Namespace, k.Metadata.Namespace), Asserted)
// The cheapest win in the whole system: a label carrying the EA application id
// turns an inference into an assertion.
if app := k.Metadata.Labels[ctx.Config.ApplicationLabel]; app != "" {
a.Edge(vocab.DeployedAs, Alias(vocab.Application, "earepo:applications", app), wl, Asserted)
}
}
return a, nil
}
```
这样拆分让连接器可以复用,因为同一个代码托管平台连接器适用于任何公司;公司特有的知识则留在映射器里,在那里可以被评审。这也意味着连接器可以由拥有该数据源的团队来写,贡献正是这样开始的。在参考实现里,加一个数据源只需要三个文件:一个连接器,一个映射器,和一份用来测试的种子导出。
对标签的检查不只关乎这一个映射器:每个在自己的部署里加上企业架构应用 ID 的团队,都会把模型的一次推断变成一条断言,第二天早上记分卡就会体现出这份改进。
## 第四层:身份解析 {#layer-four-identity-resolution}
映射会为同一个东西产生许多候选。企业架构仓库写的是「Policy Administration」,代码托管平台上有 `pol-adm-svc` 和 `pol-adm-ui`,集群在命名空间 `claims-prod` 里运行着 `policy-admin`,IT 服务管理工具里有一个叫「PAS」的业务服务。解析要决定其中哪些是同一个实体。
它分三轮进行,从便宜而确定到昂贵而不确定:
1. **键。** 跨数据源共享的标识符,比如部署标签里的应用 ID,或者仓库元数据文件里的 CMDB 引用,产生断言链接。
2. **规则。** 精度已知的确定性启发式规则:规范化之后完全相同的名字,一个所属团队恰好只拥有一个应用的仓库,命名空间的命名约定。它们产生推导链接。
3. **推断。** 剩下的交给模型。每个候选项会得到一份最多五个应用的简短清单,先是其所属团队的应用,然后是名字最相近的应用;模型看到候选项的名字、README 摘录或描述、所有者和命名空间,然后返回一个结构化的判断。
```json
{
"candidate": "githost:repo/kestrel/pol-adm-ui",
"match": "ctx:Application/policy-admin",
"confidence": 0.82,
"reasons": [
"README describes the policy administration frontend",
"same owning team as pol-adm-svc, already linked by key",
"deploys to claims-prod next to policy-admin"
]
}
```
「PAS」,也就是 IT 服务管理工具里的那个业务服务,也以同样的方式解析:模型以 0.93 的置信度把它链接到 Policy Administration,因为 PAS 是常用的缩写,它的支持组拥有这个应用,而它的事件单文本里提到了 `pol-adm-svc`。
阈值是明确的,写在配置里。高于 0.9,链接作为推断链接存储并正常显示。介于 0.6 和 0.9 之间,链接作为推断链接存储,并排进队列等待所属团队确认。低于 0.6 则丢弃并记录日志。推断链接永远不会被悄悄提升为断言链接;那需要一个人来做。模型提供方是可插拔的。默认情况下,参考实现回放录制好的判断,所以它可以离线运行,不需要 API 密钥,每次都给出同样的答案;在 `config/resolver.yaml` 里改一行,就能切换到本地模型或托管模型,效果很好,因为输入是元数据,提示词也很小。
这是一个老问题。统计学家称之为记录链接(record linkage),Ivan Fellegi 和 Alan Sunter 在 1969 年为它给出了一套形式化理论:两个阈值把候选对分成链接、非链接,以及交给人来复核的可能链接。上面的三个区间是同一个思路,只是在他们的理论使用匹配权重的地方,换成了模型的判断。如果你的数据源存有数以百万计的记录,而不是几百个应用,可以看看 [Splink](https://moj-analytical-services.github.io/splink/),这是英国司法部(UK Ministry of Justice)对这种概率方法的开源实现。
## 第五层:工作流 {#layer-five-workflows}
数据摄取要和不稳定的数据源打交道,还要调用会超时的模型,所以它需要每一步单独重试、崩溃之后能接着运行、调度,以及一个可以查看发生了什么的地方。而且这里的事情并不都很快:一条链接要等团队确认,一次 primary 声明要等第二个人批准,两者都可能搁置好几天,其间也许有人在休假,提醒则通过邮件发出。这些工作不属于 API。所以工作流编排是一个独立的组件:API 是控制面,它启动运行并报告运行情况,但从不亲自执行,执行由编排器来做。
在生产环境里,这个编排器是一个持久化工作流引擎,Temporal、Restate 或类似的东西;设计并不取决于选哪一个。
其中一个候选是我自己的:[Aqueduct](https://github.com/raskell-io/aqueduct),一个用 Rust 写的持久化执行引擎,为智能体编写、人来批准的流程而建。它在每一步被计入之前先把它写进日志,带超时地等待一个人(通过一个信号,或一个任何人都能完成的 id;如果没人回应,就上报给另一个人),并通过 gRPC 或 HTTP 在任何语言写的 worker 上运行步骤,所以这里的步骤可以继续用 Go 写。它还很年轻,它自己的 README 也请大家暂时不要依赖它,所以我把它列为一个选项,而不是默认选择。
参考实现自带一个基于 PostgreSQL 的最小编排器,遵循同样的契约,作为一个单独的进程 `itx worker` 运行,所以它在笔记本电脑上就能跑,不需要另装任何东西。一个工作流是一串固定的、幂等的步骤:
```go
// workflows/workflows.go (trimmed)
modelSteps := []runner.Step{
{Name: "Judge", Run: d.judge, Timeout: 30 * time.Minute},
{Name: "Build", Run: d.build, Timeout: 10 * time.Minute},
{Name: "Score", Run: d.score, Timeout: 10 * time.Minute},
}
return []runner.Workflow{
{Name: "IngestSource", Steps: append([]runner.Step{extract}, modelSteps...)},
{Name: "IngestAll", Steps: all},
{Name: "ConfirmLink", Steps: []runner.Step{applyLink, build, score}},
{Name: "DeclarePrimary", Steps: []runner.Step{applyPrimary, build}},
{Name: "BuildArtifacts", Steps: artifactSteps},
}
```
运行和步骤尝试存放在两张表里。worker 用 `select ... for update skip locked` 认领一次运行,并持续发送心跳,所以几个 worker 可以并排运行,被崩溃进程丢下的运行会由另一个 worker 接手。一次运行从第一个没有成功的步骤处继续,重试带抖动地退避,步骤之间只传递运行 id:一个步骤产出的任何东西都写进 PostgreSQL。因为 API 和 worker 是分开的进程,它们可以分别扩展,一次缓慢的摄取永远不会拖住智能体的查询。
| 工作流 | 触发方式 | 步骤 |
|---|---|---|
| `IngestSource` | 数据源自己的时间间隔,或按需触发 | Extract、Judge、Build、Score |
| `IngestAll` | `make ingest` | 对每个数据源执行 Extract,然后是 Judge、Build、Score 以及产出物的各个步骤 |
| `ConfirmLink` | 团队在界面里确认或拒绝 | Apply、Build、Score |
| `DeclarePrimary` | 数据集所有者发起请求,由第二个人批准 | Apply、Build |
| `BuildArtifacts` | 每晚一次,以及 `IngestAll` 结束时 | Snapshot、Diagrams、Insights |
每一次运行都会显示在 `/runs` 上,连同它的步骤、尝试、错误和耗时。这一点比听起来更重要:当某个数据源的记分卡下滑时,第一个问题就是上一次摄取期间发生了什么,而答案只需点一下。最小编排器做不到的,是在工作流内部等一个人好几天、发送提醒,或者扇出成成千上万个并行任务。因此在参考实现里,`ConfirmLink` 和 `DeclarePrimary` 只在人已经作答之后才启动。持久化引擎会把这段等待移进工作流本身,这是它带来的第一样东西;而换上它是机械性的工作:这些步骤已经具备 activity 的形态,API 也从来只是启动运行、读取运行状态。
## 第六层:评分 {#layer-six-scoring}
`Score` activity 在每次摄取时,为每个数据源和数据集计算一张记分卡:
| 信号 | 计算方式 |
|---|---|
| 新鲜度 | 在数据源预期周期内被修改或确认过的记录所占比例 |
| 完整度 | 具备映射器所需全部字段的记录所占比例 |
| 一致度 | 至少有另一个数据源确认的事实所占比例,所以只有一个数据源持有的事实会拉低它的分数 |
| 可解析度 | 身份和引用全部能解析到 Context Model 实体的记录所占比例 |
总分是加权平均,权重写在配置里,每个数字都链接到背后的记录。在种子数据上完成一次摄取之后,企业架构仓库的应用得分 0.58,能力得分 0.45,集群的命名空间得分 0.75,IT 服务管理工具的业务服务得分 0.99。分数带来两个结果。每一条断言事实的初始置信度是 0.7 加上 0.3 乘以其数据源最近一次的总分,所以一个维护良好的数据源给出的事实,排在一个被忽视的数据源给出的同样说法之前;推导出的事实则继承其链条中最弱的那个置信度。而且记分卡是公开的,放在每个团队都能看到的页面上,这让数据质量从一条审计发现,变得更像一张联赛积分榜。
## 第七层:API 与 MCP 服务器 {#layer-seven-the-api-and-the-mcp-server}
API 进程 `itx serve` 用同一套查询提供三个出口:供系统和前端使用的 REST API,供智能体使用的 MCP 服务器,以及一个提供已生成产出物的静态端点。把它们放在一个进程里是有意为之。一个智能体和一个人看同一个实体时,必须看到同样的事实,而保证这一点最简单的办法,就是不要有两套实现。
大部分设计精力都花在了 MCP 服务器上,因为给智能体用的工具是一种接口,它的规则和给程序用的 API 不同。Kestrel 的服务器提供了少数几个:
| 工具 | 输入 | 返回 |
|---|---|---|
| `search_entities` | 文本,可选的种类 | 匹配的实体,附带 id、种类和一行摘要 |
| `get_entity` | id | 实体本身、它的属性、它的地位和它的直接边 |
| `find_owner` | id 或自由文本名称 | 所属团队、所有权是如何确立的,以及置信度 |
| `impact_of_change` | id,深度 | 给定深度内的依赖方,按距离分组 |
| `explain_fact` | 边 id | 一条边背后的证据:数据源、观测、依据、谁确认了它 |
| `list_decisions` | id | 约束该实体的架构决策 |
| `render_diagram` | id,视图 | 该实体周边的一张 Mermaid 图 |
塑造它们的有三条规则。**工具以实体为中心**,因为比起通用查询语言,智能体从「把这个东西和它周围的东西给我」出发推理得更好。**每个回答都带着出处**,这样智能体可以引用事实的来源,人也可以去核查。**回答要小**,给出智能体可以继续追问的 id,而不是整张子图,因为这个平台的意义在于替智能体省 token,而不是把它的上下文窗口淹没。经济上的理由我在 [The Economics of Inference](https://raskell.io/articles/the-economics-of-inference/) 里讲过,工具设计上的理由则在 [Tools: How Agents Actually Do Things](https://raskell.io/articles/tools-how-agents-actually-do-things/) 里。
被问到 *「claims-prod 归谁所有,什么依赖它?」* 时,仓库里的智能体会调用 `find_owner`,并在第一次摄取之后得到这样的结果:
```text
find_owner {"id": "claims-prod"}
owner: ctx:Team/claims-platform, derived, 0.92
path: ctx:Namespace/claims-prod <- runs_in - ctx:Workload/claims-prod/claims-settlement (asserted, cluster)
ctx:Workload/claims-prod/claims-settlement <- deployed_as - ctx:Application/claims-settlement (asserted, cluster)
ctx:Application/claims-settlement - owned_by -> ctx:Team/claims-platform (asserted, itsm)
```
这个命名空间没有所有者标签,所以所有权是推导出来的,回答也如实说明了这一点。有三个理赔应用运行在 `claims-prod` 里,全都指向同一个团队;最强的那条链胜出,智能体可以引用它所依据的每一个事实。团队下一步该做什么,从回答里一目了然:在命名空间上加一个所有者标签,就能把推导变成断言。
为了让编程智能体能用上它,仓库里带着一份项目范围的 MCP 配置。在 Claude Code 里,那就是仓库根目录下的一个 `.mcp.json`:
```json
{
"mcpServers": {
"it-intelligence": {
"type": "http",
"url": "http://localhost:8080/mcp"
}
}
}
```
在公司里,同样的条目指向共享实例,并写进每个新仓库起步所用的模板。从那以后,每台笔记本电脑上的每个编程智能体,都能在针对某个服务写代码之前先问一句它归谁所有。
## 第八层:前端 {#layer-eight-the-frontend}
Next.js 前端在技术上是最无趣的一层,却决定了人们会不会再回来。它有五个视图:
- **实体页面**,每个实体一页,展示属性、按种类分组的边、悬停时显示的出处,以及一个在事实过时后变成琥珀色的「最后一次见到」。
- **图视图**,展示任意实体的周边,可按关系种类和深度筛选。
- **评审队列**,每个团队一个,列出等待确认的推断链接,每条旁边附着模型给出的理由。
- **数据源记分卡**,也就是第六层的那张联赛积分榜。
- **产出物**,`BuildArtifacts` 生成的一切,每一件都标注着它所依据的快照。
TypeScript 类型来自本体,所以模型一变,前端就编译不过,直到它跟上为止。这是正确的那种摩擦。
## 第九层:产出物 {#layer-nine-artifacts}
产出物是上下文模型开始在查询之外证明自身价值的地方。`BuildArtifacts` 工作流给模型拍一张快照,然后在上面运行生成器。每一件产出物都记录着它来自哪个快照,这样它可以被复现,读者也知道它有多新。
**文本形式的图表。** 一个生成器遍历某个实体的周边,写出 Mermaid。对 Kestrel 的保单管理应用,输出是:
```text
flowchart LR
app_policy_admin["Policy Administration
owner: claims-platform"]
repo_svc["repo: pol-adm-svc"]
repo_ui["repo: pol-adm-ui"]
wl["workload: policy-admin
ns: claims-prod"]
ep["endpoint: api.kestrel.example/policies
WAF: enforced"]
cap["capability: Policy Management"]
pay["Payment Gateway"]
app_policy_admin -->|realised_by| repo_svc
app_policy_admin -.->|realised_by, inferred 0.82| repo_ui
app_policy_admin -->|deployed_as| wl
app_policy_admin -->|exposed_via| ep
app_policy_admin -->|supports| cap
app_policy_admin -->|depends_on| pay
```
推断边画成虚线,并标注置信度,所以图对自己知道什么是诚实的。因为它是文本,它能在代码托管平台、维基和聊天工具里渲染,还能在快照之间做差异比对,展示一个季度里系统版图发生了哪些变化。
**洞察。** 每条洞察都是一个带名字、描述和阈值的查询,在每个快照上运行。Kestrel 自带几条,在任何真实公司里往往都能找出点什么:
```sql
-- applications in production with no accountable owner
select a.id, a.name
from entity a
where a.kind = 'Application'
and a.attributes->>'lifecycle' = 'production'
and not exists (
select 1 from edge e
where e.from_id = a.id and e.kind = 'owned_by'
and e.confidence >= 0.8
);
```
其他洞察会找出:在每个市场单元里由不止一个平台支撑的能力(合并的候选),没有 WAF 策略却暴露在互联网上的端点,企业架构生命周期标为「已退役」却仍有工作负载在运行的应用,以及根据提交历史算出卡车因子为一的仓库。每条发现都链接到涉及的实体,所以它是一场对话的起点,而不是一份被归档了事的报告。
**草稿**是下一步,目前还没有实现:一组生成器,用来写解决方案设计中的现状章节、预先填好的架构决策记录或一份简短的商业论证,每一份都必须为每个论断引用某个实体或某条边。这条引用规则,就是对付我在第一篇文章里称为「对产出物的过度信任」的那道防线。
## 运行它 {#running-it}
你需要 Docker,不需要 API 密钥。
```sh
git clone https://github.com/raskell-io/it-intelligence
cd it-intelligence
make up # PostgreSQL, the API, the workflow worker and the web UI
make seed # register the Kestrel Group sources
make ingest # extract, judge, build, score, and build the artifacts
make verify # check the resolver against the answer key, and this post against the system
open http://localhost:3000
```
第一次摄取之后,有三个地方值得看看。记分卡页面显示企业架构仓库的导出在新鲜度上得分最低:它的大部分记录上一次被改动是在半年多以前,其中就包括那个一年前已经下线的应用。理赔平台团队的评审队列里,放着从 `pol-adm-ui` 到 Policy Administration 的那条推断链接,置信度 0.82,附带模型给出的三条理由。在仓库里问编程智能体「claims-prod 归谁所有,什么依赖它?」,会得到一个引用它在图中路径的回答,只需两次工具调用,而不是二十次。
我最得意的部分是 `make verify`。种子数据附带一份答案表:Kestrel Group 真实的样子,由人手写下来。verify 这一步把解析出的模型与它比较,并对照运行中的系统检查这篇文章里的每一个具体说法,CI 在每次改动时都会运行它。在种子数据上,边的精确率是 0.996,召回率是 0.994,身份则都是 1.0。每条规则的精确率也会被测量,其中一条规则 `team_owns_single_app` 在它仅有的 1 个案例上答对了 0 个:它把一个实验仓库链接到了一个与之毫无关系的应用上。这正是一个参考实现应该展示而不是隐藏的东西。
## 参考实现没有涵盖的部分 {#what-the-reference-leaves-out}
一个参考实现靠坦白自己的空缺来赢得信任。下面是几个大的。
- **身份与访问。** 参考实现没有认证。写操作带着一个从「以某人身份操作」选择器里选出的名字,作为 `X-Actor` 请求头发送,因为确认和 primary 声明都需要一个名字。真正的部署需要为写操作提供真实的身份,即便读取对所有人开放,正如我主张的那样。
- **规模化的真实连接器。** 这些连接器读取种子文件;只有代码托管平台的连接器有一个小小的在线模式,面向单个 GitHub 组织。生产环境的连接器要处理分页、限流、部分失败、凭据,以及不打招呼就改模式的数据源。这项工作毫不光鲜,而且没有尽头。
- **历史。** 参考实现保留观测的历史,但实体和边是原地重建的。时间点上的问题(「迁移之前系统版图是什么样子?」)需要带有效区间的边历史,这是一个直接的扩展,但在存储和查询复杂度上都有实实在在的代价。在此之前,快照以及快照之间的 `itx snapshot diff` 是廉价的替代办法。
- **规模。** Kestrel 有四十个应用,参考实现在每次摄取时都重建整个模型。对成千上万个实体来说这没问题,对数以百万计的实体则不行。PostgreSQL 应付得了一个大型集团的系统版图,但构建必须改成增量式的,递归查询也需要索引、限制和一些小心。
- **草稿。** 用于决策记录和商业论证的生成器,连同它们的引用检查,还没有实现。
- **本体本身的治理。** 谁可以新增一种实体,这种变更如何评审,是一个组织层面的问题,仓库可以用代码评审来支持它,却回答不了它。
这些都不会改变形态。它们是一个下午就能读懂的参考实现,与一个能为整个集团运行的平台之间的差别。
## 可以从中带走什么 {#what-to-take-from-it}
如果你要建一个这样的系统,顺序比工具更重要:先写本体,其余一切由它生成;把观测和实体分开;让每一条关系都成为一行,带着依据、置信度和来源;公开给数据源打分;MCP 服务器与 API 放在同一个进程里,编排放在它之外;产出物是文本形式,从快照生成,并带着出处。数据库、工作流引擎、前端框架和模型提供方,都是可以日后再议的选择。
这个仓库就是拿来拆的。如果你用自己的导出数据运行它,而模型弄错了什么,那是可能发生的最有用的事,我很想听听:[CONTRIBUTING.md](https://github.com/raskell-io/it-intelligence/blob/main/CONTRIBUTING.md) 说明了如何添加一个数据源,issue 也是开放的。
## 参考资料 {#references}
- Raffael Schneider,[IT Intelligence: The Missing Data Layer of Enterprise IT](https://raskell.io/articles/it-intelligence/),配套文章,论证了为什么需要这个平台。
- [raskell-io/it-intelligence](https://github.com/raskell-io/it-intelligence),参考实现,决策记录在 `docs/adr/` 里。
- [LinkML](https://linkml.io/),Linked Data Modeling Language,以及它的[生成器](https://linkml.io/linkml/generators/)。
- [Temporal](https://temporal.io/)、[Restate](https://restate.dev/) 和 [Aqueduct](https://github.com/raskell-io/aqueduct),持久化执行引擎,其中任何一个都可以接替编排器的位置。
- [PostgreSQL documentation on recursive queries](https://www.postgresql.org/docs/current/queries-with.html)(`WITH RECURSIVE`)。
- [Apache AGE](https://age.apache.org/),在 PostgreSQL 上用 openCypher 做图查询。
- [Model Context Protocol](https://modelcontextprotocol.io/),以及[官方 Go SDK](https://github.com/modelcontextprotocol/go-sdk)。
- [Mermaid](https://mermaid.js.org/),文本形式的图表。
- [Backstage software catalog](https://backstage.io/docs/features/software-catalog),实体模型在开发者门户领域的前身。
- Simon Brown,[The C4 model](https://c4model.com/),适合作为生成器输出目标的架构视图。
- [The Go 1 compatibility promise](https://go.dev/doc/go1compat),多年前写的 Go 代码至今仍能构建,原因就在这里。
- Ivan P. Fellegi 和 Alan B. Sunter,"A Theory for Record Linkage",*Journal of the American Statistical Association* 64, no. 328 (1969): 1183 至 1210,[doi:10.1080/01621459.1969.10501049](https://doi.org/10.1080/01621459.1969.10501049),以阈值和人工复核做身份解析的理论基础。
- [Splink](https://moj-analytical-services.github.io/splink/),英国司法部(UK Ministry of Justice)的开源概率记录链接工具。
- W3C,[PROV-O: The PROV Ontology](https://www.w3.org/TR/prov-o/),描述一个事实从何而来的标准词汇。
- W3C,[OWL 2 Web Ontology Language](https://www.w3.org/TR/owl2-overview/) 和 [SHACL](https://www.w3.org/TR/shacl/),本体被生成为的语义网形式,以及 [JSON Schema](https://json-schema.org/),用于校验的形式。
- Michael Nygard,[Documenting Architecture Decisions](https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions)。
================================================================================
---
title: "一个由人组成的帝国"
url: https://raskell.io/zh/articles/review-empire-of-ai/
author: Raffael Schneider
date: 2026-11-14
description: "Karen Hao 的 Empire of AI 通过其中的人讲述 OpenAI 的故事。作为报道引人入胜,在论证之处则参差不齐。"
tags: [research-labs, technology-races, hubris, training-data, capital-allocation, bureaucracy]
categories: [reviews]
review_of: "Empire of AI"
review_of_author: "Karen Hao"
review_of_kind: book
review_of_year: 2025
rating: 7.5/10
lang: zh-Hans
translation_of: https://raskell.io/articles/review-empire-of-ai/
---
# 一个由人组成的帝国
## 简而言之
Karen Hao 的 *Empire of AI* 是一部关于 OpenAI、Sam Altman 及其身边之人的内部叙述,建立在约 300 次访谈之上;我给它打 7.5 分(满分 10 分)。 紧接着 Sebastian Mallaby 的 *The Infinity Machine* 读它,几乎就是一部配套之作:同一批人物,同样的年份,只是从 OpenAI 而不是从 DeepMind 看过去,政治更多,技术更少。 书中最好的部分展示了 OpenAI 的使命如何每隔一两年就被重新定义;Hao 把它读作一套帝国的公式,我则把它读作一个比其中任何人都更大的过程。 它在论证之处较弱:好几章关于代价由别处承担的内容本可以更短,而它对智利的叙述是透过一种政治视角来看这个国家的。 它留下的最持久的教训是:一家具有全球意义的公司,仍然是由像你我这样的人在运营,只是更聪明一点、更狡黠一点、更有远见一点。
*Empire of AI* 开篇于 2023 年 11 月 17 日星期五,太平洋时间中午前后:Sam Altman 登录一个视频会议,董事会五名成员中的四人告诉他,他被解雇了。序章把整整五天都讲了一遍:Ilya Sutskever 什么也解释不清的全员大会、高管们的威胁、员工联名信、Microsoft 的邀约、Sutskever 的反悔、Altman 的回归。随后全书回到 2015 年 Rosewood 酒店的一场晚宴,直到最后一部分,才从董事会商议的内部再次抵达同样的五天。
Karen Hao 从 2019 年起就在追踪 OpenAI,那一年她在公司办公室里驻留了三天,写下了关于这家公司的第一篇特稿。这本书建立在对约 260 人进行的大约 300 次访谈之上,其中 90 多人是 OpenAI 的现任或前任员工,此外还有备忘录、电子邮件和 Slack 消息。Altman 和 OpenAI 选择不予配合。这一点在两个方向上都看得出来:她知道谁在哪次会议上说了什么,而 Altman 大多是透过与他共事的人被看到的。
我给它打 7.5 分(满分 10 分)。如果你想理解 Sam Altman、OpenAI 以及塑造了二者的那些纷争,这就是该读的书;它也让我确信了一件我早有猜测的事:一家可能与历史上任何公司同等重要的公司,仍然是由像你我这样的人在运营,只是更聪明一点、更狡黠一点、更有远见一点。
## 两本书,一个故事 {#two-books-one-story}
我紧接着 Sebastian Mallaby 为 Demis Hassabis 写的传记 [*The Infinity Machine*](https://raskell.io/articles/win-everything-control-no-one/) 读了这本书,事实证明这是正确的顺序。Mallaby 讲述了 DeepMind 的起源,顺带也讲述了现代机器学习的起源,按时间顺序,一直讲到基于 Transformer 的语言模型,而我们才刚刚开始经历它们带来的后果。Hao 讲的是另一半:同样的年份,许多同样的人(Musk、Sutskever、Amodei、Hinton、Suleyman),只是从旧金山而不是从伦敦看过去。两本书互为对方盲点的镜像。Mallaby 得到了 Hassabis 的配合,透过 Altman 的对手来描绘他;Hao 没有得到 Altman 的配合,而 Hassabis 即便出场,也是被远远地描绘。
有些场景在两本书里都出现,并因此更好看。Musk 对 Hassabis 的恐惧,Mallaby 是从伦敦报道的,在 Hao 的第一章里却成了 OpenAI 得以存在的理由:Musk 不希望 AI 的未来由 Larry Page 掌控,而 Altman 写邮件给他说,最好由 Google 以外的人先把它造出来。一位前 DeepMind 研究员对 Hao 说,OpenAI 的创立是「对一个相当温和的人的半歇斯底里的反应」。Mallaby 展示了 DeepMind 如何否定以语言通往智能的道路,Hao 则展示了让它改变主意的那份备忘录:2019 年从 OpenAI 转投 DeepMind 的安全研究员 Geoffrey Irving,带去了扩展语言模型的论证(第 7 章)。两本书共同涉及的人物和观念,我画在了 [Who contributed to AI](https://raskell.io/notes/who-contributed-to-ai/) 里,每一条连线都有出处。
两本书的侧重点差异很大。Mallaby 讲解技术,每个概念讲两遍,人物服务于这个领域的历史。Hao 感兴趣的是人和政治,以及谁为这项技术买单,而不是它如何运作。两种选择都正当。她的选择造就了更好的惊悚故事,也造就了更弱的观念史。
## 讲述的方式 {#how-it-is-told}
Hao 为悬念而写,我很欣赏这一点。这些故事彼此交织,在人性层面上又如此有趣,值得被当作一出戏来讲:Rosewood 晚宴,Musk 在 2018 年的最后通牒与离开,Bill Gates 先被 GPT-2 的演示打动、又被通过他那场生物考试的 GPT-4 折服,Amodei 兄妹带着 GPT-3 团队的三分之一离开、创立 Anthropic,还有 ChatGPT 本身。它在 2022 年 11 月因为一个传言而被匆忙推出,传言说 Anthropic 即将发布一款聊天机器人;它在内部被定位为一次「低调的研究预览」,员工们下注打赌,周末会有几千人还是几万人来试用。五天之内,它就有了一百万用户。
结构对读者就没那么友好了。全书分为四个部分,大体按顺序推进,但有好几段时间被讲了两遍。第 2 章和第 3 章把 2015 年到 2019 年讲成一个机构的故事,第 5 章又回过头去,把这几年再讲一遍,讲成研究的故事。第 4 章完全离开 OpenAI,写了一篇从轧棉机到达特茅斯再到深度学习的 AI 史随笔。第 9 章在 2021 年的肯尼亚、委内瑞拉的崩溃、哥伦比亚和 2023 年的内罗毕之间来回穿梭。第 13 章又从华盛顿一侧重新讲述 2023 年。读过 Mallaby 严格按时间顺序的叙述之后,我有时会弄不清自己身处时间线的哪个位置。这没有让我停下来,但如果书末附一份时间线或人物表会有帮助,而这本书两样都没有。
## 押注语言 {#the-bet-on-language}
一些最好的材料在第 5 章,讲的是造就 GPT 的那些决定。Hao 报道说,Ilya Sutskever 在 OpenAI 内部的说法是[「智能就是压缩」](https://raskell.io/notes/intelligence-is-compression/):一个被训练来生成令人信服的文本的模型,必须把它对世界的所知压缩成精华。随后 Dario Amodei 把研究当作一组押注的组合来管理,他保留下来的那个押注是 GPT-2,它代表了这个领域所说的「纯语言」假说:一个只用足够多的文本、别无其他来训练的系统,可以获得通用智能;与之相对的是「具身」假说,认为它还需要感知和行动。Amodei 逐渐认为,扩展语言模型也许是最快的路径,尽管很可能不是唯一需要的东西。
与 Mallaby 放在一起看,这是这十年里决定性的岔路口。DeepMind 2010 年的商业计划书否定了「语言是智能的表达」这一观点,Hassabis 多年来一直相信,模型必须在世界中行动才能理解世界。OpenAI 押了另一边,并赢下了第一回合。说压缩和纯语言是同一个赌注的两半,也就是「文本就够了」,这是我的解读,不是 Hao 的。她把一些员工为语言押注所做的论证,即拿海伦·凯勒和盲人作类比,称为「令人反感的」;在第 4 章里,她还论证说规模扩展是[「一个自我实现的预言」](https://raskell.io/notes/a-self-fulfilling-prophecy/),而不是自然规律。尽管如此,这本书还是把这个岔路口展示得很清楚。
前半部分的另外三段成了独立的笔记:一位中国研究员认为,在硅谷以外,没有人会在这东西还没有用途之前就为它出钱([A billion without a plan](https://raskell.io/notes/a-billion-without-a-plan/));Altman 让人漆在办公室墙上的 Rickover 名言([One person can make a difference](https://raskell.io/notes/one-person-can-make-a-difference/));以及电影 *Her* 作为 OpenAI 对 AGI 应有之感的想象([The interface that disappears](https://raskell.io/notes/the-interface-that-disappears/))。
## 使命如何移动 {#how-a-mission-moves}
我会记得最久的一段在第 18 章「A Formula for Empire」。Hao 论证说,OpenAI 的使命像一个由三种成分构成的公式:它用宏大的抱负聚集人才,它通过让替代方案显得危险来聚集资本,而它又足够模糊,可以在公司需要时随时重新诠释。作为第三点的证据,她列出了这一使命在各个阶段被说成意味着什么,每一次都用公司自己的话:
| 年份 | 使命被说成意味着什么 | 出处 |
|---|---|---|
| 2015 | 一个「不受产生财务回报之需要约束」的非营利组织,开源其研究 | 成立公告 |
| 2016 | AI 造出来以后,每个人都应当受益,但科学本身不必分享 | Sutskever 写给 Altman、Brockman 和 Musk 的邮件 |
| 2018 至 2019 | 一个利润封顶的结构,用来筹集这项工作所需的资源,同时避免一场没有时间顾及安全的竞赛 | 宪章 |
| 2020 | 把模型封闭在 API 之后,作为「一种实现开放与利益共享的策略」 | Altman 回应 Hao 关于公司的第一篇特稿 |
| 2022 | 「迭代式部署」,以及争分夺秒地推出 ChatGPT | Hao 对公司口径的概括 |
| 2024 | 把非常强大的 AI 工具免费或以极低的价格交到人们手中 | Altman 在 GPT-4o 发布后的博客 |
这一章以 Altman 称赞一本拿破仑语录开篇,特别是拿破仑如何重新诠释大革命的口号来巩固自己的权力。这个类比很尖锐,Hao 也有意如此。我对这张表的解读不同。每一步在当时都有说得通的理由:训练变得昂贵,所以非营利组织需要资本;资本需要回报,所以模型需要一门生意;竞争者出现了,所以这门生意需要速度。2015 年的理想主义不是被某一个决定抛弃的。它是被算力、金钱和竞争的现实一步一步磨损掉的,每一步都合情合理,而做出这些步骤的人大多仍然相信自己在为它服务。这是一个比其中任何一个人都更大的过程,包括 Altman 在内;我猜想,换成任何一位创始人,它都会发生。
同样的过程也出现在第 11 章一个更小的故事里。在 2020 年的一份备忘录中,Altman 希望 OpenAI 保持[「小、专注、高信任、少扯淡、高强度」](https://raskell.io/notes/small-focused-high-trust/);到 2022 年底,他主张新招聘不超过一百人左右,而其他高管想要的是这个数字的五倍。2022 年 10 月的一次外出会议时,OpenAI 大约有 300 人,一年后已接近 800 人。每一个大的群体,最终都会把越来越多的工作花在维系自身上,部委如此,公司亦然;我把自己对这一观察的版本写在了 [Small, focused, high-trust](https://raskell.io/notes/small-focused-high-trust/) 里。
## 我与它分道扬镳之处 {#where-i-part-ways}
Hao 的立场很清楚,她在作者说明里也直说了:这本书「不是一本企业书」,而是「一次关于权力的沉思」,她深入了世界各地承受 AI 代价的社区。在序章里,她把这个隐喻说得很明白。AI 公司是殖民意义上的帝国:它们攫取不属于自己的资源,剥削他人的劳动,再用现代性的观念和与敌对帝国的竞赛来为之辩护。这造就了诚实的报道,但在某些地方,也让这本书读起来更像是一份针对打造 AI 之人的控诉,而不是对他们的叙述。好几章关于代价由别处承担的内容,篇幅超出了它们要表达的意思,本可以更精炼。
其中有一章我不会删。第 7 章「Science in Captivity」讲的是 Timnit Gebru,一位生于埃塞俄比亚的研究员,十几岁时作为厄立特里亚难民来到美国,后来共同领导 Google 的伦理 AI 团队。她曾与 Joy Buolamwini 合写「Gender Shades」,表明商业人脸分析在肤色较深的女性身上出错最多。GPT-3 出现时,她警告说,一个用 Reddit 和 Common Crawl 其余部分训练的模型会吸收其中的毒性;她还与 Emily M. Bender 合写了「On the Dangers of Stochastic Parrots」。Google 命令她撤回这篇论文。她提出了条件,并表示如果条件得不到满足她就会离开;2020 年 12 月 2 日,Google 告诉她,公司立即接受她的辞职,而她宣布自己被解雇了。Hao 更大的论点关乎科学:在这件事之后,也在 ChatGPT 之后,这个行业不再公布其模型是用什么训练的,而如果看不到训练数据,就无法诚实地检验一个模型。我记得 GPT 早期的那场争论,当时人人都在谈论权重里的偏见。在我自己的工作中,这个问题此后已经退居其次:一个在回答之前先用工具查找事实的模型,答对的次数远远多于一个仅凭权重作答的模型。这不等于权重里没有偏见,但它改变了偏见有多要紧。无论如何,Hao 关于封闭训练数据的论点都站得住。
关于智利的那一章「Plundered Earth」(第 12 章),我读得很艰难。Hao 透过智利的殖民历史、芝加哥男孩、皮诺切特的私有化、不平等以及 Gabriel Boric 的当选来讲述智利,并把它归入那些为帝国供应铜、锂、土地以及圣地亚哥周边数据中心用水的全球南方国家。我很喜欢智利,在那里也有认识的人;这只是看这个国家的一种视角,而不是它的全貌。在联合国人类发展指数上,智利在拉丁美洲排名第一。它的政府招揽数据中心,是因为它想要这笔投资;而 Hao 自己的报道也展示了一个自己做决定的国家:Cerrillos 的一次公投,一个在 2024 年裁定 Google 不能在圣地亚哥建造水冷数据中心的环境法院,以及一个如今请活动人士一同参与起草数据中心战略的部委。按全球标准,智利是建设数据中心和矿山的合理之地,而在漫长的干旱中,用水是一个正当的关切。在这里,Hao 的消息来源比她的框架更审慎。原住民活动人士 Sonia Ramos 说她的祖先就是矿工,问题在于规模;乌拉圭研究员 Daniel Pena 对数据中心也是这么说的。
规模正是我与它分道扬镳之处。Altman、Hassabis 等人所下的赌注是:把世界的资源花在打造更多智能上,终将得到回报,因为它能解决没有它我们就解决不了的问题。能源是其中最大的一个。Hao 报道说,Altman 喜欢说,他那些最大的数据中心的能源问题,会随着核聚变的突破而自行解决,而聚变公司 Helion 是他个人最大的一笔投资。她引用一位研究员的话,称「AGI 将解决我们的环境问题」这一说法无法证明。确实如此。它也可能是错的。但这是一个连贯的策略,它值得得到比这本书给予的更多的同情。帝国从定义上并不是净负面的。集中在少数人手中的权力让伤害成为可能,这值得讨论;问题在于权力积累起来之后用它做什么,而不在于积累本身。我在 [A billion without a plan](https://raskell.io/notes/a-billion-without-a-plan/) 里就资本提出过这个论点的一个版本。
## 帝国如何衰落 {#how-the-empire-falls}
尾声给出了 Hao 的替代方案。Te Hiku Media 是新西兰最北部的一家毛利语广播电台,它用社区在知情同意下捐出的 310 小时录音,为毛利语打造了第一个语音识别模型,并在自己的两块 GPU 上完成训练。Hao 把它与 OpenAI 的 Whisper 对照,后者用从网上取来的 68 万小时音频训练。接着,她借用斯坦福研究员 Ria Kalluri 一次演讲中的说法,提出了权力的三条轴:知识、资源和影响力。在她的叙述中,AI 公司通过集中人才、侵蚀开放科学、把模型封闭起来不受审视来控制知识;通过聚集资金、数据、劳动、算力、能源和土地来控制资源;又通过意识形态和俘获全世界想象力的演示来控制影响力。她对第三条轴开出的药方是公众教育,并以 ELIZA 的创造者 Joseph Weizenbaum 的话作结:一旦一个程序的内部运作被解释得足够浅白、让人能够理解,[「它的魔力便土崩瓦解。」](https://raskell.io/notes/its-magic-crumbles-away/)
这三条轴是一个有用的视角,我会用它。Te Hiku 是一个好故事,用人们自愿提供的数据训练的小模型,是未来的一部分。我认为最重要的那个细节很容易被忽略:Te Hiku 买了自己的 GPU,因此不依赖任何科技巨头的云。对硬件的所有权,是资源这条轴上普通人真正能够改变的那一部分。
训练定制模型是其中一种方式。运行模型是另一种,而每当有人向模型提问,就有越来越多的算力花在这里。这正是我在 [Archipelag.io](https://raskell.io/articles/archipelag-io-distributed-compute-from-mining-rigs-to-open-beta/) 上着力解决的问题:一个让 AI 任务运行在由个人和社区而不是少数超大规模云厂商运营的 GPU 上的网络,优先选择就近的主机,并记录每个任务在哪里运行。它目前处于公开测试阶段,也不会去训练下一个前沿模型。但它让人们拥有运行 AI 的基础设施的一部分,而不只是租用访问权,并带来所有权所附带的东西:为提供主机的人带来收入,让数据离家更近,也没有哪一个房东能单方面改变条款。网络为出版做了同样的事。在它之前,要触达受众需要一台印刷机或一张广播执照;在它之后,任何有电脑的人都能发布一个网页,而网络正是从数以百万计的人做这件事中生长出来的,正如我在关于 [Tim Berners-Lee 回忆录](https://raskell.io/articles/the-web-was-the-training-set/)的书评里写的那样。分布式的公民算力,是在推理上迈出的同样一步。
我完全赞同这个药方:解释这些系统如何运作,是任何人能做的最好的事,也是这个网站努力在做的事。我与它分道扬镳之处在于:这种诊断把集中本身当成了问题,并把小模型当作大模型的替代品,而不是补充。
## 谁应该读它 {#who-should-read-it}
任何对 Sam Altman、OpenAI 以及这项技术背后的人和纷争感兴趣的人,最好在读过 *The Infinity Machine* 之后再读,因为那本书解释了 Hao 大多视为理所当然的技术。书中的细节非同寻常,我从中带走的值得记住的掌故,比今年读的大多数书都多。我希望它能更聚焦一些:以 Hao 接触 Altman 身边之人的程度,一本只写人物、更紧凑的书会更加宏大。
留在我心里的,是 Hao 当作批评来拉出的一条线索。这本书以两段题词开篇:Weizenbaum 关于一旦被解释便土崩瓦解的魔力,以及 Altman 博客里的一句话。在第 10 章里,她写道,末日派和繁荣派在宣讲同一本圣经,一个讲地狱之火,一个讲天堂。在第 18 章里,她又回到 Altman 2013 年的那句话:最成功的创始人着手创造的是[「某种更接近宗教的东西」](https://raskell.io/notes/something-closer-to-a-religion/),而公司原来是实现它最容易的方式。在第 17 章里,她引用他在一档播客中的话,说[「智能不过是物质的一种涌现属性」](https://raskell.io/notes/an-emergent-property-of-matter/),并把它当作炒作。我认同这一信念,并在 [An emergent property of matter](https://raskell.io/notes/an-emergent-property-of-matter/) 里写过它。Hao 把宗教视为警示信号,我却把它看作对这些公司正在变成什么的诚实描述。随着人类劳动的价值下降,维系它们的将越来越少是它们付钱购买的工作,而越来越多是它们所相信的东西。OpenAI 是最早的一批之一,而它的使命还会继续移动。
================================================================================
---
title: "三个部分,没有大脑"
url: https://raskell.io/zh/articles/three-parts-and-no-brain/
author: Raffael Schneider
date: 2026-11-05
description: "一个国际象棋程序由什么构成,以及在任何学习开始之前,一个手写的程序能在 lichess 的电脑对手面前走多远。"
tags: [game-ai, tree-search, games, rust, metrics, probability, chess, shogi, go-game]
series: learning-to-play
lang: zh-Hans
translation_of: https://raskell.io/articles/three-parts-and-no-brain/
---
# 三个部分,没有大脑
## 简而言之
在任何学习开始之前,我按 Levy 描述的三个部分构建了 Kishi 的国际象棋引擎:变成数字的棋盘、判断谁占优的评估函数,以及向前看的搜索。 位棋盘表示在每次改动时都用 perft 检验;手写的 PeSTO 评估函数几乎不包含国际象棋知识,棋力在于搜索,以及搜索里那一堆调校过的统计赌注。 诚实地测量棋力是最难的部分:对抗赛需要成对的开局、相同的搜索预算和明确给出的误差范围,而一个没有得到证明的微小正向结果意味着:留着它,但不要宣称它。 对阵一个重建的 lichess 电脑对手,使用手写评估函数、单核运行的 Kishi 介于 6 级和 7 级之间,误差范围很宽,我把它们报告出来,而不是略去。 同样的构造在将棋上得到一个说得过去的俱乐部级对手,围棋则需要改用随机模拟对局;这条基线,就是本项目中每一个训练出来的神经网络都必须击败的对手。
lichess 上的国际象棋电脑有八个级别。我坐火车时用手机和它下棋,和每一个跟它下过棋的人一样,我有一个能赢的级别,也有一个会输的级别。上个月我造出自己的引擎后,我拿给谁看,谁问的第一个问题,都是我一直在问自己的那个:它是几级?这听起来是世界上最容易回答的问题。结果它成了整个项目里最难的部分,比让程序会下棋还难,而这个答案正是本文的重点。
在[第一篇](https://raskell.io/articles/learning-to-play/)里,我讲了十二岁的 Demis Hassabis 读 David Levy 关于国际象棋计算机的手册、得知一个国际象棋程序由三个部分构成的故事:变成数字的棋盘,一个判断谁占优的函数,以及一个向前看的搜索。我用 Rust 构建了这三个部分,我想展示每一个部分在真正动手构建之后是什么样子,因为出人意料的地方在于,国际象棋到底藏在哪一个部分里。然后我想给结果定一个数字,并说明为什么这个数字带着一个大多数人悄悄略去的误差范围。
本文里没有任何东西在学习。这是有意为之。一个学习评估国际象棋局面的神经网络,需要有东西来下它所学习的那些对局,事后还需要有东西让它去击败,否则就无从判断它是否学到了什么。本文讲的就是这个东西。
## 棋盘,变成数字 {#the-board-as-numbers}
Levy 的第一个部分听起来微不足道,其实不然。棋盘有 64 个格子,现代处理器处理的是 64 位的数字,所以自然的表示方式是每种棋子一个数字,这种棋子站在哪个格子上,就把对应的位设为 1。十二个数字,白方和黑方各六种棋子各一个,局面就有了。一步棋是十六位:从哪里走,走到哪里,再加几位表示这是哪一类走法。一盘棋的全部状态,占用的内存比这一段文字还少。
之所以要在意这些,是为了速度。问「这个马能走到哪里」变成了查一张表;问「王是否被攻击」变成了对这些数字做几次与运算和或运算。一个引擎每秒要问这些问题几千万次,而每一次都必须完全正确,因为国际象棋的规则有很多犄角旮旯。王车易位时穿过受攻击的格子。吃过路兵的兵,在吃子的同时让己方的王沿横线暴露在将军之下。一个在走法生成里有一个罕见 bug 的程序,可以平安无事地下一千盘棋,然后因为走了一步非法棋而输掉一盘,而没有人注意到是哪一条规则出的错。
检验这一点的测试有个名字,叫 perft,它是每个引擎作者最先运行的东西。你从一个已知局面出发,数出到固定深度为止所有合法的走法序列,再与公开的数字比较,这些数字几十年来早有公论。
| 向前看的步数 | 从初始局面可到达的局面数 |
|---|---|
| 1 | 20 |
| 2 | 400 |
| 3 | 8,902 |
| 4 | 197,281 |
| 5 | 4,865,609 |
如果你的程序在深度五时给出 4,865,609,你的规则就是对的,至少对初始局面而言如此。还有第二个人人都用的局面,绰号 Kiwipete,其中王车易位权、吃过路兵和升变同时存在,另外还有几个更刁钻的残局。Kishi 在每次改动时都会跑完整套测试。项目中的每个对局工具还会用 Kishi 自己的走法生成器检查对手的走法,所以如果两个程序在规则上出现分歧,这盘棋会大声报错,而不是被悄悄计分。
有一个决定此后一直伴随着这个引擎。在 Kishi 里,一个局面是一个被复制、而不是被修改的小值。走一步棋会交给你一个新局面,旧局面原封不动,所以没有「撤销走法」,两者也就不可能逐渐错位。代价是每步棋复制几百个字节,换来的是不可能与自身失去同步的代码。对于一个后来要被编译成 WebAssembly、同时在多个线程上运行的程序来说,这是正确的取舍,换作今天我还会这样选。
## 评估函数 {#the-evaluation}
Levy 的第二个部分,是我以为国际象棋会藏在里面的那个,而它几乎什么都不包含。评估函数只看单个局面,不向前看,返回一个数字:谁占优,优势多大,以百分之一个兵为单位。正 100 表示轮到走棋的一方多一个兵,或者在局面上有相当于一个兵的优势。在 Hassabis 读过的那本书里,Levy 举的例子是子力与机动性的权衡:如果你剩下的棋子的重要性是它们能到达的格子的两倍,那就在加上机动性分数之前,先把子力分数翻倍。这个思路至今没有变:给能数出来的东西加权。
Kishi 的手写评估函数是一套知名的表,叫 PeSTO。十二种棋子各有一张 64 个数字的表,每个格子一个数字:中心的马比边线上的马更值钱,王在中局时应该待在角落,在残局时应该来到中心,一个挺进到远处的兵比待在原位的兵更值钱。每种棋子有两张表,一张用于中局,一张用于残局,评估函数根据剩余子力的多少把两者混合。把棋盘上各个棋子对应的表项加起来,就是那个数字。
除此之外它一无所知。对兵形的了解仅限于每个兵站在哪里,对王的安全的了解仅限于王站在哪里,不知道车是否在开放线上,也不知道任意两个棋子之间有什么关系。它就是两组 768 个数字,外加一次插值,而它下棋的水平足以击败大多数下国际象棋的人,这说明了这些程序的棋力究竟在哪里。不在知识里。
下一篇我还会回到 768 这个数字,因为那个本应取代这张表的神经网络恰好有 768 个输入,而这并非巧合。
引擎里其实已经有一小块学习,值得用一句话说说,因为它是整个项目所关注的那个思想最小的一个例子。搜索会维护一张表,记录评估函数最近对它见过的每种兵形错了多少,并在使用评估值之前用这个滑动平均对它加以修正。这个修正是在对局过程中、从搜索自身更深的结果里学来的,对局结束后就被丢弃。
## 搜索 {#the-search}
Levy 的第三个部分,是工程所在之处,也是棋力的来源。搜索尝试每一步棋,以及每一步应着,再到应着的应着,构建一棵可能到达的局面树,并在叶节点上询问评估函数。教科书版本是极小化极大:假设对手总是选择对你最不利的应着,然后选择最坏情况最好的那步棋。Alpha-beta 是附带一个证明的极小化极大,证明这棵树的大部分并不重要。一旦某个应着已经表明一步棋足够糟糕,你就不再去读这步棋的其余变化,就像你在一份合同条款里找到那句足以让交易告吹的话之后,就不再读下去。如果每一步都先检查最好的走法,alpha-beta 能看得和极小化极大一样远,访问的局面数却大约只是后者的平方根。
现代引擎在此之上所做的一切,都是关于国际象棋的赌注,而每一个赌注都有输的时候。引擎经过调校,使得这些赌注换来的额外深度,比它们造成的失误更有价值。
| 技术 | 赌注 | 在 Kishi 中 |
|---|---|---|
| 置换表 | 同一个局面可以由不同的走法顺序到达,所以把找到的结果记下来 | 16 字节的表项,存在一张所有线程无锁共享的表里 |
| 走法排序 | 先看最可能最好的走法,让截断尽早发生 | 先是表里记住的走法,然后按价值排序的吃子,然后是最近引发过截断的走法 |
| 空着剪枝 | 如果什么都不做就已经足够好,那走一步也一样;跳过其余部分 | 停一手之后做一次较浅的搜索,领先越多,搜索越浅 |
| 反向无益剪枝(reverse futility pruning) | 深度很浅而局面远高于目标时,就停止查看 | 余量为每层深度 75(以百分之一个兵计),用于深度八层以内 |
| 后期走法缩减(LMR) | 排在后面的走法很少是最好的,所以用较浅的深度搜索它们 | 一个基于深度和走法序号的对数的公式 |
| 单一延伸(singular extension) | 一步远好于所有其他选择的棋,值得看得更深 | 深度八层起启用 |
| 静态搜索 | 永远不要在交换进行到一半时评估 | 一直吃下去,直到局面平稳,再去询问评估函数 |
这些都不是我发明的。它们是开源引擎的共同遗产,是三十年来由那些用数万盘对局逐一测试每项技术的人摸索出来的,也正是因为它们,Kishi 的搜索只有几千行,而不是一个研究项目。我希望你从这张表里记住的是它的形状。一个国际象棋搜索是一堆统计赌注,每一个都带着一个以百分之一个兵为单位写下的余量,每一个都针对与它一起运行的那个特定评估函数调校过。这些赌注并不知道评估函数是什么。下一篇里评估函数会换掉,而这句话就会变得代价高昂。
所有这些都就位之后,在笔记本电脑的一个核心上,引擎每秒检查大约三百万个局面,在半秒之内,也就是点一下棋盘的工夫,向前看十七到二十个半回合。1997 年的 Deep Blue 在专门为此打造的硬件上每秒检查两亿个局面,向前看十二到十六个半回合。局面少了六十倍,却看得稍远一些:差别就在于那些赌注。
## 凭什么说你知道 {#how-you-know-anything}
现在是难的部分。两个国际象棋程序可以彼此对弈,其中一个赢得更多,而你想把这一点变成一个数字。国际象棋从 1960 年代起就有这样一个数字:Elo 等级分,每个俱乐部棋手都知道的那个数字,也是我十几岁时在地区比赛上第一次接触到的数字,所以这套算术对我来说从来都不抽象。相差 400 分意味着十比一的胜算。相差 100 分意味着较强的一方大约得到 64% 的分数。两个程序之间的等级分差是根据它们之间一场对抗赛的得分算出来的,而问题在于,一场短对抗赛的得分大部分是噪声。
国际象棋引擎的开发者们为此有一件诚实的工具,值得描述一下,因为诚实就在它的设计里。两个程序从相同的随机开局下几百盘棋,每个开局下两次,交换执色,这样一个运气好的开局就不会偏袒某一方。双方每步棋都获得相同数量的可搜索局面,这样一个更快的程序就无法冒充一个更强的程序。结果还附带一个 95% 置信度下的误差范围,取决于下了多少盘棋。
| 对局数 | 误差范围 |
|---|---|
| 20 | 上下约 200 个等级分 |
| 400 | 约 32 |
| 600 | 约 23 |
在信任这件工具之前,我先把它对准了它自己。双方是同一个程序,每步一万个局面,六百盘棋:
```text
Kishi vs Kishi, 10,000 nodes a move, 600 games: +211 =181 -208 elo +1.7 ± 23.3
```
正 1.7,误差 23,这就是工具读出了零,在什么都没有改变时它就应该读出零。然后是真正的测试,前面描述的兵形修正,对阵没有它的引擎:
```text
Kishi vs Kishi without correction, 600 games: +219 =180 -201 elo +10.4 ± 23.3
```
这很可能是正的,但没有得到证明。大型引擎项目对每一次改动都用数万盘棋来做这个测试,并用一条统计规则:答案一旦明朗,无论偏向哪一边,就立即终止对抗赛。在一台笔记本电脑上,六百盘棋就是一个晚上,而对正十、误差二十三的诚实解读是「留着它,但不要宣称它」。我发现这句话在国际象棋之外也很有用。
## lichess 的阶梯 {#the-lichess-ladder}
两个版本的 Kishi 之间的对抗赛能说明哪一个更好。它说明不了任何一个有多好。要知道这一点,程序必须和一个人们已经知道其强度的对手下棋,而我所知道的最有用的标尺就在你的口袋里:lichess 的电脑对手,因为人人都和它下过,人人都有一个会击败自己的级别。
这八个级别并不是八个不同的程序。它们都是 Stockfish,世界上最强的开源引擎,被同时从三个方面刻意削弱:一个让它故意选择更差走法的技能设置,一个限制它向前看多少步的上限,以及每步棋的时间限制。这些设置是公开的,就在 lichess 运行的客户端里,所以这个对手可以在一台笔记本电脑上被精确重建。
| 级别 | 技能 | 深度 | 每步用时 |
|---|---|---|---|
| 1 | −9 | 5 | 50 ms |
| 2 | −5 | 5 | 100 ms |
| 3 | −1 | 5 | 150 ms |
| 4 | 3 | 5 | 200 ms |
| 5 | 7 | 5 | 300 ms |
| 6 | 11 | 8 | 400 ms |
| 7 | 16 | 13 | 500 ms |
| 8 | 20 | 22 | 1,000 ms |
Stockfish 自己的技能设置最低只到零,所以我重建的 1 到 3 级比真正的要强一点。4 到 8 级是精确的。Kishi 在单核上与 Stockfish 19 对弈,每个级别二十盘,用时是它自己的应用为相应级别给出的时间:
| 对手 | Kishi 每步用时 | 得分 | 等级分差 |
|---|---|---|---|
| lichess 4 级 | 200 ms | 20 盘得 19 分 | +511,上下浮动 646 |
| lichess 6 级 | 500 ms | 20 盘得 13 分 | +108,上下浮动 165 |
| lichess 7 级 | 500 ms | 20 盘得 ½ 分 | −636,上下浮动 579 |
每个级别二十盘棋,误差范围大到能开过一辆公共汽车,这正是它们写在表里、而没有被略去的原因。这些数字能支持的说法是:使用手写评估函数,在单核上,每步半秒,Kishi 介于 lichess 的 6 级和 7 级之间。如果 6 级是那个会击败你的级别,那么 Kishi 三盘里能赢它两盘。7 级是向前看十三步、棋力大部分完好的 Stockfish,二十盘棋只和一盘,是对这段差距的诚实描述。8 级是深度 22 的 Stockfish,也就是说,就是 Stockfish 本身,任何在笔记本电脑上手写的评估函数都到不了那里。
应用在手机上用四个核心下棋,而这些数字来自一个核心,所以你在 [kishi.raskell.io](https://kishi.raskell.io) 遇到的对手比表里的稍强一些。随着训练好的神经网络陆续到来,我会按手机的预算再测一次,因为正是这个测量将决定它们能否上线。
## 同样的三个部分,再来两次 {#the-same-three-parts-twice-more}
将棋采用了同样的构造:变成数字的棋盘,额外的麻烦是被吃掉的棋子会进入手中,还能回到棋盘上;一个计算子力的手写评估函数,手中的棋子比棋盘上的棋子稍值钱一些,并奖励靠近己方王的金将和银将;以及同样的搜索和同样的赌注。对阵下将棋的变体引擎 Fairy-Stockfish,每步半秒,它在最弱的技能设置下二十盘全胜,在中等设置下二十盘只赢两盘。一个说得过去的俱乐部级对手,离高水平还差得很远,而手写评估函数已经到了设计吃力的地方:棋子会回到棋盘上,就没有可以简化进入的残局,一张格子表能说明的东西也越来越少。
围棋没有采用这三个部分,因为它们行不通。没有哪张 361 个格子的表能告诉你一个围棋局面里谁在领先,而在十九乘十九的棋盘上向前看四步的搜索几乎什么都看不到。Kishi 的围棋引擎像 2008 年的程序那样下棋:把成千上万盘快速的随机对局下到终局再数子。对阵最低级别的 GNU Go,它十盘赢三盘。这种方法,以及为什么它是 AlphaGo 必须走出的死胡同,值得单独写一篇。
## 代价是什么 {#what-it-cost}
| | |
|---|---|
| 引擎 | 几天的 Rust,借助编码智能体写成,由我掌舵 |
| 规则测试 | 几秒钟,每次改动都跑 |
| 每秒搜索的局面数,单核 | 300 万到 370 万 |
| 一场 600 盘、每步 10,000 个局面的对抗赛 | 十个核心上的一个晚上 |
| 对阵一个 lichess 级别的二十盘棋 | 几分钟 |
这条基线是整个项目里最重要的数字,也是最不起眼的。它是每一个训练出来的神经网络都必须击败的对手,是将要生成它们最初学习所用对局的棋手,也是其余所有工作试图让它变得多余的东西。Levy 的三个部分,构建出来之后,装着一张手写的 768 个数字的表和大量的搜索,落在你手机上那个电脑对手的 6 级和 7 级之间。下一篇会给这张表加上一个隐藏层,看看那要付出什么代价。
## 参考资料 {#references}
- Ronald Friederich, [PeSTO's evaluation function](https://www.chessprogramming.org/PeSTO%27s_Evaluation_Function), Chess Programming Wiki.
- [Perft results](https://www.chessprogramming.org/Perft_Results), Chess Programming Wiki.
- lichess, [fishnet](https://github.com/lichess-org/fishnet):运行电脑对手各级别的客户端,附有级别表。
- Arpad Elo, *The Rating of Chessplayers, Past and Present* (Arco, 1978).
- [Kishi](https://github.com/raskell-io/kishi):`engine/` 是搜索和评估函数,`tools/` 是对局运行工具,`docs/study/notebook.md` 记录了本文引用的每一场对抗赛。
================================================================================
---
title: "IT 智能:企业 IT 缺失的数据层"
url: https://raskell.io/zh/articles/it-intelligence/
author: Raffael Schneider
date: 2026-11-04
description: "商业智能告诉一家公司它是怎么做生意的,却没有什么告诉它,它的 IT 是怎么拼在一起的。我为什么开始构建一个 Enterprise Context Platform。"
tags: [enterprise-architecture, context-engineering, legibility, knowledge-management, provenance, democratisation, oss, future-of-work]
lang: zh-Hans
translation_of: https://raskell.io/articles/it-intelligence/
---
# IT 智能:企业 IT 缺失的数据层
## 简而言之
企业建起了商业智能来了解自己怎么卖东西,却无法低成本地回答:自己有哪些 IT,归谁负责,彼此如何连接。我把这个缺失的层称为 IT 智能。 事实分散在各自独立的记录系统里,而它们之间的知识,消失在部落知识和知识孤岛之中;关于默会知识、信息政治和知识隐藏的研究,有助于解释这一点。 我正在构建的 Enterprise Context Platform 摄取每一个来源,为其准确性打分,再把它解析成一个由实体构成的本体,带有出处和置信度,通过 Web 界面、REST 和 MCP 对外提供。 IT 上下文应当默认开放,并建立在开源之上:缺少上下文的智能体探索代价高昂、重复劳动、只能靠猜,而一个共享的模型能把反复的重新发现变成一次查询。 随着智能体写下越来越多的代码,工作上移到一个新的抽象层级,那些围绕稀缺实现能力搭建起来的组织会成为下一个瓶颈,不得不改变形态。
问一家大公司上个季度在德国卖出了多少份保险,几秒钟就能得到答案,还附带图表、趋势线和按渠道的拆分。再问同一家公司:哪些应用处理客户的健康数据,归谁负责,跑在哪些集群上,其中哪些已经在调用语言模型?你得到的是一场会议,然后是一张电子表格,然后是第二场会议,因为那张表格和 CMDB 对不上。
企业花了三十年构建商业智能,却从未为自己的 IT 构建过对应的东西。我开始把这个缺失的东西称为 **IT 智能**(**IT Intelligence**),把提供它的平台称为 **Enterprise Context Platform**(企业上下文平台)。
## 让这个缺口显现出来的那份工作 {#the-job-that-made-the-gap-visible}
过去一段时间,我在一家瑞士金融集团担任面向智能体 AI 和 AI 平台的企业解决方案架构师(Enterprise Solution Architect)。这家集团既有庞大的保险业务,也有一家银行,通过十多个市场单元运营。我的任务是协调一致:确保所有这些市场单元的解决方案架构指令、政策和设计,正确地诠释了企业架构所定义的能力,而这些能力又是从公司战略推导出来的。
纸面上,这是一条干净的链条。
*The chain as it is drawn*
```text
┌──────────────────────────┐
│ corporate strategy │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ enterprise architecture │ capabilities, principles, target landscape
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ solution architecture │ directives, policies, reference designs
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ 10+ market units │ actual systems, actual teams, actual budgets
└──────────────────────────┘
```
实际上,每一个箭头都是一次翻译,由人在文档里完成,速度各不相同:战略一年一变,能力地图在有人得空时才更新,解决方案设计按项目来,而系统本身每天都在变。等到一项能力被十个市场单元诠释过一遍,你就有了十种诠释,却没有任何低成本的办法看出它们在哪里分道扬镳。
知道「好」是什么样子,是这份工作里容易的部分;知道实际上有什么,才是难的部分。每一次评审都从考古开始:存在哪些应用,它们用了哪些平台服务,归哪个团队负责,EA 仓库里的条目是否仍然和代码仓库对得上,代码仓库是否仍然和集群上运行的东西对得上。
最近我换了一个更契合这个问题的角色。我现在是集团 AI 架构师(Group AI Architect),在 AI 与数据部门内部工作,目标与之前相似:让 AI 在每个市场单元都得到协调一致的使用。区别在于,我现在坐在数据和平台旁边,而不是从外部评审它们。正是这一点,让我得以开始构建那个我一直希望存在的东西。
## 我以前造过一个小的 {#i-built-a-small-one-before}
在成为企业解决方案架构师之前,我是集团 Web 服务交付平台的平台工程师和解决方案架构师。这个平台包括 WAF、CDN,以及一批负责流量整形的入口代理,它们共同为公司暴露给内部边界和互联网的一切,提供 Web 安全和 Web 交付能力。
那个团队是个尝试新东西的好地方。其中之一是用 AI 辅助整理 WAF 规则,我和同事 Milan Duric 在 RSAC 2026 上做了这个分享。给安全圈以外的读者介绍一下:RSAC 原名 RSA Conference,是世界上最大的安全会议之一,每年春天在旧金山的 Moscone Center 举行。2026 年那一届吸引了四万多人。除了从业者、研究者和 CISO,它的舞台上也常有来自硅谷、政府,有时还有好莱坞的知名人物。此前我参加过两次,分别在 2024 年和 2025 年,第三次能作为演讲者出现在议程上,是一件让我暗自自豪的事。我们的演讲是 [Self-Learning WAF: Using Generative AI to Tame ModSecurity False Positives](https://path.rsaconference.com/flow/rsac/us26/FullAgenda/page/catalog/session/1753946922633001YdMq)。关于这次会议本身,我写在了 [RSAC 2026 笔记](https://raskell.io/articles/notes-from-rsac-2026/)里。
另一个尝试,回头看,就是一个小型的 Enterprise Context Platform,范围限于一个小队的职责。问题和这篇文章讨论的是同一个,只是规模更小。应用团队想知道:他们的 Web 服务是如何暴露的,哪些 WAF 规则作用于它们,前面的 CDN 表现如何,它们的 DNS 记录实际上做了什么。答案分散在代理、WAF、CDN 供应商的控制台和 DNS 里,而提问的团队对这些一样都没有访问权限。于是他们来问我们,我们每周有很大一部分时间花在回答问题和手工执行变更上。
我把这个小队领域里的每一种数据结构都形式化成了一份 **manifest**(清单):一种声明式的、持久化在 Git 里的描述,描述一次暴露、一条 WAF 策略、一份 CDN 配置、一条 DNS 记录,以及它们之间的关系。在这些清单之上有三层:
*The web delivery self-service, one squad's scope*
```text
┌──────────────────────────┐
│ Web frontend │ self-service portal: see what is
│ │ exposed and how, order changes
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ API backend │ control plane: validates requests,
│ │ starts workflows
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ Durable workflows │ create, adjust and remove resources,
│ │ do the operator work
└──────┬────────────┬──────┘
▼ ▼
manifests in Git WAF, CDN, ingress proxies, DNS
(source of truth)
```
门户是清单之上的一层外观。一个团队可以查到自己的服务,在一个地方看到:它通过哪个边界可达,哪些 WAF 规则适用,CDN 如何缓存和转发,哪些 DNS 记录指向哪里,完全不需要在 CDN 供应商那里开账号。想要变更时,他们在门户里下单。后端充当控制平面,校验请求并启动一个持久化工作流,工作流做的正是过去人工运维做的事:更新 Git 里的清单,把变更应用到 WAF、CDN、代理和 DNS 上,检查结果,必要时回滚。随着时间推移,这些工作流接管了过去需要专职运维人员承担的几乎全部运维工作。
Milan 和我已经把这套系统作为演讲提交给了 RSAC 2027 的演讲征集。
它留下的三条经验,直接延续到了这篇文章讨论的平台上。把数据形式化是困难的部分,也是有价值的部分;一旦清单存在,门户和工作流就很容易了。让所有人都能读到数据,使大多数问题在被提出之前就消失了。而一旦数据值得信赖,自动化几乎会自己跟上。Enterprise Context Platform 是同一个赌注,只是范围大得多,野心也大得多:不是一个小队的职责,而是整个集团的 IT 版图。
## 商业智能有一个没人造出来的孪生兄弟 {#business-intelligence-has-a-twin-nobody-built}
商业智能之所以行得通,靠的是一套乏味而成熟的架构:业务系统产生数据,管道把数据抽取出来,数据仓库把它建模成事实和维度,分析师和仪表盘查询这个模型。没有人会主张一份销售报告应该靠给十二个区域财务主管发邮件来拼凑。
IT 拥有全部的业务系统,却没有其余的任何部分。数据就在那里,散落在各个记录系统中,每个系统只知道其中一片:
| 系统 | 典型例子 | 它知道什么 | 它不知道什么 |
|---|---|---|---|
| EA 仓库(应用组合) | Ardoq, LeanIX | 应用、能力、业务归属、生命周期 | 这个应用是否仍以那种形态存在 |
| 数据治理目录 | Alation, Collibra, Microsoft Purview | 数据域、数据所有者、分类、血缘 | 实际上是哪个运行时在接触这些数据 |
| IT 服务管理与 CMDB | Jira Service Management, ServiceNow | 服务、配置项、事件、变更 | 它们背后的架构意图 |
| 源代码平台(git 托管) | Bitbucket, GitHub, GitLab | 仓库、团队、代码、依赖、活跃度 | 一个仓库属于哪个应用 |
| 容器平台 | AKS, EKS, OpenShift | 集群、命名空间、工作负载、镜像 | 谁对一个命名空间负责 |
| 可观测性平台 | Datadog, Dynatrace, Grafana | 仪表盘、告警、人们实际在盯着什么 | 这些指标对业务意味着什么 |
| 内部平台服务 | 集成平台或消息代理、WAF、API 网关、CDN | 集成流程、WAF 规则、API 暴露、CDN 配置 | 一个请求端到端经过的路径 |
这些例子是各类别里的常见产品,按字母顺序排列;大多数大公司每一行都用着一两个,具体用哪个并不改变论点。
每一行都是某人在某件事上的事实来源(source of truth),但没有哪一行能单独回答架构师的问题。架构师真正提出的问题,会同时跨越三四行:「市场单元 X 里,哪些面向客户的应用通过网关暴露了 API 却没有 WAF 策略,它们归谁负责?」
这个问题是有答案的,但答案存在于各行之间的连接里,而今天,这些连接存在于人们的脑子里。
## 部落知识与知识孤岛 {#tribal-knowledge-and-knowledge-silos}
一个拥有十多个市场单元的集团,每个单元都有自己的平台、小队,有时还有相互竞争的服务,它会以两种截然不同的方式丢失知识。把两者分开很有帮助,因为它们需要不同的解法。两者背后都有几十年的研究,而这些研究比常见的管理口号有用得多。
### 部落知识:从未被写下来的东西 {#tribal-knowledge-what-was-never-written-down}
**部落知识**(tribal knowledge)是从未被写下来的知识。哪个团队真正在运行那个老旧的集成枢纽。为什么两个应用共用一个数据库。某个市场单元的网关悄悄地经由另一个单元路由。它并不是被刻意藏起来的;只是从来没有人把它变成文字,更不用说变成结构化数据。它存在于少数几个人身上,他们一走,它也就跟着走了。
哲学家 Michael Polanyi 在《默会维度》(*The Tacit Dimension*)中为这一底层现象给出了经典表述:「我们所知道的,多于我们能说出的。」一位经验丰富的工程师对一片 IT 版图的了解,有一部分在这个严格意义上是默会的。他们早在能说清原因之前,就能认出一个设计行不通。野中郁次郎(Ikujiro Nonaka)和竹内弘高(Hirotaka Takeuchi)围绕这类知识的转化建立了一个组织学习模型,即 SECI 模型,并把从默会到显性的那一步称为*外化*(externalisation)。他们的批评者指出,许多默会知识根本无法编码,我认为双方都有道理。IT 里很多被当作部落知识的东西,其实根本谈不上深层的默会。它们是显性知识,只是从来没有人被要求把它写下来,因为没有地方可写。谁拥有一个命名空间,完全是说得出来的;只不过哪里都没有记录。
James C. Scott 补上了警告。他在《国家的视角》(*Seeing Like a State*)中描述了 *mētis*,即通过长期经验获得的实践知识,并展示了那些试图让复杂系统从上方变得清晰可读的方案,往往恰恰摧毁了这种知识,因为简化的地图被当成了疆域本身。任何承诺让一家公司对自己变得清晰可读的平台,都应当严肃对待这一点。Context Model 永远不会包含运行一个系统的人所知道的一切,也不应假装如此。它能做的,是让显性的那部分变得廉价,并指向掌握其余部分的人。
这第二项工作也有名字。Daniel Wegner 的*交互记忆*(transactive memory)理论描述了群体如何记忆:不需要每个人都知道一切,只要每个人都知道*谁知道什么*。小团队会自然地建立起这样一份目录。一个跨越十个市场单元、成千上万人的集团做不到,而这正是部落知识从一个怪癖变成一种风险的地方。软件工程直接测量这种风险的一个版本,称为*卡车因子*(truck factor):需要离开多少人,一个项目才会停滞。Avelino 及其同事为 GitHub 上 133 个流行的开源项目估算了这个数字,发现 65% 的项目卡车因子不超过二。没有理由相信企业内部的代码会更好,而由于 Context Model 本来就读取提交历史,它可以为集团里的每一个应用计算出卡车因子。
### 知识孤岛:写下来了,却够不着 {#knowledge-silos-written-down-but-out-of-reach}
**知识孤岛**是相反的问题。知识被形式化了,也被持久化在某处,在某个工具、某张电子表格、某个 wiki 空间里,但需要它的人并不能方便地获取。这种抱怨有一句著名的话:「要是 HP 知道 HP 知道些什么就好了」,通常被归于惠普前 CEO Lew Platt,不过 Carl Sieloff 把这句话追溯到 1980 年代,那时它已经是公司内部一句常见的抱怨。
孤岛有时是意外,有时是刻意的。根据我见过的情况,我自己对原因的猜测是以下几种的某种混合:
- **把访问控制当作条件反射。** 在一家受监管的公司里,「谁能读这个?」的默认答案是「越少越好」,而这个答案被套用到关于系统的元数据上,仿佛那是客户数据。
- **按席位计价的许可证。** 如果 EA 仓库或数据目录的每一位读者都要花一份许可证,那么阅读就成了一个预算决策。
- **把知识当作筹码。** 一个唯一能回答某个问题的团队,就是一个会被邀请开会、能保住编制、能为预算找到理由的团队。
- **害怕暴露。** 开放的清单会显示出技术债、重复建设的平台和影子 IT。不是每个人都乐意让这些被看见。
- **没有接口。** 数据躺在一个没有 API 的遗留工具里,导出物是某人每季度手工做出来的一张电子表格。
- **单元之间的竞争。** 当两个小队提供相互重叠的平台时,让自己的版图透明,可能感觉像是在给对方递论据。
文献支持其中一些猜测,也让另一些变得更复杂。Thomas Davenport、Robert Eccles 和 Laurence Prusak 研究了二十五家以上公司的信息管理,并在 1992 年以「Information Politics」(信息政治)为题发表了结果。他们观察到,信息技术本应使层级扁平化、让信息自由流动,却常常适得其反:一旦信息成了组织里的通货,管理者就觉得它太宝贵,舍不得给出去。他们发现的最常见的安排,被他们称为*信息封建主义*(information feudalism):每个部门控制着自己的信息如何被收集、存储和共享。三十年后,每个部门都运行着自己的 SaaS 工具,这个描述依然十分贴切。
Catherine Connelly 及其同事更进一步,研究了*知识隐藏*(knowledge hiding),也就是刻意不提供别人索要的知识。他们发现了三种形式:推脱隐藏(承诺给出一个永远不会来的答案,或只给出部分答案)、装傻,以及合理化隐藏(解释为什么这些信息不能共享)。不信任对这三种形式都有预测作用,而在鼓励分享的氛围中,推脱隐藏较少见。研究发表时,其中一位作者直截了当地说出了实际结论:没有信任的氛围,软件再好也没用,人们就是不会去用它。
Gabriel Szulanski 关于企业内部最佳实践转移的研究,是对我那份愤世嫉俗的清单的有益平衡。他考察了八家公司的 122 次转移,发现让知识具有「粘性」的,主要不是动机。主要障碍与知识本身有关:接收单元缺乏吸收它的能力,没有人完全理解这种做法为什么有效,来源方和接收方之间的关系艰难。许多孤岛只是很难用,这让它们既是一个政治问题,也同样是一个设计问题。
Morten Hansen 补充了一个我认为对这个平台至关重要的区分。在一项针对 120 个产品开发项目的研究中,他表明,跨单元的弱联系有助于团队在别处*找到*有用的知识,但转移复杂知识需要相关人员之间的强联系。他称之为搜索与转移问题(search-transfer problem)。Context Model 是一台用于搜索的机器。它可以告诉一个市场单元的工程师,他们需要的平台已经在另一个单元存在,以及由谁在运行。它无法转移运行它的经验。那仍然需要一场对话。
最后,组织里的孤岛会变成版图里的孤岛。Melvin Conway 在 1968 年观察到,设计系统的组织,其产出的设计必然复制自身的沟通结构。十个彼此不沟通的市场单元,会建出十个彼此不沟通的集成平台。Matthew Skelton 和 Manuel Pais 在《Team Topologies》中把这一点倒转过来,提出「逆康威策略」(inverse Conway manoeuvre):按照你想要的架构来设计团队结构。可如果不先看清你现有的架构,就做不好这件事。人类学家出身、后来成为财经记者的 Gillian Tett 在《谷仓效应》(*The Silo Effect*)中提出了更广泛的论点:孤岛是专业知识和专业化的副作用,而不仅仅是恶意的产物,管理孤岛最好的组织,是那些刻意建立起跨越孤岛观察的方法的组织。
### 平台对此能做什么,不能做什么 {#what-the-platform-can-and-cannot-do-about-it}
| 现象 | 研究怎么说 | Context Model 做什么 | 它不能做什么 |
|---|---|---|---|
| 默会知识 | 有些知识无法言说(Polanyi),清晰可读化的方案可能摧毁实践知识(Scott) | 记录能被显性化的部分,链接到知道其余部分的人 | 捕捉判断力和经验 |
| 未被记录的显性知识 | 外化需要一个地方和一种格式(Nonaka 和 Takeuchi) | 给每一个事实一个位置、一个所有者和一个出处 | 让人们把它写下来 |
| 集中的知识 | 群体依赖于知道谁知道什么(Wegner);卡车因子很低(Avelino 等) | 把「谁知道什么」的目录显性化,按应用计算卡车因子 | 传播知识本身 |
| 信息封建主义与知识隐藏 | 信息是通货,隐藏随不信任而增长(Davenport 等,Connelly 等) | 让阅读成为默认,让隐藏作为例外变得可见 | 单凭自己建立信任 |
| 知识粘性 | 障碍主要是吸收能力和因果模糊(Szulanski) | 降低找到和理解上下文的成本 | 取代学习 |
| 搜索与转移 | 弱联系负责找到,强联系负责转移(Hansen) | 解决搜索问题,覆盖所有市场单元 | 取代转移复杂知识的那场对话 |
| 组织孤岛塑造系统 | 系统映照沟通结构(Conway) | 如实展示版图,让团队设计可以有意为之 | 对任何人进行重组 |
最后一列和第三列同样重要。Jeffrey Pfeffer 和 Robert Sutton 把这种普遍的失败称为*知行差距*(knowing-doing gap):组织常常知道该做什么,却依然不去做。一张开放的版图地图弥合的是「知」的那部分。「行」仍然是激励、归属和领导力的问题,这也是为什么这个平台围绕贡献和权威来设计,程度不亚于围绕数据。
这两个问题在架构师那里产生的是同一个症状:知道有什么的成本高于猜测的成本,于是人们去猜。决策基于片面的图景做出,平台被重复建设,协调一致变成了一连串谈判,而不是一连串查询。
## 把问题说清楚 {#the-problem-stated-plainly}
**一家大公司无法低成本、可靠地回答关于它自己 IT 的问题。** 我指的是关于现状的朴素问题,而不是关于未来的难题。存在什么,归谁负责,如何连接,用来做什么,以及它是否符合战略所说的应有样子。
其余一切都源于这一个缺口。战略抵达系统时已经迟了,也走了样,因为不立一个项目,就没有人能对照战略检查系统。平台被建了两遍,因为建第二个的团队找不到第一个。架构评审把时间花在重建现状上,而不是评判提案。运维团队每周回答同样的问题,因为答案不在任何一个人能查到的地方。而那些存在于人脑中、或藏在某人访问策略背后的知识,悄悄地决定了一项决策究竟会考虑哪些选项。
智能体让这件事变得紧迫。一家给每位工程师都配上编程智能体、并在交付管道里运行智能体工厂的公司,即将成倍增加对其 IT 做出决策的行动者数量,而每一个行动者都从零上下文开始。缺少企业上下文的智能体,做的正是缺少上下文的人所做的事,只是更快:它们猜测,它们重复,它们构建早已存在的东西。另一种选择,是给它们以及它们周围的人一个地方,在那里,公司 IT 的现状是已知的、值得信赖的、开放可读的。
那么目标就是:让企业 IT 的现状变得廉价可知,可信到足以据此行动,并向每一个在其上构建的人和智能体开放。
## 一个问题,三种尺度 {#one-problem-three-scales}
回头看,我多年来一直在处理同一个问题,尺度不断变大,直到最近才给它起了名字。
| 角色 | 范围 | 没人能低成本回答的问题 | 我构建或做了什么 |
|---|---|---|---|
| 平台工程师和解决方案架构师,Web 服务交付 | 一个小队的职责:WAF、CDN、入口代理、DNS | 我的 Web 服务是如何暴露和受保护的? | Git 里的清单、一个自助服务门户、承担运维工作的 持久化工作流 |
| 企业解决方案架构师,智能体 AI 与 AI 平台 | 跨越十多个市场单元的解决方案架构 | 我们构建的东西是否符合企业架构和战略的意图? | 评审、指令和参考设计,每一次都从考古开始 |
| 集团 AI 架构师,AI 与数据 | 整个集团的 IT 版图 | 存在什么,它们如何拼在一起,我们应该改变什么? | Enterprise Context Platform |
每一步都在重复同一个模式。先要把数据形式化,然后要让所有人都能读到它,只有在那之后,才能在其上实现自动化,无论是靠工作流还是靠智能体。在 Web 交付小队里,这个模式奏效了。在企业解决方案架构师的角色里,它的缺失是这份工作的主要成本。Enterprise Context Platform 是把它应用到整个公司的尝试。
它也和我在这里写过的东西相连。[上下文就是产品](https://raskell.io/articles/context-is-the-product/)和[智能体平台手册](https://raskell.io/articles/what-an-agent-actually-is/)的其余部分主张,在单个仓库的尺度上,智能体读到的上下文比它所运行的模型更重要。[记忆是一条写入路径](https://raskell.io/articles/memory-is-a-write-path/)讨论的是上下文如何被安全地写回,这和一个数据集如何成为一手来源是同一个问题。关于企业上下文仓库的笔记,在我动手构建任何东西之前,就在公司尺度上勾勒了这个想法。而这个网站本身就是同一件事的玩具版本:每一页都会再为机器发布一次,正如[这个网站正在变成一张地图](https://raskell.io/articles/this-site-is-becoming-a-map/)里所描述的。Enterprise Context Platform 是这些线索在生产环境中交汇的地方。
## 我所说的 Enterprise Context Platform 是什么 {#what-i-mean-by-an-enterprise-context-platform}
EA 仓库是对版图的一份精心整理的描述,由架构师为架构师维护。Enterprise Context Platform 则是一个数据层,覆盖 IT 部门内部发生的一切:构建了什么,部署了什么,暴露了什么,改变了什么,坏了什么,被监控着什么,归谁所有,做出了什么决定,在它发生的时候,从它发生的系统里获取。EA 仓库是它的来源之一,架构师是它的用户之一;而它的主要消费者,越来越多地是智能体。
我开始构建的这个平台有三层,中间那层才是重点。
*Enterprise Context Platform*
```text
SOURCES CONTEXT MODEL SURFACES
EA repository ─────┐
data catalogue ────┤ ┌────────────────────┐
ITSM and CMDB ─────┤ │ entities │ ──▶ Web UI
source code ───────┼──▶ │ relationships │ ──▶ REST API
container platform─┤ │ provenance │ ──▶ MCP, for agents
observability ─────┤ │ confidence │
integration ───────┤ └─────────┬──────────┘
WAF and exposure ──┤ ▼
CDN ───────────────┘ analytics over the model
ingest ▼
artifacts: analyses, business
cases, diagrams, ADRs
```
**摄取。** 每个来源都有一个连接器。其中一部分是静态且确定的:容器平台上的命名空间就是命名空间,源代码平台上的团队就是团队,EA 仓库里的应用有一个 ID。另一部分则需要帮助。把一个名为 `pol-adm-svc-v2` 的仓库映射到 EA 仓库里的应用「Policy Administration」,是一个需要判断的决定,而摄取正是在这里由 AI 辅助的:模型根据名称、README、所有者、部署标签和描述提出这条链接,并记录它有多大把握以及理由。
摄取层还会为每个来源的每个数据集的准确性打分。并不是每个记录系统都值得同等的信任:从容器平台实时拉取的清单接近真实状态,一份每年手工维护一次的应用列表则不然。分数是计算出来的,而不是声明出来的,依据的信号包括新鲜度、必填字段的完整度、该来源在同一实体上与其他来源一致的频率,以及它有多少条记录能通过身份解析。一张来源记分卡记录的内容大致如下:
```yaml
# ingestion/scorecards/ea-repository.yaml (illustrative)
source: ea_repository
dataset: applications
last_ingested: 2026-10-29T03:00:00Z
scores:
freshness: 0.62 # share of records touched in the last 180 days
completeness: 0.81 # mandatory fields present
agreement: 0.74 # facts confirmed by at least one other source
resolvability: 0.88 # records matched to a Context Model entity
overall: 0.76
```
这些分数会传递进模型。从高分数据集推导出的关系,起始置信度高于从低分数据集推导出的关系,而且每个所有者都能看到自己的来源和其他来源相比如何。
**Context Model。** 这就是本体,平台的核心。来源的原始记录并不是模型。模型是从这些记录中推导出的一组抽象实体,以及它们之间的关系:一个 Application 由若干 Repository 实现,以 Workload 的形式部署在 Namespace 中,归一个 Team 所有,支撑一项 Capability,处理某种分类的 Data Object,通过一个 Endpoint 暴露,位于一条 WAF 策略之后,被一个 Dashboard 监控。这个意义上的 Application,就是当 EA 仓库里的一条记录、三个代码仓库、两个命名空间和 IT 服务管理里的一个业务服务被证明是同一个东西时,你得到的那个东西。
**界面。** 模型通过三种方式对外暴露,Web 界面、REST API 和 MCP,每一种服务于不同类型的消费者。三者背后是语义相同的同一批实体,这一点每个月都变得更加重要,正如我在[上下文就是产品](https://raskell.io/articles/context-is-the-product/)中所论证的。
| 消费者 | 界面 | 他们用它做什么 |
|---|---|---|
| 每位开发者和工程师笔记本上的编程智能体(本地 Claude Code 实例) | MCP | 在写下一行代码之前,询问哪个服务拥有某个 API、该部署到哪个平台、参考架构怎么说 |
| SDLC 中的远程智能体工厂 | MCP | 同样的问题,由在管道里而不是在笔记本上构建、测试和修改软件的智能体提出 |
| 企业架构师、解决方案架构师和工程师 | Web 界面 | 发现存在什么,了解一个领域如何拼在一起,在设计评审之前探索依赖关系 |
| 需要上下文的其他系统 | REST API | 下游系统把 Context Model 的数据拉进自己的流程:组合管理工具、风险与合规报告、入职、成本分摊 |
前两行是这个平台必须现在存在、而不是五年后才存在的原因。笔记本上的编程智能体,每次会话开始时都对它所服务的公司一无所知。给它一个通往 Context Model 的 MCP 端点,它就知道该问哪个团队,该复用哪个平台服务而不是重建,以及哪一项架构决策已经排除了它正要采用的方案。把这一点乘以集团里的每一位工程师和每一座智能体工厂,Context Model 就成了公司如何构建软件的共享记忆。
模型之上是分析,而正是在这里,它不再是一份目录,开始成为智能。因为模型是相互连接的,它可以产出产出物:一个市场单元的架构分析,整合三个重叠平台的商业论证初稿,根据实际运行的东西生成的解决方案架构图,一份关于能力覆盖的 EA 视图,一份预先填好现状和选项的架构决策记录。同样的分析还能自己发现业务用例:横跨五个系统、其实两个就够的流程,在四个市场单元里重复建设的组件,可以变得更高效(结果相同,成本更低)或更有效(结果更好,成本相同)的解决方案。这样的发现过去需要某个恰好对两边都了解的人。现在需要的是一次查询,以及一个愿意据此行动的人。
## 为什么本体是最难的部分 {#why-the-ontology-is-the-hard-part}
摄取是管道活。界面是一个 UI 加两个 API。Context Model 才是真正做决定的地方,也是我改变想法最多的地方。
实体模型的一个最小切片大致如下。这只是示意,不是实际的 schema:
```yaml
# context-model/entities.yaml (illustrative)
Application:
identity: [ea_repository.application_id]
derived_from: [ea_repository.application, itsm.business_service]
relations:
realised_by: Repository # many
deployed_as: Workload # many
owned_by: Team # one, accountable
supports: Capability # many
processes: DataObject # many, with classification
exposed_via: Endpoint # many
Repository:
identity: [source_code.repository_path]
relations:
belongs_to: Application # inferred, carries confidence
```
有三件事比我预想的更重要。
**身份解析占了大部分工作。** 同一个应用在每个系统里都有不同的名字,有时根本没有名字。判断两条记录何时是同一个实体,是核心问题。确定性的键能解决其中一部分(一个携带 EA 仓库应用 ID 的部署标签,简直是一份礼物)。其余的靠推断,而推断需要是可见的。
**每条边都带有出处和置信度。** 来自某个 API 外键的边,和模型根据 README 提出的边,是不同种类的事实。两者都有用。把它们同等对待,就是你建出一张漂亮却无人信任的图的方式。每一条关系都记录它来自哪里,最后一次被看到是什么时候,以及它是被断言的、被推导的,还是被推断的。我在讨论上下文仓库时提出过同样的论点,而一旦这张图开始产出人们据以行动的产出物,这个论点就更加成立。
**模型必须有立场,而这些立场必须是企业架构的立场。** 实体类型、关系类型和能力地图都不是中立的。它们是公司战略和 EA 的能力进入平台的地方。如果 Context Model 使用与 EA 相同的能力分类法,那么「哪些系统在所有市场单元中支撑能力 X」就是一次查询,而不是一个项目。这就是我上一个角色里的协调一致问题,被变成了一个数据问题。更多内容见一套智能体能读懂的分类法。
## 一手来源与二手来源 {#primary-and-secondary-sources}
Context Model 中并不是所有数据都具有同等地位,模型会明确说明这一点。
大部分数据起初是**二手来源**:一份副本,从对它具有权威性的系统摄取而来。容器平台对一个命名空间里运行着什么具有权威性。源代码平台对谁有权访问一个仓库具有权威性。Context Model 镜像这些事实,为其打分,把它们连接起来,但如果它与来源不一致,以来源为准,更正也要回到来源那里去做。
有些数据则是**一手来源**:Context Model 就是它的权威所在。起初,这主要是任何其他系统都不持有的东西,即实体之间已确认的链接。没有别人记录这三个仓库、这两个命名空间和那个业务服务是同一个应用。一旦某个团队确认了这一点,这个事实就存在于 Context Model 中,别无他处。
随着时间推移,更多数据会从二手转为一手。当一个数据集经过整理、得分很高、通过模型被到处使用,而原来的工具除了多出一个需要维护的地方之外别无贡献时,明智的做法就是宣布 Context Model 对它具有权威性,并让那份副本退役。
*How a data set changes standing*
```text
┌──────────────────────────┐
│ ingested from a source │ secondary: the source wins
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ scored and connected │
│ in the model │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ curated by its owner, │
│ used through the model │
└─────────────┬────────────┘
▼
┌──────────────────────────┐
│ declared primary in │ an explicit decision, with
│ the Context Model │ an owner and a date
└──────────────────────────┘
```
这种转变始终是一个明确的决定,按数据集逐一做出,有所有者,有日期,这样每个人都知道该去哪里更正一个事实。
## 默认开放 {#open-by-default}
我最坚定持有的前提是:**企业 IT 上下文并不敏感**。存在哪些应用,归谁负责,支撑哪些能力,运行在哪些平台上,如何相互连接:这一切都应该向公司里的任何人开放,也向任何代表他们工作的智能体开放。
这里的 IT 上下文指的是关于系统的元数据,而不是系统内部的数据。客户记录、凭据和密钥不是 IT 上下文,永远不会进入模型。所有描述版图的东西都会进入。
这个论点关乎谁有资格进行整体思考。当上下文受到限制时,只有少数能访问每一个孤岛的人才能看到全貌,他们成了每一项跨越边界的决策的瓶颈。当它开放时,一个市场单元的工程师可以注意到,自己正要构建的平台服务已经在另一个单元存在。一位解决方案架构师可以在评审之前看到一个设计的二阶效应。一个编程智能体可以复用而不是重复。让 IT 上下文民主化,就是让更多的人和更多的智能体参与到创造最大价值的决策中,而不是等待那少数能看到一切的人。
## 开放构建,因贡献而改进 {#built-in-the-open-improved-by-contribution}
这个平台完全构建在开源技术之上。它的核心没有任何供应商产品。这是一个刻意的选择,而且不仅仅是出于成本考虑。
一个要求整个公司信任它对版图描绘的平台,必须对这幅图景是如何形成的保持透明。每一个连接器、每一条打分规则、每一种实体类型、每一个推断提示词,任何愿意去看的人都能阅读和理解。当有人问为什么模型说某个应用属于他们的团队时,答案是一串他们可以追溯的来源和规则,而不是一个黑箱。
同样的开放也让贡献成为可能。团队可以为自己的系统添加连接器,提议实体类型,更正映射,整理自己的数据集。而且他们有这样做的理由。一个在 Context Model 中准确、经过整理、并且有意义地连接起来的数据集,会被集团里的每一位架构师、每一位工程师和每一个智能体使用。它得分高,被人阅读,最终可能被宣布为权威来源。一个陈旧的数据集得分低,这一点每个人也都看得到。激励就内置在模型里:一个团队对其数据投入的心血越多,这些数据就越有价值,对他们自己如此,对其他所有人也是如此。这个想法接近 Zhamak Dehghani 在数据网格(data mesh)中所描述的*数据即产品*(data as a product):了解数据的领域拥有它、整理它,并以明确的质量保证把它提供给他人。Context Model 把同样的原则应用到关于 IT 的元数据上,记分卡就是质量保证。
## 它为架构师改变了什么 {#what-it-changes-for-an-architect}
区别体现在那些变得廉价的问题上。
| 问题 | 以前 | 有了 Context Model |
|---|---|---|
| 市场单元 X 里有哪些应用使用了语言模型? | 发调查问卷,两周 | 一次查询,外加一份需要核实的低置信度匹配列表 |
| 命名空间 `claims-prod-07` 归谁? | 到处打听 | 经由工作负载、仓库和应用找到所属团队 |
| 我们的 AI 解决方案是否遵循集团参考架构? | 逐个评审设计 | 按市场单元,把实际拓扑与参考架构比较 |
| 整合这三个集成平台会牵涉到什么? | 一场研讨会 | 依赖子图,以图表和商业论证初稿的形式呈现 |
| 这份 ADR 还成立吗? | 没人知道 | 对照当前模型检查 ADR 的假设 |
这些答案没有一个是完美的。但它们全都是比一张白纸加一封会议邀请更好的起点。架构师的工作从收集现状转向评判现状,这正是我在架构师现在做什么中描述的转变。
## 从上下文到工作 {#from-context-to-work}
上面那张表是架构师的视角,它低估了这个平台。架构师是最先注意到这个缺口的用户,却不是受益最多的用户。
IT 部门的大部分工作都是例行公事:查找东西,在系统之间翻译,在团队之间协调,执行遵循已知模式的变更。这个归谁,在哪里运行,什么依赖它,适用哪条规则,该填哪张表,谁必须审批,上周改了什么。今天由人来做这些工作,是因为它所需的上下文分散在十几个工具和几百个脑袋里。智能体可以完成其中的大部分,但前提是它能读到那些上下文,而这正是 Context Model 所提供的。
| 今天的角色 | 主要是检索上下文和例行变更的工作 | 智能体需要从 Context Model 获得什么 |
|---|---|---|
| 服务台与运维 | 分派事件、找到所有者、执行标准变更 | 归属、依赖、变更历史、运行手册 |
| 平台运维人员 | 资源开通、暴露、证书、DNS、WAF 例外 | 清单、策略、每项资源的当前状态 |
| 解决方案架构师与企业架构师 | 现状分析、对照原则的合规检查、设计和 ADR 的初稿 | 版图、能力地图、参考架构、过往决策 |
| 安全与合规 | 收集证据、控制检查、暴露面评审 | 暴露了什么,通过什么暴露,涉及哪种数据分类 |
| 工程师与编程智能体 | 在构建之前找到正确的服务、API、平台和约定 | 以上全部,通过 MCP,在编辑器里 |
| 组合管理与 IT 管理 | 清单盘点、成本分摊、合理化候选 | 应用、所有者、使用情况、跨市场单元的重叠 |
我在小尺度上见过这种情况发生。在 Web 交付小队里,一旦清单存在,持久化工作流又能读取它们,这些工作流就接管了过去需要专职运维人员承担的几乎全部运维工作。这种自动化多年前就已经可行;它所缺少的,是足以安全据之行动的上下文。
如果做得对,在整个 IT 部门的尺度上,这会大幅减少一个 IT 组织所需的人数。不是通过取代判断,判断反而会变得更有价值,正如我在架构师现在做什么中所论证的,而是通过去掉那一大块只因为上下文获取成本高昂才存在的工作。这就是商业论证,而且它比更好的架构评审要大得多。一家公司如何处理这一转变中人的那一面,是一个领导力问题,这个平台并不回答它,它值得的审慎,远非一篇博客文章所能给予。
## 上下文比探索便宜 {#context-is-cheaper-than-exploration}
人员编制是商业论证中人们会注意到的部分。他们忽略的部分,是智能体本身会发生什么。
没有企业上下文的智能体照样会继续工作,靠的是探索。被问到谁拥有一个服务、什么依赖于它时,笔记本上的编程智能体会搜索仓库,阅读 README,grep 部署文件,如果有权限还会查询集群,顺着链接进入 wiki,再对它找到的一切进行推理。每一步都是一次工具调用,每一个工具结果都会进入上下文窗口,而这个不断增长的窗口在随后的每一轮都要再付一次费。然后,下一台笔记本上的下一个智能体问同样的问题,从头做一遍同样的探索,之后的每一个智能体也都如此。
这种差别用数量级来看最清楚。下面的数字是我自己的示意性估算,不是测量结果:
```text
Question: "Who owns payment-gateway, and what breaks if we change its API?"
Without a Context Model With a Context Model
--------------------------- --------------------
~25 tool calls (search, read, grep, ...) 1 to 2 MCP calls
~150,000 to 250,000 input tokens ~3,000 to 6,000 input tokens
over the whole exploration one entity and its subgraph
answer: plausible, unverified answer: sourced, scored, current
repeated by every agent that asks computed once, read by everyone
1,000 engineers x 20 such questions a day x ~200,000 tokens
= ~4 billion tokens a day spent rediscovering the same facts
```
token 不是可以忽略的零头。正如我在[推理的经济学](https://raskell.io/articles/the-economics-of-inference/)中所论证的,它们是一种计量资源,表现得更像电力而不是软件许可证,一家向成千上万人推广智能体的企业会在账单上感受到它们。Context Model 把重复的探索变成一次查询。摄取层把昂贵的工作做一次,为其打分并保持更新,之后的每个智能体读取结果即可。这和缓存或物化视图是同一招,只是应用在一家公司对自己的认知上。
第二个效果是质量。上下文窗口是有限的,每一个花在探索上的 token,都是没有花在实际任务上的 token。一个从干净、有出处的子图出发的智能体,是在正确的事实上推理,而不是在它的搜索碰巧翻出来的东西上推理。它也不再犯缺少上下文的智能体的那些典型错误:构建一个已经存在的服务,选择一个公司正在淘汰的平台,违背一项它从未见过的架构决策。在对公司真正重要的意义上,一个智能体从公司已知的东西出发,就会变得更聪明,无论它运行在哪个模型上。我在[上下文就是产品](https://raskell.io/articles/context-is-the-product/)和[检索是工具,不是层](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/)中为单个仓库提出过同样的论点;Context Model 是这个论点在企业尺度上的版本。
第三个效果是我低估了的:沟通变得更清晰。今天,两个团队之间关于「支付网关」的一次对话,可能指的是三个不同的东西,直到一次变更搞坏了错误的那一个,才有人注意到。有了 Context Model,就有一个定义实体的地方,每个实体有一个标识符,还有一套人人都使用的词汇,也就是本体:
| 之间 | 以前 | 有了共享的 Context Model |
|---|---|---|
| 人与人 | 同一个系统有不同的名字,对版图有不同的图景 | 一个实体,一个标识符,一个可以指给对方看的页面 |
| 智能体与人 | 智能体的回答听起来合理,却无法追溯 | 回答引用实体,每个实体又引用其二手来源 |
| 智能体与智能体 | 每个智能体各自探索,交接的是大段文字 | 智能体交接双方都能解析的实体引用 |
这一切都不会把原始来源藏起来。Context Model 返回的每一个事实都带有出处:它来自哪个记录系统,最后一次被看到是什么时候,那个来源得了多少分。本体是共同语言;对于任何想要核实的人或智能体来说,记录系统始终只在一次点击之外。
## 一个新的抽象层级 {#a-new-level-of-abstraction}
退一步看,这在 IT 里是一个熟悉的故事。每一次重大进步,都移动了人们解决问题的层级。汇编让程序员不必再写机器码。C 让他们不必再以寄存器的方式思考。面向对象语言和托管语言让他们不必再管理内存,开始为领域建模。框架、云平台和基础设施即代码移除了一整层又一整层的管道活。每一次,工作都是向上移动,而不是消失,做这些工作的人开始解决更大的问题。
编程智能体是下一步,而且是更大的一步。自 2025 年 11 月发布的 Claude Opus 4.5 那一代模型以来,像 Claude Code 这样的智能体在越来越多的团队里写下了大部分代码,包括我的团队,正如我在[我这些天如何工作](https://raskell.io/articles/how-i-work-these-days/)中描述的那样。一个技术人员现在主要产出的是意图、约束、设计和判断,代码越来越少。我在[源代码是新的汇编](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/)中论证过,代码正在成为 lowering(逐层降低)的目标,就像汇编当年那样。
这改变了这份工作。与智能体一起工作的工程师,花时间的方式就像解决方案架构师、需求工程师或业务分析师那样:理解问题,决定应该构建什么,把它规定得足够清楚以便智能体能构建出来,并判断结果是否有韧性、可扩展、正确。技术背景仍然不可或缺,因为正是它让他们能够做出判断,但他们工作的层级已经整整上移了一层。
在那个层级上,最重要的输入是上下文。一个以架构师方式工作的工程师需要了解版图;一个构建他们所规定之物的智能体也需要了解它。这就是为什么我认为 IT 智能和新的抽象层级是相伴而生的。Context Model 让在更高层级上工作变得安全,因为它是人和智能体共同据以设计的那幅共享、当前、有出处的图景。
## 组织是下一个瓶颈 {#the-organisation-is-the-next-bottleneck}
如果工程师像架构师和分析师那样工作,而智能体承担了大部分实现,那么过去分属不同角色、位于组织架构图上不同方框里的能力,就开始集中到同一批人身上。工程、架构、需求和分析趋于融合。而且它们也开始与管理和决策相竞争。IT 组织里中层管理所做的很多事情是协调:弄清谁知道什么,在团队之间翻译,安排工作顺序,汇报状态。Context Model 和一队智能体恰恰能做很多这样的事。当一个带着智能体的小团队就能理解一个问题、设计解决方案、构建它并运行它时,那些为了围绕稀缺的实现能力协调大团队而存在的层级,就失去了大部分存在的理由。
大多数企业 IT 组织都是围绕这种稀缺来设计的。构建既慢又贵,于是组织长出了配给它的结构:需求管理、项目组合、年度预算周期、漫长的架构评审队列,以及分别负责需求、设计、构建和运行的独立团队。康威定律在这里是双向的。正是这些结构产生了本文开头描述的那片碎片化的版图,而且除非它们改变,它们还会继续产生这样的版图,以智能体的速度。
当构建变得又快又便宜时,瓶颈就会转移。它转移到决定构建什么,以及业务吸收所构建之物的能力上。那些赚钱的业务单元,也就是 IT 所交付的一切的功能性消费者,现在必须跟上:足够精确地表述需求,更快地做出决定,在新的解决方案到来时改变自己的流程,不再把 IT 当作一条排队等候的队伍。一个能在几周内交付过去需要几个季度的东西的 IT 部门,其价值只取决于业务使用它的能力。
我还不知道正确的组织形态是什么。但对它的某些特性,我相当有把握:
- **更小的团队,更宽的职责**,每个团队从理解到运行全程负责一个问题,由智能体完成大部分实现。
- **决策权更靠近业务**,因为理解需求的人和现在能构建解决方案的人,越来越多地是同一个人,或者坐在同一张桌子旁。
- **按产品和成果而不是按项目拨款**,因为项目是稀缺实现能力的计量单位,而这种能力已不再是稀缺的东西。
- **治理作为自动化关卡而不是评审队列**,在设计阶段对照 Context Model 为设计打分,只把真正需要人来处理的事情升级上去,正如带阈值的设计期风险和架构成为一个循环中所写的。
- **把一幅共享的公司图景当作基础设施**,这正是 Context Model 的用途。
这是性质上的转变,而不是程度上的转变。它改变了技术的构建方式,也改变了一个组织必须如何构建自己,才能以技术如今能够被生产出来的速度吸收技术。引入编程智能体却没有 IT 智能的公司,会更快地构建错误的东西。两者都引入却不改变组织的公司,会构建出正确的东西,然后等待组织跟上。三件事都做的公司,五年后看起来会和那些没做的公司截然不同。
## 相关工作,以及这不是什么 {#related-work-and-what-this-is-not}
这里的每一个想法单独来看都不新,之前的工作值得肯定。
**自动化 EA 文档。** 慕尼黑工业大学和因斯布鲁克大学的研究者十多年来一直致力于自动保持企业架构模型的更新,而不是靠手工维护。Farwick 及其同事在 2011 年整理了自动化 EA 模型维护的需求,并在 2013 年分析了公司内部有哪些信息来源可以为 EA 模型提供数据,以及这些数据的质量如何,这正是上文描述的摄取和打分问题。Martin Kleehaus 和 Florian Matthes 后来展示了如何通过对服务进行运行时插桩来保持 EA 模型的更新。最近,Reitemeyer 和 Fill 综述了大语言模型和知识图谱在企业建模中如何结合。这一系列工作是 Context Model 最接近的学术前身,它也表明这个问题由来已久。不过,它的目标是一个更好的 EA 模型。这里的目标则是一个智能体可以据以工作的数据层。
**AI 上下文平台。** 2026 年,业界从另一侧发现了同一个缺口。根据供应商对其报告的摘要,Gartner 已经开始描述一个名为 *AI 上下文平台*(AI context platforms)的类别:构建、治理并向 AI 智能体交付经过语义组织的知识的软件。今年有好几款产品打着这面旗号发布。TopQuadrant 明确把 TQ Data Foundation 作为企业上下文平台来推广。DataHub 发布了一个上下文平台,把来自一百多个数据系统的元数据合并成一张图,通过 MCP 提供给智能体。Neo4j 宣布了一个上下文引擎。而 EA 工具供应商 Ardoq 收购了图数据库 GraphLake,用来构建它所说的「面向企业 AI 的 EA 级上下文图」,其 CEO 宣称企业架构「是 AI 技术栈其余部分赖以运行的基底」。
我把市场的到来看作是对这个缺口真实存在的确认,显然我也不是唯一一个想到「enterprise context platform」这个词的人。但差别很重要,正是这些差别,让这件事不应被理解为又一个 EA 仓库或又一个数据目录:
| | EA 仓库 | 数据目录与上下文产品 | Enterprise Context Platform |
|---|---|---|---|
| 它描述什么 | 应用组合,按架构师的整理 | 分析型数据:表、指标、血缘 | IT 中发生的一切:组合、代码、运行时、暴露、运维、决策 |
| 数据从哪里来 | 主要靠手工录入 | 数据平台和 BI 工具 | 每一个记录系统和每一个平台,并对准确性打分 |
| 有多新 | 和上一次评审一样新 | 紧贴数据栈 | 和来源一样新,每个事实都带有「最后一次被看到」 |
| 它为谁服务 | 架构师 | 分析师和分析类智能体 | IT 中每一个人和每一个智能体,无论什么角色 |
| 权威性 | 仓库本身就是记录 | 镜像来源 | 默认是二手来源,经宣布后成为一手来源 |
| 访问 | 许可席位 | 需要许可,常常按用户计 | 默认向所有人开放 |
| 技术 | 供应商产品 | 供应商产品 | 开源,可读,可通过贡献扩展 |
最近的邻居是开发者门户,比如 Backstage,它的软件目录给一个软件组织提供了一个关于「存在什么」的模型。Context Model 是把这个想法从一个工程组织扩展到整个 IT 部门,从人浏览目录扩展到智能体完成工作。
## 权衡与反对意见 {#tradeoffs-and-objections}
**「这不过是一个 CMDB。」** CMDB 是一个要求团队手工维护的记录系统,这就是它会漂移的原因。Context Model 首先是推导出来的。它不依赖任何人往里输入东西;它读取各个系统本来就在说的内容,并把自己的判断与来源分开保存。CMDB 正确的地方,模型与它一致。CMDB 错误的地方,模型会显示出这种不一致,而这本身就有用。
**「这不过是一个多了些连接器的 EA 仓库。」** EA 仓库非常擅长组合视图,它也是这里最重要的来源之一。但它描述的是架构师所意图和整理的版图,一年几次,供少数持有许可的读者阅读。它不知道集群上运行着什么,WAF 放行了什么,哪个代码仓库真正实现了一个应用,昨晚哪个事件击中了它,或者哪项变更正在进行中。Context Model 由所有这些构建而成,持续不断,为每一个在 IT 中工作的人和智能体服务。EA 仓库为它提供数据;两者不是同一类东西。
**「AI 辅助摄取意味着幻觉出来的架构。」** 如果推断出的边被当作事实呈现,那确实如此。但它们并没有。推断出的关系带有其置信度和推理过程,低置信度的关系会排队等待所属团队确认,而一次确认就会成为一个附有姓名和日期的断言事实。没有这一点,我不会信任这个平台,别人也不应该信任。
**「为什么要自己建?」** 部分原因是本体就是产品,而一个现成买来的本体,编码的是别人的企业。部分原因是来源是供应商工具和内部平台的一种特定组合,没有哪个产品能覆盖。部分原因是一个要求人们信任并为之贡献的平台,必须是他们能够阅读的,开源技术栈允许这一点,供应商产品则不然。还有部分原因是,在请任何人为它出资之前,我需要知道这个想法是否站得住。自建平台是最便宜的诚实测试。
**「一张开放的 IT 版图地图会帮助攻击者。」** 这是我听到最多的反对意见。一个已经进入网络内部的攻击者,只要有足够的时间,就能绘制出版图的大部分;而防守者和建设者,在今天往往做不到。让地图保持封闭,主要保护的是攻击者在耐心上的优势。真正的保护应当放在系统本身上,放在身份、网络控制和密钥管理上,而不是让同事难以知道存在什么。当某个具体细节确实危险时,比如一个具体的漏洞或一份凭据,它就不是 IT 上下文,也不会进入模型。
代价是什么:来源更改 API 时连接器会坏掉,身份解析需要持续维护,而访问权限才是真正的约束。一个能看到整个 IT 版图的平台,需要对整个 IT 版图的读取权限,而在一家受监管的金融集团里,这是一场对话,而不是一次配置变更。我在瓶颈在于读取权限中写过这一点。
## 我在警惕的失败模式 {#failure-modes-i-am-watching-for}
- **漂亮的图。** 一个在演示中令人印象深刻、却回答不了任何真实问题的界面。检验标准是架构师是否会在没人要求的情况下,在评审前主动打开它。
- **无声的过时。** 某个来源连接器失败了,模型继续显示上个月的状态,却没有人注意到。每个实体都需要一个「最后一次被看到」,界面也必须把它显示出来。
- **本体膨胀。** 每个团队都想要自己的实体类型。模型必须保持足够小,小到一个人能在白板上把它讲清楚。
- **对产出物的过度信任。** 一份生成的商业论证读起来很好,却以一种只有所属团队才能发现的方式出了错。产出物是带有来源的草稿,而不是答案。
- **第二个影子仓库。** 如果人们开始在平台里而不是在其记录系统里编辑二手数据,它就会变成它本来要解决的那个东西。对二手数据的更正要回到来源。只有被明确宣布为一手来源的数据,才在 Context Model 中维护。
- **开放被例外侵蚀。** 每个要求隐藏某个字段的团队,都有一个听起来合理的理由。批准得足够多,模型就会变成又一个孤岛。例外需要很高的门槛和一份公开的清单。
- **被操纵的分数。** 一旦分数关乎声望,就会有人去优化分数而不是准确性。这些信号必须始终以与其他来源的一致性为基础,而这很难造假。
## 结语 {#closing}
商业智能让一家公司对它的高管变得清晰可读。IT 智能让它对每一个构建它的人和智能体变得清晰可读;而随着软件构建的层级不断上移,这幅共享的公司图景,会成为其他一切赖以构建的东西。我为架构勾勒的那个循环需要一个出发的地方和一个落回的地方,而 Context Model 就是要成为这两者。
如果你想看看它作为可运行的代码是什么样子,[构建 IT Intelligence](https://raskell.io/articles/building-it-intelligence/) 一文会带你走一遍一个参考实现:它放在一个开源仓库里,里面有一家虚构的公司,你可以在笔记本电脑上运行它。
## 参考文献 {#references}
知识,默会的与显性的:
- Michael Polanyi, *The Tacit Dimension*, Doubleday, 1966; reissued by the University of Chicago Press, 2009, with a foreword by Amartya Sen.
- Ikujiro Nonaka and Hirotaka Takeuchi, *The Knowledge-Creating Company*, Oxford University Press, 1995; an overview of their [SECI model](https://en.wikipedia.org/wiki/SECI_model_of_knowledge_dimensions).
- James C. Scott, *Seeing Like a State*, Yale University Press, 1998, chapter 9 on mētis.
- Daniel M. Wegner, "Transactive Memory: A Contemporary Analysis of the Group Mind", in B. Mullen and G. R. Goethals (eds.), *Theories of Group Behavior*, Springer, 1987; Wegner's own [summary of transactive memory](https://dtg.sites.fas.harvard.edu/DANWEGNER/wjh/tm.htm).
- Guilherme Avelino, Leonardo Passos, Andre Hora and Marco Tulio Valente, [A Novel Approach for Estimating Truck Factors](https://arxiv.org/abs/1604.06766), ICPC 2016.
- [Tribal knowledge](https://en.wikipedia.org/wiki/Tribal_knowledge), Wikipedia, for the term and its usage.
孤岛、隐藏与转移:
- Thomas H. Davenport, Robert G. Eccles and Laurence Prusak, "Information Politics", *Sloan Management Review* 34(1), 1992, pp. 53 to 65.
- Catherine E. Connelly, David Zweig, Jane Webster and John P. Trougakos, [Knowledge hiding in organizations](https://doi.org/10.1002/job.737), *Journal of Organizational Behavior* 33(1), 2012, pp. 64 to 88; a shorter [research brief](https://smith.queensu.ca/insight/content/research-brief-knowledge-hiding-in-organizations.php) from Queen's University.
- Gabriel Szulanski, "Exploring Internal Stickiness: Impediments to the Transfer of Best Practice Within the Firm", *Strategic Management Journal* 17, Winter Special Issue, 1996, pp. 27 to 43.
- Morten T. Hansen, [The Search-Transfer Problem: The Role of Weak Ties in Sharing Knowledge across Organization Subunits](https://doi.org/10.2307/2667032), *Administrative Science Quarterly* 44(1), 1999, pp. 82 to 111.
- Carl G. Sieloff, ["If only HP knew what HP knows": the roots of knowledge management at Hewlett-Packard](https://doi.org/10.1108/13673279910259385), *Journal of Knowledge Management* 3(1), 1999.
- Gillian Tett, *The Silo Effect: The Peril of Expertise and the Promise of Breaking Down Barriers*, Simon and Schuster, 2015.
- Jeffrey Pfeffer and Robert I. Sutton, *The Knowing-Doing Gap*, Harvard Business School Press, 2000.
自动化 EA 文档:
- Farwick, Agreiter, Breu, Ryll, Voges and Hanschke, "Requirements for Automated Enterprise Architecture Model Maintenance", ICEIS 2011.
- Farwick, Breu, Hauder, Roth and Matthes, "Enterprise Architecture Documentation: Empirical Analysis of Information Sources for Automation", HICSS 2013.
- Roth, Hauder, Farwick, Breu and Matthes, "Enterprise Architecture Documentation: Current Practices and Future Directions", Wirtschaftsinformatik 2013.
- Martin Kleehaus and Florian Matthes, [Automated Enterprise Architecture Model Maintenance via Runtime IT Discovery](https://doi.org/10.1007/978-3-030-49640-1_13), in *Intelligent Systems Reference Library* 188, Springer, 2021, pp. 247 to 263.
- Reitemeyer and Fill, [Applying Large Language Models in Knowledge Graph-based Enterprise Modeling: Challenges and Opportunities](https://arxiv.org/abs/2501.03566), 2025.
AI 上下文平台(2026):
- Gartner, *Market Overview for AI Context Platforms*, 13 August 2026, and *How to Navigate the Emerging AI Context Platform Market*, 1 September 2026;我只读过[摘要](https://www.gartner.com/en/documents/8486545),以及 [Atlan 的](https://atlan.com/know/ai-agent/context-layer/gartner-impact-radar-ai-context-platform/)这类厂商总结。
- TopQuadrant, [TopQuadrant Launches Enterprise Context Platform to Build Trusted AI](https://www.einpresswire.com/article/893232971/topquadrant-launches-enterprise-context-platform-to-build-trusted-ai), 18 February 2026.
- DataHub, [Announcing the DataHub Context Platform](https://datahub.com/?p=14496), 2026.
- Neo4j, [Neo4j Context Engine](https://neo4j.com/?p=433599), October 2026.
- Ardoq, [Ardoq Acquires GraphLake to Establish the EA-Grade Context Graph for Enterprise AI](https://www.ardoq.com/news/ardoq-graphlake-context-graph-enterprise-ai), 8 June 2026.
- [Backstage software catalog](https://backstage.io/docs/features/software-catalog), the developer-portal version of the idea.
组织与架构:
- Melvin E. Conway, [How Do Committees Invent?](http://www.melconway.com/Home/Committees_Paper.html), *Datamation* 14(4), 1968, pp. 28 to 31.
- Matthew Skelton and Manuel Pais, *Team Topologies*, IT Revolution, 2019.
- Zhamak Dehghani, [Data Mesh](https://www.thoughtworks.com/insights/books/data-mesh), O'Reilly, 2022.
- Jeanne W. Ross, Peter Weill and David C. Robertson, *Enterprise Architecture as Strategy*, Harvard Business School Press, 2006.
- Michael Nygard, [Documenting Architecture Decisions](https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions), the origin of the ADR.
会议:
- [RSAC Conference](https://www.rsaconference.com/About/FAQ), San Francisco.
- Raffael Schneider and Milan Duric, [Self-Learning WAF: Using Generative AI to Tame ModSecurity False Positives](https://path.rsaconference.com/flow/rsac/us26/FullAgenda/page/catalog/session/1753946922633001YdMq), RSAC 2026, session NCS-W01.
技术:
- Anthropic, [Introducing Claude Opus 4.5](https://www.anthropic.com/news/claude-opus-4-5), November 2025.
- [Model Context Protocol](https://modelcontextprotocol.io/), the protocol behind the agent endpoints.
================================================================================
---
title: "最早的数据公司"
url: https://raskell.io/zh/articles/the-original-data-company/
author: Raffael Schneider
date: 2026-11-01
description: "保险公司说自己不是科技公司。可保险公司卖的是一份包裹在承诺里的预测,从 1693 年的一张生命表起就是如此:它是最早的数据公司。"
tags: [insurance, finance, cryptocurrency, trust, machine-learning, history-of-technology, determinism, fractals, money, probability, surveillance, mortality]
lang: zh-Hans
translation_of: https://raskell.io/articles/the-original-data-company/
---
# 最早的数据公司
## 简而言之
说自己不是科技公司的保险公司和银行,误解了自己的产品:保险公司是一家碰巧持有资产负债表的科技公司,也是现存最古老的数据公司。 货币、保单和账户都是信任的抽象记录。我把技术定义为把信任形式化为流程:让一件事每次都以同样的方式发生,并且可以被检验。 Halley 在 1693 年制作的生命表已经具备保险的全部架构:收集来的数据集、拟合在它上面的模型,以及从模型推导出的价格;核保、定价、准备金和资本建模,全都是预测。 定义风险的数据正在流向汽车、手机、可穿戴设备和建筑物,谁看得见道路,谁就能给风险定出最好的价格;而智能体恰好适合保险公司早已身处其中的符号世界。 资本、浮存金和监管让承诺变得可信,却决定不了谁胜出。所以保险公司应当掌握自己的模型和数据,把流程当作代码,让智能体去探索,同时留下行之有效的东西。
「我们不是一家科技公司。」这句话我在自己任职的保险公司的会议上听到过(这家公司在最近一次合并之后也成了一家银行),在那之前也在我工作过的一家银行里听到过。说这话的是聪明、经验丰富的人,而且通常是当作理由来说的:为什么一个平台不需要自己建,为什么工程是一项需要控制的成本,为什么有意思的工作发生在别处。每一次我都感到困惑,因为我认为事实恰恰相反。保险公司不是一家碰巧使用技术的金融公司。它是一家碰巧持有资产负债表的科技公司,而且严格来说,它是现存最古老的数据公司。
这篇文章就是为这个观点做的论证。它建立在[《河流与运河》](https://raskell.io/articles/the-river-and-the-canal/)之上,那篇文章结尾的观察是:银行和保险公司贩卖的是始终如一;它也建立在一篇关于为什么信任靠始终如一赢得的笔记之上。这不是一篇关于货币政治的文章,尽管它从货币讲起,因为抽象正是从货币开始的。
## 抽象的生意 {#abstract-businesses}
你摸不到一份保单。你也摸不到一个银行账户、一份养老金,或者基金里的一个份额。这些生意卖的东西是抽象的:一个承诺,即在满足某些条件时,某件事会以某种方式发生。经济中很大一部分,也就是经济学家所说的服务业的大部分,都是这样运作的,哪怕从外面看起来并不相像。银行、保险公司、经纪商、支付服务商和土地登记处,产品各不相同,实质却一样。它们卖的是被兑现的承诺。
货币本身是最深刻的例子。教科书上的故事说,人们一直以物易物,直到有人发明了硬币,信用是后来才有的。David Graeber 的[《债:第一个5000年》](https://en.wikipedia.org/wiki/Debt:_The_First_5000_Years)把这个故事拆得七零八落:「事实上,我们关于货币史的标准叙述恰恰是颠倒的。我们并不是先有以物易物,再发现货币,最后才发展出信用体系。事情的发生顺序正好相反。我们今天所说的虚拟货币是最先出现的。」信用体系,也就是记录谁欠谁什么的方式,在美索不达米亚就有文献记载,比铸币的出现(大约在公元前 600 年到公元前 500 年之间)早了几千年。照这样理解,货币一开始就是信任的记录,而且至今仍然是。一种货币的价值,取决于人们相信它值多少,所以更准确的称呼是那个古老的词:信用(credit),来自拉丁语 *credere*,意思是「相信」。
这种记录在今天是如何产生的,并没有听起来那么神秘,也没有大多数人以为的那么公开。2014 年,英格兰银行在它的季刊上发表了一篇短文[「Money creation in the modern economy」](https://www.bankofengland.co.uk/quarterly-bulletin/2014/q1/money-creation-in-the-modern-economy),解释说现代经济中的大部分货币以银行存款的形式存在,而这些存款被创造出来的主要途径,是商业银行发放贷款。瑞士经济学家 [Mathias Binswanger](https://www.fhnw.ch/de/personen/mathias-binswanger) 围绕这件事的后果写了一整本书:*Geld aus dem Nichts*(*Money Out of Nothing*,2015)。书的第一章讲商业银行如何创造货币,章首的标题已经说明了一切:「把银行视为金融中介的错误观念」(*"Die falsche Vorstellung von Banken als Finanzintermediäre"*)。记者 Paul Schreyer 在 *Wer regiert das Geld?*(*Who Governs Money?*,2016)中把这个论点推得更远:
> 一个社会的全部决策权和主权,归结起来就是两个简单的问题:谁可以创造货币?谁来决定它的用途?
>
> *Alle Entscheidungsgewalt und Souveränität einer Gesellschaft läuft auf zwei simple Fragen hinaus: Wer darf das Geld erschaffen? Und wer entscheidet über seine Verwendung?*
关于这对国家和民主意味着什么,有一场规模很大、争论激烈的辩论,我觉得它很重要,但它不是这里的主题。我需要的论点更简单:即便是金融业最基本的产品,也是一种抽象,一份被小心维护的信任记录。
## 这些生意是为了什么 {#what-these-businesses-are-for}
没有人给银行和保险公司写过一份使命书,可它们还是在履行一项使命。每个社会都必须一遍又一遍地回答两个问题,而它从来没能在没有机构的情况下回答它们。资源应该流向哪里?当发生了谁也无法预见的坏事时,由谁来承担代价?经济学家给这两项职能起了名字。第一项是**资本配置**,也叫金融中介:在所有可能的未来之中,决定哪一个获得资金。第二项是**风险汇聚**,也叫互助化:把只落在少数人身上的不幸的代价,分摊给所有本可能遭遇不幸的人。银行做第一件事,保险公司做第二件。两者看起来都像是由我们称为人类的那个集体设计出来的,在某种意义上也确实如此:缓慢地、靠试错、历经数个世纪。
Joseph Schumpeter 比任何人都更清楚地看到了第一项职能。在《经济发展理论》(*The Theory of Economic Development*)中,他描述的银行家不是一个转手他人储蓄的中间人,而是决定哪些新事业能够发生的人:「他使新组合的实施成为可能,仿佛以社会的名义授权人们去建立它们。他是交换经济的监察官(ephor)。」ephor 是古代斯巴达的监察官。Schumpeter 的意思是,银行通过决定把钱借给谁,代表社会决定了建造什么,以及一个文明如何成长。
第二项职能同样古老,同样具有社会性。在有保险公司之前,有家族和氏族在某个成员的房子烧毁时吸收损失,有行会扶助生病的会员,有村庄为火灾和洪水设立的公共基金。Taleb 在《非对称风险》中把这种群体内部的保护称为一种自我保险,「只能对有限数量的人起作用,无法普遍化」。保险公司就是把它普遍化之后得到的东西:同样的事情,在陌生人之间、大规模地、依合同来做:每个人付一点,好让没有人需要付全部。社会保险则通过国家来做这件事。所有这些形式底下的原则都一样,是一种变得可以计算的团结。
这两项职能都是分形的,读过[《一切皆分形》](https://raskell.io/notes/everything-is-a-fractal/)的人到这里已经不会感到意外了。一个人决定把自己的时间、注意力和金钱放在哪里。一个家庭决定哪个孩子上哪所学校,谁来接管农场。一个部落决定谁去打猎、谁留下来。一家公司决定资助哪些产品,一家银行决定资助哪些公司,一个社会决定资助哪些产业。在每一个尺度上都是同一个动作:用有限的资源对未来下注,并分担那些失败赌注的损失。
而在每一个尺度上,赌注都需要有人愿意站到另一边。当克里斯托弗·哥伦布想向西航行,横渡一片欧洲没有人能绘出彼岸的海洋时,他花了好几年寻找支持者,直到卡斯蒂利亚王室同意,而说服并帮助王室的,是 [Luis de Santángel](https://en.wikipedia.org/wiki/Luis_de_Sant%C3%A1ngel),一位筹措了大部分资金的王室财政官员。这就是最纯粹形式的奈特不确定性:没有类似航行的统计表,没有可以衡量的概率,只有判断和甘愿承受损失的意愿。有人选择了接下这个赌注。银行给新事业的每一笔贷款,都是这个选择的缩小版。
Nassim Nicholas Taleb 用一系列书探讨了这些职能的边缘会发生什么。《黑天鹅》讲的是由「稀有性、极端影响,以及事后(而非事前)的可预测性」所定义的事件,而这正是放贷和保险失败得最惨痛的地方。Taleb 对这个行业的一部分格外宽厚。再保险公司承担原保险公司转嫁出去的巨灾风险,在他的描述里,它们「不像银行家」,「足够内省,知道情况其实可能糟糕得多,因为过去二十年没有发生过大灾难,而每个世纪只要有一次这样的灾难,就足以让这门生意说再见。」《非对称风险》从汉谟拉比法典讲起,这部法典惩罚房屋倒塌压死房主的建造者,因为「隐藏风险的最佳地点是『在角落里』,把对稀有事件的脆弱性埋起来,只有建筑师(或交易员)才能察觉。」保险业有一个与之相反的著名例子:在劳合社历史的大部分时间里,以个人身份为保单承保的会员,也就是所谓的 Names,要以自己的全部财产承担责任。而《反脆弱》划出了对一个以吸收他人冲击为职责的机构最重要的区分:「有韧性的东西抵御冲击,保持原样;反脆弱的东西则变得更好。」
对这篇论证而言,要紧的是这些职能的共同点。无论是银行家挑选借款人,核保人给一艘船定价,还是再保险公司给一场飓风定价,工作都是一样的:评估世界,给它标上数字,然后决定以什么价格向谁做出什么承诺。社会把它最重要的两项决定,委托给了核心活动就是计算的机构。这是论证的下一步。
## 技术到底是什么 {#what-technology-actually-is}
如果产品是一份信任的记录,那么要把它做好需要什么?主要需要的是每次都做同样的事。在那篇关于信任的笔记里,我描述了它的两半:**一致性**,即同样的输入在时间推移中得出同样的结果;以及**完整性**,即事物是完整的,并且就是它所声称的那样。一家银行如果根据经办职员的不同而以不同方式记录你的付款,或者一家保险公司的保单所指的东西和它的文件所说的不一样,那它就没有任何东西可卖了。
这也是我对技术的工作定义,至少是对这里要紧的那种技术。剥掉硬件,技术就是把信任形式化为流程:把一件你原本只能选择相信的事,变成每次都以同样方式发生、并且可以被检验的事。在这个意义上,账本是一种技术,复式记账是,数据库事务是,工作流引擎也是。在[《河流与运河》](https://raskell.io/articles/the-river-and-the-canal/)中,我描述了计算的每一层如何让又一件事变得可预测,好让上一层的人不必再去想它。金融机构早在计算机出现之前,就在用纸张、人员和流程做这件事了;而当计算机到来时,银行和保险公司是它最早的商业用户之一,因为它们本来就身处计算机所服务的那门生意之中。
所以我的主张不是抽象的生意应该变成科技公司,而是它们一直都是科技公司,而「我们不是一家科技公司」这句话,是对它们自己产品的误解。在所有这些生意中,保险公司是最清楚的例子。
## 比特币,或没有机构的信任 {#bitcoin-or-trust-without-an-institution}
如果技术是形式化的信任,而货币是信任的记录,那么迟早会有人尝试把货币本身彻底形式化,一直到不再剩下任何机构。2008 年 10 月 31 日,雷曼兄弟倒闭六周之后,也恰好是我开始写这篇文章的十八年前,一个自称 Satoshi Nakamoto 的人向一个密码学邮件列表发送了一条简短的消息,标题是[「Bitcoin P2P e-cash paper」](https://www.metzdowd.com/pipermail/cryptography/2008-October/014810.html)。它所链接的论文[「Bitcoin: A Peer-to-Peer Electronic Cash System」](https://bitcoin.org/bitcoin.pdf)在第一句话里就说明了目标:「一种纯粹点对点的电子现金,将允许在线支付从一方直接发送给另一方,而无需经过金融机构。」几段之后,它点出了它想取代的东西:「我们需要的是一种基于密码学证明而非信任的电子支付系统。」2009 年 1 月网络启动时,它的第一个区块里写着当天《泰晤士报》(*The Times*)头版的一行字:「Chancellor on brink of second bailout for banks.」(财政大臣即将对银行进行第二次纾困。)
这就是为什么比特币,以及它引入的更广泛的分布式账本或区块链的想法,会引起那么大的轰动。它直击抽象金融机构所做之事的核心。银行保管着谁欠谁什么的账本,而 Graeber 表明,这是现存最古老的货币形式。中央银行,以及如英格兰银行所解释的商业银行,决定存在多少货币。比特币用一个每个参与者都可以检验、谁也无法悄悄改写的公共账本取代了前者,用一个算法取代了后者:新币按照固定的时间表出现,每 210,000 个区块减半,直到供应量接近 2100 万枚后停止。用这篇文章的话来说,这是把我对技术的定义推到了极致,信任被形式化得如此彻底,以至于不再需要那个被信任的机构。它也是迄今为止对 Schreyer 第一个问题(谁可以创造货币)最纯粹的回答:谁都不可以,只有协议可以。
接下来发生的事同样富有启发。短短几年内,围绕这个协议就生长出一整个由交易所、托管机构和经纪商组成的行业,因为大多数人并不想自己保管私钥、自己验证交易,也不想在出问题时找不到人打电话。我在[《河流与运河》](https://raskell.io/articles/the-river-and-the-canal/)中提到的那家加密货币经纪商,卖的正是银行所卖的东西:始终如一、妥善保管、一个承诺。比特币回答了谁可以创造货币;它没有回答 Schreyer 的第二个问题,即谁来决定它的用途,也没有回答该资助什么、由谁承担不幸代价的问题。这些职能,资本配置和风险汇聚,仍然由那些对世界进行数字运算的机构来履行,而这正是这篇文章的论点。
然后还有一个我最难放下的问题:它到底是谁发明的。Satoshi Nakamoto 在 2010 年代初停止了公开交流,身份始终没有得到确认;2024 年,一家英国法院裁定,一位著名的自称者 Craig Wright 不是 Satoshi。我自己的猜测是,它可能来自某个情报机构内部,也许是 NSA,也许是别的机构。我要说清楚,这只是猜测,仅此而已。人们指出的线索单薄,但确实存在:比特币核心的哈希函数 SHA-256 属于[由 NSA 设计的 SHA-2 家族](https://en.wikipedia.org/wiki/SHA-2),并在 2001 年和 2002 年作为联邦标准发布;而 NSA 在 1996 年的一份研究报告「How to Make a Mint: The Cryptography of Anonymous Electronic Cash」,早在十多年前就研究过匿名数字货币。这些都不是证据;SHA-256 是公开的,被广泛使用,电子现金的文献在密码学家之间也广为人知。我对待这个想法的方式,就像对待海底的工厂一样:当作一个值得反复琢磨的思想实验。如果它是真的,那将是最奇怪的转折:一个机构造出了旨在让机构变得多余的工具。
## 最早的数据公司 {#the-original-data-company}
1693 年,天文学家 Edmond Halley(就是那颗彗星的 Halley)在 *Philosophical Transactions of the Royal Society* 上发表了一篇论文,标题平淡无奇:「An Estimate of the Degrees of the Mortality of Mankind」。有人把布雷斯劳城的出生和死亡记录寄给了他,他用这些记录制作了一张生命表:同一年出生的一群人中,有多少人活到每一个年龄。然后他用它做了一件新事情。他用这张表计算一份终身年金应该值多少钱,也就是一个特定年龄的人应该付多少钱,才能换来一份直到去世的收入。Halley 给英国王室的建议被忽视了几十年,但这个方法没有。收集来的数据集,拟合在它上面的统计模型,以及从模型推导出的价格:这就是保险的全部架构,也是此后每一家数据公司的全部架构,在任何人说出「大数据」之前三个世纪就已经写下来了。
工具箱的其余部分也大约在同一时期到来。1654 年,Blaise Pascal 和 Pierre de Fermat 在一组关于赌博的通信中推演出了机遇的数学。1713 年,Jacob Bernoulli 身后出版的 *Ars Conjectandi*(《猜度术》)给出了大数定律,正是这个定律让保险公司能对一千栋房子有把握,同时对其中任何一栋都一无所知。而在 1680 年代后期,伦敦 Edward Lloyd 的咖啡馆里,商人和船东为了这家店能提供的最有价值的东西聚在一起:可靠的航运消息。在那里为航行承保的人,后来成了[伦敦劳合社](https://en.wikipedia.org/wiki/Lloyd%27s_of_London)。这家咖啡馆还把名字给了一份航运报纸 *Lloyd's List*。第一个伟大的保险市场,是围绕一项信息服务成长起来的。
我在那篇河流随笔里倚重过的 Frank Knight,解释了这为什么行得通。在他的意义上,风险是你可以在许多相似案例中加以衡量的不确定性,而可衡量的风险是可保的。保险公司是一台把可衡量的风险变成流程的机器。它的全部优势,就在于比下一家保险公司衡量得更好。
## 为模型建模 {#modelling-the-model}
看看保险公司一整天实际上在做什么,然后把它翻译一下。
| 保险公司的叫法 | 科技公司的叫法 |
|---|---|
| 核保 | 预测某一位客户发生损失的概率和规模 |
| 定价 | 一个把这种预测变成在整个业务组合中都站得住的价格的模型 |
| 理赔处理 | 一个带有欺诈检测和例外处理的大批量工作流 |
| 准备金 | 预测已经欠下但尚未知晓的东西 |
| 资本建模 | 在成千上万种情景下模拟整张资产负债表 |
| 再保险 | 向一个为你的模型建模的人购买保障 |
| 分销 | 一个漏斗、一个推荐系统和一个客户界面 |
这些行里没有一行是比喻。定价是拟合在数据上的模型。准备金是一种预测。资本建模是模拟,而且是监管要求的。例如,在[瑞士偿付能力测试](https://www.finma.ch/en/supervision/insurers/cross-sectoral-tools/swiss-solvency-test-sst/)之下,保险公司每年都必须对其整张资产负债表上的风险进行量化,可以用标准模型,或者在标准模型不适合其风险时,用一个经监管机构批准的自有内部模型。欧盟的偿付能力 II(Solvency II)依据的是同样的原则。1992 年的安德鲁飓风让好几家根据过往理赔给风暴定价的保险公司破产,两年后又发生了北岭地震,从那以后,财产保险公司就依赖巨灾模型,在自己的业务组合上模拟飓风、地震和洪水。
而这里面还有一个分形,我忍不住要说。保险公司为世界建模。再保险公司,也就是保险公司的保险公司,为保险公司的模型建模。监管机构为再保险公司和保险公司建模,以决定整个体系需要多少资本。每一层都是把同样的活动放大一个尺度:为下面那一层建立模型,找出它错在哪里,再给这个错误定价。
*An insurer as a prediction pipeline*
```text
┌────────────────────────────┐
│ data about the world │ claims history, exposure, weather,
│ │ vehicles, buildings, health
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ model │ probability and size of loss,
│ │ per customer and per portfolio
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ price and promise │ the policy: a prediction wrapped
│ │ in a contract
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ procedure │ claims handled the same way,
│ │ every time, for decades
└─────────────┬──────────────┘
▼
┌────────────────────────────┐
│ outcomes │ feed the next model
└────────────────────────────┘
```
这条流水线上的每一步,都是我所定义的那种意义上的技术:要么是一个做出预测的模型,要么是一个每次都以同样方式兑现承诺的流程。资产负债表在底下充当兜底,让承诺变得可信。它不是产品。
## 谁看得见道路 {#who-sees-the-road}
如果保险公司的优势在于衡量得更好,那么关于它的未来,最重要的问题就是谁拥有最好的衡量数据。在历史的大部分时间里,答案是保险公司自己:它拥有理赔历史、精算师和各种表格。这正在改变,而最清楚的例子是汽车。
一辆现代汽车是一个碰巧装了轮子的传感器平台。它知道你刹车有多猛,过弯有多快,你是否系安全带,以及你在夜里几点开车。Tesla 已经在美国部分地区销售正是根据这些来定价的保险。它的[实时保险](https://tesla.com/support/insurance/real-time-insurance)根据车辆自身的数据计算出一个安全评分,不需要任何额外设备,并按照评分和行驶里程每月调整保费。
George Hotz 从一个更奇特的角度看到了同一件事。他因为越狱 iPhone 和 PlayStation 3 而出名,之后创办了 [comma.ai](https://comma.ai/),这家公司做一套开源的驾驶辅助系统,人们可以把它加装到自己的车上。在一些访谈中,包括[他与 Lex Fridman 的对话](https://lexfridman.com/george-hotz/),他提出过这样的想法:comma 真正的长期生意可能是保险。一家公司的设备看得到数百万英里是怎么开出来的,它比任何依据年龄、邮编和理赔历史工作的保险公司都更清楚谁是好司机。comma 最终会不会这么做并没有那么重要,重要的是这个逻辑,它无懈可击。谁拥有最好的风险模型,谁就能给出最好的价格,而最好的模型属于看得见道路的人。
同样的逻辑远远不止适用于汽车。手机知道人们如何移动,手表知道他们怎么睡觉、心脏如何跳动,建筑物也越来越知道自己的水管什么时候漏水。这些传感器中的每一个,都可能是一个掌握在非保险公司手中的核保模型。一家相信自己不是科技公司的保险公司,是一家还没有注意到自己真正的竞争对手是谁的公司。
## 简单说说银行和经纪商 {#banks-and-brokers-briefly}
这个论证可以迁移过去,只是名词不同。银行的核心决策,即是否放贷,是一种预测:这个借款人会还钱吗?信用评分是一个模型,1989 年 FICO 在美国把它做成了一种通用评分,而现代放贷机构运行在丰富得多的模型之上。支付是一个巨大的实时欺诈检测问题。交易台是模型和执行引擎。经纪商是一个附带公平执行承诺的撮合与路由系统。它们每一个卖的都是一个预测或一个流程,包裹在信任之中,由资本作为后盾。资产负债表让承诺变得可信。技术让承诺成为现实。
## 这句话为什么挥之不去 {#why-the-sentence-persists}
如果论证这么清楚,为什么这些公司里聪明的人还一直在说「我们不是一家科技公司」?我认为有三个原因,没有一个是因为愚蠢。
第一个是会计。在大多数银行和保险公司里,IT 是作为服务于「业务」的成本中心成长起来的,组织架构图至今仍然反映着这一点。我在[《河流与运河》](https://raskell.io/articles/the-river-and-the-canal/)中写过的康威定律完成了剩下的事:一家把技术当作支持职能来组织的公司,会建出表现得像支持职能的系统,而这又反过来印证了那个信念。
第二个是身份认同。在公众的想象中,「科技公司」意味着硅谷:消费类应用、连帽衫、不惜代价的增长、习惯于把东西搞坏。一家信守承诺一个半世纪的瑞士保险公司不想成为那样,它这样想也是对的。但解决办法是给技术一个更好的定义,而不是拒绝它。一个半世纪始终如一地信守承诺,本身就是一项技术成就。
第三个是,这些公司里的技术已经老到变得看不见了。我在河流随笔里描述的那个棘轮在这里同样适用:一旦某一层能正常工作,就再也没有人看得见它。保险公司里没有人会惊叹于精算表、保单管理系统或理赔工作流,就像没有人会惊叹于自来水一样。它们只是做事的惯常方式。Marc Andreessen 在 2011 年写道,软件正在吞噬世界。对保险公司来说,它们早就被吞下去了,此后一直在被消化。
## 为什么现在要紧 {#why-it-matters-now}
如果什么都没有在变,这只会是一桩趣闻。但有两件事在变。
第一件是传感器,如上所述。定义风险的数据正在从保险公司手中流出,流向汽车、手机、可穿戴设备和建筑物。一家不把自己看作数据公司的保险公司,会在某一天醒来发现,自己成了一张被别人的模型租用的资产负债表。
第二件是智能体。在那篇河流随笔里我论证过,语言智能体在符号世界中最强,也就是文档、合同、流程和代码的世界,而这恰恰是银行和保险公司早已身处的地方。它们的产品是合同,它们的工厂是流程。这让它们成为受智能体能力影响最大的公司,也是最有条件从中获益的公司,前提是它们把智能体当作一种新的工程,而不是一种新的供应商。一家把自己看作科技公司的保险公司会问:怎样让智能体去探索它的理赔、核保和运营,又怎样把它们的发现变成它可以信任的流程。一家把自己看作别的什么的保险公司,会去买一个聊天机器人。
## 诚实的反驳 {#the-honest-counterargument}
确实存在一个真正的反对意见,它值得一个真正的回答。保险公司不只是模型。它们持有用于承担风险的资本,这是任何软件公司都没有的。它们利润的很大一部分,来自在支付理赔之前把收来的保费拿去投资,也就是 Warren Buffett 所说的浮存金:保险公司持有却并不拥有的钱。它们作为金融机构受到监管,它们的品牌建立在稳健之上,而不是代码之上。这难道不是说明它们首先是金融公司吗?
我认为这只说明它们也是金融公司,这和首先是金融公司不是一回事。资本让承诺变得可信:没有它,一个预测只是一种意见。浮存金是承诺的时间差带来的结果。监管之所以存在,是因为这些承诺太重要了。但这些东西没有一样是客户购买的,也没有一样决定一家保险公司能否胜过另一家。两家拥有同样资本、受同一监管机构管辖的保险公司,输赢取决于谁更好地衡量风险、更好地给风险定价,以及更一致、更低成本地信守承诺。这些全都是技术问题。Buffett 本人就警告过,浮存金可能被糟糕的承保结果吞没,换句话说,模型排在第一位。
## 如果你接受它,会有什么改变 {#what-changes-if-you-accept-it}
如果保险公司是一家科技公司,那么有几件事随之而来,而且没有一件需要连帽衫。
- **掌握模型。** 定价、核保、理赔分诊和资本模型就是产品。把它们外包,就是把生意外包。
- **掌握数据,以及数据周围的上下文。** 包括关于你自己系统的数据,这正是[《IT Intelligence》](https://raskell.io/articles/it-intelligence/)的论点:一家无法回答关于自身问题的公司,无法在自身之上建立可靠的技术。
- **把工程师、精算师和数据科学家看作同一门手艺。** 他们在用不同的工具做同一件事:把不确定性变成流程。
- **让流程成为一等公民。** 理赔和核保流程就是代码,无论它们写在手册里还是工作流引擎里。像对待代码一样对待它们:做版本管理,用过去的案例测试,可以重放。
- **到传感器所在的地方去。** 与那些看得见道路、住宅和身体的公司合作,或者成为其中之一。
- **让智能体去探索,留下行之有效的东西。** 保险公司最古老的本领,把衡量过的风险变成每次都以同样方式运行的流程,恰恰是智能体时代所需要的本领。
## 结语 {#closing}
Halley 的生命表是一个数据集、一个模型和一个价格。劳合社是一个围绕新闻服务建立起来的保险市场。此后的每一份保单,都是一个包裹在承诺里的预测;每一个理赔部门,都是一个为了每次以同样方式兑现那个承诺而设计的流程。这就是对这些生意而言唯一要紧的那种意义上的技术:信任的形式化。保险公司不需要变成科技公司。它们需要注意到自己已经是了,并且注意到,争夺下一个世界模型的竞争已经开始,而且往往发生在那些根本不把自己叫作保险公司的公司里。
## 参考文献 {#references}
- David Graeber, *Debt: The First 5,000 Years*, Melville House, 2011,2014 年更新扩充版。
- Michael McLeay, Amar Radia and Ryland Thomas, [Money creation in the modern economy](https://www.bankofengland.co.uk/quarterly-bulletin/2014/q1/money-creation-in-the-modern-economy), Bank of England Quarterly Bulletin, 2014 Q1.
- Mathias Binswanger, *Geld aus dem Nichts: Wie Banken Wachstum ermöglichen und Krisen verursachen* (Money Out of Nothing: How Banks Enable Growth and Cause Crises), Wiley-VCH, 2015;译文为作者自译。
- Satoshi Nakamoto, [Bitcoin: A Peer-to-Peer Electronic Cash System](https://bitcoin.org/bitcoin.pdf), 2008,以及 2008 年 10 月 31 日[在密码学邮件列表上的发布公告](https://www.metzdowd.com/pipermail/cryptography/2008-October/014810.html)。
- [比特币创世区块](https://en.bitcoin.it/wiki/Genesis_block)及其中嵌入的《泰晤士报》(*Times*)标题。
- [SHA-2](https://en.wikipedia.org/wiki/SHA-2),由 NSA 设计、NIST 标准化的哈希函数家族。
- Laurie Law, Susan Sabett and Jerry Solinas, "How to Make a Mint: The Cryptography of Anonymous Electronic Cash", National Security Agency, 1996.
- Paul Schreyer, *Wer regiert das Geld? Banken, Demokratie und Täuschung* (Who Governs Money? Banks, Democracy and Deception), Westend, 2016;译文为作者自译。
- Joseph A. Schumpeter, *The Theory of Economic Development*, 1911,英译本 1934;银行家一段引文转引自 [Festré and Nasica, MPRA paper 67694](https://mpra.ub.uni-muenchen.de/67694/1/MPRA_paper_67694.pdf),所据为 1983 年版第 74 页。
- [Risk pool](https://en.wikipedia.org/wiki/Risk_pool),关于风险汇聚与互助化。
- [Luis de Santángel](https://en.wikipedia.org/wiki/Luis_de_Sant%C3%A1ngel),关于哥伦布首次航行的资金来源。
- Nassim Nicholas Taleb, [《黑天鹅》](https://en.wikipedia.org/wiki/The_Black_Swan:_The_Impact_of_the_Highly_Improbable)(*The Black Swan*,2007)、[《反脆弱》](https://en.wikipedia.org/wiki/Antifragile_(book))(*Antifragile*,2012)和[《非对称风险》](https://en.wikipedia.org/wiki/Skin_in_the_Game_(book))(*Skin in the Game*,2018)。
- Edmond Halley, [An Estimate of the Degrees of the Mortality of Mankind](https://ui.adsabs.harvard.edu/abs/1693RSPT...17..596H/abstract), *Philosophical Transactions of the Royal Society* 17, 1693,第 596 至 610 页。
- Jacob Bernoulli, *Ars Conjectandi*, 1713.
- [Lloyd's of London](https://en.wikipedia.org/wiki/Lloyd%27s_of_London),关于它起源于 Edward Lloyd 的咖啡馆。
- Frank H. Knight, [*Risk, Uncertainty, and Profit*](https://www.econlib.org/library/Knight/knRUP.html), 1921.
- Tesla, [Real-Time Insurance](https://tesla.com/support/insurance/real-time-insurance) 与安全评分(Safety Score)。
- [comma.ai](https://comma.ai/) 以及 [Lex Fridman 播客对 George Hotz 的访谈](https://lexfridman.com/george-hotz/)。
- 关于安德鲁飓风之后的巨灾建模:[Insurance Journal, Lessons Learned from Hurricane Andrew](https://www.insurancejournal.com/magazines/mag-features/2017/09/04/462873.htm)。
- FINMA, [Swiss Solvency Test](https://www.finma.ch/en/supervision/insurers/cross-sectoral-tools/swiss-solvency-test-sst/).
- [The History of the FICO Score](https://blog.myfico.com/history-of-the-fico-score/).
- Marc Andreessen, "Why Software Is Eating the World", *The Wall Street Journal*, 2011.
- Warren Buffett, 致 Berkshire Hathaway 股东的信,关于保险浮存金。
================================================================================
---
title: "河流与运河"
url: https://raskell.io/zh/articles/the-river-and-the-canal/
author: Raffael Schneider
date: 2026-10-31
description: "智能体在崎岖的世界里探索;工作流是探索留下的东西。国际象棋、星际争霸、海底的工厂,以及我为什么要造一台引擎。"
tags: [agents, game-ai, fractals, abstraction, determinism, durable-execution, trust, factories, post-scarcity, legibility, finance, insurance, chess, go-game, starcraft, internet-culture]
lang: zh-Hans
translation_of: https://raskell.io/articles/the-river-and-the-canal/
---
# 河流与运河
## 简而言之
智能体最擅长探索开放、迷雾重重的问题;确定性工作流最擅长重复已知的问题。银行、保险公司这类贩卖「始终如一」的企业,依赖的是后者。 计算的每一层都让又一件事变得可预测,好让人们不必再去想它;一个包揽一切的智能体编排器,是第一个把思考重新交还回来的层。 行得通的设计是一座元工厂:智能体去探索,把行之有效的做法写成工作流,由确定性引擎来运行;世界变了,再由智能体修复或退役它。 工作流里仍然可以包含有边界的智能体步骤,就像运河上的船闸:判断留在需要它的地方,其余部分则可审计、可重复、成本低廉。 并非一切都应变成流程:边缘的智能体会一直留下,因为迷雾永远不会完全散去。
*开始之前说明一下:这篇文章和本站大多数文章不同。它是一篇哲学随笔,而不是技术文章,篇幅也长,大约需要四十五分钟读完。它从一张照片开始,以一台工作流引擎的名字结束,中间经过分形、游戏、宇宙学、一个世纪以来关于组织的思考、一个来自 4chan 的故事,以及一份你周一就能用上的实地指南。比起我在这里写过的任何文章,它更是一张我如何思考的地图。如果你只想看实用的部分,可以[直接跳到实地指南](#a-field-guide)。*
我写这篇文章的咖啡馆墙上挂着一张照片,是摄影师 Armin Grässl 的作品[*Whispering Current*](https://www.armingraessl.ch/collection/006-whispering-current)。他自己的图注开头是「在巨大的岩石之间,水流开辟出自己的道路」,照片拍的正是这个:一条山间河流漫过满是岩石的河床,激荡处泛白,积聚处幽暗,身后的松树渐渐消融在雾中。这条河没有哪两米的水流是一样的。在任何我们能理解的意义上,水都不知道自己要去哪里。它试探每一道缝隙,填满每一处凹陷,一块岩石接一块岩石地,在无人规划过的地形中找到一条路。
我一再看它,因为它回答了一个我坐在书桌前答不出的问题。几周前,我开始用 Rust 写一个持久化工作流引擎,属于 [Temporal](https://temporal.io/) 和 [Restate](https://restate.dev/) 那一类,暂定名叫 *tsumugi*。这是个合理的项目。一个自成一体、从库起步、再成长为集群的引擎是有用的,我在一份很长的设计说明里写下了理由。但那份说明一直绕着一个问题打转,却始终没有回答它:既然智能体就能把活干了,2026 年为什么还会有人需要工作流引擎?
构建在 [Claude Code](https://www.anthropic.com/claude-code) 这类框架上的智能体,恰恰擅长那条河所做的事。给它一个目标,再加上一个陌生的代码库、一次失败的部署或一个含糊的请求,它就会试探、失败、调整,然后找到出路。如果这就是工作的新形态,那么工作流引擎,连同它固定的步骤和对确定性的坚持,看起来就像是为一个正在终结的世界准备的工具。
我不这么认为,但答案最终比这个项目大得多。它也以这个项目的新名字收尾,而这个名字,我是在这篇文章里找到的。
## 一切皆分形 {#everything-is-a-fractal}
再凑近看那条河,它又做了另一件事。水流绕过一块大石的样式,会在较小的石头周围重复,又在石头之间的卵石周围重复。河后的树分叉的方式和河流分叉的方式一样,枝条又再分叉。Benoit Mandelbrot(曼德博)在 1982 年出版的[《大自然的分形几何学》](https://en.wikipedia.org/wiki/The_Fractal_Geometry_of_Nature)开篇,写下了让这种观看方式广为人知的一句话:「云不是球体,山不是圆锥,海岸线不是圆,树皮并不光滑,闪电也不沿直线行进。」自然是粗糙的,而它的粗糙在不同尺度上看起来彼此相似。这种[自相似性](https://en.wikipedia.org/wiki/Self-similarity),正是[分形](https://en.wikipedia.org/wiki/Fractal)的含义。
这是我怀抱最久的一个想法,比本站上任何一个项目都久,它贯穿接下来的一切;我把一个较短的版本写成了一则笔记,[一切皆分形](https://raskell.io/notes/everything-is-a-fractal/)。我认为我们很可能生活在一个在时间和空间上都没有边界的世界里,向每个方向无尽延伸;在这样的世界里,分形是最自然的形状:同样的模式在每一个尺度上重现,没有最大的实例,也没有最小的实例。宇宙学家给这个想法的强版本起了名字,叫[分形宇宙学](https://en.wikipedia.org/wiki/Fractal_cosmology),即物质在所有尺度上都呈分形分布的假说。这是少数派的立场;大多数宇宙学家对星系巡天数据的解读是,宇宙在几亿光年以上的尺度上会变得均匀。所以,我把这个无限的、分形的世界当作一种工作直觉来持有,而不是一个我能在物理研讨会上辩护的主张。但作为一种关于观念、组织和机器如何运作的直觉,它从未让我失望。
和我这一代的许多人一样,我是通过《侏罗纪公园》接触到它的。Michael Crichton 的 [1990 年小说](https://en.wikipedia.org/wiki/Jurassic_Park_(novel))是我最喜欢的书之一,它围绕混沌理论展开;当时大多数读者如果接触过混沌理论,也是通过 James Gleick 1987 年的[《混沌:开创新科学》](https://en.wikipedia.org/wiki/Chaos:_Making_a_New_Science)。Crichton 笔下的数学家 [Ian Malcolm](https://en.wikipedia.org/wiki/Ian_Malcolm_(character)) 的形象,部分就来自 Gleick。小说不是分成「部」,而是分成「迭代」,每一次迭代都以同一个分形的图开头,即[海威龙形曲线](https://en.wikipedia.org/wiki/Dragon_curve),每一次都比上一次多折叠一点。在 1993 年的电影里,Malcolm 说出了那句人人都记得的台词:「生命,呃,总会找到出路。」这又是那条河。
我从这一切中得到的,是一个关于观念的观念。最著名的分形[曼德博集合](https://en.wikipedia.org/wiki/Mandelbrot_set),来自一条反复应用的极小规则:取一个数,平方,加上一个常数,重复。迭代简单的东西,会产生丰富程度没有上限的东西。我认为好的想法也是这样运作的,在科学、工程、商业以及我所知道的每一门手艺里都是如此。最好的想法很少是飞跃。它们是在前人基础上的小小迭代,一个简单的改进,恰好加入足够的新意,让一种新的行为涌现出来,然后它们就成为其他所有人在其上构建的那一层。[Stuart Kauffman](https://en.wikipedia.org/wiki/Stuart_Kauffman) 把这类下一步所构成的空间称为*邻近可能*:在任何时刻,只有某些步骤离现存的事物只有一步之遥;Steven Johnson 后来用这个说法作为他那本探讨好想法从何而来的书的开篇。Michael Tomasello 把这个机制的另一半描述为[棘轮](https://en.wikipedia.org/wiki/Ratchet_effect):每一代人都保留上一代建造的东西,再添上一点,而得到的进步不会倒退。
正是这个棘轮,让进步给人那样的感觉。一层一旦存在,我们就对它视而不见。没有人会为自来水、函数调用或搜索引擎惊叹,也没有人能回到它们出现之前的世界。AI 现在也在同一个棘轮上。无论人们怎么看它,总会有人迈出下一步,再下一步,而这一层终将变得寻常。
我的思考往往是这样运作的:融合的、收敛的,从截然不同的地方汲取想法,直到发现它们其实是同一个想法在不同尺度上的样子。这篇文章就是一个例子。分形会不断回来:在游戏里,在企业里,在编排器里,在海底的工厂里,也在那台引擎的名字里。
## 两种游戏 {#two-kinds-of-games}
我一直在读 Sebastian Mallaby 的《无限机器》(*The Infinity Machine*),这本书写的是 Demis Hassabis 和 DeepMind,我[在这里写过书评](https://raskell.io/articles/win-everything-control-no-one/)。在第十三章,围棋和国际象棋的胜利之后,DeepMind 转向《星际争霸 II》,Mallaby 描述了为什么这是一类不同的问题:
> 星际争霸与其说像棋盘游戏,不如说更像人类的生活经验:一条连绵不断的选择与子选择之流,有些涉及长期规划,有些更为紧迫,而这一切又因不完全信息的迷雾而更加令人困惑。
国际象棋是最纯粹的封闭游戏。棋盘完全可见,规则永不改变,双方轮流走子,终局有明确定义:将死,或者和棋。一切可能发生的事,原则上都事先可知。星际争霸恰恰相反。你只能看到你的单位看得到的东西,其余部分的名字就叫[战争迷雾](https://en.wikipedia.org/wiki/Fog_of_war)。没有什么会等你的回合,而什么算赢,取决于对手此刻正在做什么。DeepMind 最终确实造出了 [AlphaStar](https://en.wikipedia.org/wiki/AlphaStar_(software)),按 Mallaby 的记述,到 2019 年 10 月,它在对阵排位人类玩家的比赛中赢下了 99.8% 的对局;但这需要另一种机器:一台学会在不确定中行动的机器,而不是一台在已知的树中搜索的机器。
我玩过很多星际争霸。对我来说,这两种游戏的区别不是纸上谈兵。在国际象棋里,你可以是对的。在星际争霸里,你只能比对手错得少一点,并且比他快那么一点。星际争霸还以国际象棋所没有的方式呈现出分形。Mallaby 说的「选择与子选择」是准确的:同一个问题,也就是在迷雾中、在时间不够时做决定,会在每一个时间尺度上重复,从整局游戏的经济,一直到某一秒里某一个单位的移动。
### 第三种游戏 {#the-third-game}
与此同时,在大洋彼岸,另一个实验室正在下另一种赌注。2017 年,Google 的一个团队在一篇题为[〈Attention Is All You Need〉](https://arxiv.org/abs/1706.03762)的论文中提出了 [transformer](https://en.wikipedia.org/wiki/Transformer_(deep_learning_architecture))。Mallaby 描述了 Ilya Sutskever 读到这篇论文时从椅子上跳起来的情景。OpenAI 把 transformer 对准了语言:一个[生成式预训练 transformer](https://en.wikipedia.org/wiki/Generative_pre-trained_transformer),也就是 GPT,被训练来续写文本。GPT-2 于 2019 年 2 月问世,那时 DeepMind 正深陷于星际争霸之中;2022 年底,它的对话式后代 [ChatGPT](https://en.wikipedia.org/wiki/ChatGPT) 轰动了全世界。
DeepMind 也有 transformer;AlphaStar 就是在它之上构建的。DeepMind 缺少的,是相信语言才是值得去玩的那场游戏的信念。Mallaby 对原因说得很直白:「在语言建模这件事上,Hassabis 的品味出了偏差,原因包括他对没有根基的符号的怀疑、他对游戏的热爱,以及他的预设:人类经验比互联网上所有的文本更加多样,或许也更加宏大。」Hassabis 本人对此倒是很大度:「你看,你不可能每次都当诺查丹玛斯。」
在我看来,这与其说是技术上的失误,不如说是哲学上的失误。语言是第三种地形,既不是国际象棋,也不是星际争霸:它是人类用符号建造起来的世界,用来描述、压缩和协调另外两种。合同、法律、流程、代码、文档、Linux 机器上的 shell。Hassabis 押注智能将在游戏和物理世界中赢得,而第一批通用智能体却是通过文本到来的。
并非所有人都认为这就有了定论。[Yann LeCun](https://en.wikipedia.org/wiki/Yann_LeCun) 多年来一直主张,语言模型单靠自己无法达到人类水平的智能,因为人和动物是通过在现实中行动来了解现实的,而不是通过阅读。他于 2025 年 11 月离开 Meta,创办了 [AMI](https://techcrunch.com/2026/01/23/whos-behind-ami-labs-yann-lecuns-world-model-startup/),这家公司在 2026 年融资略高于十亿美元,用于构建世界模型;它的使命宣言说,真正的智能「并不始于语言。它始于世界。」在他看来,今天的智能体生活在一个由编程语言、解释器和终端会话构成的狭窄世界里,而真正的迷雾在别处。
他的立场背后有一个古老的观察。1988 年,机器人学家 Hans Moravec 在《心智儿童》(*Mind Children*)中指出,让计算机在智力测验或跳棋上表现得像成年人相对容易,而要让它们具备一岁孩子的感知和行动能力却非常困难。我们觉得难的东西,符号和逻辑,对机器来说却很容易。我们觉得毫不费力的东西,比如走过河床而不滑倒,反倒成了难题。这个观察被称为[莫拉维克悖论](https://en.wikipedia.org/wiki/Moravec%27s_paradox)。
我认为 Hassabis 的批评者和 LeCun 都说对了一些东西,而这个区分正好贯穿整篇文章。我所写的智能体,探索的是符号世界内部的迷雾:陌生的代码库、含义模糊的文档、没有文档的 API。那个世界有规则,但规则如此之多、执行得如此松散,以至于从内部看,它表现得就像星际争霸。照片里的那条河,以及终有一天必须渡过它的机器人,需要的是 LeCun 正在构建的东西。但那些贩卖「始终如一」的企业,银行、保险公司和行政机构,几乎已经完全生活在符号世界里了。它们的产品是合同,它们的工厂是流程。那恰恰是语言智能体最强的地形,也恰恰是为什么「它们应该留下什么」这个问题在那里如此重要。
## 风险与不确定性 {#risk-and-uncertainty}
国际象棋和星际争霸之间的区别,在经济学里有一个古老得多的名字。1921 年,Frank Knight 出版了[《风险、不确定性与利润》](https://www.econlib.org/library/Knight/knRUP.html),划出了一条至今仍然有用的界线。**风险**是可以度量的不确定性:在单个案例中你不知道会发生什么,但你知道许多相似案例的分布。而 Knight 严格意义上的**不确定性**([奈特不确定性](https://en.wikipedia.org/wiki/Knightian_uncertainty)),是无法度量的那一种,因为根本不存在一组有意义的相似案例可供计数。风险原则上可以投保,不确定性不能。Knight 还认为,在竞争性经济中,利润来自不确定性而不是风险,因为可度量的风险会被定价,然后在竞争中被消磨殆尽。
带着这两种游戏再读一遍。保险公司实实在在就是一台把风险变成流程的机器。它接手那些对每个客户来说都不可预测的事件,比如水管爆裂、车祸或自行车被盗,让它们在总体上变得可预测,然后用一个每次都相同的流程去处理每一件。企业家、研究者和机器人工程师生活在 Knight 那条线的另一侧。他们的利润如果有,也来自在无人能度量胜算的地方行动得当。
这就赋予了两种游戏一层经济含义。封闭游戏是风险可以度量的游戏,所以正确的回应是流程。开放游戏是不确定性无法度量的游戏,所以正确的回应是判断、探索和适应。两者都有价值,但不是同一种价值。
## 两种企业 {#two-kinds-of-businesses}
一旦你看清了这两种游戏,企业就会出人意料地清晰分成两类。
银行、保险公司、税务局、土地登记处、养老基金,以及加密货币经纪商这样的新来者,卖的都是某种抽象的东西。你摸不到一份保单。客户买的是一个承诺:当某些条件满足时,某件事会以某种方式发生,每一次、对每一个人、持续几十年。这类企业的价值就在于它的始终如一。一项理赔如果因为当天的心情不同而处理得不同,那不是特色,而是产品失灵。
德国社会学家 [Niklas Luhmann](https://en.wikipedia.org/wiki/Niklas_Luhmann)(卢曼)为此给出了一个精确的名字。在 1968 年的《信任》(*Vertrauen*,英译本收入 *Trust and Power*,即《信任与权力》)中,他把信任描述为一种化简复杂性的方式:你无法核实一切,所以你决定依赖什么。他区分了**人格信任**,即对你认识的某个人的信任,和**系统信任**,即对货币、银行这类制度的信任,你依赖它们,却不认识其中的任何人。没有人是因为信任柜员才信任自己的银行。他们信任银行,是因为他们相信无论柜员是谁,这个系统都会以同样的方式运作。[Max Weber](https://en.wikipedia.org/wiki/Max_Weber)(马克斯·韦伯)早半个世纪就针对[科层制](https://en.wikipedia.org/wiki/Bureaucracy)提出了同样的观点:它的力量,以及它的正当性来源,在于可计算性,即统一地、不问对象是谁地适用规则。科层制就是一个承诺:你可以预测它会做什么。
加密货币经纪商是这一点最新也最极端的版本。它的客户被要求信任代码本身,也就是[智能合约](https://en.wikipedia.org/wiki/Smart_contract);在最纯粹的情形下,流程确定到可以在公共账本上运行,任何人都能重放它。无论你如何看待这个行业,它都是对这个原则的一次惊人示范:当人格信任完全缺席时,确定性就必须承担一切。
另一些企业则与物理世界讨价还价:机器人、能源、航天、农业、医疗,以及任何一个研究实验室。它们脚下的地形在变。昨天还能用的机械臂,今天遇到一个略微弯曲的零件。钻机遇到无人预料到的岩层。它们的价值在于当场适应,而一个不能变通的流程是一种负担。
大多数真实的公司两者兼有,而分界线穿过的是部门,而不是公司之间。保险公司的理赔部门在下国际象棋,它的产品开发在打星际争霸。而这个模式在每一个部门内部又会重复:银行是由流程组成的流程,每个部门都是整个公司所作承诺的一个缩小版,一直到那张每次都必须以同样方式填写的单张表格。这两类问题在性质上不同,它们需要不同种类的机器。
## 两种机器 {#two-kinds-of-machines}
这个区分也比看上去更古老。1960 年,[Herbert Simon](https://en.wikipedia.org/wiki/Herbert_A._Simon)(赫伯特·西蒙)在《管理决策新科学》(*The New Science of Management Decision*)中区分了**程序化决策**,即组织用既定流程处理的那些例行的、重复的决策,和**非程序化决策**,即需要解决问题的那些新颖的、无结构的决策。他把两者看作一个连续统的两端,而不是两个盒子,并预期程序化的一端会被计算机接管。对于非程序化的一端,他那个时代的计算机几乎无能为力。
六十四年后,2024 年 12 月,Anthropic 发表了一篇名为[〈Building effective agents〉](https://www.anthropic.com/engineering/building-effective-agents)的简短指南,为语言模型划出了几乎同样的界线:「工作流是通过预先定义的代码路径来编排 LLM 和工具的系统。而智能体则是由 LLM 动态主导自身流程和工具使用的系统。」它的建议很冷静:「对于定义明确的任务,工作流提供可预测性和一致性;而当需要大规模的灵活性和由模型驱动的决策时,智能体是更好的选择。」它也直白地点出了代价:「智能体的自主性意味着更高的成本,以及错误不断累积的可能。」
于是,一边是确定性机器:工作流引擎、流程引擎、调度器,以及在更宽泛的意义上,每一个曾经写下过流程的科层机构。给定相同的输入,它们做相同的事;出了问题,你可以一步一步重放发生了什么。另一边是智能体,在 2026 年指的是在循环中使用工具的语言模型,而它们也一直指人。给它们一个目标,它们就会找到办法,而每一次的办法都不一样。这个区分很古老。新鲜的是,机器第一次在 Simon 所说的非程序化那一端变得擅长。
把两类问题和两类机器放在一起,你会得到四个格子,其中两个是错误:
| | **确定性机器**(流程、工作流) | **智能体机器**(在运行时探索) |
|---|---|---|
| **封闭问题**(风险可度量、规则已知、终点明确) | 保险公司的理赔流程:通过始终如一建立信任 | 昂贵的即兴发挥;大多数时候是对的,但没有人说得清它为什么那样做 |
| **开放问题**(不确定性、迷雾、变化的地形) | 脆弱的自动化,碰到第一块意料之外的石头就崩溃 | 探索者:通过试错找到一条路 |
左下角的格子是企业自动化的历史:僵硬的流程铺在凌乱的现实之上,随之而来的是没完没了的例外处理。右上角的格子是此刻的风险。智能体现在已经好到让人忍不住把一切都交给它们,包括封闭游戏;而一个下国际象棋的智能体,通常也会下出说得过去的棋。但「通常」和「说得过去」并不是客户从保险公司那里买的东西。
算术是无情的。假设一个智能体在一个二十步的流程中,每一步做对的概率是 95%,这已经非常好了。二十步全部做对的概率是 0.95 的二十次方,约为 36%。每步 99% 时,约为 82%。对于那些确定性的步骤,确定性工作流没有这个问题;这就是为什么对于一整个流程,有用的问题从来不是「智能体还是工作流」,而是哪些步骤需要判断,哪些不需要。
还有解释的问题。智能体的对话记录显示了它说自己在想什么,这是有用的。但推理来自没有人能读懂的权重。你可以检查它说了什么,却无法检查它为什么这么说,也无法确定它明天会不会说同样的话。对于封闭游戏,客户、审计师和监管者都期待同一个问题得到同一个答案,单凭这一点是不够的。
## 一切向来都是编排器 {#everything-was-always-an-orchestrator}
我职业生涯的大部分时间都花在了这样或那样的编排层上;回头看,每一层都是一种让又一件事变得确定的方式,好让它上面的人不必再为它操心。[Alfred North Whitehead](https://en.wikipedia.org/wiki/Alfred_North_Whitehead)(怀特海)在 1911 年的《数学导论》(*An Introduction to Mathematics*)中用一句话道出了普遍原理:「文明的进步,在于扩大我们无需思考就能完成的重要操作的数量。」每一个编排器都是一台实现怀特海这句话的机器。
| 层 | 工作单元 | 它让什么变得确定 | 不确定性去了哪里 |
|---|---|---|---|
| 单体应用 | 函数调用 | 单个进程内的控制流 | 进入代码,由接口、类型和 ABI 维系 |
| 微服务 | 服务 | 归属和部署边界 | 进入服务之间的网络 |
| Kubernetes、Nomad | 容器、作业 | 调度位置、重启、期望状态 | 进入调和循环和配置 |
| WebAssembly 函数平台 | 函数 | 极小单元的隔离性和可移植性 | 进入函数的组合方式 |
| 工作流引擎 | 步骤 | 流程的顺序、持久性和历史 | 进入步骤体,它们可能运行不止一次 |
| microVM 中的智能体运行时 | 任务 | 沙箱,此外几乎没有 | 进入模型 |
当年我很喜欢 [Nomad](https://www.nomadproject.io/),因为它把这种抽象表达得如此直白:你描述一个作业,调度器就让它成真。[Kubernetes](https://kubernetes.io/) 做的是同样的事,只是仪式更多。WebAssembly 平台把这个想法推得更远。我密切关注过 [wasmCloud](https://wasmcloud.com/),它提出,一个应用不过是一些小函数,编译成可移植的格式,放到任何有空间的地方。这些层中的每一层都只是转移了复杂性,而没有消除它。[微服务](https://en.wikipedia.org/wiki/Microservices)并没有让系统更简单;它把难点从一个程序内部的接口挪到了许多程序之间的网络上,这也是为什么我们随后需要服务网格、链路追踪,以及[不只是日志的可观测性](https://raskell.io/articles/observability-is-not-logging/)。
把这张表当作一个分形来读。每一行都在高一个尺度上做同一个动作:把下一层中不确定的东西变得可预测,让上面的人不必再去想它。而每一行一旦稳定下来,就变得不可见。如今没有人再去想函数调用,很少有人去想自己的容器跑在哪台机器上;再过几年,几乎没有人会去想自己软件底下的持久化工作流。这既是 Tomasello 的棘轮,也是怀特海的那句话。
最后一行在性质上不同。最近我听了一场推介,一家大型咨询公司介绍了它在内部如何运行智能体:一个类似 Kubernetes 的编排器,管理安全的 microVM,每台 microVM 里运行一个编码智能体框架,喂给它描述作业、任务或待招职位的 Markdown 上下文。那是一场不错的推介,和我自己做过的东西很接近。[Kage](https://github.com/raskell-io/kage) 是一个本地优先的智能体工作编排器。Shiioo 在[它的第二种形态](https://raskell.io/articles/shiioo-reimagined-and-a-home-ai-lab/)中运行着一家由智能体组成的小型虚拟公司,由一份规则文件决定它们可以独自做什么;而[有组织架构图的十六个智能体](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/)那次实验让我明白,这件事会多快变得复杂。我也从[《你的智能体想要 root 权限》](https://raskell.io/articles/your-agent-wants-root/)中知道,这项工作有多大一部分仅仅是把这样一个运行时关好。
之前的每一层都把不确定的东西变得可预测,让上面那一层可以不假思索地依赖它。一个包揽一切的智能体编排器做的恰恰相反。它把公司花了几十年变成流程的工作,交还给一个即兴发挥的东西。对于开放问题,这完全正确。对于封闭问题,它却把那些企业真正在卖的唯一一样东西拱手让了出去,并且把怀特海的那句话倒过来用:它扩大了需要思考的操作的数量。
那么,我们应该为一切构建智能体编排器吗?我持怀疑态度。总会有一大片问题空间在本质上是确定性的,因为一个成熟流程所建立的信任本身就有价值。
## 探索与利用 {#exploration-and-exploitation}
如果智能体不是一切问题的答案,它们仍然是某个新问题的答案,而组织理论为它起了名字。1991 年,James March 发表了[〈组织学习中的探索与利用〉](https://doi.org/10.1287/orsc.2.1.71)(Exploration and Exploitation in Organizational Learning),这是该领域被引用最多的论文之一。探索是对新可能性的搜寻:实验、变异、冒险。利用是对已知事物的精进:效率、执行、可靠。每个组织都需要两者,而两者争夺同样稀缺的资源。March 的警告是:精进利用快于精进探索的适应过程,往往在短期内显得有效,在长期内却自我毁灭。组织会向利用漂移,因为利用的回报更近、更确定,也更容易度量。
[同样的权衡](https://en.wikipedia.org/wiki/Exploration%E2%80%93exploitation_dilemma)位于[强化学习](https://en.wikipedia.org/wiki/Reinforcement_learning)的核心,而强化学习正是 DeepMind 自己的领域。一个只利用已知的智能体永远找不到更好的策略;一个只探索的智能体永远收不到奖励。AlphaGo 和 AlphaStar 的意义不止一端,其中之一,就是它们对这个困境给出了极其精巧的回答。这个权衡同样是分形的。它出现在单个智能体决定是否尝试一条新命令时,出现在一个团队决定重写还是打补丁时,出现在一家公司决定是否开发新产品时,也出现在一个行业决定押注游戏还是语言时。
智能体改变了探索的价格。在历史的大部分时间里,探索是昂贵的。它需要熟练的人、时间和对失败的容忍,这也是 March 笔下的组织会远离它的原因。语言智能体让符号世界里的探索变得便宜。一个智能体可以在一夜之间对一个陌生的集成尝试十种方法,读完一次监管变更涉及的每一份文件,或者处理完一整批没有任何流程覆盖的怪异案例。与此同时,利用向来是确定性机器所擅长的。
这就提示了一种任何一方都无法单独做到的分工。智能体探索,工作流利用。设计上的问题在于两者之间的接口:智能体通过探索学到的东西,如何变成工作流可以利用的东西;以及一个已经失效的工作流,如何被交还给探索。
## 惯例是公司的记忆 {#routines-are-the-memory-of-a-company}
Richard Nelson 和 [Sidney Winter](https://en.wikipedia.org/wiki/Sidney_G._Winter) 在 1982 年的《经济变迁的演化理论》(*An Evolutionary Theory of Economic Change*)中回答了这个问题的一部分,这本书是[演化经济学](https://en.wikipedia.org/wiki/Evolutionary_economics)的奠基之作。他们认为,理解企业行为的最佳方式是通过它的**惯例**:它做事的那些规律的、可预测的模式。惯例在组织中扮演的角色,就像基因在生物学中扮演的角色。惯例是组织的记忆,是组织年复一年复制自身行为的方式;而经济变迁,正是通过搜寻新惯例并在其中进行选择而发生的。
惯例的弱点,正如 Nelson 和 Winter 所知,在于它们存放的地方。一个组织的大部分惯例存放在执行它们的人的脑子里,一部分写进了流程和手册,大部分没有。我在[《IT Intelligence》](https://raskell.io/articles/it-intelligence/)中把这称为部落知识:没有人写下来的显性知识,以及或许没有人能写下来的隐性知识。
工作流引擎改变了惯例存放的地方。一个被编码成工作流的惯例,不再是对人们应该做什么的描述。它就是做这件事的东西本身,而每一次执行都会留下一份日志,确切记录发生了什么。组织的记忆同时变得可执行、可检查;这意味着一家公司可以读自己的惯例,比较它们,用过去的案例测试它们,并有意识地修改它们,而不是在访谈和工作坊里去发现它们。
直到最近,缺少的是之前那一步:把一个惯例变成工作流,需要一位人类分析师、一位开发者和一个漫长的项目。野中郁次郎(Ikujiro Nonaka)和竹内弘高(Hirotaka Takeuchi)把从隐性知识到显性知识的这一步称为*外化*,它是他们 [SECI 模型](https://en.wikipedia.org/wiki/SECI_model_of_knowledge_dimensions)的一部分,而它一直是组织学习中缓慢而昂贵的那部分。智能体现在可以迈出这一步了:它们可以观察、探索、尝试,然后写下来。
## 海底的工厂 {#the-factory-under-the-sea}
现在绕一段路,这段路也说明了我是怎样读互联网的。
我读 4chan,也读 UFO 学,读的心态大致和别人读科幻小说一样:不是当作报告,而是当作一个奇异的、有时相当出色的思想实验来源。一个被称为 UFOAnon 的匿名发帖者,曾经写过[一个很长的帖子](https://imgur.com/a/4chan-whistleblower-NXjWQaN),声称要解释非人类飞行器如何在地球周围运作。其中大部分我都归入虚构。但其中有一个意象一直留在我心里,因为它是一段极好的工程想象。
在这个故事里,海底有一座工厂。它不停放舰队。它按需建造飞行器,每一架都为单一任务而设计:一架用于采矿,一架用于运输,一架用于运送活物,一架用于类似观光的用途。一架飞行器为它的任务而造,执行任务,返回,然后被拆解。不需要的东西一样也不留。工厂本身是唯一永久的东西。
无论你怎么看待这个来源,这个设计都是令人信服的,而理由与外星人毫无关系。它正是一个文明在制造东西几乎免费之后会建造的东西。如果制造不花任何成本,你就不会再去维护那些样样都做、样样做不好的通用机器,而是开始生产专门造来把一件事做好、然后就消失的机器。科幻小说给这种状态起了名字,叫[后稀缺](https://raskell.io/tags/post-scarcity/),而它最著名的描绘是 Iain M. Banks 的[「文明」系列](https://en.wikipedia.org/wiki/The_Culture);据 Mallaby 的记述,Hassabis 正是读着这个系列长大的。
这个想法也有体面的渊源。20 世纪 40 年代,John von Neumann(冯·诺依曼)在纸上设计了一台[通用构造器](https://en.wikipedia.org/wiki/Von_Neumann_universal_constructor):一台位于[元胞自动机](https://en.wikipedia.org/wiki/Cellular_automaton)之中的机器,能根据任何机器的描述把它造出来,包括它自己的副本。他的设计有三个部分:**描述**,即一份蓝图;**构造器**,按照描述建造任何东西;以及**复制器**,复制描述本身。冯·诺依曼去世后,Arthur Burks 完成了这项工作,于 1966 年以《自复制自动机理论》(*Theory of Self-Reproducing Automata*)为名出版。这种分离很关键。因为描述与执行它的机器是分开的,描述可以改变、积累、演化,而构造器保持不变。
软件在那个世界里已经生活了几十年。复制一个程序、一个容器镜像或一个编译好的二进制文件,成本几乎为零,这就是为什么我们早已习惯用工厂、模板和模式来思考,而不是用单个的制品。面向对象设计中的[工厂](https://en.wikipedia.org/wiki/Factory_method_pattern)模式和[策略](https://en.wikipedia.org/wiki/Strategy_pattern)模式,就是同一个想法的小型家常版本。
我想,这才是这个故事让我信服的最深层原因:它是分形的。源代码里的工厂模式,即一个以制造其他对象为工作的对象,与一座制造汽车的工厂是同一个想法,也与一座按需制造飞行器、或制造其他工厂的工厂是同一个想法。冯·诺依曼的构造器又是同一个想法,只是高了一层抽象。一个在三四个尺度上都成立的模式很少是偶然的。它通常意味着你发现了世界是如何组装起来的某种东西。2026 年改变的是,工厂现在会思考了:它可以自己写描述。
## 元工厂 {#the-meta-factory}
把这些碎片拼起来。智能体是探索者:它们在迷雾中处于最佳状态,在没有人解决过的问题里找到一条路。工作流是惯例:它们在已知的地面上处于最佳状态,每次都做同样的事,留下任何人都能读的历史。在两者之间选一个,才是错误。更好的设计是把两者连接起来,让探索者找到的东西变成惯例。
*The meta-factory*
```text
┌──────────────────────────────┐
│ the rugged world: │
│ open, foggy, changing │
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ an agent explores │ trial and error, at runtime
└───────────────┬──────────────┘
│ a path is found, and it will be needed again
▼
┌──────────────────────────────┐
│ the agent writes a workflow │ typed, validated, simulated
│ │ against past cases, reviewed
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ a deterministic engine │ journaled, replayable, auditable;
│ runs it │ may contain bounded agent steps
└───────────────┬──────────────┘
▼
┌──────────────────────────────┐
│ observe │ exceptions, drift, new fog
└───────┬──────────────┬───────┘
▼ ▼
repaired retired
by an agent when the mission is over
```
用冯·诺依曼的术语来说,工作流定义是描述,引擎是构造器,版本管理是复制器。用那个故事的术语来说,智能体是海底的工厂,工作流是它造出的飞行器。
面对一种新的理赔、一份新的监管报告或一个新的集成,智能体会像任何能干的人那样,琢磨出该怎么做。如果这项工作是一次性的,事情就到此为止。如果它会重复出现,智能体就会做一个好员工在第三次解决同一件事之后会做的事:把流程写下来。在这里,写下来意味着为确定性引擎产出一份工作流定义,它可以被校验、用过去的案例模拟、由人审阅,并被纳入版本管理。从那以后,这个流程就在引擎上运行,每次都一样,每一次运行都会留下一份日志,确切显示发生了什么。当世界发生变化、工作流开始产生例外时,智能体会去调查并提出修复方案。当任务结束时,工作流就被退役,就像一架飞行器返回去被拆解。
有两个细节让这不只是一张图。
第一,工作流可以包含判断,而不必放弃自己的形状。有些步骤确实需要智能体:阅读一份无结构的文件,起草一封信,判断一个怪异的案例是否符合某条规则。这些步骤可以是工作流内部的智能体调用,其输入和输出都记入日志,其范围有边界。我把它们想象成运河上的[船闸](https://en.wikipedia.org/wiki/Lock_(water_navigation)):在一条原本笔直的水道里,那些允许水位升降的受控节点。前面的算术解释了这一点为什么重要。一个包含两个有边界的智能体步骤和十八个确定性步骤的二十步流程,失败的频率远低于连续二十个智能体步骤;而当它确实失败时,你知道是哪一道船闸漏了水。
第二,这是关于组织的最古老的想法,应用在一种新的工作者身上。人几乎什么都能做;这正是人的价值所在,也正是人难以依赖的原因。公司一向用同样的方式回应:流程、层级、指令、清单、培训。凡是工作可重复的地方,它们就把能干之人的即兴发挥变成流程;凡是工作不可重复的地方,就为判断留出空间。今天,公司正试图用政策、护栏和治理框架来约束智能体,这是同一个动作,只是换了一套词汇。元工厂把它再往前推了一步。你不只是用「它不可以做什么」的规则来约束智能体,而是让它去做它擅长的事,也就是探索,再让它把结果交给一台擅长另一件事的机器,也就是重复。
### 每个尺度上的同一个循环 {#the-same-loop-at-every-scale}
元工厂是一个在每个尺度上重复的循环。一个流程里包含智能体在其中探索的船闸;那个智能体本身可能又运行一个小流程;流程被组合成更大的流程;而一个部门,从足够远的地方看,就是一家公司曾经一路探索出来的一个流程。
| 尺度 | 由什么来探索 | 什么被结晶下来 |
|---|---|---|
| 单个步骤 | 一个阅读一份异常文件的智能体 | 一个答案,记入日志 |
| 一个流程 | 处理它未覆盖案例的智能体 | 一条新规则或新分支 |
| 一个部门 | 处理新类型工作的智能体和人 | 新的流程 |
| 一家公司 | 试探新市场的人和智能体 | 新的产品和部门 |
| 一个行业 | 彼此竞争的公司 | 标准、监管、共享基础设施 |
同一组动词在每一行都适用:探索、结晶、运行、观察、修复、退役。这正是它成为一种设计而不是一句口号的原因。一个在某个尺度上支持这个循环的引擎,就能在所有尺度上支持它,只要工作流能包含智能体,而智能体能启动工作流。
### 一个精心打造的流程是什么样子 {#what-a-crafted-procedure-looks-like}
假设一家保险公司的理赔智能体不断遇到水损理赔,客户的照片要么缺失,要么无法使用。在手工处理了几十个这样的案例之后,一个智能体提出了一个流程。它可能是这个样子:
```python
# procedures/claims/water_damage_photo_evidence.star (illustrative)
PROCEDURE = {
"name": "claims/water-damage-photo-evidence",
"version": 3,
"origin": {"explored_by": "agent/claims-explorer", "cases_studied": 37},
}
# Approval and replay evidence travel with the file, in a signed record:
# replayed against 412 closed claims, 0 divergences from human outcomes;
# approved by the claims process owner on 2026-10-12.
def run(claim):
docs = agent("classify_documents", claim["documents"], # a lock: bounded judgement, journaled
prompt = "prompts/classify-documents.md",
output_schema = "DocumentClassification",
budget_tokens = 20000)
coverage = step("coverage.water_damage@v7", claim)
if docs["missing_photos"]:
step("notify.customer", {"template": "claims/missing-photos", "to": claim["customer"]})
photos = wait(signal("photos_received"), timeout = days(14))
if photos == None:
escalate("no-photos", claim)
if claim["amount"] > 5000 or docs["confidence"] < 0.8:
escalate("manual-review", claim)
return call("claims/settle@v2", claim, coverage)
```
它是用 [Starlark](https://github.com/bazelbuild/starlark) 写的,这是 Python 的一种小方言,为那些每次都必须给出相同答案的构建系统而设计。它的解释器没有时钟、没有随机数、没有网络,也没有文件;脚本接触外部世界的唯一途径是引擎提供的函数,而每一次这样的调用都会记入日志。所以引擎可以精确地重放它,而一个人仍然能在一分钟内读懂它。
元工厂中每一个要紧的特性,都在这寥寥几行里清晰可见。这个流程记录了自己的来历:哪个智能体探索出了它,研究了多少案例,谁批准了它。在任何人信任它之前,它已经用数百个已结案的理赔重放过。它只有一处允许模型做判断,并为这一处设定了预算,也为它的答案规定了 schema。其余的一切都是步骤、消息和等待,由确定性引擎每次以同样的方式运行。它还有一个版本号,这意味着它可以被替换、比较和退役。
## 实地指南 {#a-field-guide}
哲学只有在改变决策时才有用。在一家既有智能体又有工作流引擎、并想把两者都用好的公司里,我会这样应用它。
### 什么时候把工作留给智能体,什么时候把它结晶下来 {#when-to-leave-work-to-an-agent-and-when-to-crystallise-it}
| 信号 | 留给智能体 | 结晶为工作流 |
|---|---|---|
| 频率 | 一次,或很少 | 每周一次或更频繁 |
| 案例之间的差异 | 高:每个案例都不同 | 低:案例形状相同 |
| 结果出错的代价 | 低,可逆 | 高,面向客户,受监管 |
| 事后解释的需要 | 有则更好 | 必需:审计师、监管者、法庭、客户 |
| 每次运行的成本 | 作为一次性开销可以接受 | 在成千上万次运行中累积起来 |
| 地形的稳定性 | 每月都在变 | 以季度计保持稳定 |
没有哪一行单独起决定作用。一个罕见但代价极高的案例,可能仍然值得一个流程;一个频繁但差异极大的案例,也许由一个配有一份严格清单的智能体来处理更好。但当大多数行都指向右边时,让智能体每次都去做这项工作,就是一种成本和风险,而工作流本可以消除它。
### 一个精心打造的流程的生命周期 {#the-lifecycle-of-a-crafted-procedure}
1. **探索**。智能体直接处理新类型的工作,由人审阅结果。每个案例都被记录下来,附带足以重放的上下文。
2. **提议**。当某个模式反复出现时,智能体根据它处理过的案例起草一份工作流定义,并标出仍然需要判断的步骤。
3. **验证**。草案用过去的案例重放。凡是它与人或智能体以前的做法有分歧的地方,要么解释分歧,要么修正草案。
4. **批准**。一位负责该流程的具名人员批准它。批准记录在流程本身之中,就像上面的例子那样。
5. **运行**。引擎确定性地运行它。其中的智能体步骤受预算和输出 schema 的约束。
6. **观察**。按流程、按版本跟踪例外、升级、超时和每次运行的成本。
7. **修复或退役**。当例外增多时,流程被交回给智能体调查。当这项工作消失时,流程被退役,其历史被保留。
### 度量什么 {#what-to-measure}
- **结晶率**:一个季度内,有多少重复性工作从智能体转移到了流程。
- **每个流程的例外率**:需要升级处理的运行所占的比例。例外增多是地形已经改变的最早信号。
- **重放分歧**:当一个流程被修改时,它现在会对多少过去的案例做出不同的处理。
- **每次运行的成本**:token 和算力,与只用智能体的方案相比较。
- **修复时间**:一个失灵的流程在智能体和人把它修好之前,会坏多久。
- **退役率**:没有人再运行的流程。一家从不让任何东西退役的公司,正在积累僵尸。
### 为什么监管者会喜欢它 {#why-regulators-will-like-it}
在受监管的行业里,这种设计也正是监管者前进的方向。[欧盟《人工智能法》要求](https://artificialintelligenceact.eu/article/12/)高风险 AI 系统在技术上允许在其整个生命周期内自动记录事件,并要求部署者保存这些日志。工作流引擎天然就会产生这样的记录:每一个步骤、每一个输入、每一次智能体调用及其答案,按顺序排列,可以重放。一个自由工作的智能体产生的是一份对话记录,聊胜于无,但要审计、比较和复现都难得多。受监管的工作早已要求这样的可追溯性,而要做到这一点,最便宜的途径就是把智能体包裹在流程之中。
### 它如何失败 {#how-it-fails}
- **过早结晶**。在地形还没被理解之前就把某件事变成流程,结果是脆弱的工作流和没完没了的例外:也就是表格左下角的那一格。
- **僵尸流程**。没有人负责、也没有人理解的工作流,仍在运行,只因为没有人敢让它退役。
- **船闸内的智能体漂移**。一次模型更新改变了某个有边界的智能体步骤的行为。用过去的案例重放是防线,而且每当模型变化时都必须运行,而不只是在流程变化时。
- **橡皮图章式批准**。人们没读就批准智能体写的流程。流程必须足够简短易读,批准才有意义。
- **指标上的[古德哈特定律](https://en.wikipedia.org/wiki/Goodhart%27s_law)**。为了优化结晶率,把本该留给智能体的东西也结晶下来。
## 运河与它的警示 {#the-canal-and-its-warning}
人类一向这样对待地貌。看看 Grässl 照片里的那条河,再看看任何一座城市:我们建造立方体、球体、直线和直角,这些形状从不出现在地形中,因为它们服务于一个理念。运河就是一条被告知该做什么的河。它按时刻表运送驳船,这是一条山间河流永远做不到的。
用 Mandelbrot 的术语说,运河是[欧几里得](https://en.wikipedia.org/wiki/Euclidean_geometry)的,河流是分形的。欧几里得给了我们直线、平面和光滑的曲线,它们易于建造、度量和信任。自然给了我们每个尺度上的粗糙,而大部分信息都在粗糙之中。一家公司两种几何都需要;当它相信光滑的那一种可以取代粗糙的那一种时,它就会出错。
这里有一个警示,我取自 James C. Scott 的[《国家的视角》](https://en.wikipedia.org/wiki/Seeing_Like_a_State),我在[《IT Intelligence》](https://raskell.io/articles/it-intelligence/)里也倚重过这本书。Scott 展示了那些把清晰可辨的秩序强加给复杂系统的计划,从规划的森林到规划的城市,往往会摧毁让原有系统得以运转的实践知识。他把这种知识称为 *mētis*(米提斯):熟悉某一个港口的领航员的技艺,或者熟悉某一块田地的农民的技艺。把每一条河都改成运河,你就失去了河流所做的事:泛滥平原、鱼群,以及水所找到的、没有哪个工程师会画出来的那些路。
Weber 从科层制内部看到了同样的危险。让它值得信任的可计算性,也可能让它变得不近人情:当程序上的正确压倒了实质上的公正时就是如此。他为这种终局所用的意象,通常译作[铁笼](https://en.wikipedia.org/wiki/Iron_cage),比他的大多数其他说法都流传得更久。March 则从学习的角度看到了它:一个只懂利用的组织,会变得非常擅长解决去年的问题,然后失败。
元工厂必须尊重这三重警示。并非一切都应该变成工作流。边缘那些正在探索的智能体,是这幅图景中永久的一部分,而不是一切实现自动化之前的一个阶段,因为迷雾永远不会完全散去。掌握着 mētis 的人也不会被流程取代。他们的角色会改变:他们成为决定什么值得变成流程的人,阅读并批准智能体提议的人,以及察觉河流已经改道的人。
我追求的平衡,是一张运河网,旁边仍有一条野性的河流奔涌,还有人,以及智能体,知道什么时候该挖一条新运河,什么时候该填掉一条旧的。
## 这对组织意味着什么 {#what-this-means-for-organisations}
如果这幅图景是对的,那么对于那些主要生活在符号世界里的公司,也就是大多数公司,就会引出几点推论。
**流程负责人变成编辑**。今天,流程负责人维护着描述人们应该做什么的文档,并希望它与人们实际做的相符。在元工厂里,负责人审阅智能体提议的流程,批准版本,阅读例外报告,并决定什么时候让某样东西退役。这更接近编辑工作而不是行政工作,它需要那些既懂业务、又足够懂流程语言、能够批判性地阅读它的人。
**组织架构图开始看起来像一组惯例**。中层管理所做的很多事情,是协调执行惯例的人,并处理例外。当惯例在引擎上运行、例外先交给智能体再交给人时,协调层会缩小,编辑层会扩大。我在《架构师现在做什么》(What the architect does now)中从架构师的角度写过同样的转变。
**信任从人转移到流程,并且必须重新赢得**。Luhmann 的系统信任一直是对流程的信任。新的是,流程现在可以由机器来写了。只有当来历可见、批准是真实的、历史可以重放时,客户和监管者才会把系统信任延伸到智能体写的流程上。这才是整个设想得以成立的条件,比任何技术细节都更关键。
**探索成为一项预算科目**。如果智能体让探索变得便宜,一家公司就负担得起在每个部门的边缘持续探索,而且也应该这样做。March 所说的向利用漂移,部分是一个成本问题。现在,这个借口已经没那么站得住了。
## 这对引擎意味着什么 {#what-this-means-for-the-engine}
如果元工厂是对的,那么智能体时代的工作流引擎,与其说是一个碰巧用 Rust 写成的 Temporal 替代品,不如说是那个由智能体为之撰写描述的构造器,而这改变了它必须擅长的东西。
- **流程是智能体能写、人能读的制品**。定义要能由模型产出,由 schema 校验,由模拟器用过去的案例运行,由人一次读完审阅,并且把自己的来历包含在内。
- **可以证明的确定性**。重放不只是用于崩溃后的恢复:它是你向审计师展示发生了什么的方式,是你检查一个修复后的流程在旧案例上是否仍与旧流程行为一致的方式,也是你发现一次模型更新改变了某个智能体步骤的方式。
- **有边界的智能体步骤是一等概念**。调用模型的步骤,把模型的完整答案记入日志,这样一次崩溃永远不会让它运行两次、计费两次;它强制执行预算和输出 schema,并可以用记录下来的答案重放。
- **诞生与消亡是日常操作**。版本、批准、部署、排空和退役,因为专门打造的流程本来就是要来来去去的。
- **例外是一种信号**。升级和超时既是错误,也是数据:它们告诉智能体地形在哪里发生了变化。
- **小到可以无处不在**。它可以是笔记本电脑上单个二进制文件里的一个库,必要时再成长为集群,因为工厂应该能把飞行器放到任何有工作的地方。
### 检查工厂造出的东西 {#checking-what-the-factory-makes}
一座工厂的可信程度,取决于它的检验。如果智能体来写流程,并且很快也来写这些流程赖以运行的引擎和运行时,那么就必须有某种东西来检查它们的工作,而不依赖于对智能体的信任。这就是我正在构建的另一个项目 [Arcanist](https://arcanist.sh/) 及其[巴塞尔 Haskell 编译器](https://arcanist.sh/bhc/)(BHC)背后的赌注:当生成代码变得便宜时,正确性必须是可检查的。或者如 Arcanist 网站所说:「模型不需要是对的。它需要是可检查的。」
Haskell 在这里之所以重要,其理由贯穿整篇文章。Haskell 中的纯函数在构造上就是确定性的:给定相同的输入,它返回相同的结果,而有副作用的代码必须在类型中声明这些副作用。这正是持久化执行引擎必须在工作流代码和步骤体之间划出的那条线:前者必须完全一致地重放,后者则与外部世界交谈。Temporal 这类引擎在运行时强制这条线,即在事后检测非确定性。类型系统则可以在代码运行之前就强制它。BHC 仍处于 beta 阶段,它在不同的运行时配置下把同一份 Haskell 源代码编译成原生代码和 WebAssembly,项目把每一种配置描述为「你的代码与它运行于其上的运行时之间的一份契约」;按它自己的测量,243 个测试程序中已有 236 个在 WebAssembly 上产生与原生版本逐字节相同的输出。
更宽泛的赌注是,这样的编译器可以在 AI 辅助的工程中发挥关键作用。智能体写代码;编译器验证可以被验证的部分;一个注册表记录检查过什么,这样无论是人还是模型,都不必把同一件事检查两次;最终得到的是一个工作负载、一个运行时或一台引擎,它的行为之所以可信,靠的不是写它的人的名声,而是别的理由。这又是元工厂,只是低了一个尺度:智能体探索,结果结晶成某种刚性的东西,而一位检验员守在门口。关于验证的一面,我写在[《只需写一次的证明》](https://raskell.io/articles/the-proof-you-only-have-to-write-once/)里;关于工具,写在[《我们为什么用 Rust 写了一个 Haskell 包管理器》](https://raskell.io/articles/why-we-built-a-haskell-package-manager-in-rust/)里;关于代码成为编译下降(lowering)的目标,写在[《源代码是新的汇编》](https://raskell.io/articles/semantic-artifacts-and-meaning-engines/)里。Aqueduct 的流程目前用 Starlark 编写,这种语言的解释器根本看不到时钟或随机数。它们将来是否会用一种 BHC 这样的编译器能够检查的语言来写,我还不知道。这是我最好奇的方向。
### 名字 {#the-name}
写设计说明时,我几乎是偶然地给这个项目起了个暂定名:*tsumugi*(紡ぎ),日语里把原始纤维纺成线的意思。这是个美丽的词,我用了好几个星期。但一个名字应该在你脑海里放进一幅画面,而对日本以外的大多数人来说,这个名字做不到。我需要的那幅画面早已在这篇文章里了。它就是那个让运河跨越山谷的东西。
这台引擎名叫 **Aqueduct**(引水渠)。
罗马人建造引水渠,把水从远方的泉源引入城市,跨越数十公里无人能改变的地形。在铺下第一块石头之前,必须有人走遍这片土地,在群山之间找出一条路线,让水一路平缓下降。尼姆的引水渠在[加尔桥](https://en.wikipedia.org/wiki/Pont_du_Gard)处跨越加尔东河,全长约五十公里,而它的源头只比终点处尼姆城中的水池高出十七米。探索在先,缓慢而粗糙。它留下的,是一条几个世纪里每天都以同样方式流淌的水道。
加尔桥也是分形的:三层拱,同一种形式反复出现,每一层承托着它上面的那一层。引擎也应该这样运作:步骤由工作流承载,工作流由更大的工作流承载,流程由整个公司的惯例承载,每一层都建立在它下面的那一层之上。
运河与引水渠终于相遇了。1805 年,Thomas Telford 和 William Jessop 在威尔士建成了[庞特斯沃斯特渡槽](https://en.wikipedia.org/wiki/Pontcysyllte_Aqueduct),这是一条架在石墩上的铁槽,把兰戈伦运河托举在迪河上方三十九米处。至今仍有船只从上面驶过。这就是我心中引擎的样子。不是河流,也不是运河,而是那个让运河得以跨越崎岖世界而不被冲走的结构,在建造它的人离去很久之后依然屹立。
罗马人还给我们留下了一位懂得这一点的管理者。公元 97 年,皇帝涅尔瓦(Nerva)任命 [Sextus Julius Frontinus](https://en.wikipedia.org/wiki/Sextus_Julius_Frontinus)(弗朗提努斯)为罗马的水务专员,Frontinus 随后写下了《论罗马城的供水》(*De aquaeductu*),一份关于这座城市的供水系统实际如何运作的官方报告:九条引水渠各自从哪里引水,每条输送多少水,以及使用和维护它们的规则。Nelson 和 Winter 想必会把它认作一组惯例的书面记忆。Frontinus 为他的引水渠感到自豪,他也知道是什么让它们与纪念碑不同:「有如此众多不可或缺的建筑承载着如此多的水,若你愿意,不妨拿它们与那些闲置的金字塔,或希腊人那些虽然著名却毫无用处的作品相比!」([第一卷第 16 节](https://penelope.uchicago.edu/Thayer/E/Roman/Texts/Frontinus/De_Aquis/Bennett/1*.html),据 Charles E. Bennett 的英译本)
我宁愿建造引水渠,而不是金字塔。纪念碑被人赞叹;引水渠被人依赖,直到最终没有人再去想它。阿格里帕(Agrippa)于公元前 19 年建成的[处女水道](https://en.wikipedia.org/wiki/Aqua_Virgo),至今仍以文艺复兴时期修复后的「处女泉水道」(Acqua Vergine)之名流淌,为特雷维喷泉供水。这就是我希望这台引擎拥有的那种意义:不是被人注意到,而是在没有人再记得是谁建造它之后很久,仍然在输送着水。
## 结语 {#closing}
Whitehead 说,文明的进步在于扩大我们无需思考就能完成的重要操作的数量。在历史的大部分时间里,此前的思考是由人来完成的,缓慢而昂贵,而他们变成惯例的那些操作,存放在手册和记忆之中。现在,探索可以由机器来完成,这些机器在符号世界中寻找路径的能力惊人;而惯例可以运行在每次都做同样的事、并且确切记得自己做过什么的机器上。
智能体在崎岖的世界里找到路。工作流是我们为那些值得再走一遍的路所保留下来的东西:写了下来,可重复,可检查,并且因为它们不即兴发挥而值得信任。在智能体上做得好的公司,既不会是让智能体包揽一切的公司,也不会是禁止智能体的公司,而会是那些让智能体去探索、再把它们的发现变成流程、运行在一个可读的运行时之上的公司,并且它们记得给河流留下一些野性。
如果世界真像我猜想的那样没有边界,这个模式就不会在这里终结。没有最后一层,只有下一次迭代:智能体在我们已知的边缘探索,流程保存值得保存的东西,两者都成为下一层立足的地面,直到我们不再注意到它们。Crichton 把他的小说分成迭代,因为那是一个关于系统的故事,这些系统不断展开,超出任何人能够控制的界限。这也是同一类故事。生命总会找到出路,河流也是。我们要做的,是决定它的哪些路值得保留,并建造承载它们的引水渠。
## 参考文献 {#references}
关于游戏、语言和 AI:
- Sebastian Mallaby, *The Infinity Machine: Demis Hassabis, DeepMind, and the Quest to Build a Mind*, Penguin Press, 2026,第十三章,关于星际争霸、AlphaStar 和对语言的押注。
- Ashish Vaswani and colleagues, [Attention Is All You Need](https://arxiv.org/abs/1706.03762), 2017,提出 transformer 的论文。
- 关于 Yann LeCun 的世界模型公司 AMI:[TechCrunch, Who's behind AMI Labs](https://techcrunch.com/2026/01/23/whos-behind-ami-labs-yann-lecuns-world-model-startup/) 以及 [eWeek 关于 10.3 亿美元融资的报道](https://eweek.com/news/meta-ai-yann-lecun-ami-world-models-startup)。
- Hans Moravec, *Mind Children: The Future of Robot and Human Intelligence*, Harvard University Press, 1988;另见[莫拉维克悖论](https://en.wikipedia.org/wiki/Moravec%27s_paradox)。
- Anthropic, [Building effective agents](https://www.anthropic.com/engineering/building-effective-agents), 19 December 2024.
关于分形、迭代和观念:
- Benoit B. Mandelbrot, *The Fractal Geometry of Nature*, W. H. Freeman, 1982.
- James Gleick, *Chaos: Making a New Science*, Viking, 1987.
- Michael Crichton, *Jurassic Park*, Alfred A. Knopf, 1990,以及 Steven Spielberg 执导的 1993 年同名电影;关于小说中的迭代,见[海威龙形曲线](https://en.wikipedia.org/wiki/Dragon_curve)。
- [分形宇宙学](https://en.wikipedia.org/wiki/Fractal_cosmology),包括星系巡天数据所支持的大尺度均匀性论证。
- Stuart Kauffman, *At Home in the Universe*, Oxford University Press, 1995,以及 Steven Johnson, *Where Good Ideas Come From*, Riverhead, 2010,关于邻近可能。
- Michael Tomasello, *The Cultural Origins of Human Cognition*, Harvard University Press, 1999,关于棘轮效应。
关于风险、信任和组织:
- Frank H. Knight, [*Risk, Uncertainty, and Profit*](https://www.econlib.org/library/Knight/knRUP.html), 1921.
- Niklas Luhmann, *Trust and Power*, Polity;关于信任的论文最初于 1968 年以德文 *Vertrauen* 为题发表。
- Max Weber, *Economy and Society*,关于科层制和法理型权威。
- Herbert A. Simon, *The New Science of Management Decision*, Harper and Brothers, 1960.
- James G. March, "Exploration and Exploitation in Organizational Learning", *Organization Science* 2(1), 1991, pp. 71 to 87, [doi:10.1287/orsc.2.1.71](https://doi.org/10.1287/orsc.2.1.71).
- Richard R. Nelson and Sidney G. Winter, *An Evolutionary Theory of Economic Change*, Belknap Press of Harvard University Press, 1982.
- Ikujiro Nonaka and Hirotaka Takeuchi, *The Knowledge-Creating Company*, Oxford University Press, 1995.
- James C. Scott, *Seeing Like a State*, Yale University Press, 1998.
- Alfred North Whitehead, *An Introduction to Mathematics*, 1911.
关于工厂和机器:
- John von Neumann, *Theory of Self-Reproducing Automata*, edited and completed by Arthur W. Burks, University of Illinois Press, 1966;另见 [Von Neumann universal constructor](https://en.wikipedia.org/wiki/Von_Neumann_universal_constructor)。
- Erich Gamma, Richard Helm, Ralph Johnson and John Vlissides, *Design Patterns: Elements of Reusable Object-Oriented Software*, Addison-Wesley, 1994,关于工厂模式和策略模式。
- UFOAnon,那个讲述海底工厂的 4chan 匿名帖子,[收录于 imgur](https://imgur.com/a/4chan-whistleblower-NXjWQaN),供好奇者一读。请把它当作虚构来读。
- [Temporal](https://temporal.io/) 和 [Restate](https://restate.dev/),持久化执行引擎。
- [Arcanist](https://arcanist.sh/),为 AI 编写代码的时代打造的 Haskell 工具,及其[巴塞尔 Haskell 编译器](https://arcanist.sh/bhc/)。
- [Kubernetes](https://kubernetes.io/)、[HashiCorp Nomad](https://www.nomadproject.io/) 和 [wasmCloud](https://wasmcloud.com/),编排器。
关于监管:
- Regulation (EU) 2024/1689, the AI Act, [Article 12, record-keeping](https://artificialintelligenceact.eu/article/12/).
关于引水渠:
- Sextus Julius Frontinus, *De aquaeductu*, around AD 97 to 100, translated by Charles E. Bennett, Loeb Classical Library, 1925, [on LacusCurtius](https://penelope.uchicago.edu/Thayer/E/Roman/Texts/Frontinus/De_Aquis/Bennett/1*.html).
- [Pont du Gard](https://en.wikipedia.org/wiki/Pont_du_Gard)、[Pontcysyllte Aqueduct](https://en.wikipedia.org/wiki/Pontcysyllte_Aqueduct) 和 [Aqua Virgo](https://en.wikipedia.org/wiki/Aqua_Virgo)。
- [The Starlark language specification](https://github.com/bazelbuild/starlark/blob/master/spec.md).
关于那张照片:
- Armin Grässl, [*006 Whispering Current*](https://www.armingraessl.ch/collection/006-whispering-current),摄影作品,出自他的 Transforming Spaces 系列。
================================================================================
---
title: "赢下一切,不控制任何人"
url: https://raskell.io/zh/articles/win-everything-control-no-one/
author: Raffael Schneider
date: 2026-10-29
description: "Sebastian Mallaby 为 Demis Hassabis 写的传记,是我所知最好的现代 AI 史,也是对一个厌恶控制却又行使控制的人的坦诚研究。"
tags: [intelligence, reinforcement-learning, games, research-labs, ai-alignment, history-of-technology, technology-races, post-scarcity, chess, shogi, go-game, starcraft]
categories: [reviews]
review_of: "The Infinity Machine"
review_of_author: "Sebastian Mallaby"
review_of_kind: book
review_of_year: 2026
rating: 8.5/10
lang: zh-Hans
translation_of: https://raskell.io/articles/win-everything-control-no-one/
---
# 赢下一切,不控制任何人
## 简而言之
Sebastian Mallaby 的 *The Infinity Machine* 是 Demis Hassabis 的传记,也是我所知最好的现代 AI 史;我给它打 8.5 分(满分 10 分)。 它把每个概念讲两遍,先用类比,再讲机制;它把这个领域讲成强化学习与深度学习之间的一场长期纷争,而每一次真正的突破都结合了两者。 它坦诚面对 DeepMind 的错误,从误判语言模型到没能发布自己的聊天机器人;书中一次次失败的治理尝试让我相信,至少眼下,AI 既停不下来,也无法被治理。 它的核心是一幅人物肖像:一个极度好胜、自称厌恶控制、却又在行使控制的人;其中的教训是,权力必须始终只是做事的手段,而这需要自律。 它的不足在于距离感:Hassabis 往往拥有最后的发言权,对手则只是从外部看到的;最后几章读起来像新闻快讯。但要理解 AI 背后的人,这是必读之书。
*The Infinity Machine* 开篇的场景与 Demis Hassabis 毫无关系。2015 年,在皇家学会的一场讲座之后,Nick Bostrom 问 Geoffrey Hinton:既然他认为政治体制会用 AI 来恐吓民众,为什么还要继续做 AI 研究?Hinton 回答说,他可以搬出那些常见的理由,「但事实是,发现的前景实在太诱人了。」Mallaby 说这个故事一直萦绕在他心头,它也为整本书定下了问题:如果打造这项技术的人明白其中的危险,他们为什么还要造它?他们是什么样的人,这又是否重要?
他的回答是一部 Demis Hassabis 的传记,同时也是我读过的、关于 AI 如何从下棋打游戏的程序走到今天的最好的叙述。我给它打 8.5 分(满分 10 分)。想了解这项技术背后的人、驱动他们的是什么,以及为什么似乎没有人能让它停下来,这本书是必读的。
## 这本书讲的是什么 {#what-the-book-is}
这本书做了两件事。它讲述一个人的一生:Hassabis 四岁时看父亲下棋,几周之内就能赢过大人;十三岁成为国际象棋大师;上大学前在 Bullfrog 当游戏设计师;一家失败的游戏工作室;神经科学博士;DeepMind;卖给 Google;AlphaGo;AlphaFold;诺贝尔奖;以及 ChatGPT 之后的手忙脚乱。它还通过观念来讲述这个领域的历史,按观念出现的先后顺序。Mallaby 在三年里与 Hassabis 相处了大约三十个小时,并采访了他身边一百多人,所以对手们和与他闹翻的人都能用自己的话发声。
书名来自剑桥。Hassabis 和他的朋友 David Silver 曾设想一台能在近乎无限的数据中找出规律的机器;后来 Hassabis 招揽 Mustafa Suleyman 时说,一台无限机器将拥有无限的潜力(第 2 章和第 4 章)。这个说法背后是归纳问题:符号 AI 从未解决它,而本书其余部分看着深度学习和强化学习一点一点地解决了它。
## 一部按正确顺序讲述的 AI 史 {#a-history-of-ai-told-in-the-right-order}
Mallaby 把技术讲两遍,一遍用类比,一遍讲机制。例如:
- **图像网络如何学习**(第 6 章)。最前面几层找出边缘和色块,后面几层找出曲线和纹理,更深的层找出爪子的轮廓,最后几层说出「猫」。然后是机制:权重、偏置,六千万个参数被一点点调整,直到输入与输出对得上。
- **为什么 Atari 智能体需要经验回放**(第 6 章)。一个图像分类器如果被喂入一叠排好序的照片,前面全是猫,就会断定一切都是猫。一个困在游戏某个角落的智能体也有同样的问题。把经验存下来再随机抽样,就解决了这个问题;Hassabis 从中看到了海马体在睡眠中所做的事。
- **为什么 Atari 智能体需要第二个网络**(第 6 章)。一个不断给自己的估计添加乐观成分的智能体,就像一个在人行道上捡到几张百元钞票的人,断定自己只要走上一个月就能成为亿万富翁。Mallaby 为解决办法找的比喻是一位网球教练,他先观察一阵再给建议:一个网络用冻结的权重去玩,另一个网络学习,经过一段时间的学习之后才把心得交接过去。
- **AlphaGo 作为两种思维**(第 9 章)。策略网络提出着法,就像强手一眼看出的那样;价值网络评判局面;树搜索负责缓慢而审慎的部分。Mallaby 把它们对应到 Kahneman 的系统一和系统二。
- **残差网络**(第 12 章)。深层网络会像传话游戏一样把信号传走样;跳跃连接是绕过中间层的快车道。
- **Transformer**(第 12 章)。嵌入是一张有数百个维度的语言地图;注意力就像知道要看懂这一集犯罪剧,需要回想前面哪一集;中间还绕道 Henri Bergson,谈时间是注意力而非序列。
这些解释不需要任何背景知识,也不居高临下。顺序同样重要:每一章都展示了上一次突破让什么成为可能,又做不到什么,所以从 ImageNet 到 Atari,到 AlphaGo,到 AlphaZero,到 Transformer,到 AlphaFold,再到推理模型,这条链读起来是一个完整的论证。我把这条链画了出来,每一环都注明出处,也画出了把它从一个实验室带到另一个实验室的那些人,做成一篇配套笔记里的两张交互图:[Who contributed to AI](https://raskell.io/notes/who-contributed-to-ai/)(英文)。
## 处于中心的纷争 {#the-feud-at-the-centre}
把这段历史串起来的线索,是强化学习与深度学习之间的竞争。它起初是地理上的:Hinton 的深度学习派在多伦多,Richard Sutton 的强化学习派在阿尔伯塔,彼此几乎不说话。强化学习理论家 Csaba Szepesvári 承认神经网络在实践中有效,但他不愿使用,因为他无法就它们证明任何东西;Hinton 对想把两者结合起来的学生 Vlad Mnih 说:「我试过了,行不通。」Mnih 去了伦敦,还是做了,结果就是那个 Atari 智能体(第 6 章)。
从那以后,书中展示了钟摆来回摆动,而且从不让任何一方长久获胜:
| 时期 | 谁看起来是对的 | 发生了什么 | 另一方的贡献 |
|---|---|---|---|
| 2006 年至 2012 年 | 深度学习 | Hinton 的深度信念网络,然后是图形芯片,然后是 Alex Krizhevsky 在自己卧室里训练、赢下 ImageNet;他的三人公司以 4400 万美元卖给 Google(第 4 章和第 6 章) | 暂时没有:两个阵营几乎不交流 |
| 2013 年 | 第一次两者都对 | DeepMind 的 Atari 智能体仅凭像素和分数学会了几十款游戏;当《打砖块》里的隧道出现时,NIPS 会场一片寂静(第 6 章) | 来自深度学习的卷积网络负责看屏幕;来自强化学习的 Q 学习、经验回放,以及让估计保持诚实的第二个网络 |
| 2014 年至 2016 年 | 强化学习 | AlphaGo 以五比零击败樊麾,又以四比一击败李世石,留下了第 37 手(第 9 章) | 充当直觉的策略网络和价值网络属于深度学习,最初用 15 万盘人类棋谱训练 |
| 2017 年 | 强化学习,而且声势浩大 | AlphaZero 只靠自我对弈学会了围棋、国际象棋和将棋,完全不用人类棋谱(第 12 章) | 一个来自微软的残差网络,深到足以把 AlphaGo 的两个网络合而为一 |
| 2017 年至 2019 年 | 深度学习 | LeCun 把强化学习称为「蛋糕上的樱桃」;Transformer 和 GPT 从无标注文本中学习,这抽掉了强化学习的两大卖点:无需人类标注就能学习,以及自己生成数据(第 12 章) | 很少,直到后训练出现 |
| 2017 年至 2020 年 | 单靠哪一方都不行 | Gaia,一个供智能体使用的模拟自然世界,失败了;AlphaStar 对《星际争霸 II》内置 AI 的胜率因为一个 Transformer 从 10% 跃升到 84%,然后强化学习把它对排位人类玩家的胜率推到 99.8%;一个纯自我对弈的星际争霸智能体始终没能起步(第 13 章) | 每一方都需要另一方,哪一方都无法单独做到 |
| 2018 年至 2020 年 | 深度学习,加上生物学 | AlphaFold 起初是一个强化学习项目,最后却靠基本放弃强化学习而获胜;Hassabis 说:「蛋白质折叠不是双人游戏。」(第 15 章) | 第一版 AlphaFold 里有一个搜索步骤,之后就没有了;决定性的想法来自进化和 Transformer |
| 2022 年至 2023 年 | 深度学习,由强化学习驯服 | ChatGPT 和 DeepMind 未发布的 Sparrow 都是靠基于人类反馈的强化学习才变得可用;Silver 把机器强化学习引入 Gemini 的尝试陷入停滞,因为没有人能为一首好俳句写出奖励函数(第 16 章至第 18 章) | 人类评分员提供了过去由游戏分数提供的奖励 |
| 2024 年以后 | 再次是强化学习 | 来自有正确答案的数学和逻辑题的奖励,教会模型一步一步推理:OpenAI 的 o1、Gemini Flash Thinking、DeepSeek 的 R1-Zero;AlphaProof 拿下奥林匹克数学竞赛银牌;Silver 和 Sutton 宣告「经验时代」到来(第 19 章和第 20 章) | 被训练的语言模型属于深度学习;强化学习如今运行在它们之上,奖励黑客(reward hacking)也是 |
书中每一次真正的突破都结合了两种方法,而在任何时刻看起来错了的一方,通常只是在等待另一方的下一次进展。
## DeepMind 错在哪里 {#what-deepmind-got-wrong}
Mallaby 是一位怀有同情的传记作者,但他没有掩盖 DeepMind 的错误。DeepMind 2010 年的商业计划书否定了它所说的那种错误观念,即语言就是表达出来的智能。Hassabis 相信,一个模型必须在世界中行动才能理解世界,他多年来一直误判 GPT。他也承认这一点:「你不可能每次都是诺查丹玛斯。」(第 13 章)
后来他解释了原因。他原以为人类行为的空间近乎无限;结果互联网上大约十四万亿个词就涵盖了其中大部分。他把互联网比作工业革命恰好在地下找到的煤和石油:没有人是为了 AI 建造它的,它本来也不一定存在。我在评论 Tim Berners-Lee 的回忆录时从另一个方向提出过同样的论点,见[网络就是训练集](https://raskell.io/articles/the-web-was-the-training-set/);而 Hassabis 是从实验室内部得出这个结论的。
其他错误是组织层面的。Google 陷入了施乐 PARC 的困境:它发明了 Transformer,却无法在不危及搜索业务的情况下发布聊天机器人。DeepMind 陷入了贝尔实验室的困境:一种为开放式探索而建立的文化,在道路已经明朗时却无法转向工程。DeepMind 有一个聊天机器人 Sparrow,带有二十三条行为规则和网络搜索功能,ChatGPT 发布时它已几乎准备就绪,却始终没有发布(第 16 章和第 17 章)。
## 那些人 {#the-people}
Peter Thiel 投资 DeepMind,是因为它看起来既反主流又便宜,但他从未真正相信它,还差点让它把钱烧光(第 7 章)。Elon Musk 承诺出钱,在壁橱里打了一通电话,试图为特斯拉或 SpaceX 收购 DeepMind,后来在坐过 DeepMind 自己的安全委员会之后,又联合创办了与之对抗的 OpenAI(第 8 章和第 10 章)。Mark Zuckerberg 在一顿晚餐上失去了 DeepMind,因为 Hassabis 注意到他对虚拟现实和 3D 打印的兴奋程度不亚于对 AI,随后他聘请 Yann LeCun 来挖 DeepMind 的人(第 8 章)。Larry Page 因为 Musk 偏爱人类胜过机器,称他为「物种主义者」(第 10 章)。Sam Altman 主要是通过对手的眼睛被看到的,他出场时是那个在 2015 年写下阻止人类发展 AI「几乎肯定不」可能的人,然后他比任何人都更卖力地证明了这一点。Dario Amodei 以安全研究员的身份出现,他推动了 GPT-2 的规模化,后来离开并创办了 Anthropic。
Mustafa Suleyman 的故事读来最令人难受。他是 Hassabis 弟弟的朋友,后来成了联合创始人。他为英国国家医疗服务体系 NHS 做的医疗工作很出色(Streams 应用把未被察觉的紧急肾病病例比例从 12.4% 降到 3.3%,第 11 章),却被一篇小报上关于数据的报道扼杀了。他为让 DeepMind 接受独立监督而进行的努力持续了三年,最终失败(第 14 章)。接着是一场霸凌调查、一次休假,以及彭博社的一个标题,这段友谊就此结束。Mallaby 让两个人都讲了自己的说法。
## 为什么它无法被治理 {#why-it-cannot-be-governed}
读完这本书,我比以前更加确信,AI 停不下来,也无法被治理,至少眼下如此。这是我的结论,但书中提供了大部分证据。每一次从行业内部治理它的尝试都失败了,而政府来得太晚,带来的只是自愿承诺:
- **伦理与安全委员会**是 Google 收购 DeepMind 时同意设立的,只在 SpaceX 开过一次会。它的几位嘉宾随后创办或资助了一家竞争对手实验室。Hassabis 说:「我们所谓的顾问其实是我们的对手。」(第 10 章)
- **独立小组**负责监督 DeepMind Health,在 Google 吸收医疗团队时被解散(第 14 章)。
- **Project Mario**,为一个由三名 Google 董事、三名 DeepMind 董事和三名独立董事组成董事会的 DeepMind 进行了三年谈判,最后一无所获。Reid Hoffman 承诺向一个独立出去的 DeepMind 投入十亿美元,但这件事从未发生(第 14 章)。
- **OpenAI 的非营利董事会**解雇了 Altman,结果只撑了五天(第 18 章)。
- **暂停公开信**在 2023 年获得了一千多人签名,但没有一家领先实验室的负责人签字。Hassabis 的反对意见站得住脚:在芯片和数据中心持续进步的同时暂停模型,就等于把下一场竞赛交给暂停结束时算力最多的人(第 18 章)。
到 2025 年,Hassabis 得出结论:「安全不在于治理结构」,你所能做的最多是在谈判桌上占有一席之地。Mallaby 称之为「一副单薄的安慰脚手架」,并承认这可能已是现有的最好选择。这两点我都同意他的看法。
## 我熟悉的那些部分 {#the-parts-i-recognised}
第 3 章有一句话,说 Hassabis 有一种「想玩、想赢点什么、赢什么都行的强烈渴望」,他的第一家游戏工作室曾试图用梦幻足球和星际争霸来满足这种渴望。当一位同事终于在桌上足球上赢了他时,他宣称自己的灵魂着了火。我笑了,因为我认得这种感觉。我年轻时在国际象棋俱乐部下过棋,星际争霸至今仍是我最喜欢的策略游戏,而我对韩国《母巢之战》圈子的关注程度,足以让我为它做了[一个网站](https://broodwar.live)。所以,关于 AlphaStar 的章节,以及关于 AlphaGo 在韩国两亿观众面前对阵李世石的章节,对我来说是一种大多数 AI 史都没有的切身体验。
那些游戏也是如此。我很喜欢 Peter Molyneux 的 *Black & White*,后来又喜欢 *Fable*;Hassabis 参与过 *Black & White* 的早期设计,因为在这款游戏里,生物第一次会根据玩家的拍打和抚摸改变自身的规则,这是商业游戏里的一个小型强化学习系统(第 2 章)。在那之前,他十几岁时就为 *Theme Park* 打造了模拟游客,他们吃了咸薯条会口渴,坐了过山车会吐。书中从那些模拟世界画了一条直线,连到 Gaia(DeepMind 模拟生物圈的尝试),也连到 Hassabis 对康威生命游戏和涌现的着迷:把简单的部件组合在一起,就会出现任何部件都不具备的性质。这正是我在自己的模拟中不断回到的问题,从 [Hotaru](https://hotaru.raskell.io),一个学会玩 Pong 的模拟神经元培养物,到 [Kishi](https://kishi.raskell.io) 里的引擎。Kishi 下国际象棋、将棋和围棋,正是 AlphaZero 学会的那三种棋,而 [Learning to Play](https://raskell.io/articles/learning-to-play/) 系列则是我对第 9 章和第 12 章那些问题的小规模版本。Hassabis 还曾登上英国将棋排名的榜首。
他想要的未来和我想要的很接近:用计算解决生物学,由机器人和自动化来干活,以及富足。他是读 Iain Banks 的「文明」系列小说长大的,在第 7 章里他走得比业内大多数人都远。他怀疑全民基本收入是否是答案,更倾向于他所说的全民基本供给:住房、教育、医疗和出行,达到今天百万富翁所享受的水平,免费提供给每个公民,而想要一辆法拉利的人,可以去工作。Silver 在第 20 章末尾提出把获得 AI 协助列为一项人权。两者都算不上计划,但都比大多数政策辩论更适合作为起点。
## 赢而不控制 {#winning-without-controlling}
Mallaby 在整本书中始终关注 Hassabis 的两个特质,而这两个特质恰好我也有。他好胜到了凶猛的地步:Hinton 说他是自己见过的唯一一个比 Hinton 还好胜的人。而从第 2 章开始,他就坚持说自己不想控制任何人,说「操纵或控制别人真的很糟糕」,并把这一价值观追溯到他母亲的教会。他似乎也不在乎钱。十八岁时,为了去剑桥读书,他拒绝兑现 Molyneux 给他的一张 50 万英镑的支票。出售 DeepMind 时,他和 Suleyman 先谈研究预算,再谈价格;在尾声中,他说给他多少钱他也不会拿诺贝尔奖去换。他开一辆十年车龄的奥迪,唯一的奢侈是一张利物浦的季票。
Mallaby 检验了关于控制的说法,而证据有正有反:
- 在 Elixir,Hassabis 的「绝地控心术」把一个团队鼓舞到了听不进诚实反馈的地步。他后来说:「谁能想到,你真的会把人鼓舞得太过头?」(第 3 章)一位心理学家告诉 Mallaby,有魅力的人无论多么努力,都无法避免支配他人。
- 在 Elixir 时他拒绝了风险投资,因为让出一半公司就意味着被控制。在 DeepMind,他拿的股份是他的科学联合创始人的九倍,因为他想掌控使命(第 5 章)。
- 他厌恶两个方向的支配:他不愿支配别人,也不愿被别人支配。当 Suleyman 挑战他的方向时,他让一场调查去做本该由一次谈话完成的事(第 14 章)。
- 在尾声中,Mallaby 直截了当地向他提出:「他一再告诉我,他不想控制别人。然而他确实控制着人。」Hassabis 回答说,他行使的是一种不情愿的权力,因为他想做的事需要庞大的团队。
对任何喜欢赢、又不喜欢权力的人来说,这是一个警告:前一个特质会把你放到不得不行使权力的位置上,而那正是后一个特质想要回避的。Hassabis 的回答是,权力作为做事的手段可以接受,但永远不能成为目的,这个回答是对的。但这本书表明,要让权力始终只是手段,需要多大的自律。
## 不足之处 {#where-it-falls-short}
我扣下的那半分,主要是因为距离感。Mallaby 在引言里、在给出证据之前,就宣布了他的结论:Hassabis 是「正派而有公心的」;虽然书中确实检验了这一点,但在大多数争议上,最后的发言权都归 Hassabis。OpenAI 和 Anthropic 是从外部被看到的,主要通过离开它们或与它们竞争的人,所以 Altman 几乎完全是由他的对手描绘的。而且 Mallaby 在一些本可以只做报道的地方发表了议论:他对批评 DeepMind Health 的独立小组很严厉,在关于 Gemini 基准测试的争论中对 DeepMind 很宽容,还一度说 DeepSeek 的 R1-Zero「实际上」是有自我意识的,而他给出的证据并不支持这个说法。
最后几章读起来也像新闻快讯。它们匆匆掠过已经过时的基准测试和产品名称,缺少写剑桥、Elixir 和 AlphaGo 那几章的从容。对于一本 2026 年写完、讲述一场仍在进行的竞赛的书来说,这也许无法避免,而这些都不改变我的推荐。
## 谁应该读它 {#who-should-read-it}
它适合任何想通过造就了过去十五年 AI 的那些人来理解这段历史的读者,书中还顺带把概念讲清楚了。不需要技术背景;即使你有,这些解释的顺序和类比也依然值得一读。它和[我的阅读记录](https://raskell.io/reading/)里的那些预测(比如 *AI 2027*)很搭:那些预测描述的是事情可能走向何方,而这本书展示的是谁在驾驶、为什么驾驶,以及包括驾驶者在内,任何人对路线的掌控是多么有限。
全书以 Hassabis 坐在一家酒吧里结束,他说,看着自己的梦想成真,本该感觉很美妙,但并没有,因为一切都在疯狂地往前赶。他依然乐观。
================================================================================
---
title: "学会下棋"
url: https://raskell.io/zh/articles/learning-to-play/
author: Raffael Schneider
date: 2026-10-25
description: "一位国际象棋神童读过的手册、三种古老的棋类和一台笔记本电脑:用 Rust 重建博弈 AI 背后的思想,让它在我手机的浏览器里运行,并加以测量。"
tags: [game-ai, machine-learning, reinforcement-learning, games, rust, webassembly, history-of-technology, chess, shogi, go-game]
series: learning-to-play
lang: zh-Hans
translation_of: https://raskell.io/articles/learning-to-play/
---
# 学会下棋
## 简而言之
读 *The Infinity Machine* 时,我惊讶地发现,少年 Demis Hassabis 读过的那本国际象棋手册里讲的三个部分,至今仍是一个国际象棋程序的全部,只是评估函数如今是学出来的。 国际象棋、将棋和围棋勾勒出博弈 AI 的历史:经典方法在国际象棋上行得通,在将棋上捉襟见肘(NNUE 网络正是在将棋里发明的),在围棋上则彻底失效,除非由神经网络来引导搜索。 我用 Rust 为这三种棋各写了一个引擎,编译成 WebAssembly,让它们能在我的手机上离线对弈,因为搜索内部的网络必须是小巧的、手写的算术。 在相同搜索深度下,我通过自我对弈训练的网络胜过了手写的国际象棋评估函数,但在相同用时下只打成平手,因为它评估每个局面的成本更高。 这一个月给我留下的问题比开始时更好;我正在为每一次运行(包括失败的)记一本笔记,它也许会发展成一个系列。
这个月我在读 [*The Infinity Machine*](https://raskell.io/reading/#the-infinity-machine),这是 Sebastian Mallaby 为 Demis Hassabis 写的传记。Hassabis 是来自北伦敦的国际象棋神童,创立了 DeepMind,也就是 AlphaGo 和 AlphaFold 背后的那家实验室。我拿起这本书,是因为我想了解我们如今身处其中的这种 AI 的早期缔造者之一,而讲述者曾与他相处了三十个小时;也因为几乎所有让我感兴趣的东西,游戏、模拟、机器能独自学会什么这个问题,都贯穿在他的故事里。读到一百页左右,有一个场景让我一直放不下。
那是 1988 年,Hassabis 十二岁。他用下棋赢来的奖金买了一台 Commodore Amiga 500,又在查令十字街上的大书店 Foyles 里找到一本薄薄的平装书:David Levy 的 *The Chess Computer Handbook*。他一口气读完了。Levy 讲解了一个国际象棋程序如何由三个部分构成。棋盘必须变成数字。需要一个函数来审视局面,判断谁占优。还需要一个搜索来尝试各种走法,以及对这些走法的应着,再到对应着的应着,并剪掉明显糟糕的分支,因为这棵树生长的速度比任何计算机能跟上的都快。Hassabis 试着把它做出来,发现 Amiga 根本跑不动国际象棋,于是改写了一个黑白棋程序,赢了他五岁的弟弟。
读到这里我放下了书,一部分是因为我在那个男孩身上隐约看到了自己,另一部分是因为我意识到了两件事。第一,这三个部分至今仍是一个国际象棋程序的全部。三十八年后,世界上最强的引擎依然是:数字化的棋盘、一个评估函数,以及一个带剪枝的树搜索;变化在于,评估函数如今是由机器学出来的,而不是由人写出来的,而机器是通过与自己对弈学会它的。第二,我桌上那台笔记本电脑的内存是那台 Amiga 的三万倍,而我从未亲手构建过这三个部分。
所以这个月我动手了。我用 Rust 写了三个棋类引擎,分别对应国际象棋、日本将棋和围棋,把它们编译成 WebAssembly,让它们能在我手机的浏览器里对弈,还搭建了一个训练循环,目标是让其中一个变得比我手工所能做到的更强。应用在 [kishi.raskell.io](https://kishi.raskell.io),代码在 [GitHub 上](https://github.com/raskell-io/kishi)。这篇文章讲的是:为什么是这三种棋,为什么用这些工具,以及当书里的思想遇上一台普通机器时发生了什么。
## 这本书、这个人和这家实验室 {#the-book-the-man-and-the-lab}
Mallaby 本行并不是科技作者。他曾任《金融时报》特约编辑,两次入围普利策奖决选,现为外交关系委员会高级研究员;他此前的书都与钱有关:写对冲基金的《富可敌国》,写 Alan Greenspan 的 *The Man Who Knew*,写风险投资的 *The Power Law*。事实证明这正是合适的背景。*The Infinity Machine* 既是一部传记,也是一部公司史,建立在与 Hassabis 约三十小时的谈话和对他身边一百多人的访谈之上;它认真追问一个人为什么要去构建一项自己都认为危险的技术,就像认真追问如何构建一样。这本书今年早些时候出版。我读得很慢,AlphaGo 那几章还在后面,我发现自己并不介意,因为我宁愿在自己那个版本跑起来之后再去读它们。
如果你不关注这个领域:Hassabis 是这个领域如今视为元老的人物,年仅五十岁。他 1976 年生于芬奇利,母亲是新加坡华人,父亲是希腊族塞浦路斯人;十三岁时成为国际象棋大师,是世界上同龄棋手中排名第二的。十六岁时,他在游戏工作室 Bullfrog 参与编写了 *Theme Park*,这款游戏卖出了数百万份。他在剑桥读计算机科学,自己经营了一家游戏工作室七年,然后回到大学攻读神经科学博士,因为他认为,要造出一台智能机器,唯一的路是先理解现存的唯一实例。2010 年,在罗素广场的一间阁楼里,他与 Shane Legg 和 Mustafa Suleyman 创立了 DeepMind;那时,这个领域里几乎没有人相信他们设想的东西是可能的。第一笔真正的资金来自 Peter Thiel 的一支基金,其合伙人给这门科学打了 A+,给商业模式打了 F。
DeepMind 的构想是人工智能领域的曼哈顿计划,而它的方法正是把这本书与这篇文章联系起来的东西。它押注的是把 2010 年时都不受青睐的两个分支结合起来:深度学习,即 Geoffrey Hinton 捍卫了四分之一个世纪的多层神经网络;以及强化学习,即程序从自身行动的后果中学习,而不是从标注好的样本中学习;再在其上加入神经科学的思想。试验场是游戏,因为游戏有可以完整写下的规则,也有可以直接从棋盘上读出的分数。2013 年展示的第一个成果,是一个只凭像素就学会玩 Atari 游戏的智能体。Google 在 2014 年收购了这家公司。2016 年 AlphaGo 在首尔击败李世石;2017 年,它的继任者 AlphaZero 仅凭规则和与自己的对局,用同一个算法学会了国际象棋、将棋和围棋,并在每一种棋上都击败了当时最强的程序。这正是本文的三种棋,顺序也一样,而自我对弈就是我搭建的那个循环。随后是 2020 年的 AlphaFold,然后是两亿个蛋白质的预测结构,再然后是 2024 年的诺贝尔化学奖。就连公司名字都是一个三重致敬:致敬深度学习,致敬 Deep Blue,也致敬 Deep Thought,即《银河系漫游指南》里那台被要求给出终极答案的计算机。
我为什么读它?一部分是显而易见的原因:我的工作就是做 AI 平台,想从内部了解这场革命的缔造者之一的故事,而这本书恰恰提供了这些,甚至更多。一部分是因为那些相似之处,它们一次次让我猝不及防:一个把模拟偷偷塞进主题公园的游戏设计师,一个路过棋盘就忍不住想赢一局的竞争者,一个把世界看作信息、把心智看作构建现实而非记录现实之物的人。我在其中认出的部分,多到让我有些不自在。还有一部分是因为那份信念。Hassabis 在几乎没有人相信人工智能的时候就相信它,这种信念被书中坦率地称为近乎宗教,而他是对的。故事里贯穿着一条超人类主义的线索,从他在 Bullfrog 时读的 Iain Banks 小说,到 DeepMind 找到第一位投资人的奇点峰会,而他对这种思想的加州版本始终保持着一种冷淡的英式距离。我自己也有一条这样的线索,角度不同,来路也不同,那是另一篇文章的题目。在这里只需说一句:我读这本书时并不是一个怀疑论者。
在开头那些篇章里,比神童故事更吸引我的,是游戏如何一再成为入口。Hassabis 通过国际象棋学会了编程。他的第一个智能程序下的是黑白棋。在剑桥,他跟一位教授学了围棋,又把将棋下到了英国排名的顶端。他的朋友 David Silver,后来领导了 AlphaGo 的工作,是在他们的游戏公司倒闭后,在法国南部读了一本强化学习教科书,才走进这个领域的。Mallaby 把这条线追溯到 Claude Shannon 1950 年关于编程让计算机下国际象棋的论文,而 Levy 的手册正是把这篇论文介绍给了那个十二岁的少年。Shannon 写道,国际象棋程序本身没有实际意义,但掌握一种棋类或许可以成为「攻克其他性质相似、意义更重大的问题的楔子」。这句话已有七十六年历史,至今仍是我所知道的、为花一个月研究棋类辩护的最好的一句话。
## 我自己的棋 {#my-own-games}
我自己的国际象棋故事要小得多。我十几岁出头加入了一家国际象棋俱乐部,参加地区比赛,在其中几场里成绩不错:远不至于让一位国际象棋专栏作家穿过大厅去找我父亲谈话(Hassabis 六岁时就有人这样做过),如果不是这本书把我们俩放进了同一家书店,我也绝不会把自己和他的经历写进同一段。但这项游戏一直留在了我身边。有人邀我下棋,我从不推辞;最近一次是今年在旧金山的联合广场,对手是一位同事兼朋友。我对那种棋子高及膝盖的大型户外棋盘情有独钟,我喜欢的有两处,一处在卢塞恩,一处就在巴塞尔的莱茵河畔。坐火车时,我用手机在 lichess 上下棋。我也比预想中更享受这项游戏在 2020 年代意外获得的第二次生命:一部讲述虚构神童的电视剧让人们纷纷去买棋盘,特级大师们变成了主播,观众多到任何比赛大厅都容纳不下。我没料到会这样,也没什么可抱怨的。
我游戏生活的另一半,是德语里所说的 Aufbauspiele,即建造类游戏:Anno、Die Siedler、整个大亨类游戏,凡是让你铺设一个有规则的世界、然后看它运转的东西都算。Hassabis 的 *Theme Park* 就是其中之一,这让那一章读起来格外亲切。薯条放多了盐,游客就会口渴,多买饮料;过山车太快,乘客就会呕吐:这正是我玩这类游戏所追求的那种机制。我最喜欢那些试图模仿现实、让一套厚重的规则自己生成无人编写的故事的游戏,这就是我热爱 Dwarf Fortress 的原因,也是我不断构建自己的模拟的原因,从[一皿在刺激下学习的神经元](https://raskell.io/articles/brain-emulation-as-an-infrastructure-problem/),到一个任其演化的[生态缸](https://terrarium.raskell.io)。从这个角度看,一个国际象棋引擎是最小的值得构建的模拟:一个有规则的完整世界,而其中有一个必须学习的智能体。
## 为什么是棋类,为什么是这三种 {#why-games-and-why-these-three}
Shannon 的观点很务实。像国际象棋这样的游戏,规则可以完整写下,结果可以毫无争议地从棋盘上读出,而它的深度无论怎样研究都未曾穷尽。这样的组合很罕见。大多数现实问题规则模糊、结果有争议,也没有衡量标准。一种棋类给你一间实验室,新想法可以在一个下午内接受检验,对手是几个世纪积累的人类知识,而答案是一个数字。
这个领域的历史也恰好是沿着国际象棋、将棋和围棋这三种棋依次展开的,而每一种都打破了在前一种上行之有效的方法。这就是我三种都选、而不是只选一种的原因。
**国际象棋**大约在六世纪起源于印度北部,当时叫恰图兰卡,经由波斯传入欧洲,并在十五世纪末的西班牙和意大利定型为现代形式,有了长距离行走的后和象。它是 Shannon 选中的棋,是 Levy 的手册所讲授的棋,也是搜索加评估这一经典方法为之打造的棋。1997 年,IBM 的 Deep Blue 击败了 Garry Kasparov,靠的是在专用芯片上每秒搜索两亿个局面,评估函数由人编写和调校。这是三个部分的胜利,却让所有期待洞见的人失望:机器赢在看得更远,而不是理解得更多。从 Levy 那一章开始,有意思的问题一直是:评估函数能否学出来,而不是写出来。对国际象棋而言,这个问题在 2018 到 2020 年间得到了回答,答案是一个住在引擎内层循环里的小型神经网络。它叫 NNUE,而它并不是为国际象棋发明的。
**将棋**是同一家族的日本分支。它在十一世纪前经由中国和东南亚传入日本,到十六世纪形成现在的样子,并在德川幕府时期成为一种制度,幕府给最好的棋手发放俸禄;名人这一至今仍为将棋冠军加冕的头衔,第一次授予是在 1612 年。如今日本有数百万人下将棋,有职业体系,有电视转播的头衔战,还有一位年轻的明星藤井聪太,他在 2023 年、二十一岁时同时持有全部八大头衔。棋盘是九乘九,每方有八种共二十枚棋子,大多数棋子走到对方的三行内就会升变。有一条规则让它成了另一种游戏。被吃掉的棋子会换边,进入吃子方的手中,之后可以作为一步棋打入几乎任何空格。没有棋子会永久离开棋盘,所以这种棋永远不会像国际象棋那样逐渐简化。典型的一手大约有八十种走法可选,而国际象棋是三十五种;对局更长,残局是双方的竞速,而不是技术性的消耗战。对程序员来说,打入让评估函数难以手写得多,这就是学习最先在这里发生的原因。2006 年,Bonanza 改变了电脑将棋,它是第一个评估函数根据职业棋谱拟合、而非手工调校的程序。2017 年,Ponanza 击败了现任名人佐藤天彦;2018 年,那须悠发表了那个网络设计,两年后 Stockfish 把它用在了国际象棋上。我所追寻的那个想法,就来自将棋。
**围棋**比两者都古老,也比两者都简单。它源自中国,至少已有两千五百年历史,与琴、书、画并列为文人的四艺;它在八世纪前传入日本,江户时代的职业棋手家族由幕府供养;在韩国它也根基深厚,在那里叫作 baduk。规则写在一张卡片上就够了。两名棋手轮流把黑白棋子放在十九乘十九棋盘的交叉点上。一块棋如果周围没有空点,就会被提走。终局时,围住更多地盘的一方获胜,后手的白方会得到几目补偿。从这些规则中诞生的,是一种每一手都有约二百五十种选择、一局两三百手、而且没有人能手工为局面打分的游戏。Levy 的三个部分在这里失效了。在围棋里向前看四步的搜索几乎什么都看不到,也没有任何公式能在叶节点上判断谁在领先。围棋是这个领域里所有人(包括 Hassabis)都称为大挑战的那种棋,也是 DeepMind 想要展示实力时选中的棋。2000 年代后期的程序用蒙特卡洛树搜索取代了国际象棋的方法:它把成千上万盘随机对局下到终局,统计谁赢;这让程序达到了强业余水平,然后就停滞了。AlphaGo 保留了这种搜索,又给了它两个神经网络,一个提议走法,一个评判局面,先用人类棋谱训练,再用它自己的对局训练;2016 年 3 月,它以四比一击败了李世石。
所以:一种棋,经典方法行得通,网络取代了评估函数;一种棋,同样的方法捉襟见肘,网络在这里被发明出来;一种棋,方法失效,网络必须亲自引导搜索。三者合在一起,就是这个领域四十年历史的一门速成课,而每一种都可以拿任何人都能下载的对手来测量。
## 为什么我要亲手构建,而不只是读读而已 {#why-i-built-it-rather-than-read-about-it}
Hassabis 喜欢引用 Feynman 那句话:我造不出来的东西,我就不理解。这也是这个项目真正的原因。AlphaGo 的论文和 Stockfish 关于 NNUE 的文章我都读过不止一遍。那些图示我能讲解。但我说不出 K 是什么,说不出为什么一个在相同搜索深度下获胜的网络会在相同用时下落败,也说不出一代自我对弈要耗费一台笔记本电脑多少小时的寿命,因为这些正是论文略去不提的东西,而学会它们的唯一办法就是为之付出代价。读这本书让这道鸿沟变得令人不安,而那种让我去造生态缸的冲动,也想让那个有规则、有学习者在其中的世界,在我自己的机器上运行起来。
另一个原因是,原料第一次全都摆在了我的桌上。思想已经发表,参考实现都是开源的。笔记本电脑是一台 MacBook Pro,Apple M4 芯片,十个核心,十六 GB 内存,它不是研究用的机器,通用计算能力却超过了当年的 Deep Blue。我手机上的浏览器现在能运行带向量指令和真正线程的编译代码。至于写代码本身,原本要耗去一整个冬天的晚上,借助编码智能体只用了几天:由我决定构建什么,大部分代码由智能体来敲。这一点属于方法的一部分:智能体写代码,两个引擎之间的对局决定代码好不好,而对局并不在乎代码是谁写的。
## 为什么用 Rust,而不是 PyTorch {#why-rust-and-not-pytorch}
2026 年做机器学习,显而易见的方式是 Python 和 PyTorch;如果目标是一个在服务器上回答问题的模型,我也会用它们。但目标是我手机上的一个对手,在浏览器标签页里,离线运行,这决定了后面的一切。
国际象棋的评估函数是在搜索内部被调用的,每秒大约一百万次,在单个核心上,没有批处理,而不是每个请求调用一次。住在那里的网络不可能是 API 背后的一个模型。它必须是用引擎自身语言写成的几百行算术,在整数上运行,并且随着走棋增量更新,而不是从头重新计算,这正是 NNUE 的全部诀窍。换句话说,推理部分无论如何都得手写。手写完之后,训练器就是同样的算术反过来跑,面对一百万个参数和几乎全为零的输入,它同样只需要几百行。亲手写它,也让我发现了框架本会对我隐藏的东西:一个我凭猜测而非拟合得出的常数,把一个会赢的网络变成了一个会输的网络,而如果用框架,我不会知道为什么。
Rust 是我在这个网站上写所有东西用的语言,从[神经元培养](https://hotaru.raskell.io)到[幻想游戏机](https://wasmad.raskell.io)都是,对引擎而言它也是合适的工具,理由是常见的那些:在每秒运行一百万次的循环里没有垃圾回收器,能控制内存布局,编译器还能从与原生二进制相同的源码生成带向量指令的 WebAssembly。从笔记本电脑上的自我对弈到手机上的每一步棋,都是同一种语言,在同一个仓库里,而网页应用没有构建步骤。代价也要坦白说。在 CPU 上训练一个小型稀疏网络没问题。但如果围棋网络最终成为一个有数百万稠密参数的卷积网络,十个核心上的 Rust 会很慢,到时我就得决定,是写一个 Metal 内核,还是承认这正是笔记本电脑研究与 GPU 相遇的地方。
## 为什么用 WebAssembly {#why-webassembly}
因为手机才是重点。住在服务器上的对手不属于我;应用商店里的对手要由别人来批准。一个我添加到主屏幕上的网页,能在飞机上使用,运行的二进制与我笔记本电脑上的完全相同,这才是我想要的版本,而在 2026 年,浏览器做得到。WebAssembly 支持 128 位向量指令已经有一段时间了,而 Safari 现在允许页面在线程之间共享内存,只要它带着正确的隔离响应头提供服务,所以我手机上的国际象棋引擎能用四个核心搜索。免费国际象棋网站 Lichess 也是用同样的方式为它的分析棋盘运行 Stockfish,这在我动手之前就证明了这条路是可行的。
这个约束对设计的塑造也超过了任何一篇论文。一个必须随网页下载、在手机上运行的网络必须很小;Kishi 的国际象棋网络是 820 KB,编译进了引擎的二进制文件里。一个必须在浏览器标签页里运行的搜索必须节俭。代码里每一个看起来像是品味的决定,其实都是手机在对某样东西说不。
## 结果如何 {#what-happened}
国际象棋引擎最先完成:位棋盘,一个带有一系列常见剪枝启发式方法的搜索,以及一个借用一套知名的棋子位置表的手写评估函数。对手是按 lichess 配置其电脑对手的方式设置的 Stockfish,每个级别二十局,单核:它以十九比一击败 4 级,以十三比七击败 6 级,以半比十九个半输给 7 级。如果你和 lichess 的电脑下过棋,就能据此给它定位:一个扎实的俱乐部棋手,离顶尖还差得很远。
然后是那个循环。引擎从随机开局与自己对弈了五十二分钟,从五万七千盘对局中产生了 560 万个局面,每个局面都标注了搜索对它的判断以及那盘棋的结果。用这些局面训练一个网络只花了不到二十分钟;在双方被允许查看相同数量局面的条件下,它比它所取代的手写评估函数强 85 个等级分,误差正负 32。而当双方被允许使用相同的毫秒数时,两者打成平手,因为网络评估每个局面的成本是手写评估的两倍半。这一句话就是这类学习的全部问题所在,而在拿到这些数字之前,我并不理解它。
将棋有了自己的引擎,结构相同,评估函数也是手写的;它以二十比零击败 Fairy-Stockfish 最弱的设置,以二比十八输给中等设置。围棋用的是 2000 年代后期的方法,即蒙特卡洛树搜索,加上旧程序 MoGo 的棋形模式;对阵最低级别的 GNU Go、每步一秒时,它十盘赢三盘。三个引擎都能在手机上下。在最高级别上,只有国际象棋引擎是我会称为令人满意的对手,而这还是用手写评估函数的结果,因为训练出来的网络还没有在棋钟上赢得自己的位置。
## 由此打开的问题 {#what-this-opened-up}
我开始时只有一个问题:我能否构建 Levy 的三个部分。而这个月结束时,我有了五个更好的问题。
国际象棋网络在相同搜索下获胜,在相同用时下打平。经过更多代的自我对弈,随着它学习所用的对局越来越强,这会改变吗?还是说,一个笔记本电脑大小的网络永远要为自身的成本买单?我写下这些文字时,循环正在以低优先级运行,好让笔记本电脑仍然能用。为什么一个常数会让结果相差 176 个等级分,这又说明了一个学习得来的组件与它所接入的手工调校系统之间是一种怎样的契约?一旦网络能看到王的位置(那须的原始设计做到了,我的还没有),同样的循环在将棋上是否行得通?围棋需要第二种循环,由搜索来教网络该看哪些走法,而我不知道一台笔记本电脑能在完整的十九路棋盘上训练出什么;书中 AlphaGo 那几章我就快读到了,它们会告诉我 2016 年需要什么,而我想知道的是 2026 年在一台商店里买来的机器上需要什么。而在这一切之下:一个引擎的棋力,从原生二进制到手机浏览器标签页的这一趟旅程中能保留多少,线程又能挽回多少?
每一个问题都是几天的工作和几个数字,我已经开始在仓库里记[一本笔记](https://github.com/raskell-io/kishi/blob/main/docs/study/notebook.md),好让数字一出来就被记下,失败的也包括在内。如果答案和问题一样有趣,这也许会成为几篇文章中的第一篇,一次一个想法,先是国际象棋,然后是将棋,再然后是围棋。且看吧。
## 参考资料 {#references}
- Sebastian Mallaby, *The Infinity Machine: Demis Hassabis, DeepMind, and the Quest for Superintelligence* (Penguin Press, 2026),第 1 至 5 章。
- Claude Shannon, [Programming a Computer for Playing Chess](https://www.computerhistory.org/chess/doc-431614f6d9b4e/), *Philosophical Magazine* (1950).
- David Levy, *The Chess Computer Handbook* (Batsford, 1984).
- Yu Nasu, [Efficiently Updatable Neural-Network-based Evaluation Functions for Computer Shogi](https://www.apply.computer-shogi.org/wcsc28/appeal/the_end_of_genesis_T.N.K.evolution_turbo_type_D/nnue.pdf) (2018,日文);Stockfish, [Introducing NNUE Evaluation](https://stockfishchess.org/blog/2020/introducing-nnue-evaluation/) (2020).
- David Silver 等, [Mastering the game of Go with deep neural networks and tree search](https://www.nature.com/articles/nature16961), *Nature* (2016).
- [Kishi](https://github.com/raskell-io/kishi):引擎、训练循环,以及记录每一次运行的笔记。
================================================================================
---
title: "智能体究竟是什么"
url: https://raskell.io/zh/articles/what-an-agent-actually-is/
author: Raffael Schneider
date: 2026-06-02
description: "「AI 智能体」是业内含义最混乱的词。本文讲它的结构、来历,并用 Bun 上大约两百行 TypeScript 写出一个能运行的实现。The Agent Platform Handbook 第一篇。"
tags: [agents, ai-platforms, durable-execution, typescript]
series: the-agent-platform-handbook
lang: zh-Hans
translation_of: https://raskell.io/articles/what-an-agent-actually-is/
---
# 智能体究竟是什么
## 简而言之
智能体是具备五项属性的软件:目标、模型、上下文、工具和循环;少了任何一项,得到的就是聊天机器人、工作流或一次性补全。 从 SHRDLU 和 BDI 的研究开始,这套架构就是对的;缺的是一个可用的语言模型,而函数调用随后把循环变成了一个软件问题。 2025 到 2026 年间,先是编程智能体,后是助理智能体,把循环、工具和运行时打包在一起;可几乎没有哪个组织在它们底下有一个连贯的平台,这个系列要补上的正是这一块。 我用 Bun 上的 TypeScript 写了一个能运行的智能体,只有一个 shell 工具和一个迭代预算,并说明随着聊天产品悄悄长出工具,名称总是落后于架构。 聊天机器人的失败在于知道得不够,智能体的失败在于做错了事,失败模式包括失控的循环与成本、谎报成功、缺乏隔离和隐藏状态,后续文章会逐一处理。
> *The Agent Platform Handbook. From Loop to Platform.* 的第 1 篇。这个系列共 22 篇,从单个循环一路走到生产级平台,覆盖整个智能体技术栈。下一篇:[Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/)。
如果你在同一天开三个会,会听到 *agent*(智能体)这个词被用来指三种不同的东西。供应商用它指一个带 logo 的聊天窗口。平台团队用它指一个带重试的工作流。安全负责人用它指一个长期运行、拿着你看不见的凭证的进程。这些人都不算完全错。但他们说的不是同一件东西。
这是一个系列的第一篇,这个系列从单个智能体循环一直讲到生产级平台。在谈隔离、工具、身份或编排之前,我们得先就架构图正中间那个东西到底是什么达成一致。所以我们会先给它下定义,勾勒它的结构,回顾业界走到今天的路径,然后用 Bun 上大约两百行 TypeScript 写出一个能运行的智能体。
读完这篇,这个抽象名词就会变成一个你能运行的具体文件。
## 一个可用的定义 {#a-working-definition}
智能体是具备五项属性的软件。去掉任何一项,你得到的就是别的东西。
1. **目标。** 不是单条提示词,而是系统试图满足的一个目标状态、一段任务描述或一个问题陈述。
2. **模型。** 一个或多个推理引擎,把当前状态加上目标转换成下一步行动。如今这几乎总是一个大语言模型。
3. **上下文。** 模型在用户输入之外能读到的信息:系统提示词、文档、之前的对话轮次、环境状态、配置文件。
4. **工具。** 一组有限的、具名的、带副作用的操作,模型被允许调用它们。读一个文件,执行一条 shell 命令,调用一个 API。
5. **循环。** 模型选一个工具,工具运行,结果重新进入上下文,模型再选。当目标达成、预算耗尽或触发停止条件时,循环结束。
在生产环境里通常还有第六项属性,**记忆**,也就是在循环结束后仍然保留的状态。我们会在[第六篇](https://raskell.io/articles/memory-is-a-write-path/)把记忆当作单独的一层来讲,这第一个智能体则保持无状态。
五项属性齐全的系统就是智能体。只有四项的系统是另一种值得命名的东西。聊天窗口有目标、模型、上下文和循环,但没有工具,所以它是聊天机器人。CI 流水线有目标、上下文、工具和循环,但没有模型,所以它是工作流。一次函数调用有目标、模型、上下文和一个工具,但没有循环,所以它是一次性补全。有了循环,行为才是开放式的。有了工具,循环才有意义。
迄今交付过的每一个智能体,架构图都长这样。
*The agent loop*
```text
+--------------+
| Goal |
| (user task) |
+-------+------+
|
v
+------------+ +---------------+ +------------+
| Context +-------->| Model |<--------+ Memory |
| docs, env, | | next action? | | (optional) |
| prior turns| +-------+-------+ +------------+
+------------+ |
| tool call
v
+---------------+
| Tool |
| shell, http, |
| file, custom |
+-------+-------+
|
| result
v
+---------------+
| Runtime |
| (where the |
| side effect |
| happens) |
+-------+-------+
|
v
+----------+----------+
| done? --no--> loop |
| | |
| yes |
| v |
| return |
+---------------------+
```
这张图故意画得很小。这个系列几乎每一篇都会重画它,并展开其中一个组件。第二篇展开运行时。第三篇展开工具。第四篇展开上下文。第六篇展开记忆。第七篇展开模型。系列末尾的收官篇把它们全部组装成一套参考架构。
把这张图记在脑子里。我们还会回到它。
## 我们是怎么走到这里的 {#how-we-got-here}
这一节剩下的部分可以当背景读;如果前两小节讲的你都亲身经历过,可以跳过。第三小节讲 2024 到 2026 年这一段,无论如何都值得一读,因为它解释了为什么你身边每个人突然都在用 *agent* 这个词。
### 老派 AI {#the-old-ai}
软件智能体这个想法比现代大语言模型早了大约五十年。Terry Winograd 在 1970 年做的 SHRDLU,是一个接收自然语言指令、在模拟的积木世界里规划动作、执行动作并更新内部状态的程序。它有目标、有世界模型、有一组工具,也有循环。它就是一个智能体。它在积木世界里运行得很漂亮,可你一走出那个世界它就垮了,因为世界模型是手写的,语言理解也很脆弱。
整个 1980 和 1990 年代,这个想法换着名字一再回来。专家系统把业务逻辑包进推理规则里。由 Bratman 等人形式化的「信念、愿望、意图」(Belief-Desire-Intention)架构,给了智能体一个明确的认知模型:它相信什么,它想要什么,它接下来打算做什么。那时有好论文,有能运行的系统,也有上市的产品。它们共同缺少的,是一个可用的语言模型。你可以用形式逻辑或结构化的 DSL 来指定智能体的目标。你没法说一句「帮我订张机票」就让它解析明白。
这个时代的教训是,这套架构几十年来一直是对的。瓶颈在模型。
### 聊天时代 {#the-chat-era}
GPT-3 在 2020 年出现,ChatGPT 在 2022 年底出现,语言这道瓶颈被打破了。你终于可以用英语写下一个目标,系统会连贯地回应。业界的第一反应,是把这项能力包进一个聊天窗口里拿去卖。那不是智能体。它没有循环,没有工具,模型对它所处的世界什么也做不了。它是一个非常好的自动补全,外加对这段对话的记忆。
直到有人问出那个显而易见的下一个问题,智能体模式才回来。既然模型能读写英语,我们又能让它调用函数,那能不能把循环闭合,让它去行动?
2022 年底到 2023 年初,两篇论文和两个爆红的演示回答了这个问题。
论文先到。Yao 等人在 2022 年 10 月发表的 *ReAct: Synergizing Reasoning and Acting in Language Models* 表明,把推理步骤和工具使用步骤交替进行,效果好于单独使用其中任何一种。这份蓝图小到能写在一张餐巾纸上:思考,行动,观察,重复。此后交付的几乎每一个智能体,都把它当成了事实上的标准模式。
演示在 2023 年初到来。Toran Bruce Richards 在 2023 年 3 月发布的 Auto-GPT,把 GPT-4 包进的正是这个循环,并让它无人值守地运行。它的演示效果惊艳,实际却一直出故障。几周后,Yohei Nakajima 的 BabyAGI 用大约一百行 Python 做了同样的事。两者都不是生产级的。但两者都让从没读过 ReAct 论文的人看懂了这个想法。Auto-GPT 之后,你可以这样解释智能体:「想象一个 ChatGPT,但它会一直做下去,直到任务完成。」这是营销上的突破,不是工程上的突破,但想法正是靠营销传播的。
随后到来的工程突破,是 OpenAI 在 2023 年 6 月推出的函数调用 API。你不必再从自由行文里解析出「模型想调用 `search(query)`」,而是用 JSON schema 声明你的工具,模型则返回一个结构化的工具调用。Anthropic 的 `tool_use` 也按同样的模式上线。有了函数调用,智能体循环不再是一个正则表达式问题,而开始成为一个软件问题。我们会在[第三篇](https://raskell.io/articles/tools-how-agents-actually-do-things/)回到这一点。
2023 年这一波催生了第一批真正的框架:2022 年 10 月的 LangChain,2023 年底的 AutoGen,2024 年的 CrewAI 和 LangGraph。它们比拼的是抽象。有的赢了,有的输了。我们会在后面的文章里评点它们。眼下要说的是,到 2024 年年中,构建一个智能体已经是一道 Python 或 TypeScript 练习题,而不再是一个研究项目。
### 2025 到 2026 年的打包 {#the-2025-to-2026-bundling}
正是在这里,*agent* 这个词不再是一个研究术语,而成了一个产品类别。这分两波发生。
第一波面向构建者。2025 年初,Anthropic 推出了 Claude Code,一个在你的笔记本电脑上运行的命令行智能体,能编辑文件、执行 shell 命令,还能派生子智能体。OpenAI 把 Codex 重新推出,作为一个真正的智能体,而不再是一个补全接口。开源社区做出了 OpenCode 和五六个相近的项目(aider、continue、opencoder),给同样的形态提供了不绑定供应商的界面。这些在技术上都不新。循环就是 ReAct 循环。工具就是 `bash` 和 `edit`。新的是打包:循环、工具和运行时一起到来,装在一个三十秒就能装好的二进制文件里。这一出来,每个基础设施和平台工程师在一周之内,笔记本上就都有了一个能用的智能体。
接下来发生的事,我写在了 [What Sixteen AI Agents Taught Me About Management](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/) 里。构建者一旦有了能用的智能体,就想同时跑不止一个。一旦跑了不止一个,就撞上了协调问题。一旦撞上协调问题,就发现智能体编排其实是一个套着软件外壳的管理问题。
第二波面向助理场景,它彻底冲出了开发者的圈子。OpenClaw 在 2026 年初发布,第一周就在 GitHub 上突破了十万颗星。Hermes 紧随其后,走的是同一条路。两者都把智能体模式交给了不写代码的人。一项调研任务。一份合同审阅。一次日程协商。同样的循环,换了不同的工具和不同的上下文。企业里的买家不再是开发者工具团队,而变成了任何一条有工作流的业务线。
截至 2026 年年中,市场就处在这个位置。每个工程组织都有构建者在本地跑编程智能体。每个业务组织都有人在试点助理智能体。几乎没有哪个组织在这一切底下有一个连贯的平台。这个系列的目的,就是填上这道缺口。
## 动手写一个 {#build-one}
要明白智能体是什么,就动手写一个。下面的代码是一个完整、能运行的智能体,用 Bun 上的 TypeScript 写成,大约两百行。它从命令行读取一个目标,带着一个小小的工具注册表调用 Anthropic 的 API,执行工具调用,把结果送回去,并在模型完成或迭代预算耗尽时停止。
要跟着做,你需要三样东西。
```
bun --version # 1.1 or newer
echo $ANTHROPIC_API_KEY # any valid key
bun add @anthropic-ai/sdk
```
本文的完整源码在 [`the-agent-platform-handbook`](https://github.com/raskell-io/the-agent-platform-handbook) 的 `post-01` 标签下。如果你更愿意在编辑器里读代码,可以克隆下来,运行 `bun agent.ts "list the three largest files under /etc"`。
### 工具接口 {#the-tool-interface}
最值得先定义的最小单元是工具。一个工具有名字、一段模型能读的描述、一个描述输入的 JSON schema,以及一个执行副作用并返回字符串的函数。
```typescript
// tools.ts
export type Tool = {
name: string;
description: string;
input_schema: {
type: "object";
properties: Record;
required?: string[];
};
run: (input: Record) => Promise;
};
```
这就是全部的契约。`run` 函数返回字符串,因为模型会把结果当作文本来读。如果你的工具返回结构化数据,就用 `JSON.stringify` 序列化,让模型自己去解析。等我们在[第三篇](https://raskell.io/articles/tools-how-agents-actually-do-things/)更仔细地看结构化输出时,会重新审视这个选择。
shell 工具是你能交给智能体的最有用的单个工具,它长这样。
```typescript
// tools.ts (continued)
export const shell: Tool = {
name: "shell",
description:
"Run a shell command in the current working directory and return its stdout, stderr, and exit code as JSON.",
input_schema: {
type: "object",
properties: {
command: {
type: "string",
description: "The shell command to run. Runs under `sh -c`.",
},
},
required: ["command"],
},
run: async ({ command }) => {
const proc = Bun.spawn(["sh", "-c", String(command)], {
stdout: "pipe",
stderr: "pipe",
});
const [stdout, stderr] = await Promise.all([
new Response(proc.stdout).text(),
new Response(proc.stderr).text(),
]);
const code = await proc.exited;
return JSON.stringify({ code, stdout, stderr });
},
};
```
有几点值得注意。描述是写给模型看的,不是写给你看的。要具体写明工具做什么、返回什么、有哪些限制。JSON schema 是模型在决定要不要调用这个工具时看到的契约。Bun 的 `Bun.spawn` 返回的是流,所以我们把 stdout 和 stderr 都读出来,连同退出码合成一个模型可以据此推理的 JSON 载荷。
这个工具会执行任何 shell 命令。这极其不安全。不要部署它。我们会用[第二篇](https://raskell.io/articles/your-agent-wants-root/)解释为什么,以及该怎么办。对于在你自己笔记本上、单用户、单目录的演示来说,它没问题。
### 循环 {#the-loop}
循环是大多数讲解匆匆带过的部分。我们慢慢来。
```typescript
// agent.ts
import Anthropic from "@anthropic-ai/sdk";
import type { MessageParam, ToolResultBlockParam } from "@anthropic-ai/sdk/resources/messages";
import { shell, type Tool } from "./tools";
const client = new Anthropic();
const tools: Tool[] = [shell];
const SYSTEM_PROMPT = `You are a careful command-line assistant.
You have access to a shell tool. Use it to investigate the user's
request and answer concretely. When you have the answer, stop calling
tools and reply in plain text.`;
```
我们引入 SDK,注册一个工具,再写一段系统提示词。系统提示词是第一块不属于用户输入的上下文。我们会用[第四篇](https://raskell.io/articles/context-is-the-product/)讲如何把它发展成一套真正的上下文策略。眼下它只是一段话,告诉模型该如何表现。
```typescript
// agent.ts (continued)
async function step(messages: MessageParam[]) {
return client.messages.create({
model: "claude-sonnet-4-6",
max_tokens: 4096,
system: SYSTEM_PROMPT,
tools: tools.map(({ run, ...t }) => t),
messages,
});
}
```
每一次调用模型都是一个 `step`。我们发出去的工具列表只有 schema,从不包括 `run` 函数,所以要把它去掉。模型返回的消息要么是最终的文本回答,要么是调用一个或多个工具的请求。
循环本身五十行。
```typescript
// agent.ts (continued)
export async function run(goal: string, maxIterations = 10) {
const messages: MessageParam[] = [{ role: "user", content: goal }];
for (let i = 0; i < maxIterations; i++) {
const response = await step(messages);
messages.push({ role: "assistant", content: response.content });
if (response.stop_reason === "end_turn") {
const text = response.content
.filter((b) => b.type === "text")
.map((b) => (b as { text: string }).text)
.join("\n");
console.log(text);
return;
}
if (response.stop_reason !== "tool_use") {
throw new Error(`unexpected stop reason: ${response.stop_reason}`);
}
const toolResults: ToolResultBlockParam[] = [];
for (const block of response.content) {
if (block.type !== "tool_use") continue;
const tool = tools.find((t) => t.name === block.name);
if (!tool) {
toolResults.push({
type: "tool_result",
tool_use_id: block.id,
content: `unknown tool: ${block.name}`,
is_error: true,
});
continue;
}
console.error(`> ${block.name} ${JSON.stringify(block.input)}`);
try {
const result = await tool.run(block.input as Record);
toolResults.push({ type: "tool_result", tool_use_id: block.id, content: result });
} catch (err) {
toolResults.push({
type: "tool_result",
tool_use_id: block.id,
content: String(err),
is_error: true,
});
}
}
messages.push({ role: "user", content: toolResults });
}
console.error(`iteration limit (${maxIterations}) reached`);
}
```
从头走一遍。我们把目标作为第一条用户消息。我们调用模型。我们把模型的回复追加到对话里。如果模型给出 `end_turn`,我们打印最终文本并返回。如果模型给出 `tool_use`,我们找到它请求的工具,运行它,并把结果作为一个用户角色的 `tool_result` 块追加进去。模型在下一轮看到结果,再决定做什么。
带 `maxIterations` 的 `for` 循环,是这个智能体和无休止运行之间唯一的屏障。我们会在[第八篇](https://raskell.io/articles/the-bill-is-part-of-the-loop/)用相当篇幅讨论迭代次数是不是合适的预算单位。它不是,但它最简单。先从最简单的开始。
入口只有两行。
```typescript
// agent.ts (continued)
const goal = process.argv.slice(2).join(" ");
if (!goal) {
console.error("usage: bun agent.ts ''");
process.exit(1);
}
await run(goal);
```
这就是整个智能体。算上 import 和系统提示词,大约一百四十行代码。按我们开头的定义,它是一个真正的智能体。它有目标、模型、上下文(系统提示词和不断增长的消息列表)、工具(一个)和循环(带 `maxIterations` 的 `for`)。
### 运行它 {#running-it}
一小段运行记录能让循环变得具体。
```
$ bun agent.ts "what is the largest TypeScript file under src and what does it do?"
> shell {"command":"find src -name '*.ts' -type f -printf '%s %p\n' | sort -nr | head -5"}
> shell {"command":"wc -l src/agent.ts"}
> shell {"command":"head -40 src/agent.ts"}
The largest TypeScript file under src is src/agent.ts at 4837 bytes
(150 lines). It implements an agent loop against the Anthropic Messages
API. It defines a single shell tool, sends the user's goal to the model,
executes any tool calls the model requests, feeds the results back, and
stops when the model returns an end_turn response or the iteration
budget of 10 steps is exhausted.
```
以 `>` 开头的行是智能体的工具调用,由循环里的 `console.error` 记录下来。最后一段是模型的 `end_turn` 文本。三次工具调用,一个最终回答,一个闭合的循环。
你有了一个智能体。
## 为什么大多数智能体演示都不是智能体 {#why-most-agent-demos-are-not-agents}
既然定义已经具体,你手里也有了一个能运行的例子,「什么是智能体、什么不是」这个问题就变得有用了。诚实的答案在这张表里。
| 系统 | 目标 | 模型 | 上下文 | 工具 | 循环 | 结论 |
|--------------------------------------|:----:|:-----:|:-------:|:-----:|:----:|-------------|
| ChatGPT,2022 年上线时 | Y | Y | Y | N | Y | 聊天机器人 |
| 今天的 ChatGPT(浏览、代码、文件) | Y | Y | Y | Y | Y | 智能体 |
| Cursor 的行内编辑 | Y | Y | Y | Y | N | 补全 |
| 一个 GitHub Actions 工作流 | Y | N | Y | Y | Y | 工作流 |
| 纯检索增强聊天 | Y | Y | Y | N | Y | 聊天机器人+RAG |
| 一次函数调用 API 请求 | Y | Y | Y | Y | N | 工具调用 |
| 终端里的 Claude Code | Y | Y | Y | Y | Y | 智能体 |
| 本文的脚本 | Y | Y | Y | Y | Y | 智能体 |
| Auto-GPT、BabyAGI | Y | Y | Y | Y | Y | 智能体 |
| OpenClaw | Y | Y | Y | Y | Y | 智能体 |
| 带一个 LLM 步骤的 Temporal 工作流 | Y | Y | Y | Y | Y | 智能体 |
前两行是同一个产品,相隔两年。ChatGPT 在 2022 年 11 月上线时,是一个没有工具的聊天窗口。如今同一个网页界面能浏览实时网络、在沙箱运行时里执行 Python、转换和阅读 PDF、生成图片。它跨过了那条线。有意思的是,面向用户的说法并没有变。它仍然被叫作聊天机器人。按我们采用的定义,它是一个智能体。边界在营销话术底下悄悄移动了。
这就是接下来两年整个行业里可以预期的模式。每个聊天产品都会悄悄长出工具。每个工作流产品都会悄悄长出模型。名称会落后于架构一两年。如果你只听名称,就会错过一个系统变成需要你换一种方式去治理的东西的那一刻。
纯 RAG 那一行是没有跨线的那一个。一个只充实自身上下文的检索增强聊天,并没有获得真正意义上的工具。模型无法根据它找到的东西决定去做点不同的事。它只是从更丰富的上下文里作答。有用,有时非常出色,但不是智能体。一旦同一个系统获得了「换个查询再搜一次」或「去取这份文档」这样的工具,它就是了。
带 LLM 的 Temporal 那一行,有意思的地方恰好相反。它是一个智能体。它也是一个工作流。这两个类别并不互斥。后面会有一篇文章解释,为什么几乎每个智能体的生产版本,最后都会被包进一个持久化工作流里。
这张表的意义不在于为这个词把关,而在于指出概念上的区别。聊天机器人的失败在于知道得不够。智能体的失败在于做错了事。一旦你的系统能够行动,失败模式就变了,你对运维人员所负的责任也随之改变。
## 失败模式 {#failure-modes}
上面的脚本,你最初运行的十次都会正常工作。它的有些失败模式显而易见。有些只有在生产环境里才看得到。下面是诚实的清单,大致按你遇到它们的顺序排列。
- **伪装成进展的无限循环。** 模型可以一直调用工具而永不收敛。`maxIterations = 10` 今天能把你从自己的演示里救出来。明天有人问一个更难的问题时,它就救不了你了。真正的预算是基于 token 或挂钟时间的,而不是基于步数。我们会在[第八篇](https://raskell.io/articles/the-bill-is-part-of-the-loop/)好好解决这个问题。
- **成本失控。** 每一次迭代都是一次完整的模型调用,以整个对话为输入。token 成本大致随步数呈平方增长,因为每个新轮次都要把之前的所有轮次重新发一遍。一个十步的循环,花费超过一步调用的十倍。提示词缓存有帮助。在便宜的轮次换用更小的模型帮助更大。我们会用[第八篇](https://raskell.io/articles/the-bill-is-part-of-the-loop/)来讲这个。
- **谎报成功。** 模型可能声称完成了任务,却并没有真正验证。shell 工具不检查答案是否正确。你问「你做了 X 吗?」,可能得到「做了」,而真相是「我试了,失败了,我放弃了」。评测(eval)就是为此存在的。后面有一篇文章会讲它。
- **损坏的工具输出。** 如果一个工具返回一兆字节的二进制数据,模型会噎住或者产生幻觉。工具输出需要经过摘要、截断或按 schema 整形。智能体不会替你做这件事。
- **没有隔离。** 如果模型认定 `rm -rf $HOME` 是正确的命令,shell 工具就会执行它。模型不会经常这么认定。但至少会有一次。这是下一篇的主题。
- **隐藏状态。** 每一次工具调用都会对运行时产生副作用。文件被创建。网络请求被发出。数据库行被插入。对话日志一样也记录不到。你可以重放模型的推理过程。你无法重放它推理时所面对的那个世界。严肃的系统靠幂等性和持久化执行来处理这一点。
- **并发边界情况。** 这个循环是顺序执行的。模型可以在一轮里请求多个工具,上面的例子会按顺序运行它们。如果其中两个工具都要写同一个文件,你就有了一个模型看不见的 bug。
这些都不是不去构建智能体的理由。它们是这个系列其余部分存在的理由。
## 这篇刻意略去的内容 {#what-this-post-left-out-on-purpose}
长文也仍然会略去一些东西。下面是有意的省略,以及会接手它们的文章。
- **隔离。** shell 工具很危险。在[第二篇:Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/) 里解决。
- **真正的工具注册表。** 一个工具只是演示。一个有用的智能体有四个到十几个工具。在[第三篇](https://raskell.io/articles/tools-how-agents-actually-do-things/)里讲。
- **上下文策略。** 系统提示词只有一段话。真实的系统从磁盘加载上下文,并按任务来塑造它。在[第四篇](https://raskell.io/articles/context-is-the-product/)和[第五篇](https://raskell.io/articles/retrieval-is-a-tool-not-a-layer/)里讲。
- **跨会话的记忆。** 智能体在两次运行之间会忘掉一切。在[第六篇](https://raskell.io/articles/memory-is-a-write-path/)里讲。
- **模型选择。** 我们把模型写死了。生产环境里的智能体会做路由。在[第七篇](https://raskell.io/articles/the-model-is-a-dependency/)里讲。
- **工具协议。** 这里的工具接口是自定义的。业界已经汇聚到 MCP 上。在后面的一篇文章里讲。
- **框架。** 我们是从零写的。关于框架的讨论在系列后面。
- **身份、评测、持久性、经济性、治理。** 全部在第四和第五部分。
如果你读一下这个系列的目录,就能看出它的形状:系列中其余的每一篇,都在修补你刚刚构建的这个智能体的一个局限。
## 它在平台中的位置 {#where-this-lands-in-the-platform}
本文开头那张图,是最终参考架构里最小的那个方框。智能体循环位于运行时之内。运行时位于一个集群之内。集群位于一个具备身份、可观测性、治理和控制平面的平台之内。系列结束时我们得到的形状,和开始时的形状一模一样,只是放大到了企业规模,每个组件都被展开,各自有了生产级的完整讲述。
你可以用一条规则把整个系列装进脑子里。每一篇增加技术栈的一层,并解释为什么下面那一层单靠自己是不够的。
往上一层是运行时。你刚刚交给前沿模型的 shell 工具,是一把上了膛的枪。下周我们讲怎样把它指向安全的地方。
## 下一篇 {#next}
**第 2 篇:[Your Agent Wants Root](https://raskell.io/articles/your-agent-wants-root/)。** 为什么一个 Docker 容器不够,以及 Firecracker、gVisor 和 Kata 实际上解决了什么。周四发布。
================================================================================
---
title: "推理的经济学"
url: https://raskell.io/zh/articles/the-economics-of-inference/
author: Raffael Schneider
date: 2026-04-22
description: "推理 token 不是 API 调用,而是一种计量的资源:被消耗,创造价值,并与耗电量挂钩。后 AI 世界的经济学不像软件,更像水、电和燃气。"
tags: [inference, economics, sovereignty, edge-systems, gpus, energy, semiconductors]
lang: zh-Hans
translation_of: https://raskell.io/articles/the-economics-of-inference/
---
# 推理的经济学
## 简而言之
带着十六个智能体把 token 用光,不是预算问题,而是我第一次把推理当作公用事业来体验:持续消耗,按单位计量,背后是沉重的物理基础设施。 推理拥有成熟公用事业那样的供应链,建立在芯片、数据、人才和能源之上,瓶颈在芯片制造,地缘政治风险则围绕台湾和出口管制。 如果能力的增长快于其背后物理基础设施的增长,那么 AI 真正的约束不在软件,而在公用事业这一层;瓶颈是那块电表。 可以预见:公用事业式的定价,类似欧洲在俄罗斯天然气上学到的那种主权顾虑,token 效率成为一门工程学科,计量与可观测性成为必不可少的工具。
在[上一篇文章](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/)里,我讲了 2025 年圣诞节期间把十六个 AI 智能体当作一家虚拟公司来运行的经历。架构行得通,协调模型也行得通。行不通的是经济账。我的 token 预算几天之内就蒸发了,不是因为智能体没有产出,而是因为每一次协调、每一次状态更新、每一次上报,都在消耗一种计量的资源,而我补充它的速度跟不上。
当时,我把这当作一个预算问题。我的个人订阅撑不住智能体之间相互通信的开销。一家拥有 API 访问权限和真金白银预算的企业,就不会受到同样的约束。这个说法没错,但把问题看小了。
我当时实际经历的,是在一个人加十六个终端窗格的尺度上,一件大得多的事情。我体验到的是作为公用事业的推理。一种被消耗的物理资源,就像我开灯时消耗电,拧开水龙头时消耗水一样。
这个视角会彻底改变你思考 AI 经济学的方式。
## 什么让一样东西成为公用事业 {#what-makes-something-a-utility}
公用事业具有一组共同的属性,使它们有别于普通的商品和服务。它们不是可有可无的,现代生活依赖它们。它们是被持续消耗的,而不是一次性购买的。它们的生产和输送需要庞大的物理基础设施。它们是计量的,按消耗的单位计价。它们的供应链受制于地理、地缘政治和监管。它们的成本结构主要由建设和维护基础设施的资本支出决定,而不是由多输送一个单位的边际成本决定。
水、电、天然气、电信,这是四种传统的公用事业。每一个现代经济体都建立在它们之上。它们的可得性、可靠性和成本,决定了在某个司法辖区里什么是可能的。你不会在电网不可靠的地方建晶圆厂,也不会在冷却用水供应没有保障的地方运营数据中心。公用事业这一层是地基,地基之上的一切都受限于地基能承载多少。
推理正在一一获得这些属性。
它被持续消耗。每一次智能体交互、每一次模型调用、每一个生成的 token,都是一个消耗单位。我的十六个智能体在协调时,消耗推理的方式就像工厂车间消耗电:稳定,可度量,并且与正在完成的工作量成正比。
它需要庞大的物理基础设施。运行前沿模型的数据中心,是眼下全世界在建的资本最密集的设施之一。它们需要先进的芯片、巨量的电力、用于冷却的水,以及物理安保。它们不是软件项目,而是工业项目。
它按单位计量和计价。每一家主要的推理提供商都按 token 收费:输入 token、输出 token,有时不同能力档位的费率还不一样。计费模式本身已经是公用事业的计费模式。用多少,付多少。
它的供应链受制于地理和地缘政治。
## 芯片、数据、人才、能源 {#chips-data-talent-energy}
在 RSAC 2026 上,我旁听了一场座谈,台上是四位前 NSA 局长和美国网络司令部司令。Paul Nakasone 阐述了他认为在这个时代决定一个国家战略潜力的四个因素。不是 GDP,也不是军事实力,而是四样东西:芯片、数据、人才和能源。
我当时[写过这件事](https://raskell.io/articles/notes-from-rsac-2026/)。但自从 shiioo 那次经历以来,我一直在换一个角度思考这四个因素。Nakasone 谈的是国家实力,我谈的是一种公用事业的供应链。
每一种公用事业都有一条供应链,决定了谁能生产它、成本多少、依赖什么。对电来说,供应链是燃料(煤、天然气、铀、阳光、风)、发电基础设施(电厂、涡轮机、光伏板)、输电(电网)和配电(通到你插座的最后一公里)。对水来说,则是水源(河流、含水层、海水淡化)、处理、输送(管道、水泵)和分配。
对推理来说,供应链就是 Nakasone 的四个因素。
芯片是发电能力。先进的 GPU,具体说是绝大部分由台湾的台积电(TSMC)制造、主要由美国的 NVIDIA 设计的前沿芯片,就是推理经济的涡轮机。没有它们,你就无法以有竞争力的成本生产推理。这种制造能力在全球范围内集中于一个地缘政治上存在争议的岛屿上的单一设施,相当于全世界的电力都依赖一座发电厂。这是一个会让基础设施规划者夜不能寐的单点故障。
能源是燃料。前沿推理如今以吉瓦而不是兆瓦来衡量。一个大规模推理集群的耗电量超过一座小城市。[AI 2027](https://ai-2027.com/) 情景预测,到 2026 年全球 AI 数据中心的耗电量将达到 38 GW,而这个数字还在沿着一条毫无放缓迹象的曲线上升。没有电就无法运行推理,而电力基础设施也无法一夜建成。拥有廉价、充足、可靠能源的司法辖区,具备一种结构性优势,这是再巧妙的软件也弥补不了的。
数据是原材料,是模型学习的来源,是让推理有意义而不是随机的基底。谁拥有数据,在什么法律约束下可以使用,数据有多多样、多有代表性,这些共同决定了你能生产的推理的质量和适用范围。
人才是运营队伍。不只是设计模型的研究人员,还有建造基础设施的工程师、维持其运转的运维人员,以及守护它的安全专家。这是每一种公用事业都依赖的人力资本层,它集中在少数几个地理集群里,原因和石化工程人才集中在炼油厂附近一样。
把它铺开来看,推理的供应链结构和任何成熟的公用事业都一样。战略上的含义也随之而来。
| 供应链层级 | 电 | 水 | 推理 |
|--------------------|-------------|-------|-----------|
| **原始投入** | 燃料(天然气、铀、阳光) | 水源(河流、含水层) | 数据(训练语料) |
| **生产** | 电厂、涡轮机 | 水处理厂 | GPU、数据中心 |
| **输送** | 电网 | 管道、水泵 | 网络、API 端点 |
| **生产所需燃料** | 一次能源 | 泵水用电 | 电力(38+ GW) |
| **关键瓶颈** | 电网容量、许可 | 水权、干旱 | 芯片制造(TSMC) |
| **地缘政治风险** | 管道政治、OPEC | 跨境河流 | 台湾、出口管制 |
这个类比不是隐喻,而是对结构的描述。
## AI 2027 在经济学上说对了什么 {#what-ai-2027-got-right-about-the-economics}
[AI 2027](https://ai-2027.com/) 情景由 Daniel Kokotajlo、Scott Alexander、Thomas Larsen、Eli Lifland 和 Romeo Dean 撰写,是一份推测性的时间线。作者们很小心地把它定位为推测。但其中的经济预测有一种我反复回想的特质:它们把 AI 算力当作一种工业资源,而不是一种软件产品。
他们的情景追踪了全球 AI 数据中心支出达到万亿美元量级的过程。它描绘了前沿算力在各国之间的分布:美国通过其企业掌握大约 70%,中国约为 12%。它预测的耗电量数字,是公用事业规划者而不是软件工程师会认为切中要害的。
这种视角有用之处不在于具体数字,而在于类别。当你以万亿计来预测 AI 支出、以数十吉瓦计来预测耗电量时,你描述的不是一个软件行业,而是一场公用事业的大建设。资本支出的模式、基础设施的时间线、监管问题、地缘政治竞争,所有这些都对应着历史上各国围绕能源基础设施、电信基础设施和工业产能展开竞争的方式。
AI 2027 的作者们预测,AI 系统加速 AI 研究的反馈回路,会压缩能力增长的时间线。他们给出的具体日期是否成立,没有那么重要,重要的是这个结构性观察:如果能力沿着一条陡峭的曲线增长,而这种能力所需的物理基础设施却沿着一条平缓得多的曲线增长,那么 AI 真正的约束就不是软件,而是基础设施,是公用事业这一层。
这正是我在 shiioo 上以个人尺度经历过的。软件行得通,编排模型也行得通。耗尽的是物理资源:token,也就是推理,也就是算力,也就是芯片和电力。瓶颈不是架构,瓶颈是那块电表。
## 这对后 AI 系统意味着什么 {#what-this-means-for-post-ai-systems}
如果推理是一种公用事业,那么每一个依赖推理的系统都是公用事业的用户。这会改变你设计这些系统的方式。
我构建 shiioo 的时候,把 token 消耗当作需要管理的预算。那是个人开发者的视角:我有固定的配额,得花得明智。但如果把视野拉远到企业或国家,视角就变了。你管理的不是预算,而是对一种公用事业的依赖。
问题变成了基础设施问题。你需要多少推理容量?它从哪里来?你的提供商宕机了会怎样?在可用性和吞吐量上,你有什么合同保障?主要供应中断时,你的后备方案是什么?你是否拥有任何自己的发电能力,还是完全依赖外部提供商?
这些正是企业在电、水、电信方面会问的问题。它们也开始在推理方面问这些问题了,尽管大多数还没有用这个视角来看待。
能顺利度过这场转变的组织,是那些认清推理究竟是什么的组织:一种与耗电量挂钩的消耗性资源,需要物理基础设施,并以信息的情境化和评估的形式创造价值。后 AI 系统每一次与另一个系统或与人沟通,都在消耗推理。每一条智能体之间的消息、每一次模型评估、每一个生成的回复,都是从一种计量供应中取出的一个单位,而这种供应背后有真实的物理成本。
由此引出的影响有好几个方向。
**定价将向公用事业模式靠拢。** 按 token 计价已经是常态,但行业将转向公用事业所用的更精细的定价结构:阶梯费率、分时定价、容量预留、现货市场。其中一些已经开始出现。随着企业开始像对待能源支出那样对待推理支出,把它当作一项需要专门采购和优化的主要运营成本,这一趋势会加速。
**主权将变得重要。** 如果推理是一种公用事业,那么依赖外国提供商供应推理,就和依赖外国供应能源属于同一类战略弱点。欧洲在俄罗斯天然气上学到了这一课。你能否在自己的司法辖区内、在自己的基础设施上、在自己的法律框架下运行推理工作负载,这不是关于数据驻留的抽象顾虑,而是基础设施主权的问题。这就是我构建 [Archipelag.io](https://archipelag.io/) 的原因,也是我认为欧洲关于算力主权的讨论需要从政策文件走向物理基础设施的原因。
**效率将成为一门工程学科。** 电便宜而充足的时候,没有人为能效做优化。电变贵之后,围绕它诞生了一整门工程学科。推理也会如此。眼下,大多数使用推理的系统都用得大手大脚:塞满的上下文窗口、冗长的提示词、重复的调用。当推理成本成为一个不可忽视的开支项目,为 token 效率做优化就会像为能效做优化一样平常。我在 shiioo 那篇文章里描述的结构化通信协议,用类型化的消息取代自由形式的对话,就是一个早期的例子。每一个 token 都应该承载信息,而不是客套。
**计量与可观测性将必不可少。** 你无法管理一种你无法度量的公用事业。企业需要推理可观测性,就像它们需要电力监控和网络监控一样:对消耗的实时可见性,把成本归属到具体的工作负载和团队,对意外的用量激增做异常检测,并基于历史模式做容量规划。这方面的工具如今几乎还不存在。几年之内,它会成为一个可观的市场。
## 电表即信息 {#the-meter-is-the-message}
圣诞节期间 token 用光时,我的第一反应是沮丧。第二反应是换一种方式思考架构:为 token 效率而设计,把廉价的通信路由给更便宜的模型。但第三个反应,也是在我心里停留最久的那个,是认出了它。
我认出了这个问题的形状。它不是一个新形状,而是我遇到过的每一种公用事业约束的形状。是「基础设施就是瓶颈」的形状,是「资源有限且计量,你得考虑自己的消耗」的形状,是「供应链是地缘政治的」的形状。
Nakasone 的四个因素,芯片、数据、人才、能源,不只是评估国家实力的框架,它们是生产推理的物料清单。掌控这份物料清单的国家、企业和个人,将拥有同样的结构性优势:就像工业时代能源丰富的国家,信息时代带宽丰富的国家那样。
第五种公用事业已经到来。只是现在还足够早,大多数人仍以为自己买的是软件。
## 参考文献 {#references}
- [What Sixteen AI Agents Taught Me About Management](https://raskell.io/articles/what-sixteen-ai-agents-taught-me-about-management/):本文的前篇
- [Notes from RSAC 2026](https://raskell.io/articles/notes-from-rsac-2026/):Paul Nakasone 的四个因素与地缘政治维度
- [AI 2027](https://ai-2027.com/):Kokotajlo、Alexander、Larsen、Lifland 和 Dean 的情景研究
- [Archipelag.io](https://archipelag.io/):去中心化、主权优先的 AI 算力网络
- [How I Work These Days](https://raskell.io/articles/how-i-work-these-days/):我最早写到转向智能体驱动开发的地方
================================================================================
---
title: "最后一门编程语言,也许不是给人用的"
url: https://raskell.io/zh/articles/what-programming-languages-become-when-ai-writes-the-code/
author: Raffael Schneider
date: 2026-04-11
description: "当 AI 成为代码的主要作者,编程语言的三种未来,以及我为什么押注 Haskell。"
tags: [ai-engineering, programming-languages, abstraction, formal-methods, haskell, compilers, type-systems, linguistics, aerospace]
lang: zh-Hans
translation_of: https://raskell.io/articles/what-programming-languages-become-when-ai-writes-the-code/
---
# 最后一门编程语言,也许不是给人用的
## 简而言之
编程语言一向由写它的人塑造,所以如果 AI 成为代码的主要作者,介于意图与机器之间的那一层就会改变。 第一种未来是像 *Vera* 这样的显式语言:消除歧义,提供机器可读的编译器反馈,但模型写的仍然是一步一步的菜谱。 第二种未来,也就是我用 hx 和 BHC 押注的那一种,是像 Haskell 这样的声明式语言:模型描述结果是什么,类型检查器像检查证明一样验证它。 第三种未来完全跳过源代码:模型先直接生成现有的机器码,之后再以专为机器而非人类读者设计的高密度执行格式为目标。 这三者是时间线上的几个点,而不是对手;源代码不会消失,而是会专门化,就像汇编成了维护基础设施的那些人的领域。
今天早上,我站在书桌前,喝着兑得很淡的速溶咖啡,做着每天早上处理完高优先级邮件和通知之后都会做的事:花三十分钟看 HackerNews。这是一个我限定时长、从不跳过的仪式。我每天都去办公室,无论是在那张书桌前还是在家里的书桌前,早晨都一样:咖啡,站姿,首页。
要把握湾区、科技与科学的脉搏,了解一夜之间冒出了哪些激发思考的想法,HackerNews 仍然是最好的途径之一。我也订阅了几份精选的新闻通讯,但这些年我发现,只要你懂得从低信号中筛出高信号,HN 反正已经涵盖了它们的大部分内容。我每天都能就一个不同的链接写点什么。大多数早晨我忍住了。今天早上没有。
一个链接吸引了我的注意。[Vera](https://veralang.dev/),一门新的编程语言,「设计给机器来写,而不是给人类写」。静态类型,纯函数式,编译为 WebAssembly,用微软的 Z3 求解器做契约验证。它的吉祥物是一只雪貂。我喜欢技术项目用动物当吉祥物:Rust 有螃蟹 Ferris,Go 有地鼠,[Zentinel](https://zentinelproxy.io/) 有守护犬 Shisa。雪貂是个好选择。
但让我停下滚动的不是吉祥物。我停下来,是因为另一个人得出了我早在十二月就得出的同一个结论:传统编程语言并不适应这项新技术的能力,有些东西必须改变。
## 圣诞节的领悟 {#the-christmas-realization}
从 2025 年 5 月 Anthropic 首次推出 Claude Code 起,我就是它的付费用户。命令行的取向一下子就让我觉得对路,尽管早期的速率限制和模型质量让我意犹未尽。到 2025 年 12 月,我已经升级到 Max 订阅,正在休假,而 Anthropic 那个月把每日额度放得很宽。我把这些年积攒下的每一个想法都拿出来烧。有些不错,有些很糟。但它们终于都能以从前不可能的方式得到检验,因为我可以和一个跟得上节奏的模型结对编程。我在[《我如今的工作方式》](https://raskell.io/articles/how-i-work-these-days/)里更完整地写过这种转变,简短的版本是:2025 年末,是我的抱负与执行之间的关系发生根本改变的时候。堤坝决口了。在笔记本里躺了多年的想法,几天之内就开始变成真正的软件。
正是在某个深夜的会话里,在一场关于编译器设计的 Claude Code 对话深处,一个想法成形了。我当时在构建 [hx](https://arcanist.sh/hx/),思考 AI 会如何改变人们写 Haskell 的方式,然后意识到这个问题比 Haskell 大得多。智能体辅助的软件开发正在接近一个临界点:输出语言本身,也就是我们用来表达信息应当如何被处理的那个中间层,将发生根本的改变。
这不是一个抽象的观察。软件的历史就是抽象层不断累积的历史,每一层都让下一代程序员可以忽略上一代必须掌握的东西。
一切始于机器码。原始的操作码,每种 CPU 架构都不一样。想写软件,你就得背下指令集,再手工把它们写出来。人们出版厚厚的参考手册,也有工程师能把整个指令集架构装在脑子里。其中一些人至今还在,其中一些人至今仍对那套方法深信不疑。
然后,汇编器给这些操作码起了人类可读的名字。写 `MOV AX, BX`,而不是 `89 D8`。你仍然在为特定的架构写代码,仍然以寄存器来思考,但现在你能读懂自己写的东西了。第一层抽象并不是一种新能力,而是可读性。
然后 C 出现了,给了我们一层可移植的硬件抽象。你不再以寄存器思考,而开始以函数和指针思考。C 编译成特定架构的汇编,但你不必关心是哪种架构。一门语言,多个目标。参考手册的内容从指令集转向了语言规范。
然后,解释器和虚拟机又加了一层。JVM、Python、Perl。你不再思考内存布局,而开始思考对象、迭代器、垃圾回收。抽象更厚了,反馈循环更快了,受众也从硬件工程师扩大到任何会写脚本的人。
然后,IDE 改变了你与语言本身打交道的方式。语法高亮、自动补全、集成调试器、重构工具。你不再把整套 API 都记在脑子里,因为编辑器替你记着。语言没有变,但使用它的认知成本下降了。IntelliSense 不是一项语言特性,而是一层对程序员记忆的抽象。
然后,互联网改变了代码流动的方式。开源仓库、包管理器、共享库。你不再一切从零写起,而开始用别人造好的零件来组装。参考资料从印刷的书本转向了网络文档、维基和教程。
然后,StackOverflow 改变了人们学习的方式。你不再从头到尾读手册,而是搜索自己遇到的具体问题,找到一个已经解决过它的人。知识层本身变成了一层抽象。你不需要理解整个系统,只需要找到正确的答案,再把它改到适合你的情境。StackOverflow 从没编译过一行代码,但它是介于人类困惑与可运行软件之间的一个中间层,而且对普通开发者的生产力来说,它可以说比同一个十年里发布的任何语言特性都更重要。
而现在,StackOverflow 正在退潮。不是因为答案变差了,而是因为下一层抽象到来了。AI 编程智能体做着 StackOverflow 做过的事,为已知问题找到已知的解法,但它们也做着 StackOverflow 从来做不到的事:综合出新的解法,跨文件把握项目上下文,从意图描述生成可运行的代码。这个模式和之前的每一次过渡都一样。每一层都让前一层变得不那么不可或缺,不是通过取代它,而是把它吸收进一层更高的抽象。
编程语言一向由写它的人塑造。汇编由以寄存器和操作码思考的硬件工程师塑造。C 由需要一层可移植内存抽象的系统程序员塑造。Python 由想把事情做完、又不想和语法较劲的人塑造。COBOL 由希望代码读起来像英语的业务分析师塑造。每一门语言都带着它预设作者的指纹。如果 AI 成为代码的主要作者,那么顺理成章,语言就应当适应这位新作者的长处和短处。这并不是对这个模式的背离,而正是这个模式本身,在做它一直在做的事。
我一再回到三种具体的可能性,也就是中间层可能演化的三种方式。确切地说,它们不是相互竞争的愿景,更像是时间线上的三个点。
## 让语言显式到足以让机器使用 {#make-the-language-explicit-enough-for-machines}
任何真正花时间用过编程智能体的人,都见过这种失败模式。你让 LLM 写一个 Python 函数。输出看起来很合理,能通过 lint,变量名也说得过去,结构遵循常见的模式。然后它在运行时失败了,原因是某个模型没有跟踪到的微妙的隐式行为:一个在多次调用之间被共享的可变默认参数;一个在第二次迭代时被悄无声息地耗尽的生成器;一个返回 `None` 而不是抛出异常的方法,只因为某个库作者觉得那样更「Pythonic」。模型在算法上没有错,错的是对语言隐藏行为的把握。
这正是 Vera 试图解决的问题,也是我曾经考虑过的第一种思路。拿 Go 的简单和显式,再往前推一步,设计一门语言,让每一条指令、每一个方法、每一种设计模式都尽可能没有歧义。没有隐式行为,没有命名歧义,没有风格选择。每件事只有一种规范的写法,这样 LLM 就不必浪费推理 token 去琢磨该从十七种有效方案里选哪一种。
这门语言需要出色的编译器诊断。不只是「第 47 行类型不匹配」,而是模型能够解析、理解并立即据此行动的结构化反馈。Rust 和 Elixir 已经为人类把这件事做得很好。要做得更好,而且是为机器而做。
流水线是这样的:
*Explicit language feedback loop*
```text
+-------+ prompt +-------+ explicit +-----------+
| Human | -------------> | LLM | -------------> | Verifying |
+-------+ +-------+ source | Compiler |
^ +-----------+
| |
| structured error |
| + suggested fix |
+---------------------------+
|
verified
|
v
[correct program]
```
关键在于反馈循环。编译器不只是拒绝坏代码,它还用模型能据以行动的方式解释错在哪里,并给出具体的修复建议。模型重新生成,编译器重新检查。你通过迭代收敛到正确的代码,而这个循环有多紧,取决于语言有多没有歧义、错误信息有多可操作。
Vera 正是这个想法,而且执行得很坚决。一个函数看起来是这样的:
```vera
public fn safe_divide(@Int, @Int -> @Int)
requires(@Int.1 != 0)
ensures(@Int.result == @Int.0 / @Int.1)
effects(pure)
{
@Int.0 / @Int.1
}
```
完全没有变量名。参数用 De Bruijn 槽位记法,按类型和位置索引来引用。`@Int.0` 是最近绑定的整数,`@Int.1` 是它之前的那一个。每个函数都必须声明前置条件(`requires`)、后置条件(`ensures`)和副作用(`effects`)。编译器尽可能用 Z3 静态地验证契约,对编译期无法判定的部分则退回到运行时检查。
这个设计原则很犀利:模型不需要是对的,它需要是可检查的。语言把有效程序的空间约束得如此之紧,以至于编译器能在执行前抓住错误,并用自然语言解释它们。除以零不是运行时异常,而是在编译期间就被捕获的契约违反。
可以这样想。传统语言是一片开阔的田野。你可以往任何方向走,可能走到有用的地方,也可能走下悬崖。Vera 是一条有护栏的引导路径。你只能朝某些方向走,每当你试图迈出路径,就有一块路牌准确地告诉你该往哪里走。开阔田野上的 LLM 会四处游荡,引导路径上的 LLM 会收敛。
早期的基准测试结果很有意思,虽然好坏参半。Kimi K2.5 据说能写出完美的 Vera 代码,在 VeraBench 上得了 100%,超过了它自己在 Python 和 TypeScript 上的分数。其他模型就没那么好了。Claude Opus 4 在 Vera 上得 88%,在 Python 上得 96%。Vera 团队对这种差异很坦诚,这一点我很欣赏。[HackerNews 上的讨论](https://news.ycombinator.com/item?id=47696263)很冷清,只有十二个赞、三条怀疑的评论,这说明这场讨论还处在多么早的阶段。更广泛的开发者社区还没有认真对待这个想法。这会改变的。
但有件事让我不安:为机器迭代求解的方式去优化语言。再看一遍那张流水线图。LLM 仍然在生成一步一步的指令。它仍然在描述「如何」做事,只是去掉了歧义,把契约写明了。机器仍然按顺序推理整个过程。你减少了反馈循环中的噪声,却没有改变信号的本质。模型仍然在写菜谱,只是更精确的菜谱。
如果完全不再写菜谱呢?
## 描述「是什么」,而不是「怎么做」 {#describe-what-not-how}
第二个想法从一个不同的前提出发。与其让 AI 更容易正确地写出过程式代码,不如改变你让 AI 表达的东西。
具体一点。假设你需要在日志里找出最近的十个服务器错误。用过程式语言,你会这样描述这个过程:
```python
errors = []
for entry in log_entries:
if entry.status >= 500:
errors.append({
"time": entry.timestamp,
"path": entry.path,
"code": entry.status
})
errors.sort(key=lambda e: e["time"], reverse=True)
return errors[:10]
```
你在告诉机器:创建一个空列表;遍历每一条记录;检查一个条件;如果匹配,就构造一个字典并追加进去;然后按某个键对累积的列表排序;然后取前十个元素。每一步都是一条指令。机器必须跟踪可变的列表、迭代状态、排序和切片。而如果你有任何一步写错,其他步骤仍可能成功,产出看起来正确、实则暗藏错误的结果。漏掉一个 `reverse=True`,你就会悄无声息地拿到最旧的错误,而不是最近的。
同样的事,用 Haskell 写:
```haskell
recentErrors :: [LogEntry] -> [ErrorSummary]
recentErrors =
take 10
. sortBy (flip compare `on` time)
. map toSummary
. filter isServerError
```
从下往上读:筛选出服务器错误,把每一条转换成摘要,按时间降序排序,取十个。没有可变的累加器,没有循环变量,没有中间状态。你不是在描述一个过程,而是在描述输入与输出之间的关系。这个函数说的是结果「是」什么,而不是如何一步一步把它算出来。
顶部的类型签名 `[LogEntry] -> [ErrorSummary]` 是编译器强制执行的契约。如果 `toSummary` 返回了错误的类型,如果 `isServerError` 接受的不是 `LogEntry`,如果你不小心把函数按一个无法通过类型检查的顺序组合起来,编译器会在程序运行之前就拒绝它。不是在运行时给出一句含糊的「object has no attribute」,而是在编译时给出精确的类型错误,准确地告诉你哪一块对不上。
这个区别对 AI 来说极其重要。想想 LLM 在两种情况下各自实际需要跟踪什么:
*Procedural vs declarative complexity*
```text
Procedural (Vera, Python, Go) Declarative (Haskell)
================================ ================================
- mutable variables and their - input type
current state at each step - output type
- loop iteration progress - which transformations to compose
- conditional branching outcomes - whether types align
- order of side effects
- implicit language behaviors
- names and what they refer to
```
过程式的模型要求 AI 在脑子里模拟执行。声明式的模型要求 AI 描述一个变换,再让编译器去验证它。前者撞上的是 LLM 的弱点(跨越许多步骤跟踪状态),后者发挥的是它的长处(识别并生成满足形式约束的模式)。
流水线发生了根本的变化:
*Type-driven proof pipeline*
```text
+-------+ prompt +-------+ type sigs +-----------+
| Human | -------------> | LLM | -------------> | Compiler |
+-------+ +-------+ pure exprs +-----------+
|
types align?
/ \
yes no
| |
v v
[proven correct] [precise type error:
"Expected LogEntry,
got String at ...]
```
在一切顺利的情况下,根本不需要反馈循环。如果类型对得上,那么就类型系统所跟踪的那些性质而言,程序在构造上就是正确的。编译器不是在和模型来回迭代,它是在检查一个证明。
这就是我押注的思路。这也是这个博客存在的原因。
Raskell,这个网站背后的名字,是 Rascal(指的是浣熊,也就是我的吉祥物)和 Haskell 的合成词。我爱了这门语言很多年,因为它描述事物的方式优雅得接近数学证明。是 QED,而不是 TODO。当你写下一个类型良好的 Haskell 函数,你写的不只是代码,而是一份证明,证明某个变换是有效的,而编译器就是证明检查器。
但热爱 Haskell 和在生产中交付 Haskell 是两种不同的体验,两者之间的差距主要在工具上。这个生态的碎片化,已经让人们沮丧了十多年。`cabal`、`stack`、`ghcup`,三个工具做着相互重叠的工作,对依赖该如何运作各有主张。如果你从 Python 过来,想象一下 `pip`、`poetry` 和 `pyenv` 都是各自独立开发的,锁文件格式不同,解析算法不同,还时不时互不兼容。当年的 Haskell 就是这样。构建很慢,错误信息从有帮助到晦涩难懂不等。运行时假定一种性能特征适用于所有场景。如果你想把 Haskell 用于边缘函数、嵌入式系统、GPU 加速的数值计算,你花在和工具链较劲上的时间,和写实际代码的时间一样多。
语言是对的,周边的基础设施不对。
于是我开始构建 [arcanist.sh](https://arcanist.sh),采用 [astral.sh](https://astral.sh) 为 Python 工具链带来的同一种思路。astral.sh 发布 `uv` 和 `ruff` 时表明,你可以拿一个工具已经根深蒂固的成熟生态,用 Rust 从零重建开发者体验,让一切都快得多、也连贯得多。我想为 Haskell 做同样的事。arcanist.sh 下有两个项目。
[hx](https://arcanist.sh/hx/) 是一个快速、有主见的新一代 Haskell 工具链,用 Rust 构建。一个工具取代那套碎片化的组合。按项目锁定的托管编译器版本。带指纹校验的确定性 TOML 锁文件。冷构建比 cabal 快 5.6 倍,增量重建快 7.8 倍。
```bash
curl -fsSL https://arcanist.sh/install.sh | sh
hx new my-app && cd my-app
hx run
```
不用 ghcup,不用 stack,不用 cabal-install。只要 `hx`。
[BHC](https://arcanist.sh/bhc/),即 Basel Haskell Compiler(巴塞尔 Haskell 编译器),走得更远。它是一个用 Rust 编写、从零开始的 Haskell 编译器,不是 GHC 的分支,以 Haskell 2026 Platform 规范为目标。它使用 LLVM 生成本地代码,并提供六种在编译时选择的运行时配置:
| 配置 | 设计用途 | 关键特性 |
|---------|-------------|-----------|
| default | 通用应用 | 惰性求值,GC 管理,与 GHC 兼容的语义 |
| server | 后端服务 | 结构化并发,自动取消,可观测性钩子 |
| numeric | 机器学习与科学计算 | 严格数值,张量降级,SIMD,GPU 后端(CUDA/ROCm) |
| edge | WASM 与 CDN worker | 极小体积,不经 LLVM 直接生成 WASM |
| realtime | 游戏、音频、机器人 | GC 停顿有上限,低于 1ms,arena 分配 |
| embedded | 裸机、微控制器 | 完全没有 GC,静态分配,面向 ARM Cortex-M 等目标 |
同样的 Haskell 源代码,根据你在构建什么,得到不同的运行时契约。你的安全策略引擎用 server 配置编译,得到带追踪的结构化并发。你的张量流水线用 numeric 配置编译,得到 GPU 加速。你的边缘函数编译成 WASM,跑在 Cloudflare Workers 上。同一门语言,同样的类型安全,不同的性能包络。
这项工作背后的信念很具体。当 AI 写代码时,存活下来的语言不是为过程式的显式性而优化的那一门,而是通过描述事物是什么、而非如何计算它,带来一致性与纯粹性的那一门。AI 极其擅长生成满足形式约束的表达式。而读起来像证明的源代码能经受住时间。它能经受住维护者的倦怠。它能经受住这样一个事实:三年之后,没有人记得一个函数为什么被写成那样。类型记得。证明以一种过程式代码永远做不到的方式自我说明,因为类型编码了意图。
Vera 和 arcanist.sh 接受同一个前提:中间层正在改变。它们分歧在于它应当朝哪个方向改变。Vera 优化的是减少生成循环中的错误,这有价值。但 hx 和 BHC 优化的是让生成的代码在构造上就是正确的,因为语言本身在结构层面约束了有效程序的样子。
## 完全跳过语言 {#skip-the-language-entirely}
第三种可能性,是我在深夜会想、却还没有具体项目的那一种。暂时还没有。它也是我觉得最迷人、也最令人不安的那一种。
如果 AI 根本不再写源代码呢?
要理解这为什么可信,不妨看看源代码究竟是什么。它不是最终产品,从来都不是。源代码是一组由编译器转换成机器码的指令。机器码才是硬件执行的东西。源代码之所以存在,是因为人类需要在自己的意图和硅片之间有一层抽象。我们以「给这个列表排序」或「拒绝未授权的请求」这样的概念来思考,CPU 则以寄存器移动、内存加载和条件跳转来思考。源代码弥合了这道鸿沟。
但那座桥是为人类作者建造的。如果作者不再是人类,这座桥的用途就变了。它变成一条审计线索,一种让人类阅读和核实 AI 产出了什么的方式。它不再是创作的媒介,而是一层透明层。
我看到这会分两个截然不同的阶段展开。
### 第一阶段:AI 以现有机器码为目标 {#phase-one-ai-targets-existing-machine-code}
第一阶段比大多数人以为的更近,而且在概念上很直接。我们已经在用源代码训练模型。如果我们也大量地用编译产物来训练它们,会怎样?用二进制文件、目标文件、中间表示,也就是编译器的实际输出?
想想编译器做的事。它接收源代码,按照定义明确的确定性规则,把它转换成机器指令。源代码的模式与输出的模式之间存在映射。C 里的一个 `for` 循环,在 x86 上变成一串特定的比较、分支和递增指令。函数调用遵循特定的调用约定。内存分配遵循特定的系统调用模式。这些映射是可以学会的。它们是模式,而模式识别恰恰是 LLM 最擅长的。
*Skipping the source layer*
```text
Today:
human intent → prompt → LLM → source code → compiler → x86/ARM → CPU
Phase one:
human intent → prompt → LLM → x86/ARM directly → CPU
(trained on source +
compiled artifact pairs)
```
在这个阶段,模型跳过源代码层,直接生成机器码。不是传统意义上的「编译」,而是因为它已经把模式学得足够好,能从意图描述产出有效的可执行文件。就像一个流利的译者不会有意识地去解析语法规则,而是直接从意思产出正确的句子。
这听起来很激进,直到你想起我们早已信任那些我们从不阅读其输出的编译器。你上一次检查 `gcc -O3` 的汇编输出、核实它是否正确编译了你的 C 程序,是什么时候?你信任编译器。你测试生成的二进制文件的行为。你不审计中间表示。如果 AI 能产出通过同样行为测试的二进制文件,那么「AI 生成的机器码」与「编译器生成的机器码」之间的实际差别,就成了一个信任校准的问题,而不是根本可能性的问题。
我一再回到的类比是航空。早期的飞行员手动驾驶,理解飞机上的每一个机械系统。电传操纵改变了这一点。飞行员传达意图(爬升、转弯、保持高度),计算机把它转换成舵面的动作。飞行员不会为每一阵风手动调整副翼和升降舵。他们信任这个系统。他们核实的是结果(高度、航向、空速),而不是中间步骤。后语言编程的第一阶段,就是软件的电传操纵。
如果这听起来像是空想,想想这周发生的事。Anthropic 宣布了 [Project Glasswing](https://www.anthropic.com/glasswing),一个包括 AWS、Apple、Google、Microsoft、NVIDIA、CrowdStrike、Palo Alto Networks、Linux 基金会等在内的联盟,旨在用 AI 保护世界上最关键的软件。Anthropic 的 CEO Dario Amodei 说得很直白:
> 「AI 模型的编程能力已经达到这样的水平:在发现和利用软件漏洞方面,除了最顶尖的人类之外,它们可以超越所有人。」
他给出的证据是:「在 OpenBSD 中,我们发现了一个已经存在 27 年的 bug。」
想想这意味着什么。OpenBSD 是世界上审计得最仔细的代码库之一。几十年来,一些当世最一丝不苟的系统程序员以安全为重点对它进行人工审查。而一个 AI 模型找到了每一位人类审查者都错过了二十七年的东西。如果 AI 对现有代码的理解深到能找出人类找不到的漏洞,那么它对代码的理解也深到能在不以人类可读源代码为中间步骤的情况下生成代码。问题不再是 AI 是否在结构层面理解代码。这个问题这周已经有了答案。问题是它接下来会拿这种理解做什么。
### 第二阶段:一种新的机器 {#phase-two-a-new-kind-of-machine}
第二阶段更远,也更具推测性。但我认为事情最终会走到那里。
如果 AI 在生成供机器执行的代码,而没有人需要阅读它,那么这些代码就没有理由以为人类理解而设计的指令集为目标。x86 和 ARM 在设计时都假定,至少偶尔会有人去看这些指令。它们有助记符,遵循让反汇编成为可能的约定,组织成大致对应于人类能理解的操作的指令。
但如果执行目标是从零开始为 AI 生成的代码设计的呢?一个消费新型字节码的虚拟机或运行时。不为人类可读性优化,不为手写汇编优化,纯粹为执行密度和机器生成优化。
*AI-native execution target*
```text
Phase two:
human intent → prompt → AI → dense symbolic bytecode → AI-native VM
(opaque to humans, |
optimized for machine v
generation + execution) [result]
```
我一直在想信息密度。汉字把意义编码在单个符号里,每个符号承载的语义分量远远超过拉丁字母的单词。一个字就能表示一个用英语需要一整个短语才能表达的概念。当一个系统是为能原生处理高密度符号的读者设计的,表示就会被压缩。它变得更高效,代价是对不属于设计受众的读者更不友好。
AI 原生字节码可以遵循同样的原则。每条指令可以编码复杂的复合操作,而这些操作用传统指令表达需要几十条。这种字节码的密度会让现在的机器码显得啰嗦。反编译或分析时完全不透明。不是故意混淆,只是天生无法被人类认知理解,就像训练好的神经网络的权重无法被理解一样,尽管它们编码着真实而有效的知识。
运行这种字节码的虚拟机本身也会是另一种系统。不是传统意义上的栈机或寄存器机,可能更接近一个数据流引擎,字节码描述的是变换图,而不是顺序的指令。可以把它想成两种做法的差别:一种是给人逐个路口的驾驶指引(向北走,左转,继续开两英里),另一种是递给他一张标好目的地的地图。字节码就是地图,虚拟机自己找出路线。
我想坦白我们现在在哪里。我们还没到第一阶段。2026 年 4 月还没有。当前的模型仍然需要中间层。当它们能一步一步推理时,产出的代码更好。它们受益于类型系统、契约和显式的错误信息。第一种和第二种思路不只是可行,而且眼下是必需的。
但轨迹是看得见的。模型每一代都更擅长生成正确的程序。形式化验证正变得更实用。硬件正变得更便宜。「描述意图的提示词」与「正确的可执行输出」之间的差距正在缩小。当用足够多的「源代码加二进制」配对训练出来的模型能够可靠地产出正确的可执行文件时,第一阶段就会到来。当有人问出这个问题时,第二阶段就会到来:如果模型已经在生成二进制文件,我们为什么还要以一个为已经不再写代码的物种设计的指令集为目标?
到某个时候,中间层会变成可选的。而可选的东西,只要时间足够,就会退化成遗迹。
## 这意味着什么 {#what-this-means}
我不认为这三种思路在相互竞争。它们是时间线上的三个点,而这条时间线讲的是中间层不断收缩的故事。
*The intermediate layer timeline*
```text
Near term Medium term Long term
(now) (2-5 years) (5-15 years)
Explicit Declarative Post-language
languages languages (AI-native targets)
(Vera) (Haskell + BHC)
Reduce noise --> Change the signal --> Remove the layer
in the loop entirely entirely
HOW, but WHAT, verified Intent to
unambiguous by types execution
```
近期,像 Vera 这样的显式语言通过约束生成空间、提供机器可读的诊断,让 AI 生成的代码更可靠。这在今天就有用。如果你现在正在构建一条 AI 编程流水线,下个季度就要交付,这种思路行得通。
中期,像 Haskell 这样的声明式语言,尤其是配上现代工具链和现代运行时,让 AI 生成的代码在构造上就是正确的。类型系统在根本层面承担了繁重的验证工作。存活下来的代码,是描述不变量而不是描述过程的代码。这就是我用 arcanist.sh 为之构建的时代。
长期来看,语言会消失。先是消失在由 AI 直接生成的现有机器码里,然后消失在从底层起就为 AI 生成而设计的新执行格式里。定义了软件工程七十年的中间层,会变成一个实现细节。
最后这种可能性让一些人不舒服。我在十二月第一次想到它时,也觉得不舒服。它意味着我们所知的编程这门手艺,对语法的娴熟,对惯用法的掌握,对优雅实现的直觉,会变得不再像一项核心技能,而更像会操作一台手动车床。在合适的场合有价值,困难的情况仍然需要,但不再是大多数软件被构建出来的主要方式。
这以前发生过。曾经有一段时间,每个程序员都懂汇编。然后 C 把它抽象掉了,大多数程序员不再阅读机器码。然后 Python 和 JavaScript 把 C 抽象掉了,大多数程序员不再思考内存管理。每一次,前一层都没有消失,而是成了专家的领域,由他们维护着其他所有人立足其上的基础设施。同样的事会发生在源代码身上。它不会消失,它会专门化。
我仍然每天写代码,仍然以类型来思考。我仍然在构建 hx 和 BHC,因为我相信那个中期的未来既真实又漫长,而 Haskell 的长处恰恰是那个未来所需要的:纯函数,强类型,可证明的正确性。在一个由 AI 编写实现的世界里,这些不是奢侈品,而是承重结构。但我做这件事时,一只眼睛望着地平线,知道我所投入的这个中间层,正如其名:只是中间的一层。
构建 Vera 的人看到了和我一样的东西,大概也是在差不多的时候。他们选择了第一种思路,我选择了第二种。总有一天,会有人去构建第三种。到那时,我们都得弄清楚,当没有人再写程序时,我们所说的「编程」到底是什么意思。
我已经对答案感到好奇了。
*后记:*同一个问题的实践一面,也就是在智能体写下大部分代码的今天我会选用哪些语言,以及每一种语言仍然能带来什么,见 [Almost Irrelevant](https://raskell.io/articles/almost-irrelevant/)。